
실행 프로그램과 확장
최종 업데이트
DGX Spark 두 대를 연결하면 무엇이 실제로 좋아질까
DGX Spark 두 대는 메모리와 동시 처리 여유를 늘려요
DGX Spark 두 대로는 큰 모델을 나눠 실행하거나, 각각 다른 요청을 처리할 수 있어요. 원하는 모델이 한 대에 들어가는지와 동시에 사용할 사람이 몇 명인지에 따라 적합한 구성이 달라져요.
한 대의 메모리가 부족하다면 모델 분할을, 여러 사람이 요청을 보내 대기열이 길어진다면 모델 복제를 검토해요. 두 방법은 장비에 맡기는 일이 달라요. 실행 프로그램1이 어떤 구성을 지원하는지부터 확인하고, 해결하려는 문제에 맞춰 성능을 비교해야 해요.
두 번째 장비가 필요한 이유를 구분해요
한 대의 가용 메모리에 가중치와 대화 중 쌓이는 KV 캐시2가 들어가지 않는다면, 지원 런타임으로 두 노드에 모델을 분할해 더 큰 모델을 실행할 수 있어요. 이때 첫 효과는 답변 생성 가속이 아니라, 한 노드에 들어오지 않던 모델을 올리는 거예요.
각 Spark의 표기 메모리는 128GB이므로 두 대 합계는 256GB예요. 그래도 앱에서 단일 256GB 장치가 생기는 것은 아니에요. 런타임이 가중치와 캐시를 분배하고 노드 간 결과를 주고받아야 하며, 한쪽에 특정 구성 요소와 작업 공간이 몰리면 총량이 남아도 그 노드가 먼저 한계에 닿을 수 있어요. 실행 중 각 노드의 사용량과 배치를 확인해요.
모델이 한 대에 들어간다면 두 번째 장비로 풀려는 목표를 먼저 정해요. 한 답변을 두 노드에서 나눠 생성할지, 모델을 복제해 여러 요청을 나눠 처리할지에 따라 구성이 달라져요.
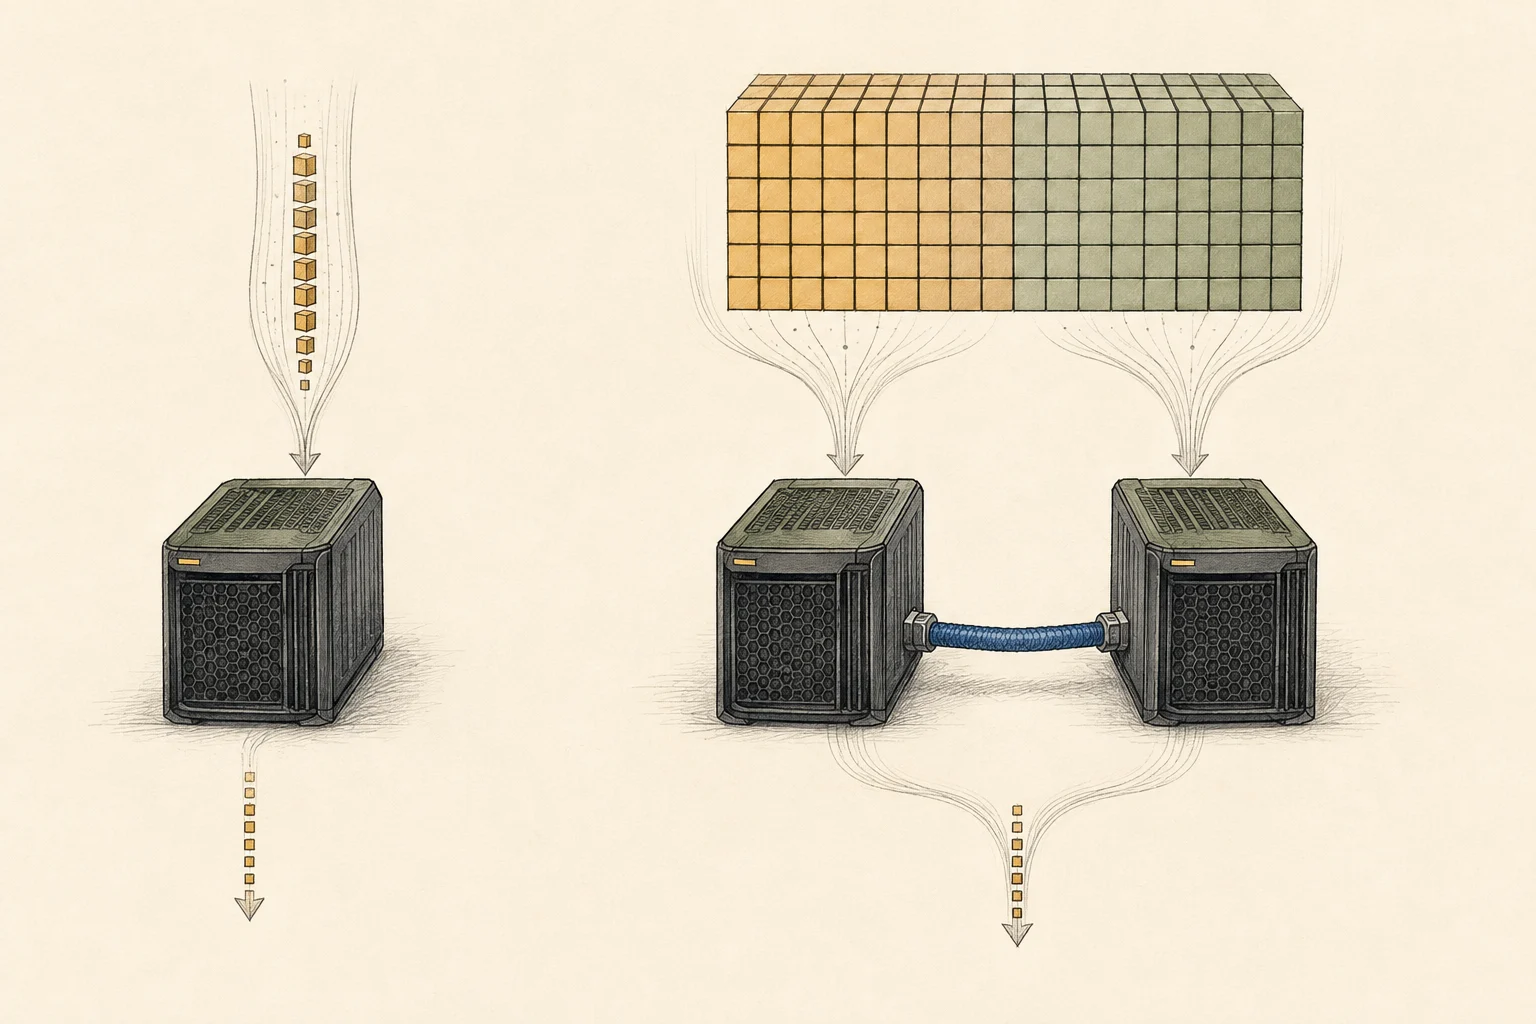
한 답변을 나누면 계산과 함께 통신도 늘어요
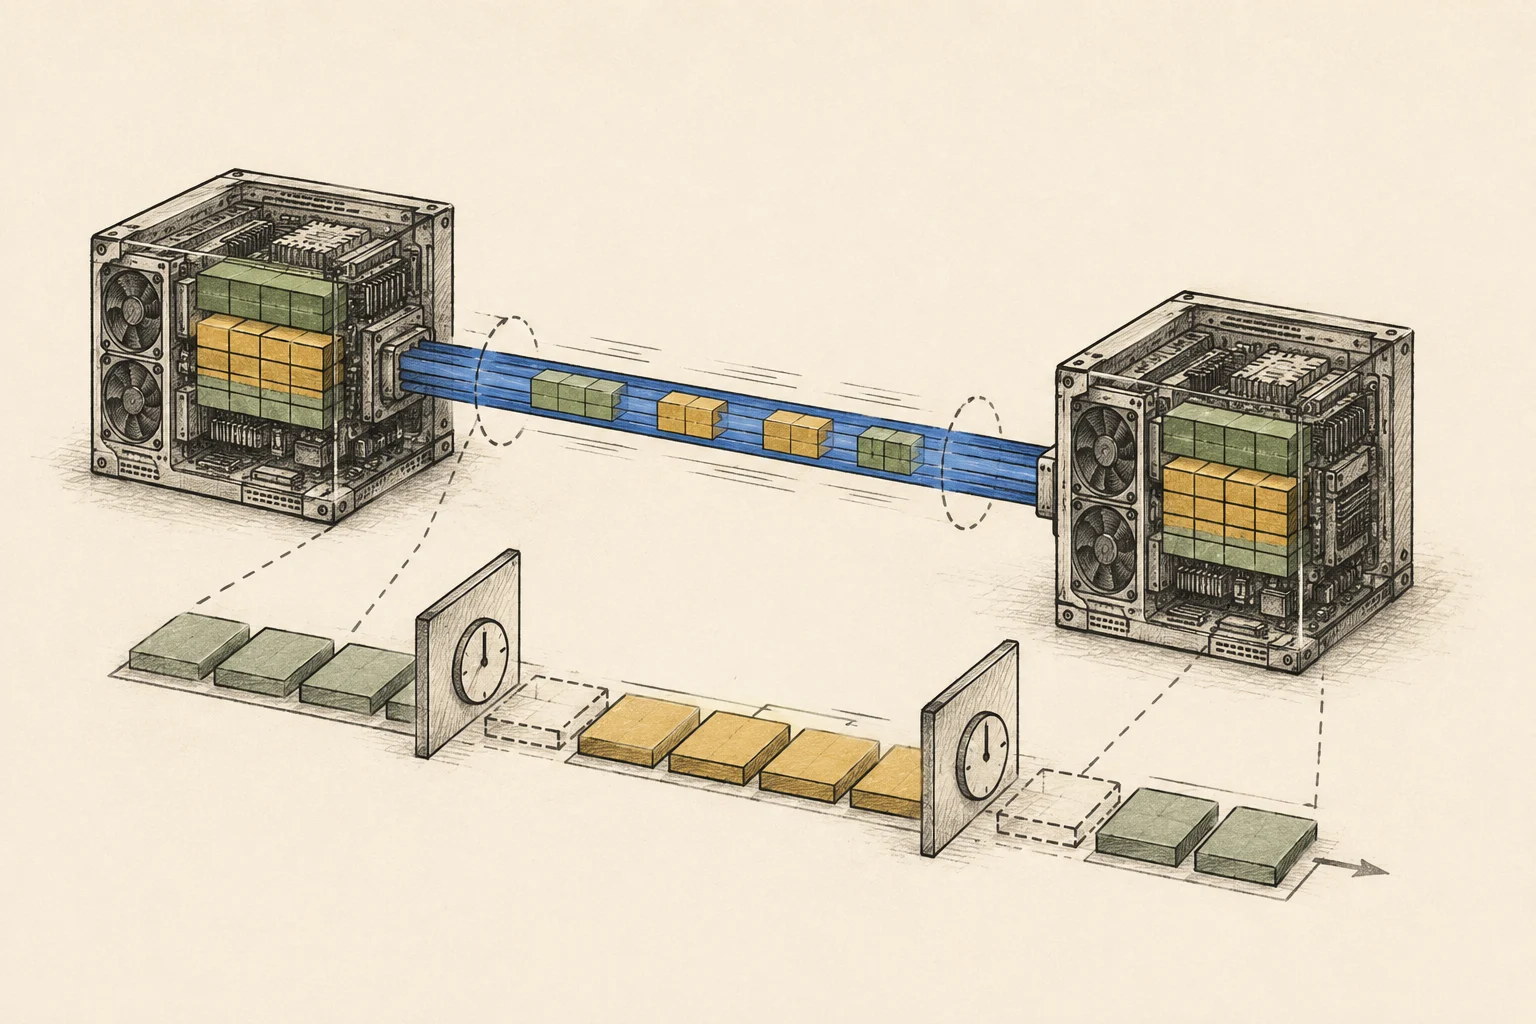
모델을 두 노드에 나누면 각 노드가 맡는 계산량은 줄 수 있지만, 중간 결과를 다음 단계에 넘기고 진행을 맞추는 통신과 동기화가 필요해요. 줄어든 계산 시간이 이 전달과 대기 시간을 넘어야 한 사용자의 답변이 빨라져요.
레이어를 앞뒤 노드에 배치하는 방식과 같은 층의 계산을 나누는 방식은 데이터 교환의 시점과 양이 달라요. 네트워크 대역폭이나 장비 사양을 단순히 더해서 단일 응답 속도를 예측할 수 없는 이유예요. 긴 입력을 먼저 처리하는 프리필3과 한 토큰4씩 만드는 디코드5도 계산 패턴이 달라, 한 구간의 수치만으로 문서 작업 전체를 판단하지 않아요.
두 구성의 차이를 보려면 비교 조건을 맞춰요
‘두 대가 더 빨랐다’는 결과를 볼 때는 모델 파일, 양자화6, 런타임 버전, MTP7 설정, 입력 길이, 동시 요청 수가 같은지 확인해요. 두 대 구성에만 다른 양자화나 MTP를 적용했다면 결과는 구매할 실제 구성을 비교하는 데는 유용하지만 장비 한 대를 더한 효과만 보여 주지는 않아요.
비교는 공통 설정으로 장비 수와 모델 분할의 차이를 먼저 보고, 이후 각 장비에서 실제로 쓸 최적 설정을 적용하는 두 차례로 나눠요. 기록에는 모델 파일·포맷과 입력·출력 조건, 첫 토큰과 완료 시점을 남기고, 특정 옵션이 한쪽에서만 지원되면 별도 설정임을 표시해요.
Spark의 ARM64 환경에 맞는 패키지, 대응 QSFP 케이블과 노드 간 통신 설정, 실행 프로그램이 인식한 분할 경로도 확인해야 해요. 이 구성이 빠지면 지원되지 않은 실행과 두 노드 통신의 비용을 혼동할 수 있어요.
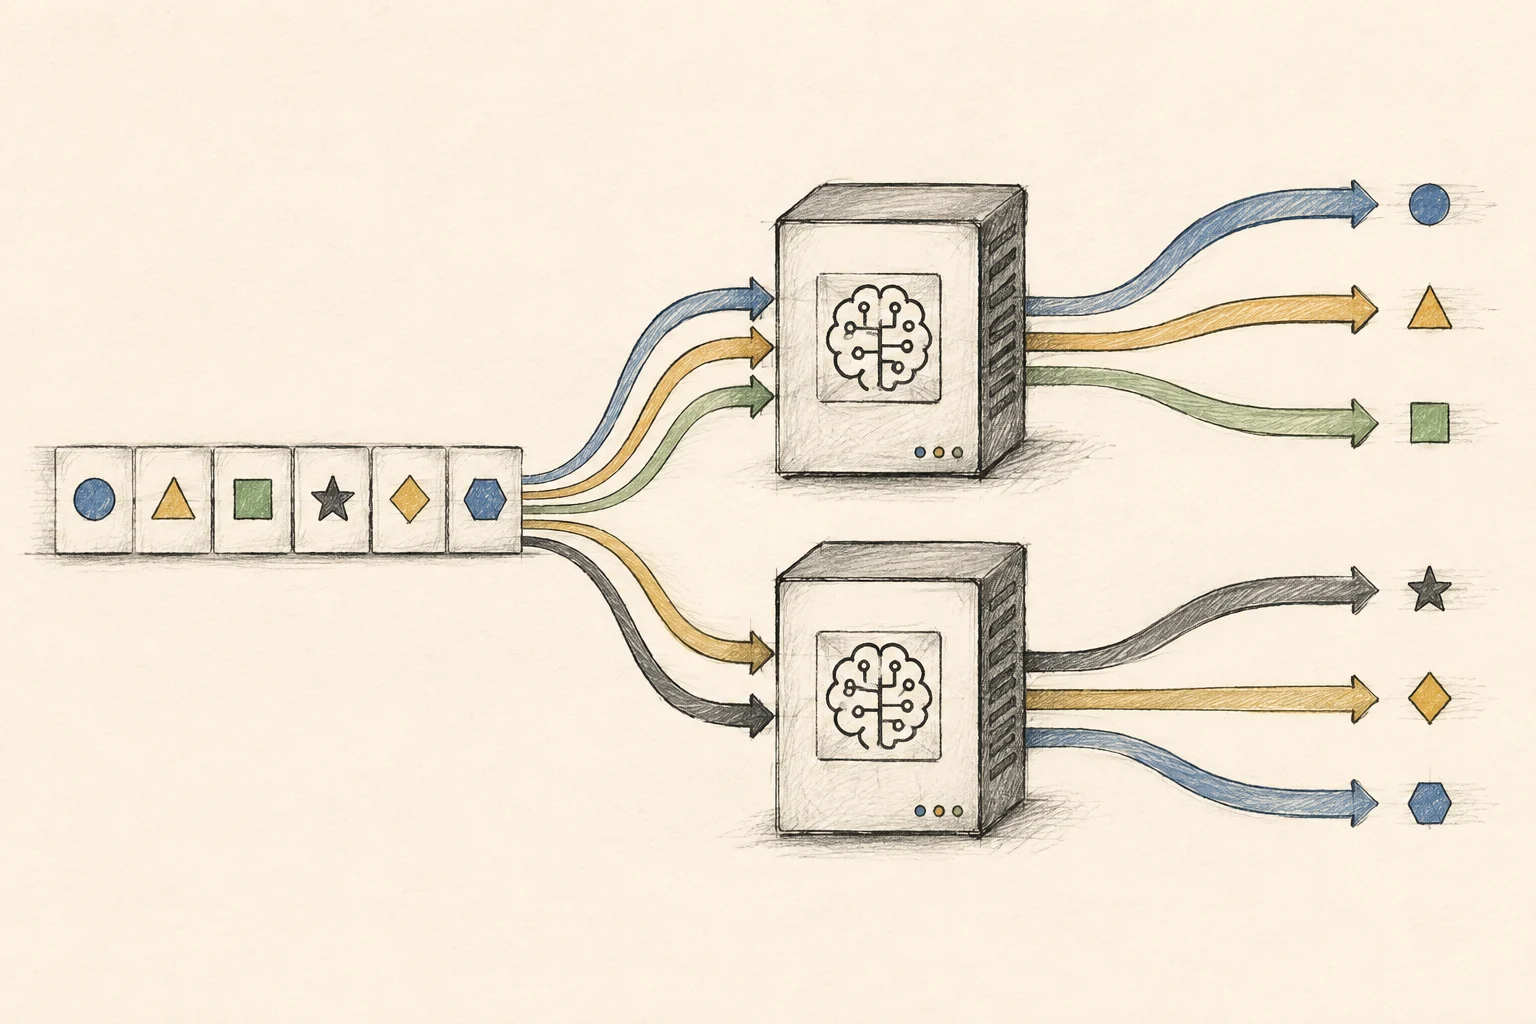
요청이 여러 개면 복제와 분할의 차이가 중요해요
한 모델이 한 대에 들어간다면 각 노드에 같은 모델 복제본을 둘 수 있어요. 스케줄러가 요청 A를 한쪽에, 요청 B를 다른 쪽에 보내면 서로 다른 사용자를 동시에 처리할 여지가 생겨요. 이때 기대하는 지표는 한 답변의 속도만이 아니라 일정 시간 동안 끝난 요청 수와 대기열이에요.
반대로 A 하나를 두 노드에 분할한 구성에서는 두 노드가 함께 A를 처리해요. 따라서 다른 요청 B가 자동으로 남는 노드에 독립 배정된다고 가정할 수 없어요. 모델을 한 대에 넣을 수 없어 분할한 구성과, 모델을 복제해 요청을 나누는 구성은 서로 다른 목표를 해결해요.
첫 토큰까지 걸린 시간, 생성 속도, 여러 요청의 처리량8은 서로 다른 지표예요. 전체 처리량이 늘어도 특정 요청이나 가장 오래 기다린 사용자의 응답은 느릴 수 있어요. 한 요청 비교 화면은 동시 요청 부하 시험을 대신하지 않아요.
두 번째 장비에 맡길 일을 먼저 정해요
한 대에 원하는 모델과 캐시가 들어가지 않는다면 두 번째 Spark가 실행 가능한 범위를 넓힐 수 있어요. 반대로 한 대에서 필요한 모델이 잘 돌고 혼자 쓰는 대기도 괜찮다면, 추가 장비가 연결·관리 부담을 상쇄할 일을 맡는지 따져요. 실제 동시 사용자가 줄을 서거나 더 큰 모델이 필요한 상황이 근거가 돼요.
고민하는 병목이 다르면 단계도 나눠 봐요. 모델 적재 중 실패하면 메모리 배치와 지원 경로를 점검하고, 모델이 올라간 뒤 긴 입력이나 동시 요청에서 기다림이 길면 분할·복제·요청 스케줄링 중 어떤 기능이 제공되는지 살펴요. 그 다음 목표 모델과 런타임을 정해 직접 비교해요.
원문 비교 도구는 Qwen3.8 27B와 4K 입력에서 Spark 한 대와 두 대의 예상 체감을 보여줘요. 장비별 권장 포맷과 가속이 다를 수 있으며 동시 요청 부하 시험은 아니에요. 프리필 포함 여부를 바꿔 한 사용자의 대기 구간을 살펴보고, 구매를 결정하기 전에는 실제 목표 구성을 다시 측정해요.
용어 각주
런타임 — 프로그램이 실행될 때 필요한 기능을 제공하는 소프트웨어 환경입니다. 로컬 AI에서는 모델을 실행하는 엔진을 가리키기도 합니다.
본문으로 돌아가기KV 캐시 — 어텐션에서 이전 토큰의 키·값을 저장해 다음 토큰 생성 때 재사용하는 메모리입니다. 문맥 길이와 배치 크기에 따라 용량이 달라집니다.
본문으로 돌아가기프리필 — LLM이 입력 프롬프트를 읽고 각 토큰의 내부 표현을 계산하는 단계입니다. 입력이 길수록 처리할 토큰이 많아집니다.
본문으로 돌아가기토큰 — 모델이 입력이나 출력을 나누어 처리하는 단위입니다.
본문으로 돌아가기토큰 디코드 — 입력과 앞서 만든 답변을 바탕으로 다음 출력 토큰을 차례로 생성하는 단계입니다.
본문으로 돌아가기양자화 — 모델의 가중치나 계산값을 더 적은 비트로 표현해 저장 공간과 메모리 사용량을 줄이는 방법입니다. 표현 단계가 거칠어져 정확도에도 영향을 줄 수 있습니다.
본문으로 돌아가기MTP — 한 번에 여러 미래 토큰을 예측하도록 학습하는 목표 또는 이를 수행하는 모델 구성입니다. 추측 디코딩에서는 이 예측을 후보 토큰으로 제안할 수 있습니다.
본문으로 돌아가기처리량 — 일정 시간 동안 처리하거나 생성한 작업량입니다. 토큰/초, 요청/초처럼 단위를 함께 확인해야 비교할 수 있습니다.
본문으로 돌아가기
자주 묻는 질문
- 이 글에서 가장 먼저 확인할 것은 무엇인가요?
- DGX Spark 두 대로는 큰 모델을 나눠 실행하거나, 각각 다른 요청을 처리할 수 있어요. 원하는 모델이 한 대에 들어가는지와 동시에 사용할 사람이 몇 명인지에 따라 적합한 구성이 달라져요.
- 필요한 메모리는 어느 정도인가요?
- 각 Spark의 표기 메모리는 128GB이므로 두 대 합계는 256GB예요. 그래도 앱에서 단일 256GB 장치가 생기는 것은 아니에요. 런타임이 가중치와 캐시를 분배하고 노드 간 결과를 주고받아야 하며, 한쪽에 특정 구성 요소와 작업 공간이 몰리면 총량이 남아도 그 노드가 먼저 한계에 닿을 수 있어요. 실행 중 각 노드의 사용량과 배치를 확인해요.