
새로 나온 모델 · 2026.09.04
최종 업데이트
GLM-5.3·DeepSeek-V4 공개: 오픈웨이트인데 개인 PC에서 가능한가
대형 오픈웨이트 모델로 팀 전용 서버를 만들려면
GLM-5.3-Flash와 DeepSeek-V4-Flash는 가중치를 내려받아 자체 서버에서 질문과 코드에 대한 텍스트 답변을 생성하는 대형 오픈웨이트 모델이에요. 팀이 모델을 직접 운영하려면 전체 가중치를 담을 메모리, 병렬 실행을 지원하는 장비와 런타임1, 요청을 받을 서버 설정을 준비해요.
외부 서비스로 코드를 보내지 않는 팀 서버를 원한다면, 공개된 가중치가 있다는 사실과 보유 장비에서 실용적으로 돌릴 수 있다는 사실을 구분해요. 모델 파일, 분산 실행에 필요한 가속기와 런타임, 여러 사용자의 요청을 운영할 수 있는지를 차례로 확인해야 해요.
자체 서버에서는 데이터와 접속 권한을 팀이 관리해요
조직이 관리하는 서버에서 모델을 실행하고 외부 추론 서비스와 연결하지 않으면 코드와 문서를 내부에서 처리하는 구성을 만들 수 있어요. 여기서 로컬은 개인 PC뿐 아니라 팀이 관리하는 서버도 뜻해요. 구성할 서버가 모델의 전체 가중치를 읽고 계산할 수 있도록 메모리와 런타임을 맞춰요.
서버를 직접 관리하면 접속 범위와 로그, 권한 설정도 팀이 맡아요. 각 모델의 라이선스가 계획한 사용을 허용하는지 읽고, 누가 업데이트와 파일 보관, 장애 대응을 맡을지 정해야 해요. 개인용 한 대에서 가끔 쓰는 구성과 여러 사람이 상시 쓰는 서버는 필요한 모델 규모와 관리 책임이 달라요.
활성 파라미터와 전체 가중치는 다른 수치예요
GLM-5.3-Flash는 약 320B 전체에 18B 활성, DeepSeek-V4-Flash-0731은 약 304B 전체에 13B 활성으로 안내돼요. MoE2 모델은 토큰3마다 전문가 일부를 선택해 계산하므로 활성 수치가 전체보다 작아요. 다음 토큰이나 다른 요청이 다른 전문가를 선택할 수 있어, 실행기는 전체 가중치에 접근할 수 있어야 해요.
가중치가 모두 원시 4비트 값이라고 단순 가정하고 십진 단위로 계산하면 GLM의 320B는 160GB, DeepSeek의 304B는 152GB예요. 이는 실제 파일이나 실행 메모리 측정치가 아니에요. 블록 부가 정보, 혼합 정밀도, KV 캐시4, 런타임 공간을 제외한 산술이라 실제 압축본의 크기와 사용량은 파일과 실행 조건으로 확인해야 해요.
공식 체크포인트의 병렬 실행 조건을 확인해요
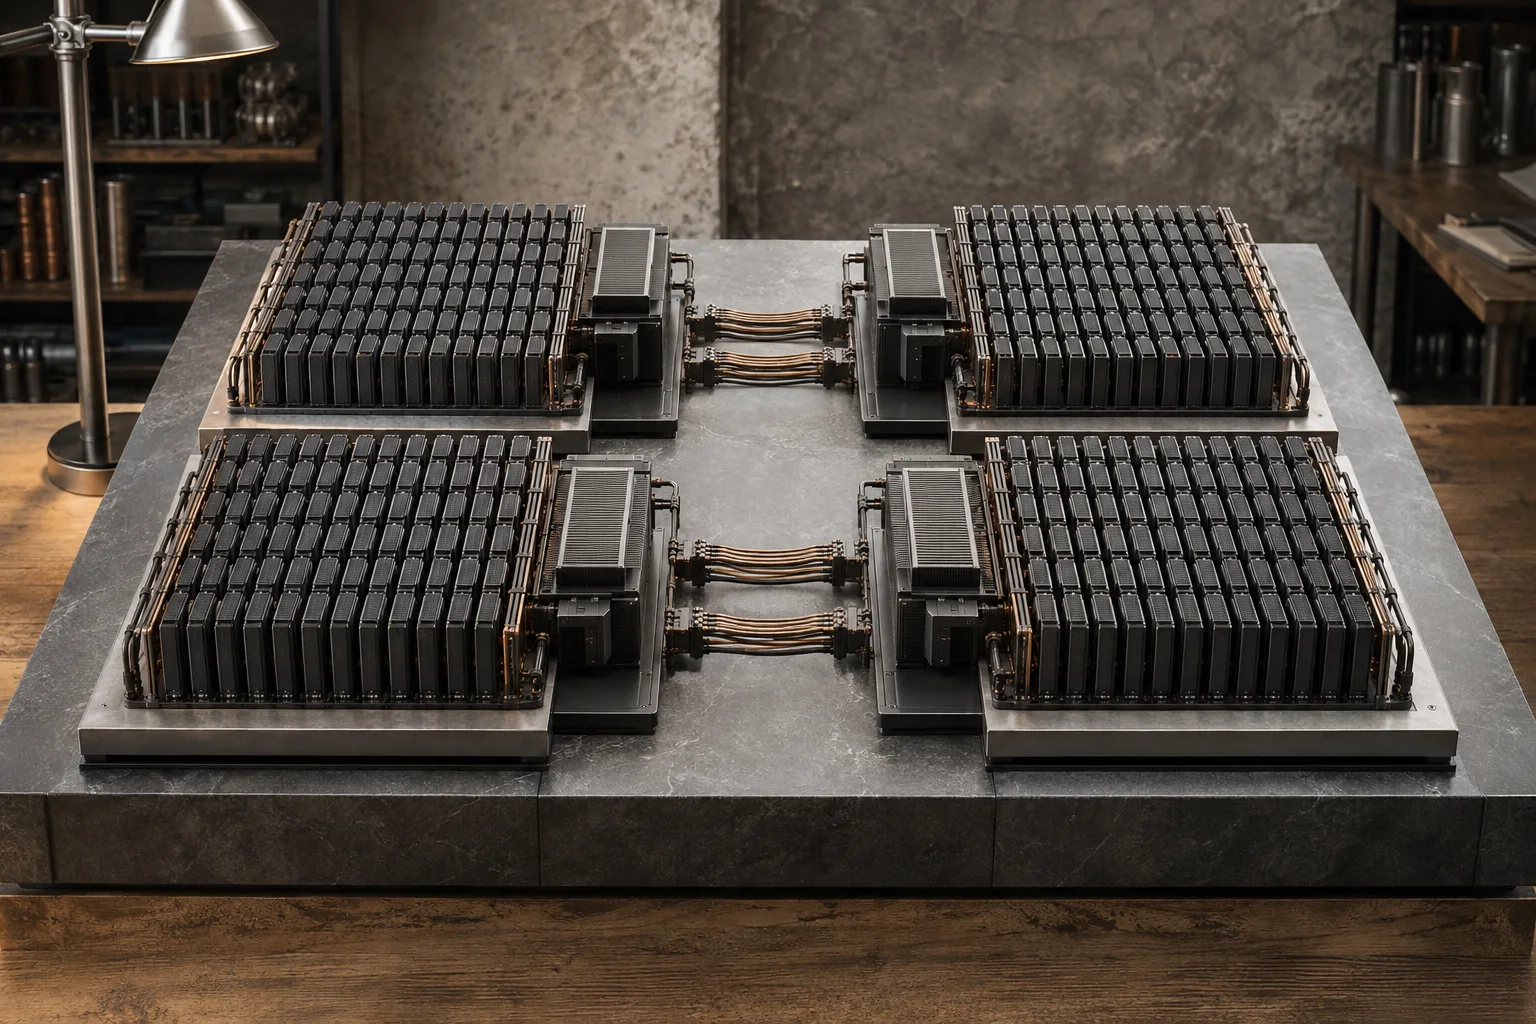
공식 체크포인트5는 가중치를 여러 가속기에 나눠 놓고 계산 중 노드 사이에 결과를 주고받는 실행 경로를 전제로 할 수 있어요. DeepSeek-V4-Flash-0731의 공식 예시는 4×GB300 노드를 사용해요. 이런 예시는 소비자 GPU6 한 장에 설치하는 방법이 아니므로, 먼저 모델 카드에서 서버 구성과 병렬 실행 요건을 확인해요.
카드 수를 맞추는 것만으로는 같은 실행이 되지 않아요. 가중치 분할 방식, 카드별 메모리, 노드 연결, 런타임이 지원하는 병렬 경로가 함께 맞아야 해요. 보유 장비가 그 구성을 지원하는지와 필요한 소프트웨어 경로가 준비됐는지 확인한 뒤에 명령을 따라야 해요.
256GB 통합 메모리 실험은 별도 압축본 경로예요
256GB 통합 메모리7는 호환되는 압축 변환본을 시험할 여지를 넓힐 수 있지만 공식 체크포인트의 서버 경로와 같지 않아요. 운영체제와 앱, 대화 중 캐시도 통합 메모리를 사용하고, 파일을 저장할 수 있다는 사실만으로 선택한 런타임이 그 변환본을 실행한다고 단정할 수 없어요.
실험 파일의 형식과 크기, 해당 앱·런타임 버전에서 같은 모델을 실행한 기록을 먼저 확인해요. 짧은 요청으로 적재와 기본 응답을 확인하고, 이후 팀이 실제로 넣을 코드나 문서 길이로 늘려요. 최대 문맥이 매우 길어도 그 값을 기본으로 쓸 필요는 없어요. 입력을 단계적으로 늘려야 실패 원인을 적재, 문맥, 캐시 중 어디에서 찾아야 할지 알 수 있어요.
팀의 운영 목적에 필요한 규모를 정해요
여러 사용자의 내부 요청을 상시 처리하고 데이터 통제나 처리량8이 중요하다면 가속기 서버와 유지보수 계획을 함께 검토해요. 장애 대응, 업데이트, 모델 파일 보관, 동시 요청 관리도 도입 비용에 포함돼요. 반대로 한 사람이 가끔 문서나 코드를 묻는다면 작은 모델로 먼저 작업을 시험해도 로컬 환경의 효용을 확인할 수 있어요.
같은 저장소 질문을 현재 모델과 후보 모델에 보내 답변의 코드 검토 효용, 한 요청의 완료 시간, 동시에 처리한 요청 수를 비교해요. 데이터 통제와 품질, 운영 비용은 서로 다른 기준이므로 하나의 속도 수치로 대신하지 않아요. 실제로 필요한 가중치 규모와 팀이 감당할 유지보수에 맞춰 서버와 모델을 고르면 돼요.
용어 각주
런타임 — 프로그램이 실행될 때 필요한 기능을 제공하는 소프트웨어 환경입니다. 로컬 AI에서는 모델을 실행하는 엔진을 가리키기도 합니다.
본문으로 돌아가기MoE — 여러 전문가 하위망 중 일부를 입력에 따라 선택해 사용하는 모델 구조입니다. 총 파라미터 수와 한 토큰 처리에 활성화되는 파라미터 수는 다를 수 있습니다.
본문으로 돌아가기토큰 — 모델이 입력이나 출력을 나누어 처리하는 단위입니다.
본문으로 돌아가기KV 캐시 — 어텐션에서 이전 토큰의 키·값을 저장해 다음 토큰 생성 때 재사용하는 메모리입니다. 문맥 길이와 배치 크기에 따라 용량이 달라집니다.
본문으로 돌아가기체크포인트 — 학습된 모델의 가중치 등을 저장한 파일입니다. 같은 모델 계열도 버전이나 용도에 따라 다른 체크포인트를 쓸 수 있습니다.
본문으로 돌아가기GPU — 많은 계산을 병렬로 처리하는 프로세서입니다. AI 모델 실행에서는 모델 계산을 맡습니다.
본문으로 돌아가기통합 메모리 — CPU와 GPU가 같은 물리 메모리 풀을 공유하는 구조입니다.
본문으로 돌아가기처리량 — 일정 시간 동안 처리하거나 생성한 작업량입니다. 토큰/초, 요청/초처럼 단위를 함께 확인해야 비교할 수 있습니다.
본문으로 돌아가기
자주 묻는 질문
- 이 글에서 가장 먼저 확인할 것은 무엇인가요?
- GLM-5.3-Flash와 DeepSeek-V4-Flash는 가중치를 내려받아 자체 서버에서 질문과 코드에 대한 텍스트 답변을 생성하는 대형 오픈웨이트 모델이에요. 팀이 모델을 직접 운영하려면 전체 가중치를 담을 메모리, 병렬 실행을 지원하는 장비와 런타임, 요청을 받을 서버 설정을 준비해요.
- 필요한 메모리는 어느 정도인가요?
- 가중치가 모두 원시 4비트 값이라고 단순 가정하고 십진 단위로 계산하면 GLM의 320B는 160GB, DeepSeek의 304B는 152GB예요. 이는 실제 파일이나 실행 메모리 측정치가 아니에요. 블록 부가 정보, 혼합 정밀도, KV 캐시, 런타임 공간을 제외한 산술이라 실제 압축본의 크기와 사용량은 파일과 실행 조건으로 확인해야 해요.
- 조건과 출처는 어디서 확인하나요?
- 공식 체크포인트는 가중치를 여러 가속기에 나눠 놓고 계산 중 노드 사이에 결과를 주고받는 실행 경로를 전제로 할 수 있어요. DeepSeek-V4-Flash-0731의 공식 예시는 4×GB300 노드를 사용해요. 이런 예시는 소비자 GPU 한 장에 설치하는 방법이 아니므로, 먼저 모델 카드에서 서버 구성과 병렬 실행 요건을 확인해요.