
답변 속도와 가속
최종 업데이트
MTP란? 다중 토큰 예측의 원리와 조건
MTP는 다음 토큰 후보를 만들고 본 모델이 맞는 구간을 확인해요
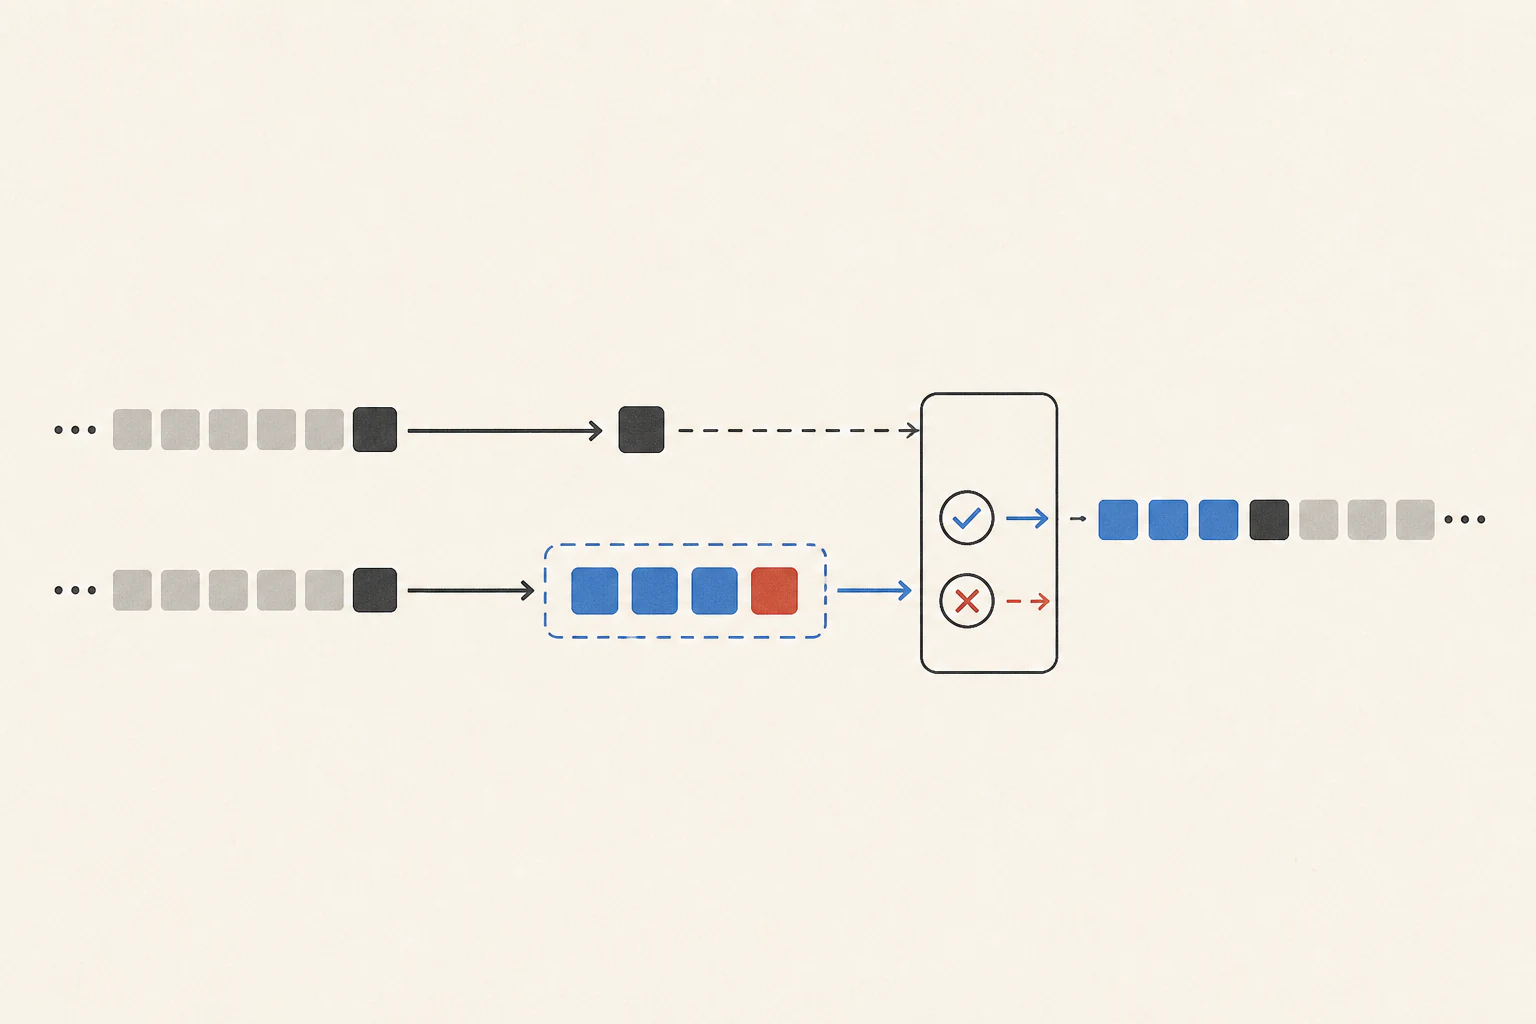
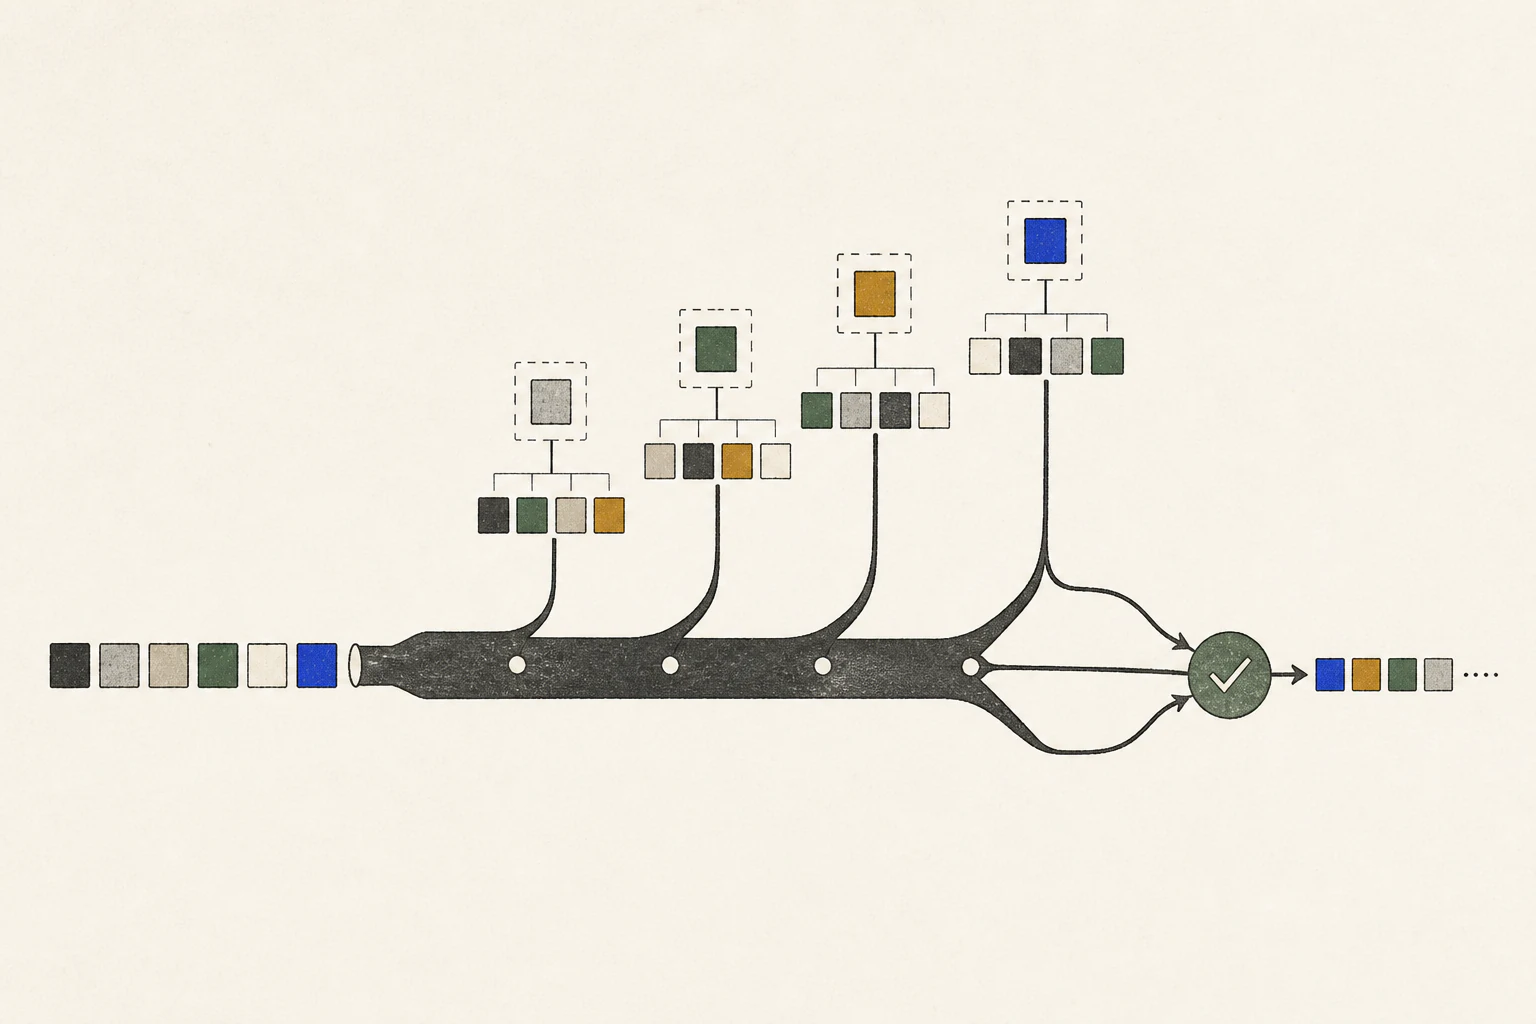
MTP1는 답변의 다음 토큰2 후보를 미리 만들어, 여러 토큰을 묶어서 검증하는 생성 방식이에요. 추가 예측 헤드가 후보를 준비하고 본 모델이 승인한 연속 구간을 답변에 반영해요. 후보가 얼마나 잘 맞는지에 따라 실제 생성 속도가 달라지므로, 같은 코드 수정 요청으로 기본 생성과 비교해볼게요.
함수 이름을 바꾸고 빈 입력 오류 처리를 추가하는 코드를 부탁했다고 해볼게요. 일반 생성은 다음 토큰을 정한 뒤 그 결과를 포함해 다음 토큰을 다시 계산해요. MTP는 예측 헤드가 뒤에 올 후보를 먼저 준비해 본 모델이 여러 자리를 함께 확인할 수 있게 해요. 후보를 세 개 만들어도 검증을 통과한 것만 답에 남아요.
본 모델은 후보 가운데 맞는 연속 구간을 승인해요
예를 들어 세 후보 가운데 첫 토큰만 맞으면 그 후보는 남고 뒤의 두 개는 버려요. 모델은 어긋난 지점부터 답을 이어가므로 버린 후보를 출력하지는 않지만, 그 후보를 준비하고 검증하는 계산은 들었어요. 반대로 세 토큰이 연이어 맞으면 본 모델이 일부 순차 계산을 줄일 수 있어요.
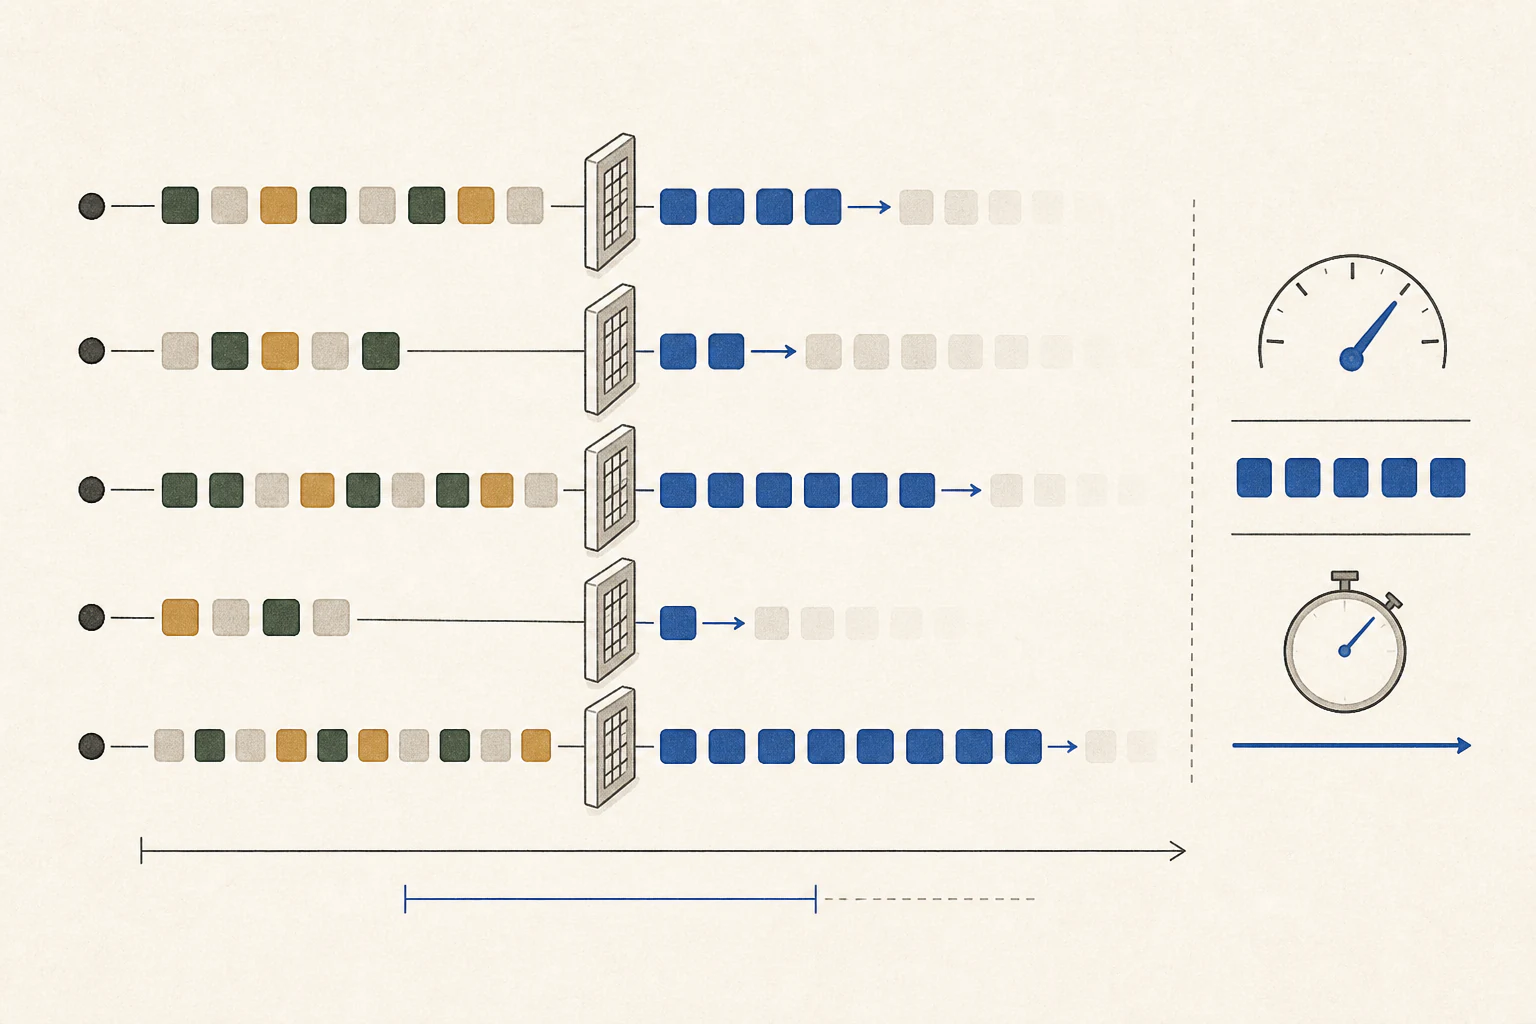
따라서 제안 깊이가 길수록 항상 빠르지는 않아요. 후보가 자주 어긋나면 버리는 계산이 늘고, 이어지는 후보가 자주 승인되면 순차 계산을 줄일 여지가 커져요. 예측 토큰 수가 아니라 실제 요청의 완료 시간을 비교해요.
실행 버튼보다 모델 파일과 런타임 지원을 확인해요
같은 코드 수정으로 MTP 전후 시간을 비교해요
먼저 MTP를 끈 채 파일·질문·요청 길이로 기준 답변을 만들고, 같은 모델 파일에서 MTP 설정만 바꿔 실행해요. 준비 실행 뒤 두 상태를 각각 세 번 재서 중앙값을 비교하고, 모델을 다시 불러오는 비용은 별도로 기록해요. 대화 캐시나 함께 실행한 앱도 양쪽에서 같은 조건으로 맞춰요.
입력 처리가 오래 걸리는지 답변 생성이 느린지 먼저 살펴요. MTP가 겨냥하는 것은 주로 뒤의 생성 구간이에요. PDF 검색이나 긴 입력 뒤 첫 답이 늦다면 프리필6과 문서 전달도 따로 측정해요.
요청부터 첫 토큰까지의 TTFT7, 그 뒤 디코드8, 전체 완료 시간을 나눠요. 디코드 tok/s는 첫 토큰 뒤 생성한 토큰 수를 디코드 시간으로 나누고, 로딩과 TTFT는 포함하지 않아요. 두 답의 수정 범위와 생성 토큰 수가 비슷한지 함께 확인해요.
결과 코드에서 함수 이름과 호출부, 빈 입력 오류, 정상 입력 처리를 확인해요. 후보 토큰 검증은 사용자의 요구사항 검사가 아니므로, 시간이 줄어도 수정 범위가 빠졌다면 같은 일을 더 빨리 끝낸 게 아니에요.
속도 이득이 없을 때는 실패 구간에 맞춰 조정해요
경로가 적용됐는데 디코드 시간이 달라지지 않았다면 이번 요청에서 이득을 관찰하지 못한 거예요. 긴 PDF에서 첫 답이 늦으면 프리필과 검색을, 메모리 오류면 입력 길이와 캐시를 먼저 살펴요.
반복 측정에서 MTP가 실제 완료 시간을 줄이고 코드가 요구대로 동작하면 현재 장비를 계속 써도 돼요. 반대로 MTP가 지원되지 않거나 결과가 비슷하다면 광고의 최고 가속 수치를 구매 판단 근거로 삼지 말고, 지금 작업이 멈춘 다른 구간부터 해결해요.
용어 각주
MTP — 한 번에 여러 미래 토큰을 예측하도록 학습하는 목표 또는 이를 수행하는 모델 구성입니다. 추측 디코딩에서는 이 예측을 후보 토큰으로 제안할 수 있습니다.
본문으로 돌아가기토큰 — 모델이 입력이나 출력을 나누어 처리하는 단위입니다.
본문으로 돌아가기체크포인트 — 학습된 모델의 가중치 등을 저장한 파일입니다. 같은 모델 계열도 버전이나 용도에 따라 다른 체크포인트를 쓸 수 있습니다.
본문으로 돌아가기런타임 — 프로그램이 실행될 때 필요한 기능을 제공하는 소프트웨어 환경입니다. 로컬 AI에서는 모델을 실행하는 엔진을 가리키기도 합니다.
본문으로 돌아가기양자화 — 모델의 가중치나 계산값을 더 적은 비트로 표현해 저장 공간과 메모리 사용량을 줄이는 방법입니다. 표현 단계가 거칠어져 정확도에도 영향을 줄 수 있습니다.
본문으로 돌아가기프리필 — LLM이 입력 프롬프트를 읽고 각 토큰의 내부 표현을 계산하는 단계입니다. 입력이 길수록 처리할 토큰이 많아집니다.
본문으로 돌아가기첫 토큰 지연 — 요청을 보낸 뒤 첫 출력 토큰이 도착하기까지 걸린 시간입니다.
본문으로 돌아가기토큰 디코드 — 입력과 앞서 만든 답변을 바탕으로 다음 출력 토큰을 차례로 생성하는 단계입니다.
본문으로 돌아가기
자주 묻는 질문
- 이 글에서 가장 먼저 확인할 것은 무엇인가요?
- MTP는 답변의 다음 토큰 후보를 미리 만들어, 여러 토큰을 묶어서 검증하는 생성 방식이에요. 추가 예측 헤드가 후보를 준비하고 본 모델이 승인한 연속 구간을 답변에 반영해요. 후보가 얼마나 잘 맞는지에 따라 실제 생성 속도가 달라지므로, 같은 코드 수정 요청으로 기본 생성과 비교해볼게요.