
답변 속도와 가속
최종 업데이트
llama.cpp에서 DFlash와 DSpark 실행하기: Qwen3-4B로 확인
DFlash·DSpark는 작은 초안이 후보를 내고 본 모델이 검증해요
추측 디코딩1은 작은 초안 모델이 다음 토큰2 후보를 먼저 만들고, 본 모델이 이를 확인해 연속으로 맞는 토큰을 답에 반영하는 생성 방식이에요. llama.cpp에서 Qwen3-4B를 쓸 때는 target과 짝이 맞는 DFlash 또는 DSpark draft GGUF3를 각각 준비해 한 번에 하나씩 비교해요.
코드 검토 답변이 시작된 뒤 문장을 이어 쓰는 시간이 길다면 생성 구간을 시험할 수 있어요. 첫 글자 전부터 기다림이 길다면 PDF 검색, 입력 처리나 메모리 조건이 원인일 수 있으므로 초안 후보를 추가하는 것만으로 줄지 않아요.
Qwen3-4B 하나로 기본 서버를 먼저 확인해요
같은 저장소 함수 하나를 고치고 빈 입력과 정상 입력을 처리하게 하는 요청을 기본 실행과 draft 실행에 똑같이 보내요. diff와 테스트로 수정 요구가 지켜졌는지도 확인해요. 초안 후보를 만들고 본 모델이 여러 자리를 확인할 수 있어도 후보 생성과 검증에 비용이 있으므로 실제 결과로 판단해요.
이 명령은 모델을 지원하는 llama.cpp 빌드와 소스 폴더의 convert_hf_to_gguf.py를 준비한 상태에서 실행해요. 소스 폴더에서 Hugging Face 원본을 받고 GGUF로 변환한 뒤 target 서버를 열어요. 문맥 4,096토큰과 요청 한 개로 기준을 고정해요. 기본 서버가 답하지 않으면 모델 경로·빌드 지원·메모리를 먼저 살펴요.
hf download Qwen/Qwen3-4B --local-dir ./hf-models/Qwen3-4B
python convert_hf_to_gguf.py ./hf-models/Qwen3-4B --outfile ./models/Qwen3-4B.gguf --outtype bf16
llama-server -m ./models/Qwen3-4B.gguf --alias qwen3-4b --host 127.0.0.1 --port 8080 --ctx-size 4096 --parallel 1 --n-gpu-layers autocurl -sS http://127.0.0.1:8080/health
curl -sS http://127.0.0.1:8080/v1/chat/completions -H 'Content-Type: application/json' -d '{"model":"qwen3-4b","messages":[{"role":"user","content":"Reply with one short sentence."}],"temperature":0,"max_tokens":64,"stream":false}'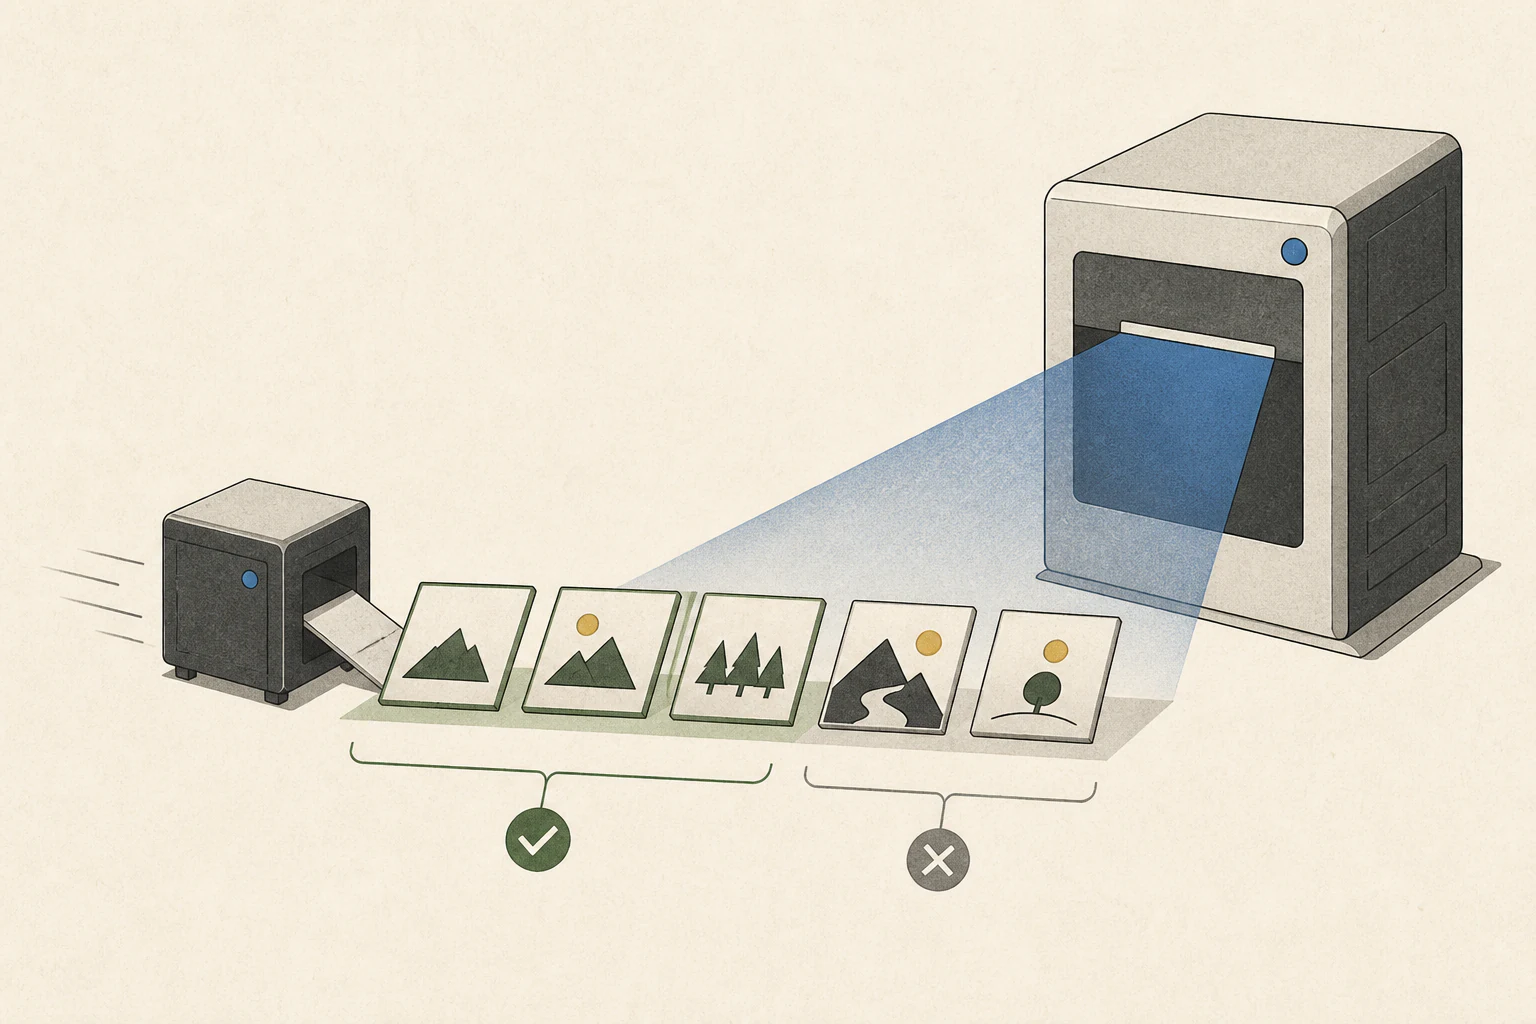
target과 짝이 맞는 DFlash 또는 DSpark를 선택해요
공식 예시에서 z-lab/Qwen3-4B-DFlash는 Qwen/Qwen3-4B target과 짝지어요. DFlash는 block diffusion draft를, DSpark는 여기에 Markov head를 더한 구조를 사용해요. 임의의 작은 모델을 대체 파일로 고르지 말고 target용으로 학습된 draft를 사용해요.
아래 명령은 두 모델 원본 디렉터리가 준비됐다는 전제예요. Qwen3-4B target은 그대로 두고 변환한 draft를 한 번에 하나씩 연결해요. 예시 초안 상한은 DFlash 15, DSpark 7이며 학습된 block 크기에 맞춰 제한될 수 있어요. 다른 모델에는 카드와 변환 결과를 확인해 값을 맞춰요.
각 비교는 8080 포트를 사용하는 서버 하나씩 진행해요. 기본 서버를 실행한 터미널에서 Ctrl+C를 눌러 종료하고 DFlash 서버를 시작하세요. 서버가 준비되면 다른 터미널에서 같은 질문을 보내 결과를 기록해요.
DFlash를 종료한 뒤 같은 순서로 DSpark를 시험해요. 두 draft 모델은 서버를 시작하기 전에 다운로드와 변환을 마쳐 두세요.
hf download z-lab/Qwen3-4B-DFlash --local-dir ./hf-models/Qwen3-4B-DFlash
python convert_hf_to_gguf.py ./hf-models/Qwen3-4B-DFlash --target-model-dir ./hf-models/Qwen3-4B --outtype bf16 --outfile ./models/Qwen3-4B-DFlash.gguf
# Stop the previous server with Ctrl+C before starting this one.
llama-server -m ./models/Qwen3-4B.gguf -md ./models/Qwen3-4B-DFlash.gguf --spec-type draft-dflash --spec-draft-n-max 15 -fa on --jinja --host 127.0.0.1 --port 8080 --ctx-size 4096 --parallel 1

hf download deepseek-ai/dspark_qwen3_4b_block7 --local-dir ./hf-models/dspark_qwen3_4b_block7
python convert_hf_to_gguf.py ./hf-models/dspark_qwen3_4b_block7 --target-model-dir ./hf-models/Qwen3-4B --outtype bf16 --outfile ./models/Qwen3-4B-DSpark.gguf
# Stop the previous server with Ctrl+C before starting this one.
llama-server -m ./models/Qwen3-4B.gguf -md ./models/Qwen3-4B-DSpark.gguf --spec-type draft-dspark --spec-draft-n-max 7 -fa on --jinja --host 127.0.0.1 --port 8080 --ctx-size 4096 --parallel 1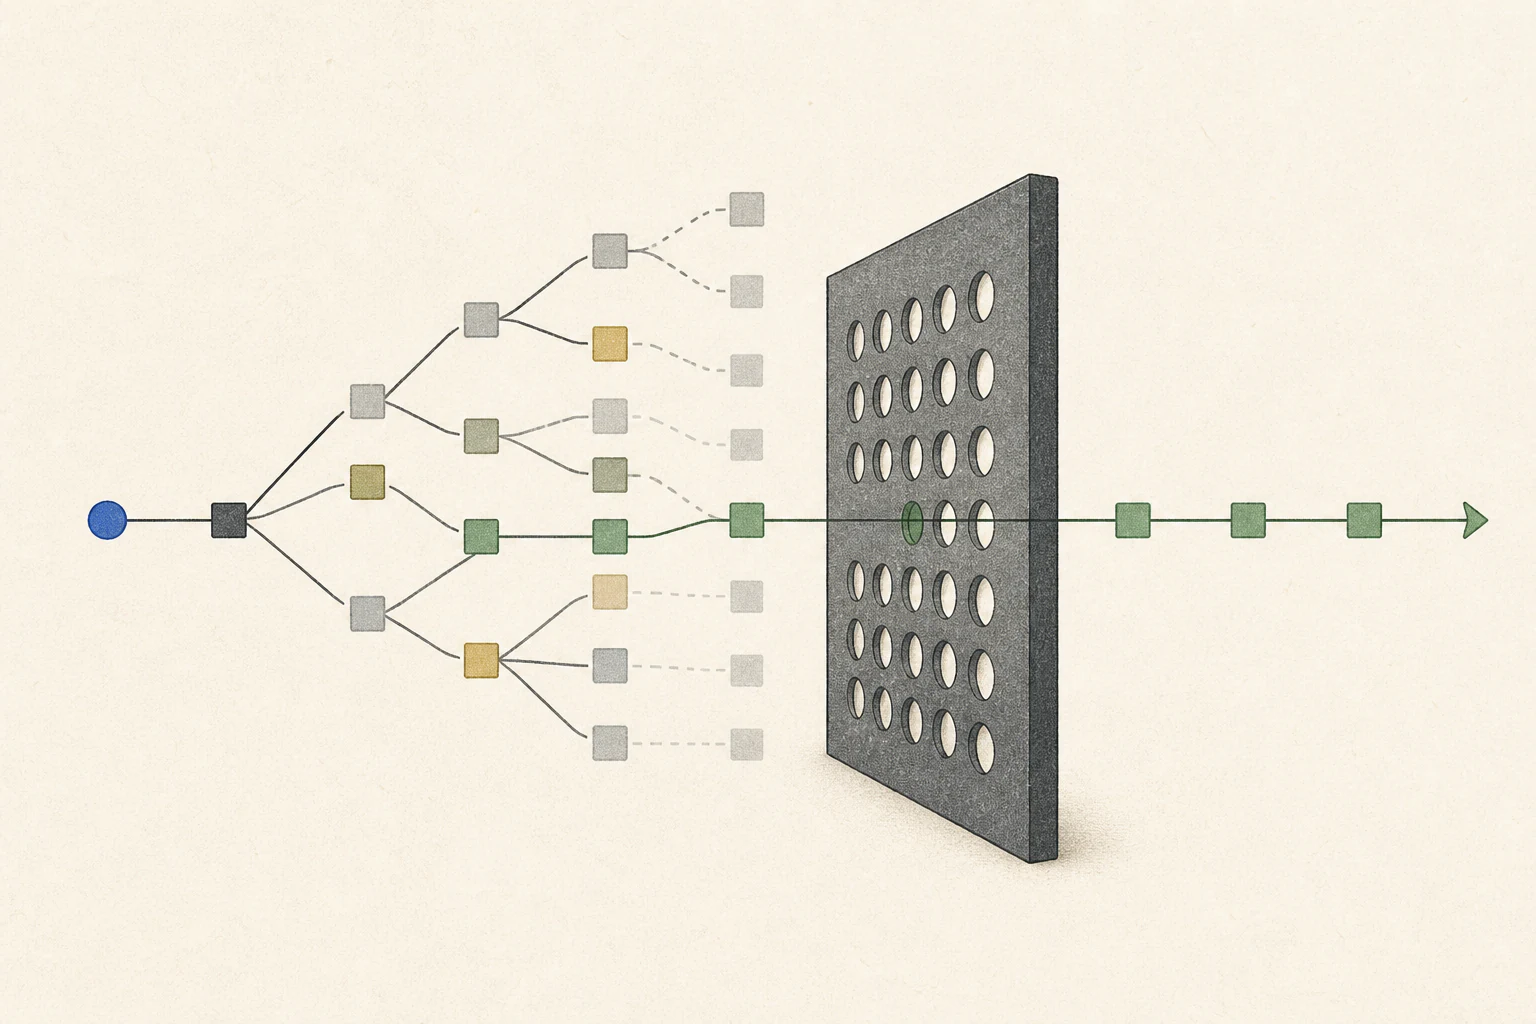
로그와 응답에서 draft 경로가 적용됐는지 봐요
각 서버 로그에서 draft 파일이 열리고 DFlash 또는 DSpark가 초기화됐는지 확인해요. 실제 연결 없이 본 모델만 답한 실행은 가속 비교에 넣지 않아요. 서버가 준비되면 같은 요청을 보내 JSON의 choices[0].message.content에 답이 있는지 확인하고, 모델 식별자와 오류 로그도 살펴요.
실행 전과 비교할 때 같은 모델 파일·프롬프트4·sampling·문맥·출력 제한·장치 상태를 유지해요. 준비 실행 뒤 여러 번 돌려 중앙값과 범위를 기록하고, 서버를 새로 띄운 첫 회와 모델이 올라온 실행을 따로 적어요. greedy 요청으로 답의 차이를 비교하고, 코드 diff와 테스트로 수정 범위도 확인해요.
기록에는 완료 시간·생성 토큰 수·speculative 통계의 draft/accepted 길이·메모리를 남겨요. accepted 토큰 수만으로 사용자 대기가 줄었다고 판단하지 말고 같은 요청의 디코드5와 전체 완료도 비교해요. draft 초기화나 메모리 오류가 나면 draft를 빼고 기본 서버가 다시 답하는지 확인한 뒤 파일·backend·block 상한을 하나씩 살펴요.
추가 메모리와 실제 작업 이득을 함께 판단해요
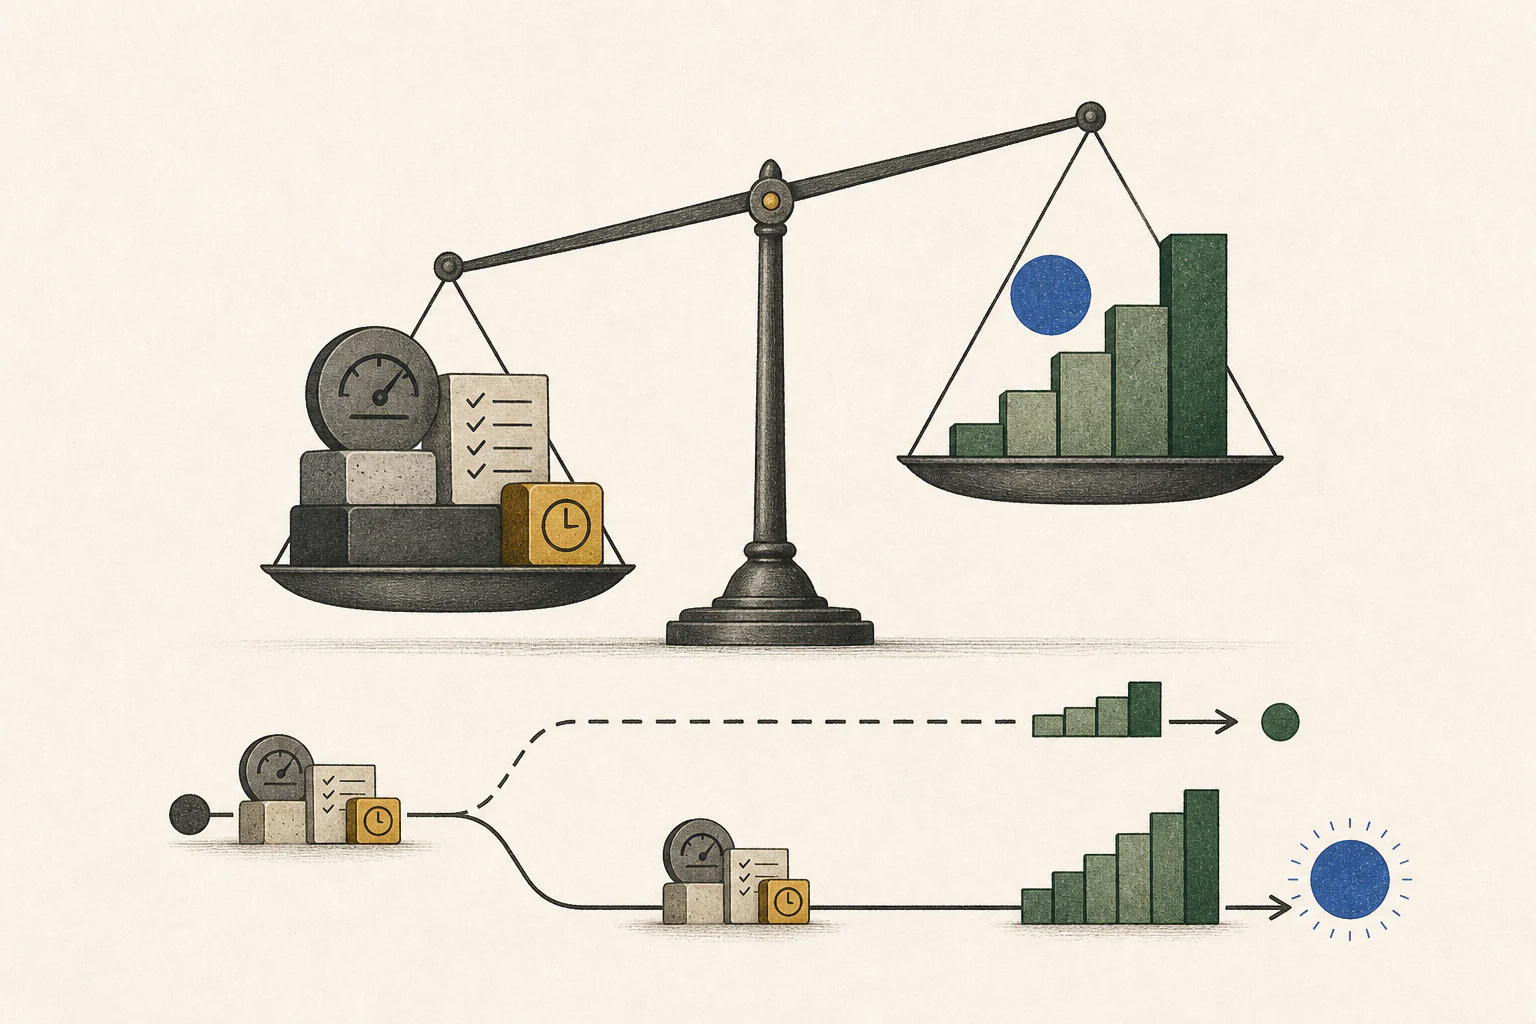
초안 모델은 메모리를 추가로 써요. 코드 답변 생성이 반복해서 빨라지고 요청한 수정과 테스트 결과도 유지되며 메모리가 충분하면 해당 target·장치·backend 조합의 설정으로 기록할 수 있어요. 긴 입력의 첫 토큰 대기가 주된 병목이거나 메모리를 좁혀야 한다면 draft를 추가하는 이득이 제한적일 수 있어요.
다른 target·양자화6·장치에서도 같은 결과라고 기대하지 않아요. 모델과 실행기를 바꿀 때마다 공식 지원 조합, 로드 로그, 같은 요청의 완료 시간을 다시 확인해요.
용어 각주
추측 디코딩 — 초안 모델·MTP 헤드·반복 문맥 조회가 출력 후보를 먼저 만들고, 본 모델이 후보를 검증해 확정하는 생성 기법입니다.
본문으로 돌아가기토큰 — 모델이 입력이나 출력을 나누어 처리하는 단위입니다.
본문으로 돌아가기GGUF — 모델 정보를 담는 파일 형식으로 llama.cpp 계열 도구에서 널리 사용됩니다.
본문으로 돌아가기프롬프트 — 모델에 보내는 입력문입니다. 생성 모델에서는 만들 결과를 설명하는 문장이 되어 출력의 구성과 내용을 크게 좌우합니다.
본문으로 돌아가기토큰 디코드 — 입력과 앞서 만든 답변을 바탕으로 다음 출력 토큰을 차례로 생성하는 단계입니다.
본문으로 돌아가기양자화 — 모델의 가중치나 계산값을 더 적은 비트로 표현해 저장 공간과 메모리 사용량을 줄이는 방법입니다. 표현 단계가 거칠어져 정확도에도 영향을 줄 수 있습니다.
본문으로 돌아가기
자주 묻는 질문
- 이 글에서 가장 먼저 확인할 것은 무엇인가요?
- 추측 디코딩은 작은 초안 모델이 다음 토큰 후보를 먼저 만들고, 본 모델이 이를 확인해 연속으로 맞는 토큰을 답에 반영하는 생성 방식이에요. llama.cpp에서 Qwen3-4B를 쓸 때는 target과 짝이 맞는 DFlash 또는 DSpark draft GGUF를 각각 준비해 한 번에 하나씩 비교해요.
- 필요한 메모리는 어느 정도인가요?
- 기록에는 완료 시간·생성 토큰 수·speculative 통계의 draft/accepted 길이·메모리를 남겨요. accepted 토큰 수만으로 사용자 대기가 줄었다고 판단하지 말고 같은 요청의 디코드와 전체 완료도 비교해요. draft 초기화나 메모리 오류가 나면 draft를 빼고 기본 서버가 다시 답하는지 확인한 뒤 파일·backend·block 상한을 하나씩 살펴요.