
実行プログラムと拡張機能
最終更新
SGLang HiCache:GPU・CPU・ストレージにKVを分散して再利用する
SGLangでローカルLLMサーバーを起動し繰り返し入力を高速化する
SGLangはモデルを実行し、API1で受け取った質問に回答を生成するLLM2サーバーです。同じ指示や文書を再度入力したときは、前に計算した状態をキャッシュから再利用して最初の応答までの待ち時間を短縮できます。まず接続を確認し、HiCacheでGPU3メモリ(L1)、ホストメモリ(L2)、対応ストレージ(L3)にキャッシュを分けて保存する方法を見ていきます。
同じリポジトリを繰り返し説明するコード支援では、システム指示や前のコードが毎回同じ場合があります。HiCacheは共通入力を処理したKV状態をGPUメモリ外にも保持して再利用できます。新しいコード・文書の初回要求と追加質問を分けて比較します。
Spark・PC・Macでは導入経路が異なる
小型モデルでサーバーとAPI接続を先に確認
追加高速化の前にQwen2.5-0.5B-Instructが質問へ応答するか確認します。コンテキスト上限4096・同時要求1件は接続確認条件であり最高速度設定ではありません。初回モデル取得時間はサーバー準備・推論応答と分けて記録します。
サーバーでモデル準備が終わってからcurlで短い質問を送ります。127.0.0.1はこのコンピューター内のloopbackアドレスで、アプリにはOpenAI互換endpoint http://127.0.0.1:30000/v1を指定できます。応答は接続の基準であり大型モデルの品質・速度は別途確認します。
python3 -m sglang.launch_server \
  --model-path Qwen/Qwen2.5-0.5B-Instruct \
  --host 127.0.0.1 --port 30000 \
--context-length 4096 --max-running-requests 1curl --fail-with-body http://127.0.0.1:30000/v1/chat/completions \
-H "Content-Type: application/json" \
-d '{"model":"Qwen/Qwen2.5-0.5B-Instruct","messages":[{"role":"user","content":"Explain what a local AI server does in two sentences."}],"max_tokens":64,"temperature":0}'
Radix cacheとHiCacheは共通prefixを再利用
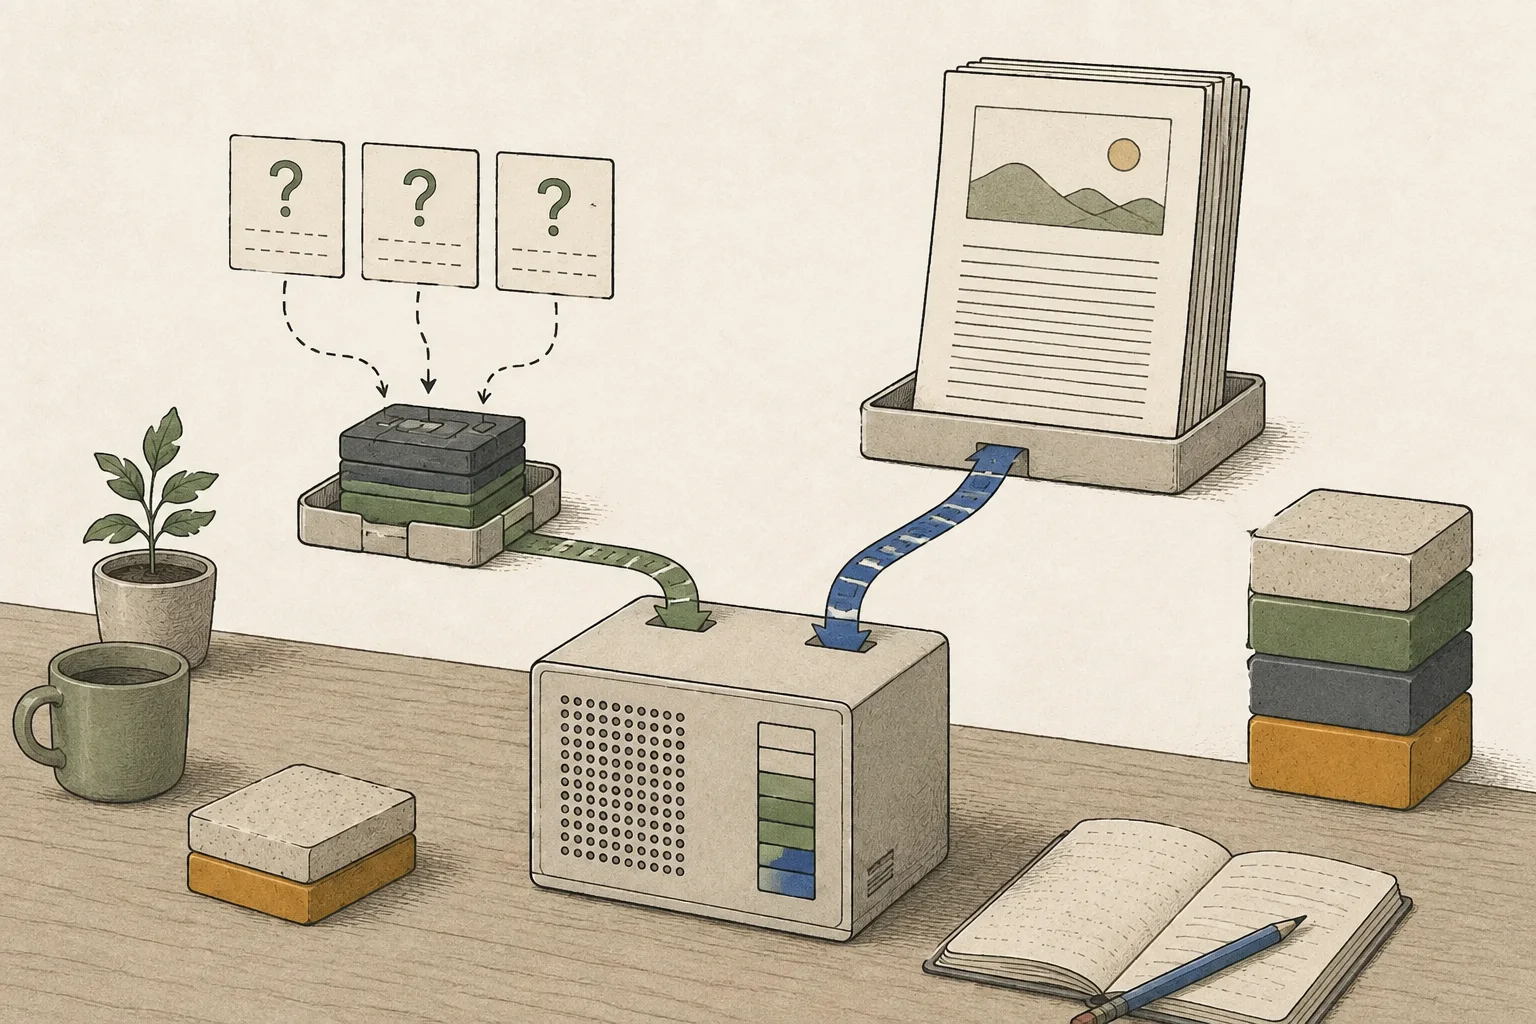
GPU・ホストメモリ・ストレージ階層を区別
HiCacheのL1はGPUメモリ、L2はhost memory、L3はファイルまたは外部storage backendです。GPUに残る状態は速く再利用できますが、容量が必要になるとhost tierへ退避される場合があります。L3にファイルがあっても後続要求でprefix keyとモデル条件が一致して初めて再利用できます。
CPU tierは保存容量を増やしますがhost帯域と転送が加わります。ファイルbackendはNVMe11 read・ページキャッシュ・index管理を要求経路に加えます。終了後にファイルが残ることと即時cache hitは異なります。
SGLang 0.5.20はUnifiedTreeのSWA・Mamba hybrid HiCache対応を紹介し、そのhybrid経路の既定接続変更は0.5.13に記録されています。全モデル・機器・storage backendの組み合わせが互換という意味ではないため、architecture対応を確認します。
host cacheから始め実行状態を確認
以下はNVIDIA CUDA上のSGLang 0.5.20とopenai/gpt-oss-20bを使う接続基準です。GPUメモリが足りるか公式モデルカードと対応資料で先に確認します。コンテキスト8192・同時要求1件は接続確認値です。--enable-hierarchical-cacheと--hicache-ratio 2を設定してもデータ容量2倍を保証しないため、起動ログで実際のpoolを確認します。
サーバー起動後は/healthと同じモデルIDのchat completionを確認します。初回応答とcold状態を別に記録し、モデル読み込み・cache pool・CUDA初期化ログを見ます。この要求は速度測定ではないため、file tierや同時要求を一度に追加しません。
ホストキャッシュの起動前に、前の基準サーバーをCtrl+Cで止めます。両例は30000ポートを使います。新しいモデルとキャッシュプールの準備後、別ターミナルで下の状態確認と質問を送ってください。
python -m sglang.launch_server --model-path openai/gpt-oss-20b --host 127.0.0.1 --port 30000 --context-length 8192 --max-running-requests 1 --enable-hierarchical-cache --hicache-ratio 2 --hicache-io-backend kernel --hicache-mem-layout page_firstcurl -sS http://127.0.0.1:30000/health
curl -sS http://127.0.0.1:30000/v1/chat/completions -H 'Content-Type: application/json' -d '{"model":"openai/gpt-oss-20b","messages":[{"role":"user","content":"Review this Python function for empty-list input and suggest a minimal fix: def first_item(items): return items[0]"}],"temperature":0,"max_tokens":96,"stream":false}'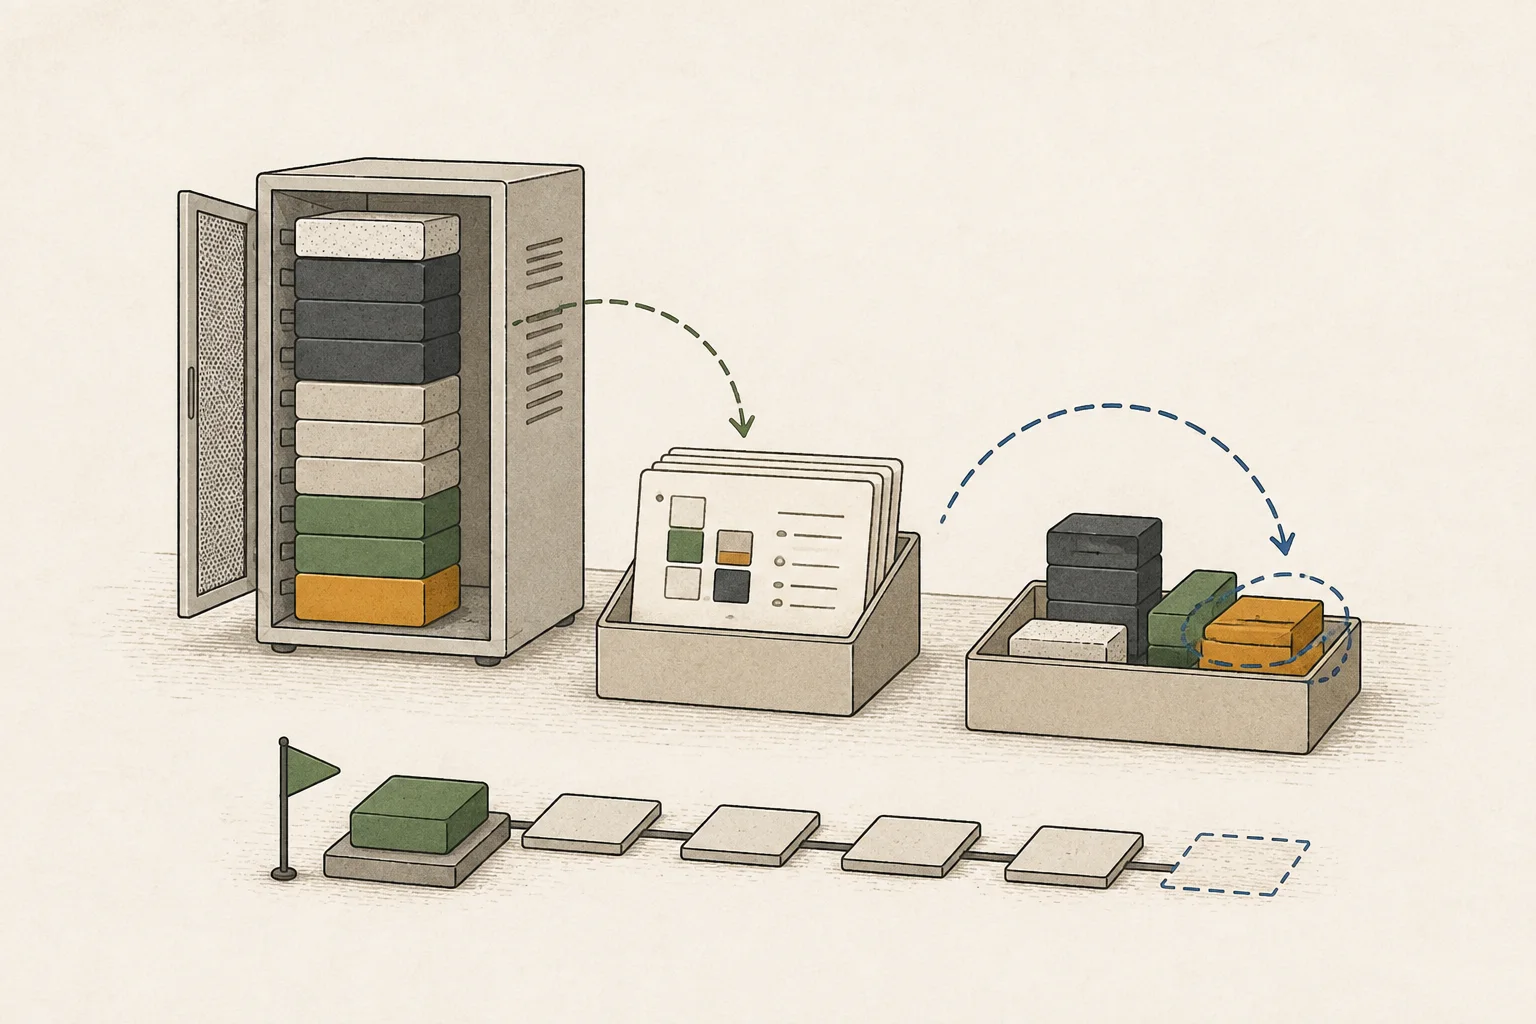
同じprefix・新規文書・eviction後の復元を分けて記録
最初の関数要求後、同じ会話にテストログ1行だけ追加して質問します。cache統計でhit token12や再利用prefixを確認し、別関数・別ログの新規入力条件と比較します。入力長で計算量が変わるため、異なる要求の完了時間だけを比べません。
file tierの試験では別NVMeパスを使い、SGLang file backendが実際に接続されたか確認します。SGLANG_HICACHE_FILE_BACKEND_STORAGE_DIRはキャッシュファイルの場所を指定し、モデル取得先やOS swapではありません。
cold と warm のリクエストを分けて試します。GPU メモリから退避したエントリの復元後と、eviction 後の再リクエストも記録してください。
NVMe read、ページキャッシュ、cache key の一致を確認します。hit 統計を確認してから、storage tier の状態が再利用されたと判断してください。
ファイル層はホストキャッシュの設定を変えて再起動する試験です。Ctrl+Cで止め、キャッシュ位置を指定して下のコマンドを実行します。再起動後の最初のリクエストと同じ入力の繰り返しを別々に記録すると再利用を比較できます。
mkdir -p /mnt/nvme/sglang-hicache
export SGLANG_HICACHE_FILE_BACKEND_STORAGE_DIR=/mnt/nvme/sglang-hicache
python -m sglang.launch_server --model-path openai/gpt-oss-20b --host 127.0.0.1 --port 30000 --context-length 8192 --max-running-requests 1 --enable-hierarchical-cache --hicache-ratio 2 --hicache-io-backend kernel --hicache-mem-layout page_first --hicache-storage-backend filehybrid attentionのSWA・Mamba状態も確認
GPT-OSSのようにsliding-window attention13を含むモデルは全トークン状態を一様に再利用しません。FULL attention prefixが残っていてもwindowに必要な状態が不足すればそのままhitできない場合があります。SGLang UnifiedTreeはhybrid要素を管理し、0.5.20はSWA・Mamba hybrid HiCacheを説明しますが全モデル・backendで共通対応ではありません。
新prefix・同じprefix・eviction後の再要求を分け、コンテキスト長・cache hit・TTFT14・完了時間・host RAM15・NVMe IOを記録します。GPUに残るwarm cacheとL3から再読込した要求も分けます。
HiCacheはMTP・NGRAMとは別機能
MTP16は次トークン候補を提案する生成高速化、NGRAM17 speculative decoding18は過去トークンから候補を探す生成経路です。PLE19 offload20は大きな埋め込み表をRAM・SSD21に置く保存・読み込み方式です。HiCacheは共通prefixの計算状態を保持・再利用するため、これらの設定を一括で扱いません。
SGLangのMTP speculative設定にはモデルに合うalgorithm・depth・widthが必要です。資料ではNEXTNをEAGLEの別名として使いますが、全Qwen・Gemma・GLMファイルが同じコマンドに対応する意味ではありません。版とモデル対応を確認し機能を一つずつ有効にします。
Radix cacheの入力再利用とMTP・NGRAMの候補検証は別の段階です。2回目のリクエストが速かっただけではどちらが働いたか分からないため、統計と応答区間を機能ごとに分けて比較してください。
利用版の公式対応資料を記録
SGLang 0.5.13・0.5.20のリリースとHiCache設計資料で導入・対応条件を確認します。再現時はモデルID・SGLang版・GPU・backendも記録します。
用語の注釈
API — 別のコードからプログラムの機能を呼び出すための決められたインターフェースです。
本文に戻る大規模言語モデル — 大量のテキストデータから言語パターンを学び、文脈に沿ったテキストを処理・生成するモデルです。
本文に戻るGPU — 多くの計算を並列に処理するプロセッサーです。AIモデルの実行ではモデル計算を担います。
本文に戻るCUDA — NVIDIA GPUで汎用計算を行うソフトウェア基盤です。
本文に戻るPyTorch — AIモデルを作成・実行するソフトウェアフレームワークです。モデルと合わせて、対応するPyTorchの版やハードウェアも確認します。
本文に戻るGPUカーネル — GPU上で並列実行され、行列積や正規化などの処理を行うコードです。
本文に戻るCPU — OSや一般的なプログラム命令を実行する中央処理装置です。AIでは前処理やデータ転送などの汎用処理も担います。
本文に戻るMLX — Appleが開発する機械学習フレームワークで、Apple SiliconのCPUとGPUが共有するメモリを使ってモデルを実行します。
本文に戻るKVキャッシュ — 過去トークンのAttention用キー・バリューを保存し、後続トークン生成で再利用するメモリです。容量はコンテキスト長やバッチサイズで変わります。
本文に戻るプリフィル — LLMが入力プロンプトを読み、各トークンの内部表現を計算する段階です。プロンプトが長いほど処理するトークンが増えます。
本文に戻るNVMe — SSDがPCI Express経由で通信する際に使うストレージ用プロトコルです。
本文に戻るトークン — モデルが入力や出力を分けて処理する単位です。
本文に戻るAttention — 入力トークン間の関連度を計算し、各位置の情報を現在の表現に反映するニューラルネットワーク演算です。
本文に戻る最初のトークンまでの時間 — リクエスト送信から最初の出力トークンが届くまでの時間です。
本文に戻るシステムRAM — プログラムの実行中にデータを一時保存するシステムメモリです。
本文に戻るMTP — 複数の将来トークンを一度に予測する学習目標、またはそれを行うモデル構成です。投機的デコーディングでは、その予測を候補トークンとして提案できます。
本文に戻るn-gram — 連続するn個のトークンまたは項目からなる列です。文脈検索や投機的生成に使われるほか、一部モデルでは埋め込みテーブルの項目にもなります。
本文に戻る投機的デコーディング — ドラフトモデル、MTPヘッド、反復文脈の検索が出力候補を先に作り、メインモデルが検証して確定する生成手法です。
本文に戻るPLE埋め込みテーブル — Per-Layer Embeddingの略で、モデルの特定の層に埋め込み情報を加える構造です。Qwen Flash-Next系はn-gramテーブルを使い、対応する実行環境ではRAMやSSDへオフロードできます。
本文に戻るオフロード — 容量が足りないとき、モデルデータの一部をGPUメモリからシステムRAMやストレージへ移して処理する方法です。データ転送が追加されます。
本文に戻るSSD — フラッシュメモリを使うデータ保存装置です。電源を切ってもデータが保持されます。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- SGLangはモデルを実行し、APIで受け取った質問に回答を生成するLLMサーバーです。同じ指示や文書を再度入力したときは、前に計算した状態をキャッシュから再利用して最初の応答までの待ち時間を短縮できます。まず接続を確認し、HiCacheでGPUメモリ(L1)、ホストメモリ(L2)、対応ストレージ(L3)にキャッシュを分けて保存する方法を見ていきます。
- 必要なメモリはどのくらいですか?
- HiCacheは計算済みの状態をGPU外のホストメモリやストレージにも保存します。GPUの余裕が減っても、再利用する状態を別の階層に残せます。モデルの重みは実行する場所で使い、キャッシュには処理済み入力の計算結果を保存します。
- 条件と出典はどこで確認できますか?
- 以下はNVIDIA CUDA上のSGLang 0.5.20とopenai/gpt-oss-20bを使う接続基準です。GPUメモリが足りるか公式モデルカードと対応資料で先に確認します。コンテキスト8192・同時要求1件は接続確認値です。--enable-hierarchical-cacheと--hicache-ratio 2を設定してもデータ容量2倍を保証しないため、起動ログで実際のpoolを確認します。
変更履歴
サイトの説明を変更した記録です。インストール済みのエンジンやモデルのバージョンを自動で確認した結果ではありません。
SGLangのキャッシュ・モデル別オプションの案内を追加
ローカルサーバーへの接続例と、プリフィル・デコードの各段階でメモリを調整する手順を追加しました。繰り返し入力のキャッシュ効果を分け、NGRAMの候補検索とPLEテーブルのRAM・SSDへの配置を別の機能として説明しました。