
메모리와 모델
최종 업데이트
LLM 컨텍스트 길이·RoPE·슬라이딩 윈도
문서와 대화, 답변이 컨텍스트 공간을 함께 사용해요.
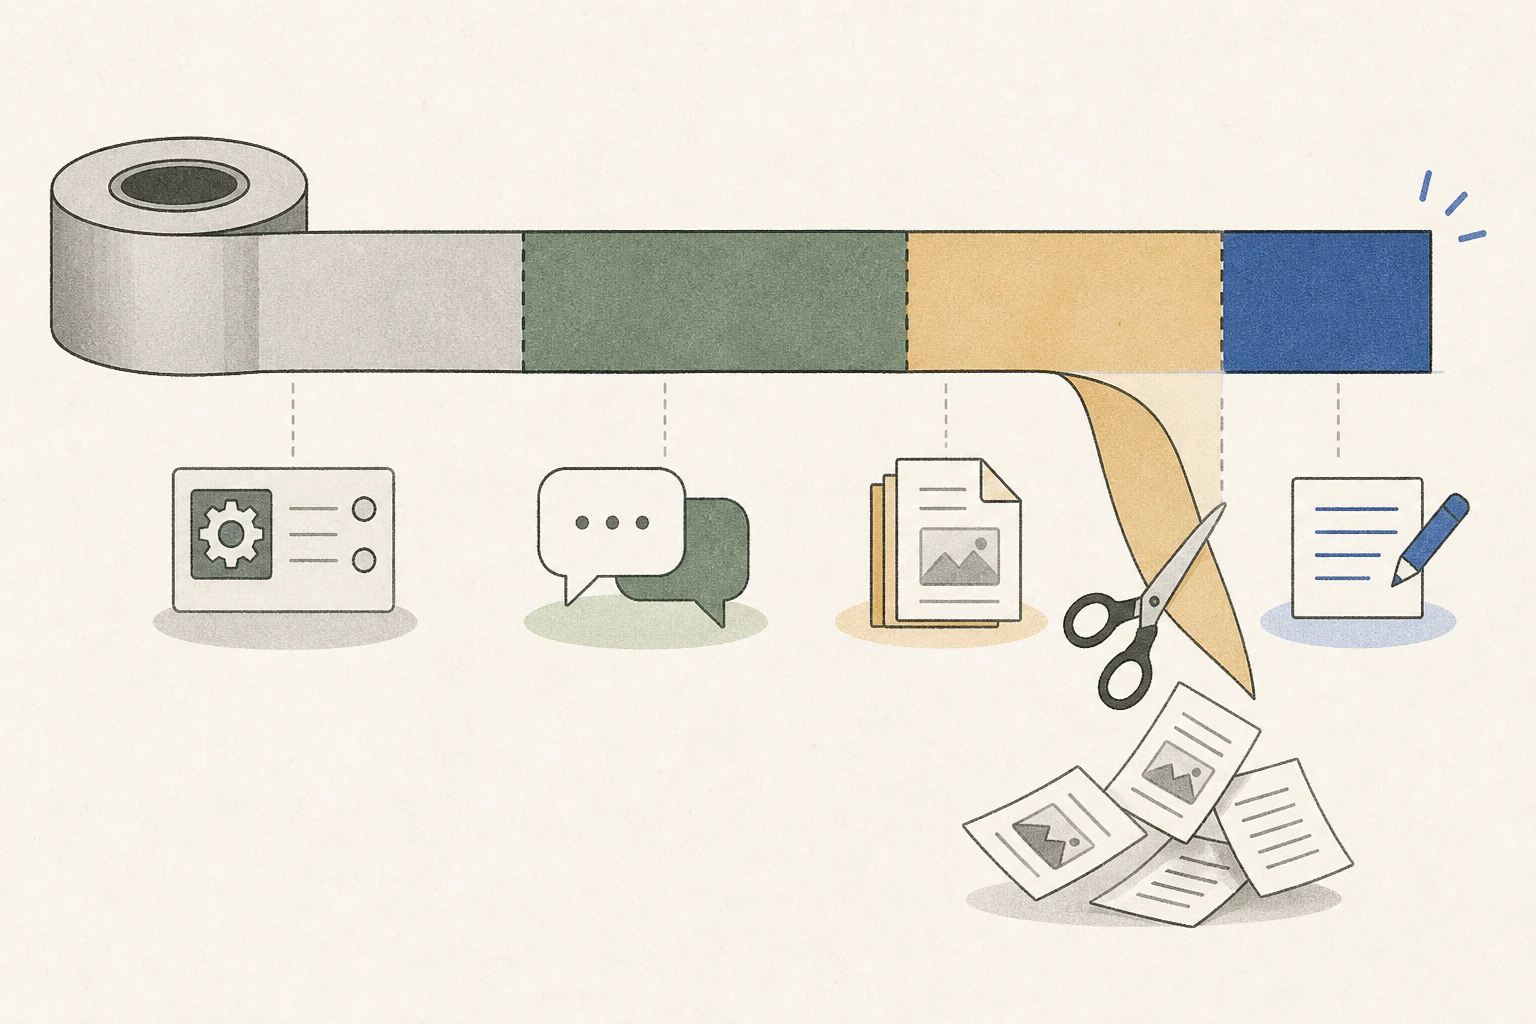
컨텍스트 윈도는 LLM1이 한 번의 요청에서 참고할 수 있는 토큰2의 한도예요. 문서 본문뿐 아니라 지침, 질문, 이전 대화와 새 답변도 이 공간을 사용해요. 문서를 길게 넣을수록 답변에 남길 여유와 KV 캐시3에 필요한 메모리를 함께 계산해야 해요.
예를 들어 계약서를 넣고 갱신일을 물은 뒤, 예외 조항까지 포함한 메모를 요청해볼게요. 두 번째 질문에는 계약서에 앞선 질문과 답이 더해질 수 있어요. 처음 질문은 잘 됐는데 후속 답변이 중간에 끊긴다면, 실제로 보낸 입력과 출력 상한부터 확인하면 원인을 찾기 쉬워요.
문서 외에 앱이 보내는 내용도 포함돼요.
앱은 질문 앞에 시스템 지침과 역할 표기, 도구 설명을 붙일 수 있어요. 이전 대화를 함께 보내는 앱은 앞선 질문과 답변도 포함해요. 문서 앱은 계약서 전체를 보내거나, 검색한 관련 구절만 보내기도 하죠. 입력창에서 보이는 글보다 실제 요청이 길어질 수 있으니 앱의 토큰 표시나 실행 로그를 확인해요.
토큰 수는 글자 수나 PDF 장수로 정확히 환산하기 어려워요. 같은 페이지라도 한국어, 숫자, 표, 코드가 어떻게 나뉘는지에 따라 달라지기 때문이에요. 비교할 때는 같은 문서의 실제 입력 토큰 수를 사용하면 돼요. 후속 요청에서는 이전 대화가 얼마나 다시 포함됐는지도 살펴보세요.
- 프리필·디코드 차이: TTFT와 tok/s 중 무엇을 봐야 하나
- KV 캐시 메모리 줄이기: vLLM FP8 설정과 답변 확인
- MLX-LM 서버 캐시: 공통 프롬프트와 동시 요청 확인하기
- 로컬 LLM VRAM·통합 메모리 용량 계산 가이드
- 네모트론 3.5 Bolt, 74B 모델을 24GB로 돌릴 수 있다고?
- RTX 3090·5090에서 Nemotron Bolt를 어떤 설정으로 실행할까?
- LiLiCorr란? Bolt와 Super VL의 speculative decoding 경로
- RTX Spark 노트북, DGX Spark·맥북프로와 무엇이 다를까?
16,000토큰에서 답변 자리를 남겨볼게요.
설명을 위해 총 한도가 16,000토큰이라고 가정할게요. 지침과 계약서가 12,000토큰, 이전 대화가 3,000토큰이면 1,000토큰이 남아요. 답변 상한을 2,000으로 정하려면 입력을 줄이거나 지원되는 범위에서 전체 한도를 늘려야 해요. 앱의 요청 제한과 출력 예약 방식에 맞춰 조정하세요.
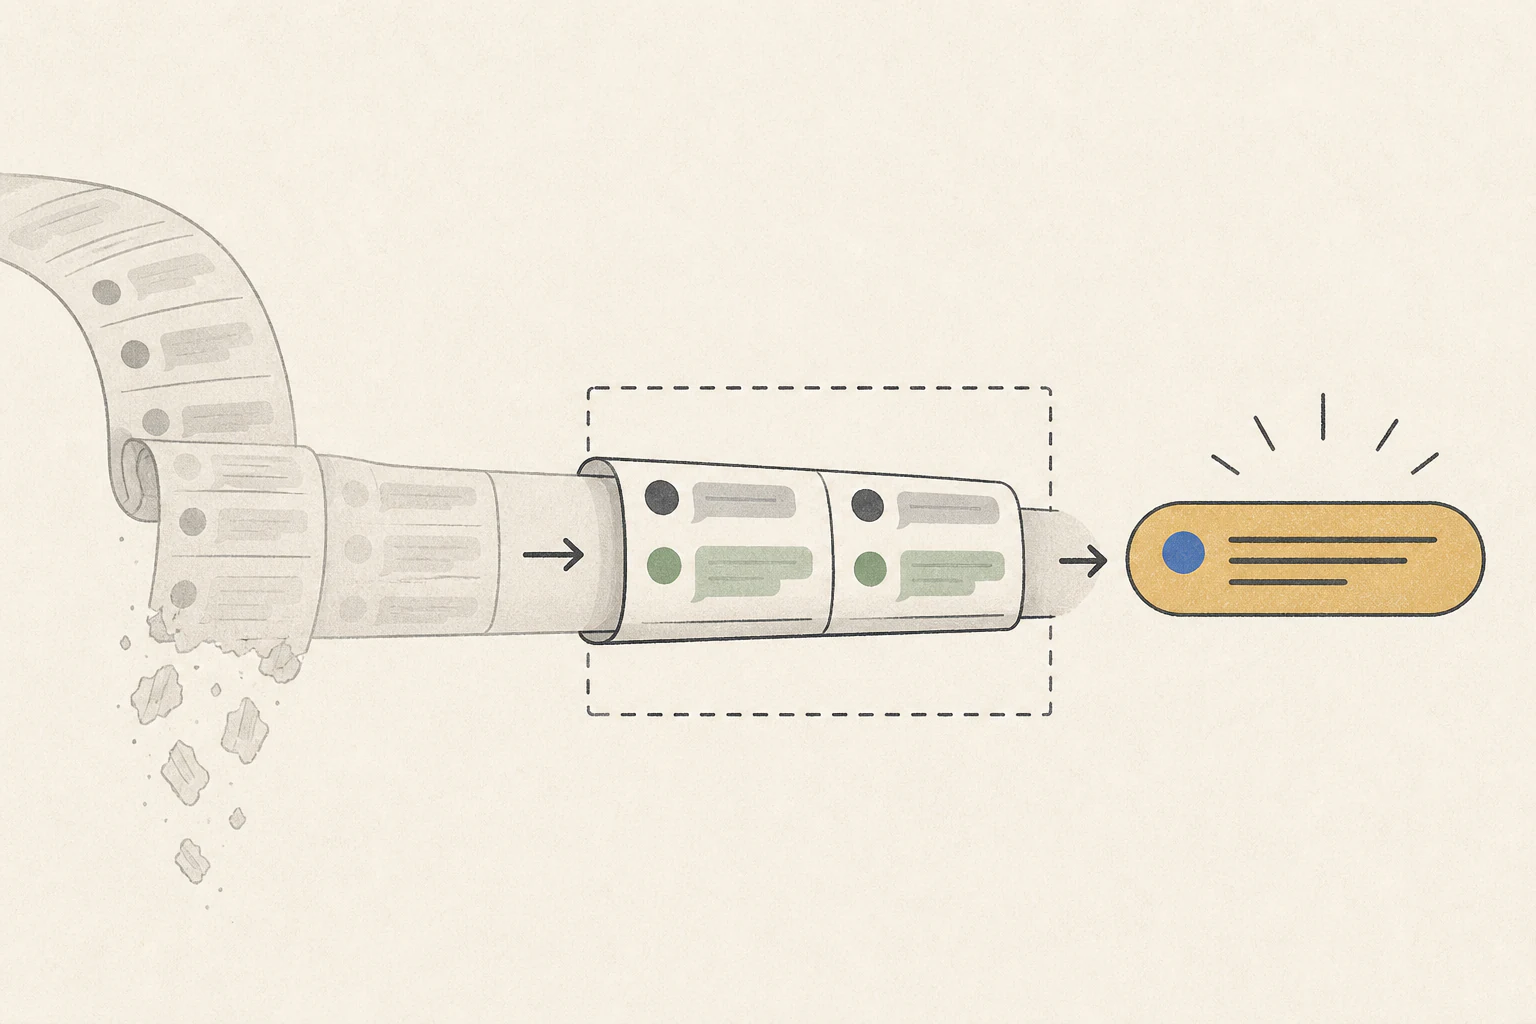
길이가 넘었을 때 앱은 요청을 거부하거나 오래된 대화를 줄일 수 있어요. 오류가 나오면 로그의 토큰 한도부터 확인하고, 답은 나왔지만 앞선 조건이 빠졌다면 모델에 실제로 전달된 내용을 확인해요. 출력이 중간에 멈춘 경우에는 설정한 상한, 실제 생성 길이와 종료·잘림 표시도 함께 살펴보세요.
| 항목 | 토큰 수 |
|---|---|
| 전체 한도 | 16,000 |
| 지침·계약서 | 12,000 |
| 이전 대화 | 3,000 |
| 답변에 남은 공간 | 1,000 |
지원 최대 길이와 실제로 사용할 길이를 나눠요.
모델 카드의 128K나 256K는 지원하는 최대 컨텍스트 길이4예요. 실행 프로그램5은 그 범위 안에서 사용할 길이를 따로 정하고, 캐시 공간을 미리 예약하거나 필요할 때 늘릴 수 있어요. 그래서 같은 짧은 질문도 설정을 크게 높이면 사용 가능한 메모리가 달라질 수 있어요.
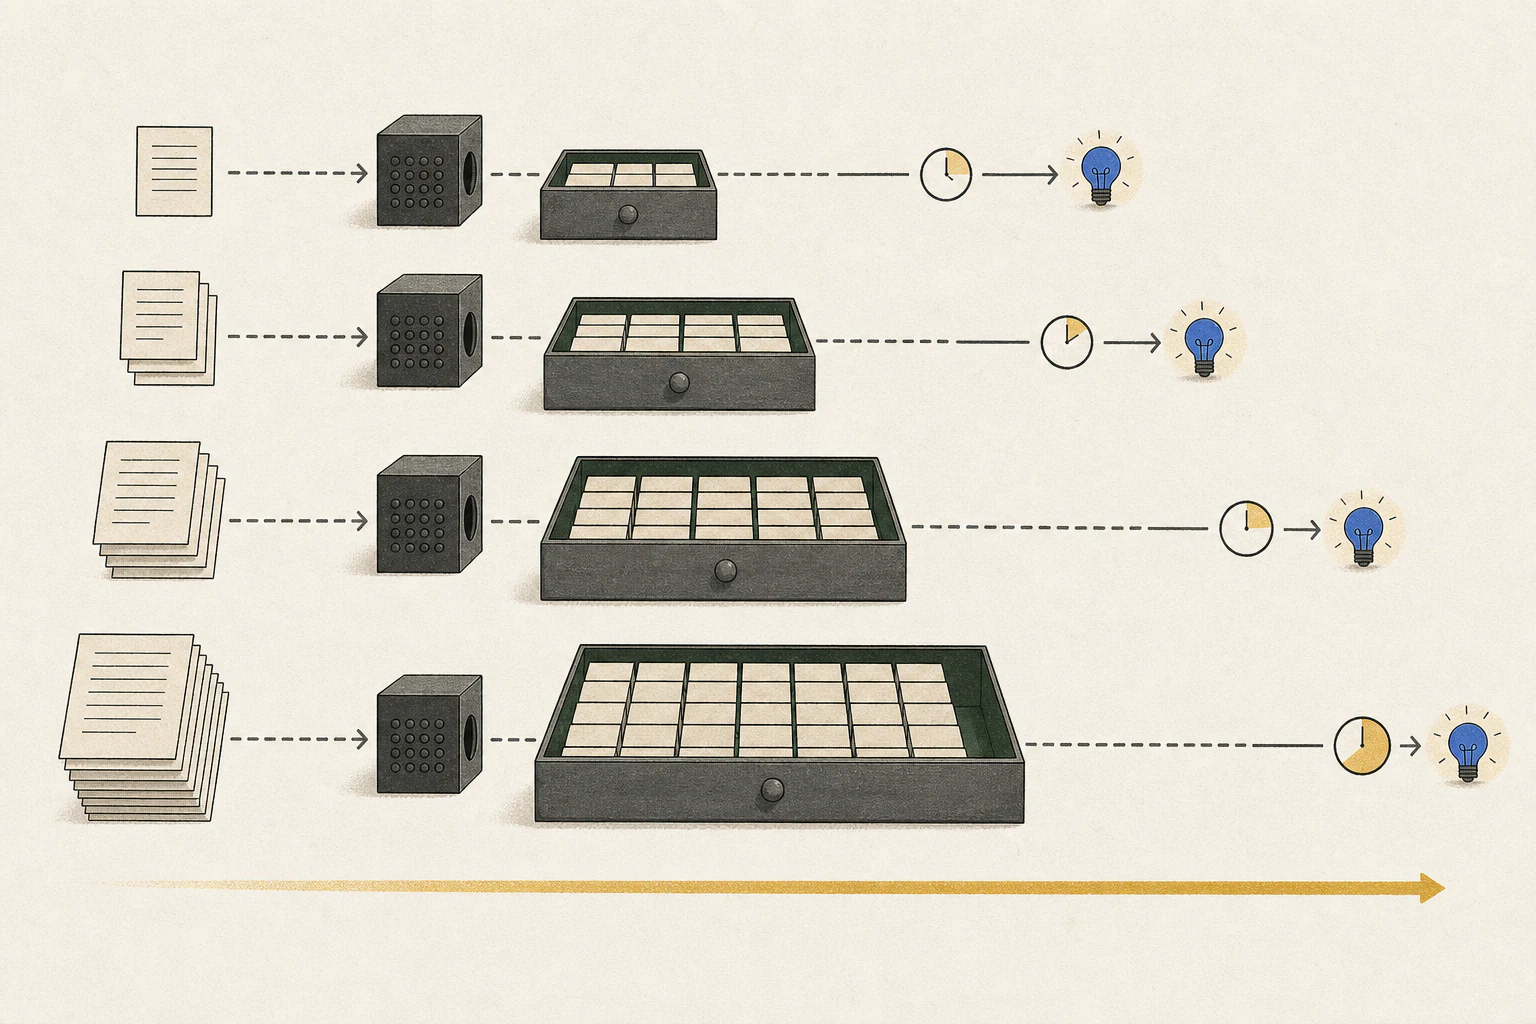
긴 입력은 프리필6 계산을 늘리고, 이전 토큰을 참고하기 위한 KV 캐시에도 공간을 써요. 가중치 파일은 그대로여도 실행 메모리가 늘어나는 이유예요. 같은 모델·KV 형식·정밀도·동시 요청 수에서 문맥 길이만 늘려 피크 메모리와 첫 토큰 시간을 기록하면 필요한 한도를 찾기 쉬워요.
가중치 Q4와 KV 캐시 정밀도는 별도 설정이에요. 두 값을 함께 바꾸기보다 한 번에 하나씩 조정해보세요. 평소 문서와 답변이 안정적으로 들어가는 길이를 기본으로 쓰고, 드물게 긴 문서는 검색이나 분할 요약으로 처리하는 방법도 선택할 수 있어요.
문서 앞뒤의 조건을 함께 답하게 해보세요.
계약서 앞부분의 갱신일과 뒤쪽의 해지 예외를 함께 물어보세요. 조항 번호나 근거 문장도 요청해 원문과 대조하면, 필요한 내용이 답변에 반영됐는지 확인할 수 있어요. 관련 구절만 검색해 보내는 앱이라면 검색 결과에 두 조건이 모두 들어 있는지부터 살펴봐요.
RoPE 확장은 모델의 위치 표현을 조정해 문맥 범위를 늘리는 방법이에요. 모델과 실행 프로그램이 안내하는 확장 조건을 따르고, 앞·중간·뒤의 근거를 같은 질문으로 시험하세요. 슬라이딩 윈도는 가까운 문맥을 중심으로 처리하는 모델 구조이고, 앱이 오래된 대화를 지우는 것은 요청을 구성하는 동작이에요. 어느 단계가 정보를 줄이는지 알면 설정과 입력 중 무엇을 바꿀지 정할 수 있어요.
용어 각주
대규모 언어 모델 — 대규모 텍스트 데이터에서 언어 패턴을 학습해 문맥에 맞는 텍스트를 처리하고 생성하는 모델입니다.
본문으로 돌아가기토큰 — 모델이 입력이나 출력을 나누어 처리하는 단위입니다.
본문으로 돌아가기KV 캐시 — 어텐션에서 이전 토큰의 키·값을 저장해 다음 토큰 생성 때 재사용하는 메모리입니다. 문맥 길이와 배치 크기에 따라 용량이 달라집니다.
본문으로 돌아가기컨텍스트 길이 — 한 번의 모델 요청에서 처리할 수 있는 입력과 생성 내용의 토큰 범위입니다. 지원 상한과 실제 사용 메모리는 모델 및 실행 설정에 좌우됩니다.
본문으로 돌아가기런타임 — 프로그램이 실행될 때 필요한 기능을 제공하는 소프트웨어 환경입니다. 로컬 AI에서는 모델을 실행하는 엔진을 가리키기도 합니다.
본문으로 돌아가기프리필 — LLM이 입력 프롬프트를 읽고 각 토큰의 내부 표현을 계산하는 단계입니다. 입력이 길수록 처리할 토큰이 많아집니다.
본문으로 돌아가기
자주 묻는 질문
- 이 글에서 가장 먼저 확인할 것은 무엇인가요?
- 컨텍스트 윈도는 LLM이 한 번의 요청에서 참고할 수 있는 토큰의 한도예요. 문서 본문뿐 아니라 지침, 질문, 이전 대화와 새 답변도 이 공간을 사용해요. 문서를 길게 넣을수록 답변에 남길 여유와 KV 캐시에 필요한 메모리를 함께 계산해야 해요.
- 필요한 메모리는 어느 정도인가요?
- 모델 카드의 128K나 256K는 지원하는 최대 컨텍스트 길이예요. 실행 프로그램은 그 범위 안에서 사용할 길이를 따로 정하고, 캐시 공간을 미리 예약하거나 필요할 때 늘릴 수 있어요. 그래서 같은 짧은 질문도 설정을 크게 높이면 사용 가능한 메모리가 달라질 수 있어요.