
메모리와 모델
최종 업데이트
MLX-LM 서버 캐시: 공통 프롬프트와 동시 요청 확인하기
같은 정책을 반복해 읽을 때는 앞부분의 계산을 재사용해요.
프롬프트1 캐시는 모델이 이미 처리한 입력의 앞부분, 즉 prefix의 계산 상태를 다음 요청에서 다시 쓰는 기능이에요. 공통 지침이나 같은 문서를 반복해서 보내는 서버에서는 첫 답변까지의 입력 처리를 줄일 수 있어요. MLX-LM2으로 반품 정책을 두 번 보내, 어떤 입력이 재사용되고 메모리와 대기가 어떻게 달라지는지 확인해볼게요.
제품 지원 문의에서는 같은 반품 정책을 붙이고 고객의 질문만 바꾸는 일이 많아요. 서버는 정책에 대한 계산을 재사용하고 새 질문과 답변을 이어서 처리해요. 답변은 매번 새로 생성하므로, 정책과 질문이 올바르게 전달됐는지도 결과에서 확인할 거예요.
Apple Silicon 맥에서 기준 서버를 열어요
이 실습은 Apple Silicon Mac에서 MLX-LM과 mlx-community/Qwen3-4B-4bit 모델을 사용해요. 모델 카드의 2.26GB는 내려받는 파일 크기예요. 실행할 때는 가중치, 캐시와 임시 계산 공간을 위한 통합 메모리3 여유도 필요해요.
Python 도구를 실행할 환경과 uv를 준비하고 아래 명령을 입력해요. 첫 실행에서는 모델을 받아야 하므로 서버 준비 로그까지 기다리세요. 기본 문맥 설정을 사용하고 같은 서버 프로세스를 유지할 거예요. 이미 서버가 켜져 있다면 그 프로세스에 요청을 보내면 돼요.
uv tool install mlx-lm
mlx_lm.server --model "mlx-community/Qwen3-4B-4bit" --host 127.0.0.1 --port 8080정책은 그대로 두고 질문만 바꿔요
아래 요청의 system 메시지에는 실습용 반품 정책이 들어 있어요. 미개봉 액세서리는 구매 증빙과 함께 30일 안에 반품할 수 있고, 개봉품은 도착 당시 파손된 경우에만 가능하다는 내용이에요. 첫 user 질문은 ‘개봉한 뒤 마음이 바뀌었다면 반품할 수 있나요?’예요. 답변이 정책의 해당 문장과 이유를 제시하는지 확인해요.
두 번째 요청에서는 user의 content만 ‘상품이 파손된 채 도착했다면 어떻게 되나요?’로 바꿔요. 모델, 메시지 역할과 순서, system 내용, 템플릿과 문맥 설정은 유지하세요. 두 질문은 다르지만 앞의 정책 토큰4은 공유할 수 있어요.
응답 usage에 usage.prompt_tokens_details.cached_tokens가 있으면 두 요청의 값을 기록해요. 재사용된 입력 길이를 나타내는 지표예요. 이 필드를 반환하지 않는 버전에서는 서버 로그와 제공되는 usage 정보를 확인해요. 첫 토큰 시점, 전체 완료 시간과 출력 토큰 수도 함께 남겨야 실제 대기 변화를 비교할 수 있어요. 이 예시는 stream:false로 완성 답변을 받으므로, TTFT5는 서버의 시간 지표로 확인하거나 별도의 스트리밍 요청으로 측정해요.
curl -sS http://127.0.0.1:8080/v1/chat/completions -H 'Content-Type: application/json' -d '{"model":"mlx-community/Qwen3-4B-4bit","messages":[{"role":"system","content":"Return the relevant policy sentence and one short reason. Policy: Unopened accessories may be returned within 30 days with proof of purchase. Opened accessories are not returnable unless they arrived damaged."},{"role":"user","content":"A customer opened an accessory and changed their mind. Can they return it?"}],"max_tokens":128,"stream":false}'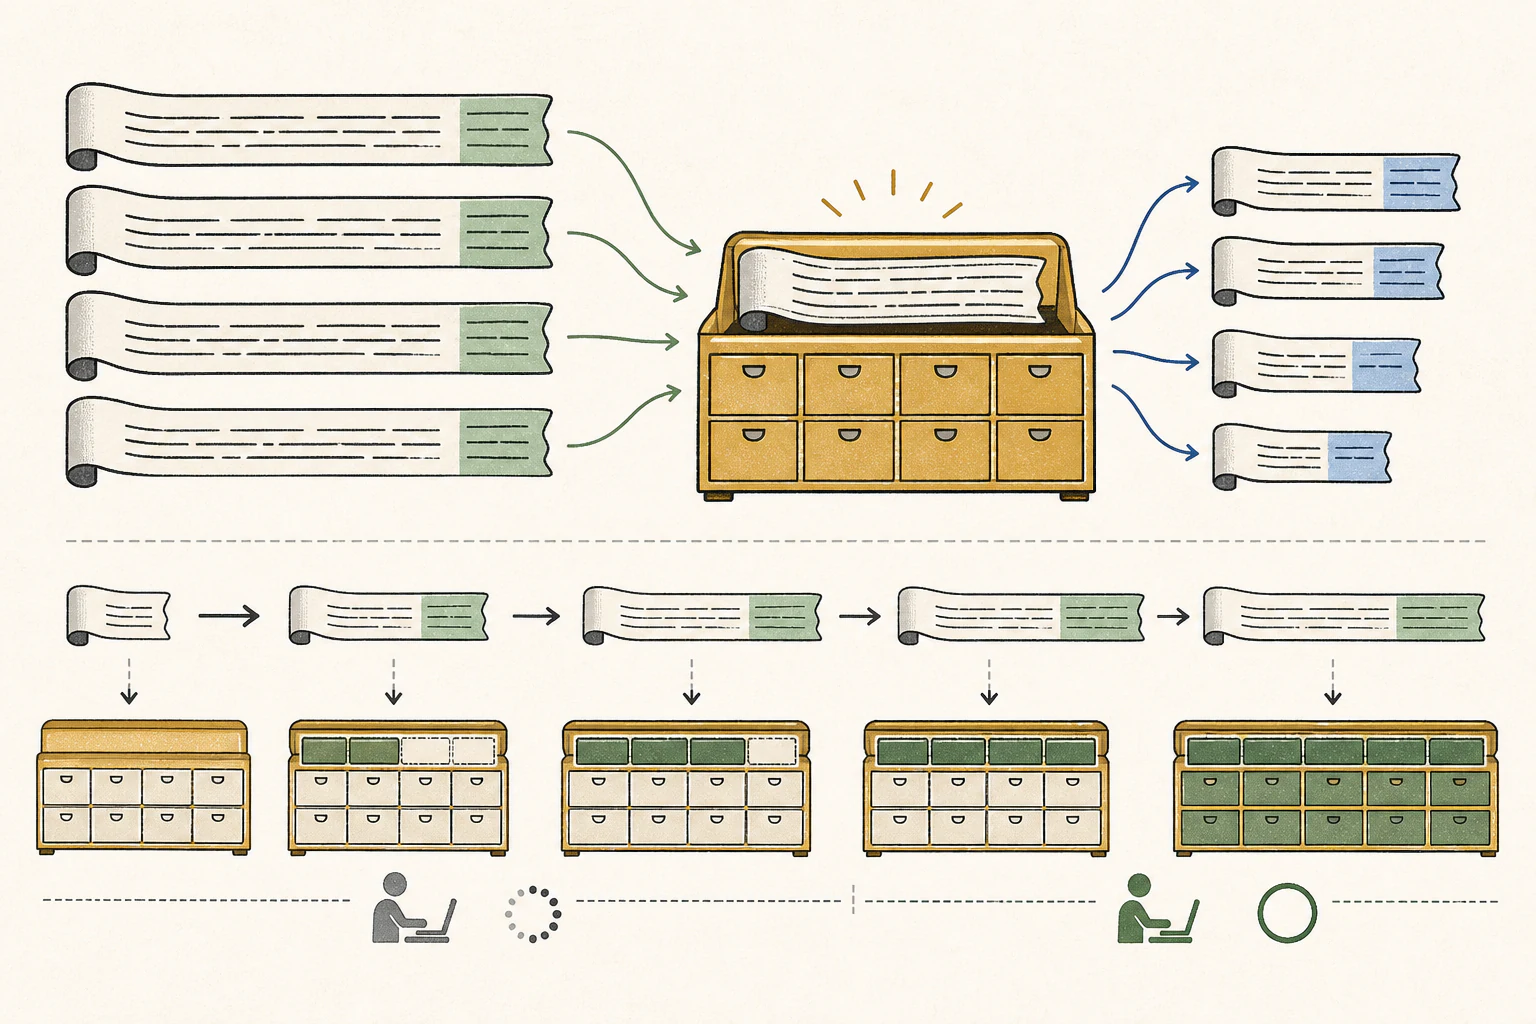
공통 내용 앞에 붙는 문구도 캐시에 영향을 줘요
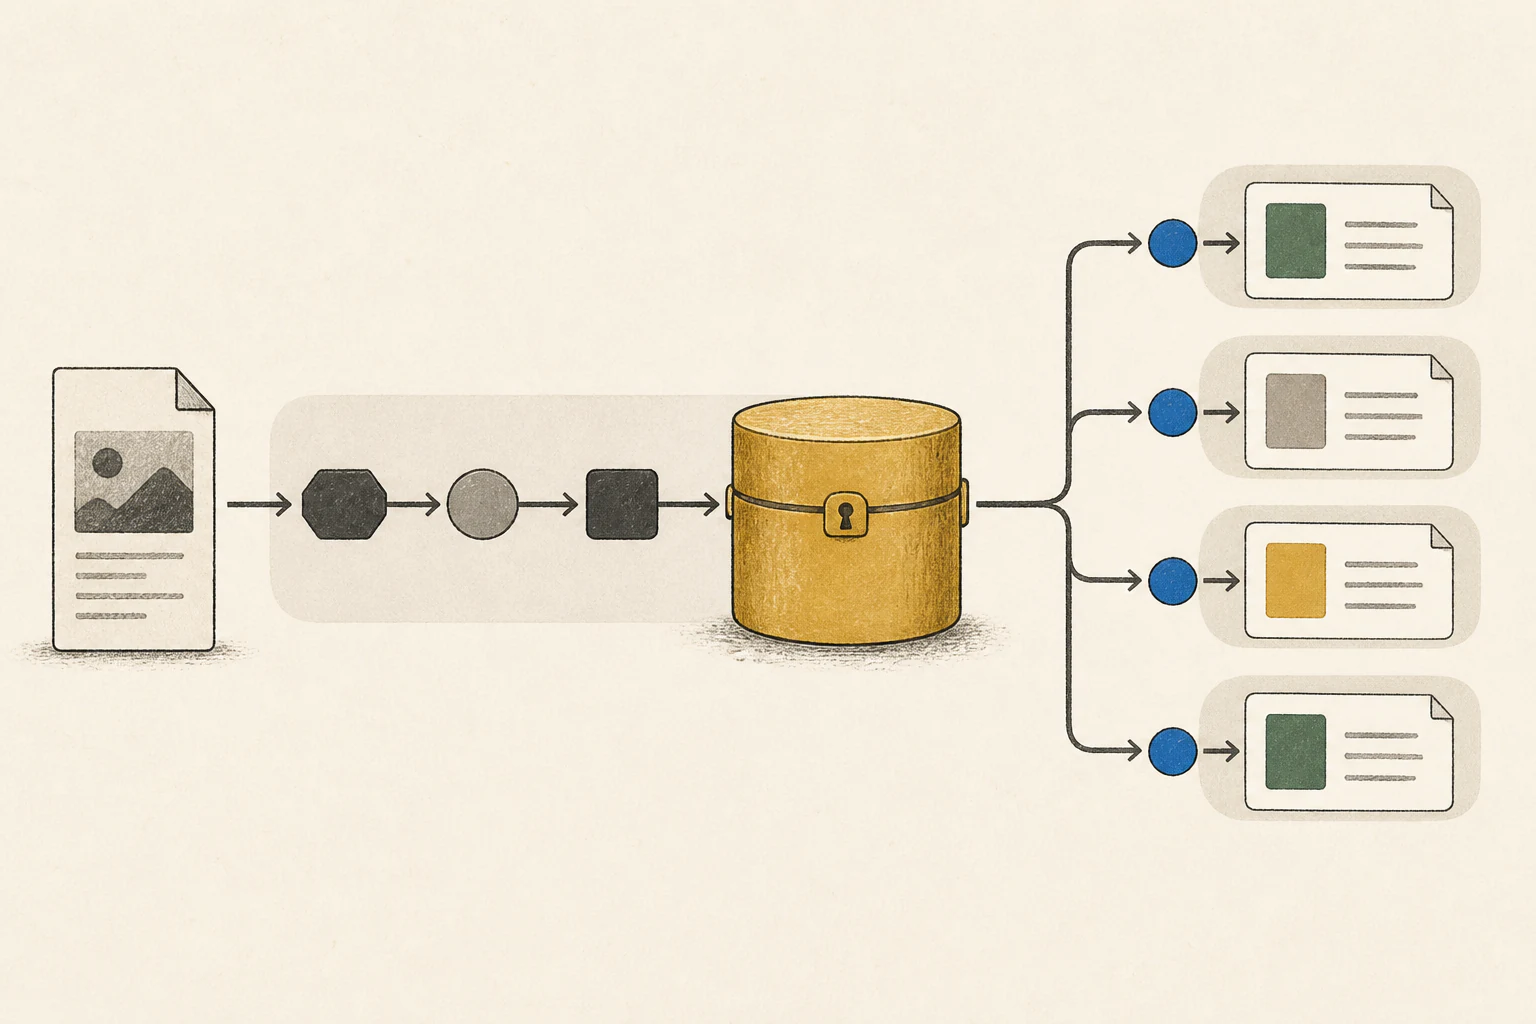
캐시는 최종적으로 모델에 전달된 토큰의 앞부분을 재사용해요. 정책 앞에 날짜나 사용자 ID가 붙으면 그 지점부터 입력이 달라질 수 있어요. 공통 지침 뒤에 고객 질문을 두는 구조와, 고객별 지침이 먼저 오는 구조를 구분해서 확인하세요.
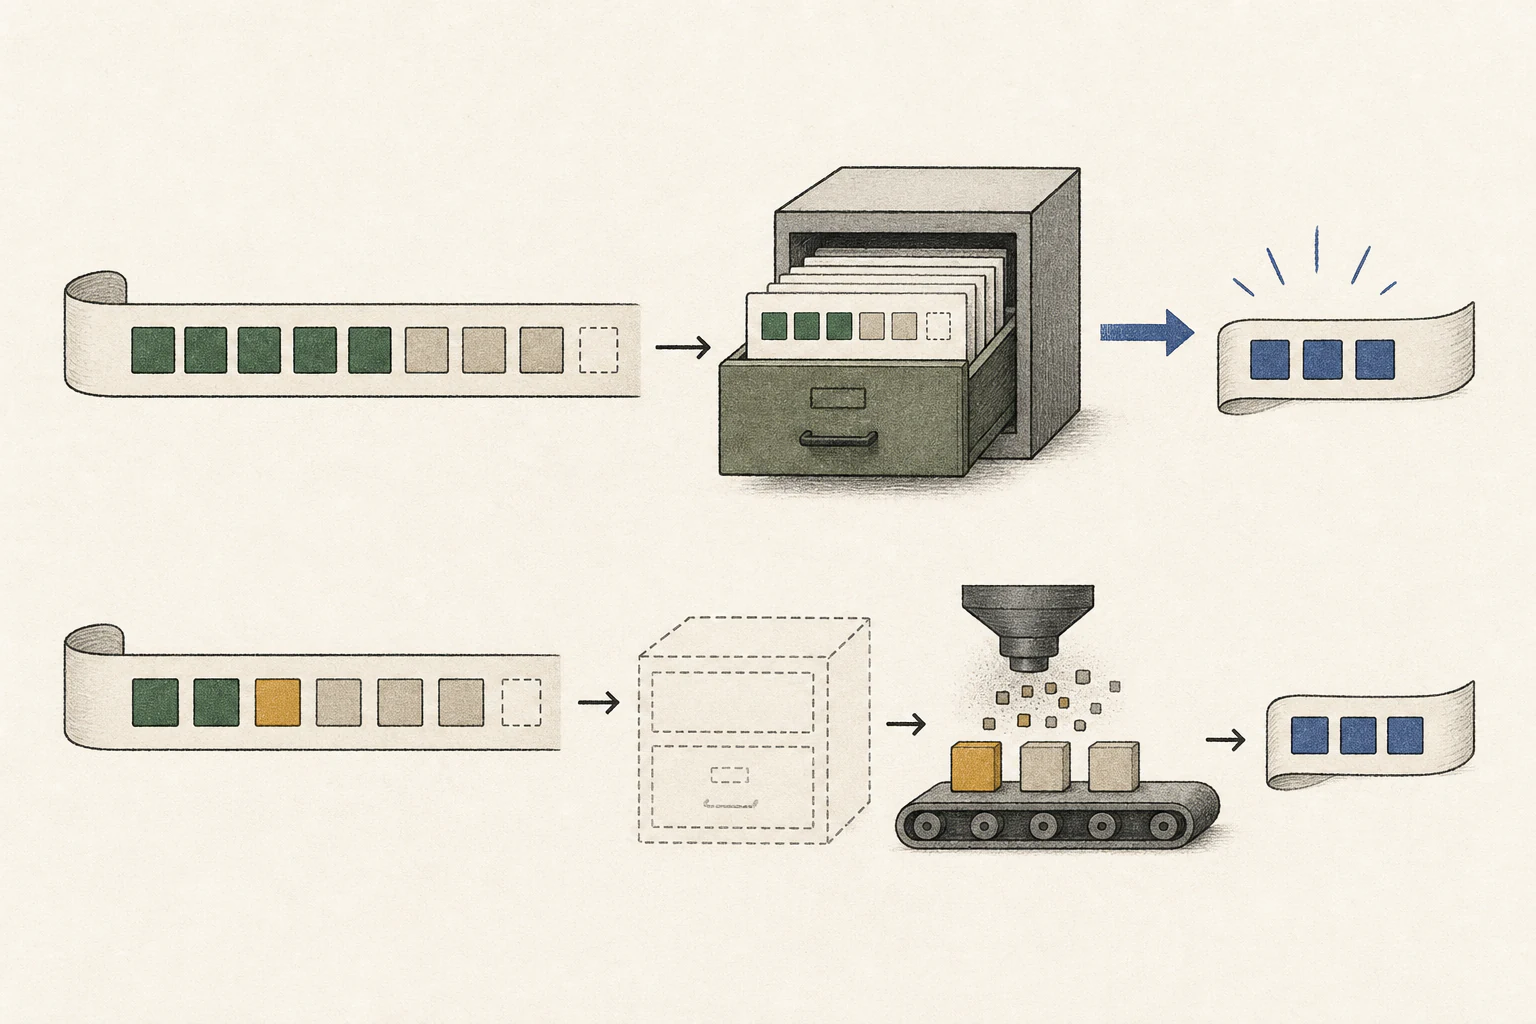
모델이나 메시지 템플릿을 바꿔도 이전 상태의 재사용 조건이 달라져요. 캐시를 위해 순서를 조절할 때는 업무상 필요한 권한과 안전 지침을 유지해요. 다음에는 서로 다른 긴 정책을 번갈아 보내고 원래 정책으로 돌아와, 앞서 쓴 상태가 남아 있는지 확인할 수 있어요.
같은 내용인데 cached tokens가 0이라면 실제 system 내용, 서버 프로세스, 캐시 항목의 유지 여부와 해당 모델의 cache trimming 지원을 차례로 확인해요. 어떤 요청이 캐시에서 빠졌는지 로그와 함께 대조하면 다시 계산한 이유를 찾기 쉬워요.
한 건의 대기와 여러 건의 처리량을 나눠 재요
먼저 준비된 서버에 문의를 한 건씩 보내요. 같은 모델과 정책을 유지하고 첫 토큰, 완료 시간, 입력·출력 토큰과 캐시 적중을 기록해요. 서버 재시작 뒤 모델을 처음 올리는 시간은 별도로 두고, 준비된 요청끼리 비교해요.
그다음 독립된 문의를 동시에 보내요. 요청별 지연의 중앙값과 오래 걸린 요청, 전체 tokens/second와 메모리를 함께 기록해요. 공통 prefix의 동시 요청과 서로 다른 사용자별 prefix를 섞은 요청은 각각 시험하면 캐시와 동시성의 영향을 구별하기 쉬워요.
설명용으로 한 건이 30초, 네 건을 동시에 보내면 각각 36초에 끝난다고 가정해볼게요. 개별 대기는 6초 늘어 20% 길어져요. 한 건씩 처리하면 30×4=120초, 네 건이 함께 끝나면 벽시계 기준 약 36초예요. 동시 요청의 개별 시간을 더한 36×4=144초와 전체 작업의 경과 시간은 다르죠. 즉시 답변을 받는 일이 목적이면 개별 대기를, 문의 묶음을 처리한다면 완료 건수와 전체 경과 시간을 기준으로 선택해요.
| 조건 | 주요 기록 | 알 수 있는 변화 |
|---|---|---|
| 순차 warm 요청 | TTFT·완료 시간·cached tokens | 공통 입력 재사용 효과 |
| cold 시작 | 모델 로딩·첫 요청·메모리 | 서버 준비 비용 |
| 동시 요청 | 개별 지연·전체 처리량·메모리 | 함께 처리할 때의 대기와 용량 |
| 여러 prefix 혼합 | hit/miss·퇴출 뒤 재요청 | 캐시가 유지되는 범위 |
캐시 크기를 줄일 때 함께 확인할 것
재사용할 상태를 남겨 두면 메모리도 계속 사용해요. 모델 가중치, 현재 요청의 KV 캐시6와 저장해 둔 항목이 공간을 나눠 쓰므로, 메모리가 부족하면 동시 요청 수와 실제 입력 길이를 먼저 줄여 시험해요.
캐시 제한은 mlx_lm.server --help에서 현재 버전의 옵션을 찾아 설정해요. --prompt-cache-bytes처럼 저장 항목의 크기를 제한하는 옵션과 --max-kv-size처럼 긴 대화의 캐시 형태를 바꾸는 옵션은 역할이 달라요. help와 시작 로그에서 지원과 적용을 확인하고, 한 옵션씩 바꿔 hit·TTFT·peak memory를 비교하세요.
짧은 문맥과 요청 한 개에서 안정성을 확인한 뒤 업무량에 맞춰 늘려요. 첫 토큰은 빨라졌지만 생성 구간이 그대로라면 디코드7가 다음 비교 대상이에요. 요청 수를 늘려 업무의 대기 한도를 넘었다면 동시성을 낮추고, 자주 쓰는 공통 문서의 재사용이 유지되는 크기를 남기면 돼요.
설치 버전과 작업 유형에 맞춰 유지해요
MLX-LM v0.31.0은 서버 캐시와 크기 제한, v0.31.2는 system·user 메시지 캐시와 batch generator 개선을 포함해요. v0.31.3에는 batch KV cache와 병렬 tool call8 관련 수정이 추가됐어요. 업데이트할 때는 지원 옵션과 로그를 다시 확인하고 같은 요청으로 이전 설정과 비교하세요.
같은 지침과 문서를 여러 번 쓰는 업무라면 실제 적중과 첫 응답 차이를 기준으로 조절해요. 새 문서를 한 번씩만 읽고 현재 맥에서 충분히 응답한다면 캐시 설정을 크게 늘리지 않아도 돼요. 여러 앱이 동시에 접속하기 시작할 때 동시 요청 시험을 추가하면 돼요.
용어 각주
프롬프트 — 모델에 보내는 입력문입니다. 생성 모델에서는 만들 결과를 설명하는 문장이 되어 출력의 구성과 내용을 크게 좌우합니다.
본문으로 돌아가기MLX-LM — MLX를 사용해 언어 모델을 불러오고 추론·미세 조정을 수행하는 패키지입니다.
본문으로 돌아가기통합 메모리 — CPU와 GPU가 같은 물리 메모리 풀을 공유하는 구조입니다.
본문으로 돌아가기토큰 — 모델이 입력이나 출력을 나누어 처리하는 단위입니다.
본문으로 돌아가기첫 토큰 지연 — 요청을 보낸 뒤 첫 출력 토큰이 도착하기까지 걸린 시간입니다.
본문으로 돌아가기KV 캐시 — 어텐션에서 이전 토큰의 키·값을 저장해 다음 토큰 생성 때 재사용하는 메모리입니다. 문맥 길이와 배치 크기에 따라 용량이 달라집니다.
본문으로 돌아가기토큰 디코드 — 입력과 앞서 만든 답변을 바탕으로 다음 출력 토큰을 차례로 생성하는 단계입니다.
본문으로 돌아가기도구 호출 — 모델이 파일 읽기·검색·명령 실행 같은 외부 기능의 이름과 인자를 요청하는 형식입니다. 요청을 실제로 실행할지는 에이전트 런타임과 권한 설정이 결정합니다.
본문으로 돌아가기
자주 묻는 질문
- 이 글에서 가장 먼저 확인할 것은 무엇인가요?
- 프롬프트 캐시는 모델이 이미 처리한 입력의 앞부분, 즉 prefix의 계산 상태를 다음 요청에서 다시 쓰는 기능이에요. 공통 지침이나 같은 문서를 반복해서 보내는 서버에서는 첫 답변까지의 입력 처리를 줄일 수 있어요. MLX-LM으로 반품 정책을 두 번 보내, 어떤 입력이 재사용되고 메모리와 대기가 어떻게 달라지는지 확인해볼게요.
- 필요한 메모리는 어느 정도인가요?
- 이 실습은 Apple Silicon Mac에서 MLX-LM과 mlx-community/Qwen3-4B-4bit 모델을 사용해요. 모델 카드의 2.26GB는 내려받는 파일 크기예요. 실행할 때는 가중치, 캐시와 임시 계산 공간을 위한 통합 메모리 여유도 필요해요.