
メモリとモデル
最終更新
MLX-LMサーバーキャッシュ:共通プロンプトの再利用と同時リクエストの確認
同じポリシーを繰り返し読むときは前半の計算を再利用します。
プロンプト1キャッシュは、処理済み入力の先頭部分であるprefixの計算状態を次の依頼で再利用する機能です。共通の指示や同じ文書を繰り返し受け取るサーバーでは、最初の回答までの入力処理を減らせます。MLX-LM2で返品ポリシーを2回送り、再利用される入力とメモリ・待ち時間の変化を確認します。
製品サポートでは同じ返品ポリシーを添付し、顧客の質問だけを変えることがよくあります。サーバーはポリシーの計算を再利用し、新しい質問と回答を処理します。回答は毎回新しく生成するため、結果からポリシーと質問が正しく伝わったかも確認します。
Apple Silicon Macで基準サーバーを起動します
この実習ではApple Silicon MacでMLX-LMとmlx-community/Qwen3-4B-4bitを使います。モデルカードの2.26GBはダウンロード容量です。実行には重み、キャッシュ、一時計算領域のためのユニファイドメモリ3も必要です。
Pythonツールを実行できる環境とuvを用意し、以下を入力します。初回はモデルを取得するため、サーバー準備完了ログを待ってください。標準の文脈設定を使い、同じサーバープロセスを維持します。既に起動している場合は、そのプロセスに依頼します。
uv tool install mlx-lm
mlx_lm.server --model "mlx-community/Qwen3-4B-4bit" --host 127.0.0.1 --port 8080ポリシーは維持し、質問だけを変えます
以下のsystemメッセージには実習用返品ポリシーがあります。未開封アクセサリーは購入証明とともに30日以内に返品でき、開封済み品は到着時に破損していた場合のみ可能という内容です。最初のuser質問は、開封後に気が変わった場合の返品可否です。回答が該当文と理由を示しているか確認します。
2回目はuserのcontentだけを、商品が破損して届いた場合の質問に変えます。モデル、メッセージの役割と順序、system内容、テンプレート、文脈設定は維持してください。質問は異なっても、先頭のポリシートークン4を共有できます。
応答usageにusage.prompt_tokens_details.cached_tokensがあれば、両方の値を記録します。再利用された入力長を示す指標です。このフィールドを返さない版ではサーバーログと提供されるusage情報を確認します。実際の待ち時間を比較するため、最初のトークンの時点、完了時間、出力トークン数も記録します。 この例はstream:falseで完成した回答を受け取るため、TTFT5はサーバーの時間指標か別のストリーミング依頼で測ります。
curl -sS http://127.0.0.1:8080/v1/chat/completions -H 'Content-Type: application/json' -d '{"model":"mlx-community/Qwen3-4B-4bit","messages":[{"role":"system","content":"Return the relevant policy sentence and one short reason. Policy: Unopened accessories may be returned within 30 days with proof of purchase. Opened accessories are not returnable unless they arrived damaged."},{"role":"user","content":"A customer opened an accessory and changed their mind. Can they return it?"}],"max_tokens":128,"stream":false}'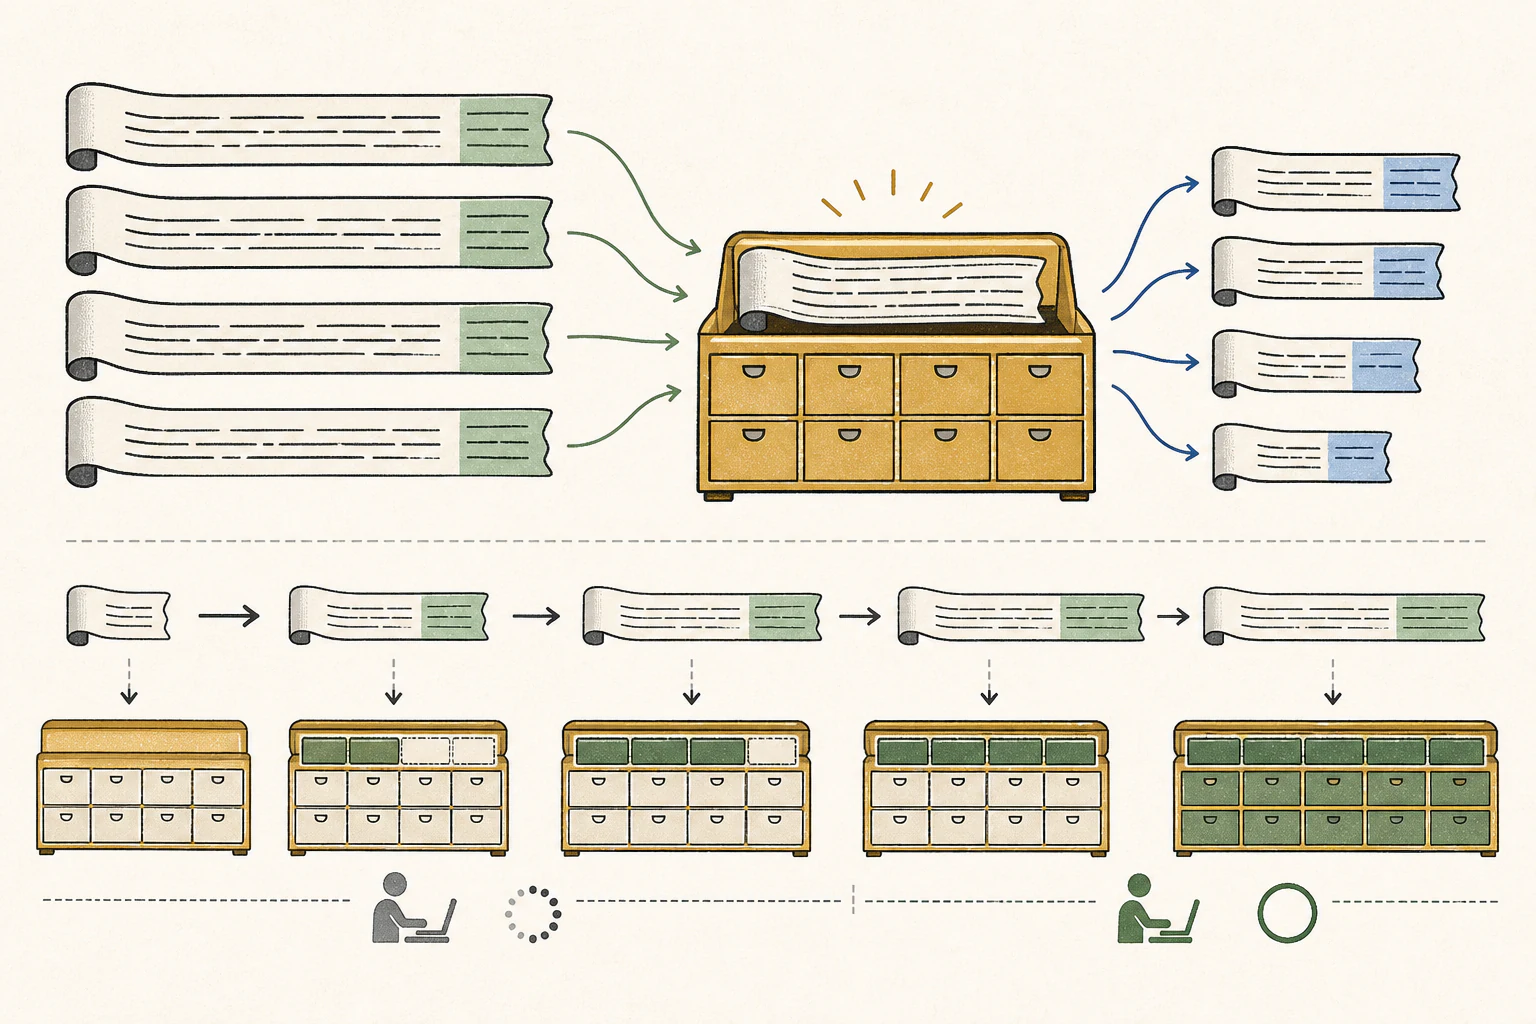
共通内容の前に付く文もキャッシュに影響します
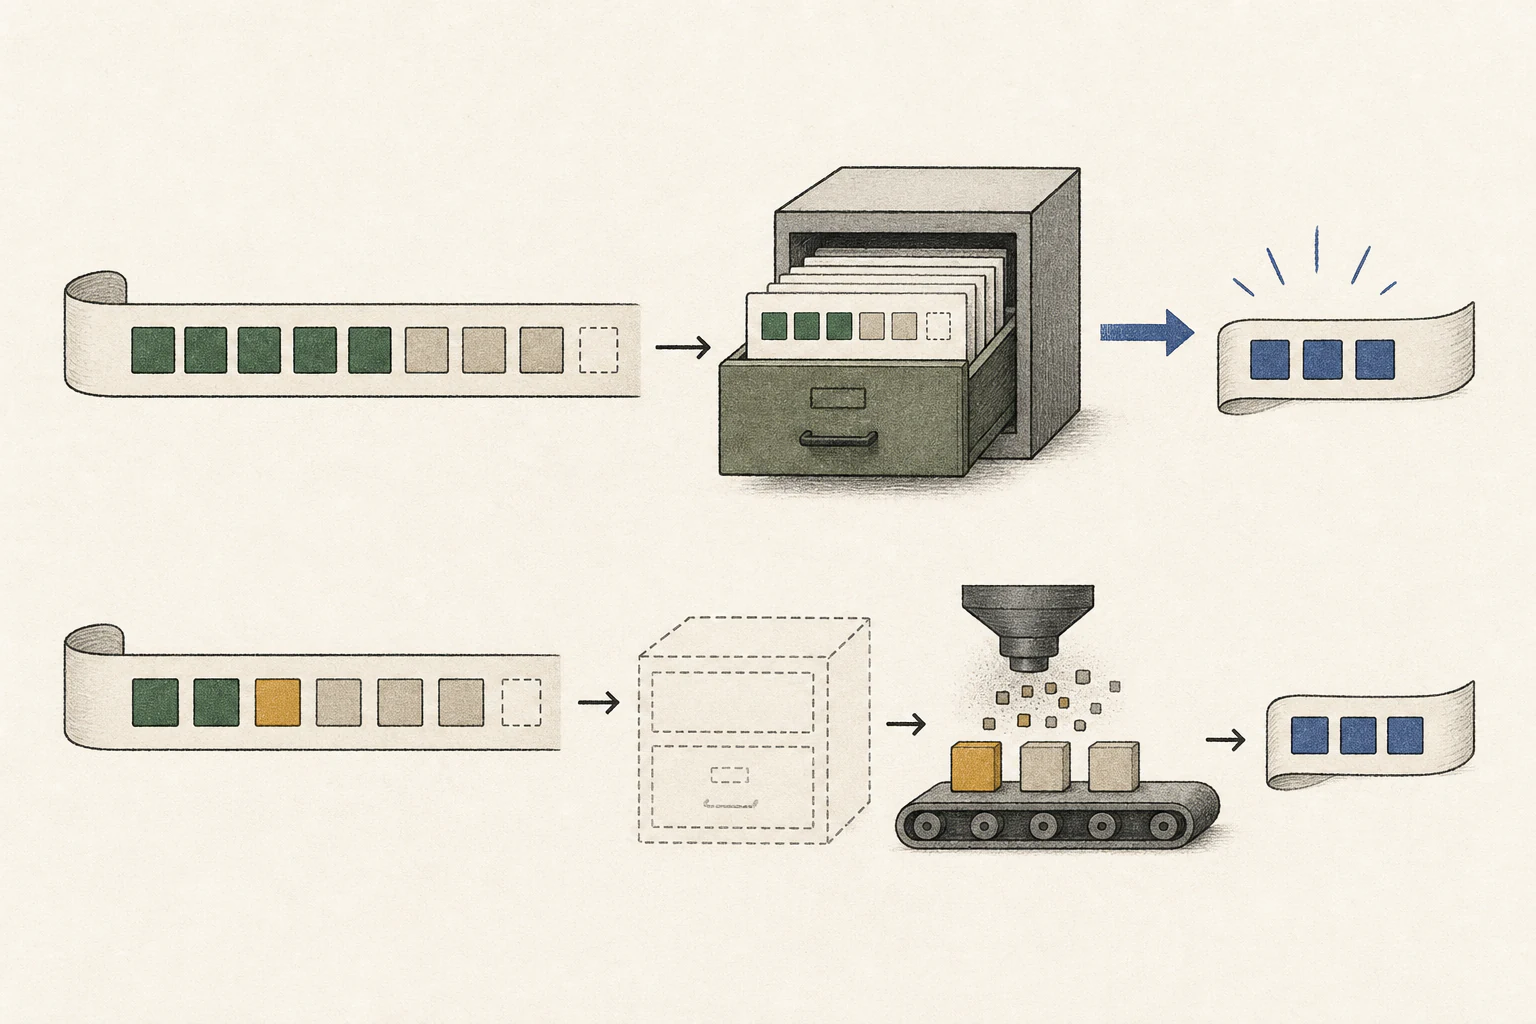
キャッシュはモデルに送る最終トークン列の先頭を再利用します。ポリシーの前に日付やユーザーIDが付くと、その位置から入力が変わる場合があります。共通指示の後に顧客の質問を置く構成と、顧客別の指示を先に置く構成を分けて確認します。
モデルやメッセージテンプレートを変えても再利用条件が変わります。キャッシュのために順序を調整する際は、必要な権限と安全指示を維持します。次は異なる長いポリシーを交互に送り、元のポリシーに戻って以前の状態が残っているか確認できます。
同じ内容なのにcached tokensが0なら、実際のsystem内容、サーバープロセス、キャッシュ項目の保持、モデルのcache trimming対応を順に確認します。ログでどの依頼の状態が解放されたか照合すると、再計算した理由を探しやすくなります。
1件の待ち時間と複数件の処理量を分けて測ります
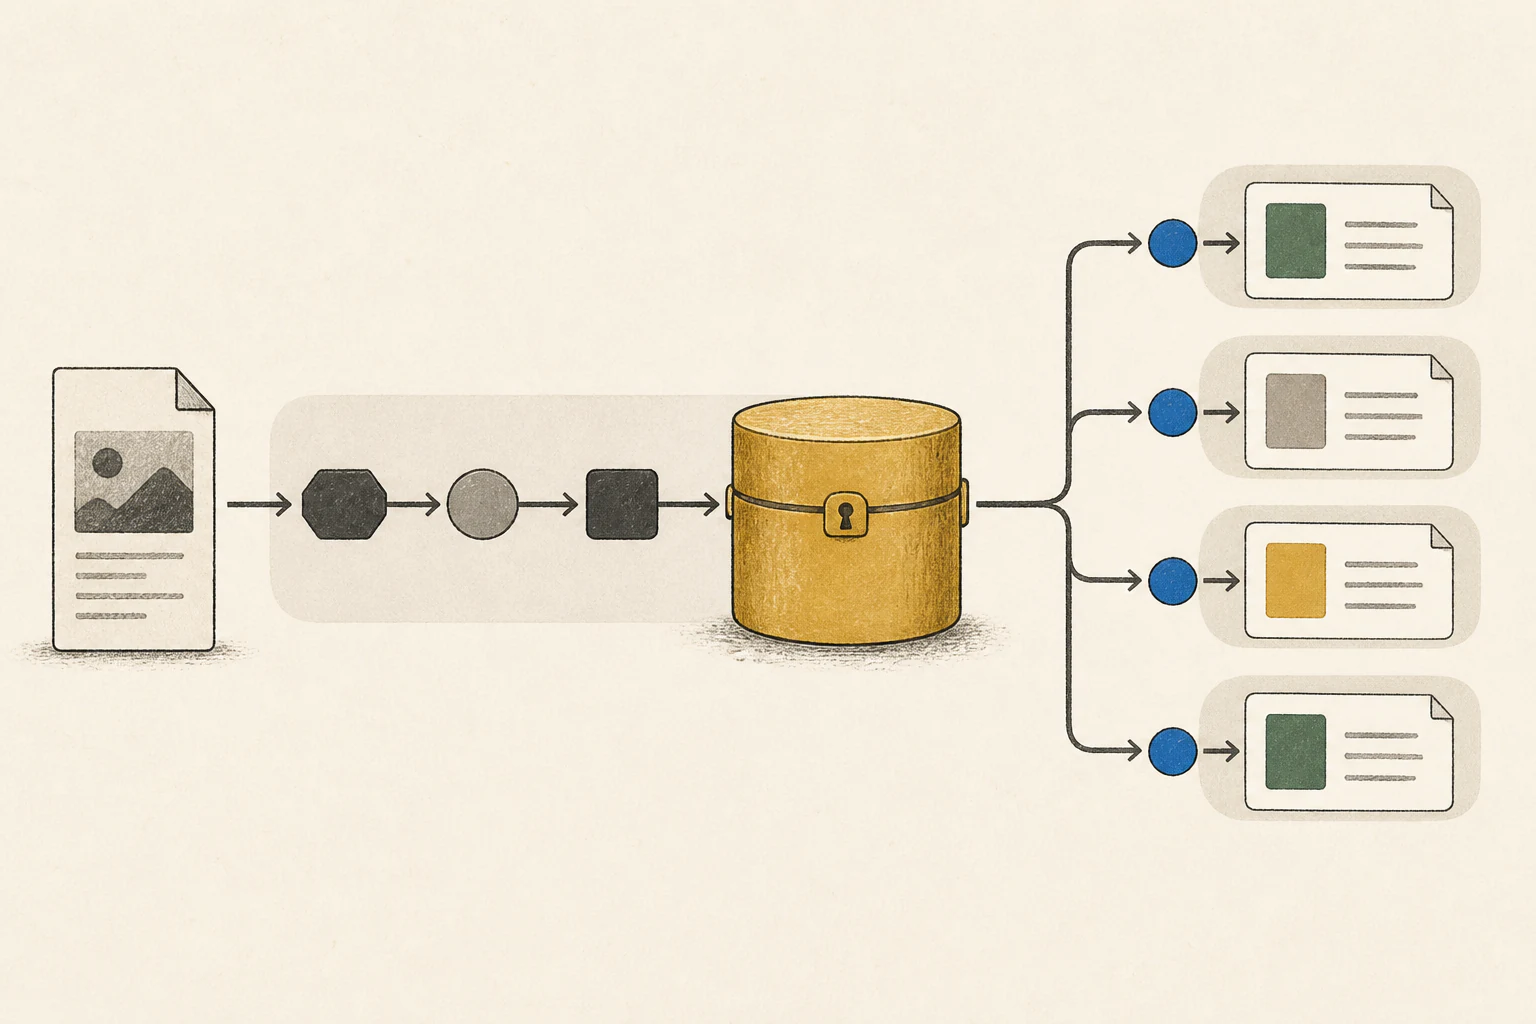
まず準備済みサーバーに問い合わせを1件ずつ送ります。同じモデルとポリシーを維持し、最初のトークン、完了時間、入力・出力トークン、キャッシュ適中を記録します。再起動後の初回モデル読み込みは別にし、準備済みの依頼同士を比較します。
次に独立した問い合わせを同時に送ります。依頼ごとの遅延の中央値、遅い依頼、全体のtokens/second、メモリを記録します。共通prefixの同時依頼と、顧客別prefixを混ぜた依頼を別々に試すと、キャッシュと同時実行の影響を区別しやすくなります。
説明用に1件が30秒、4件同時では各36秒で終わると仮定します。個別の待ちは6秒、20%増えます。順次処理は30×4=120秒、同時完了は実経過時間で約36秒です。個別時間の合計36×4=144秒と全体の経過時間は異なります。即時回答が目的なら個別の待ち、問い合わせの一括処理なら完了件数と経過時間を基準に選びます。
| 条件 | 主な記録 | 分かる変化 |
|---|---|---|
| 順次warm request | TTFT、完了時間、cached tokens | 共通入力の再利用効果 |
| cold開始 | モデル読み込み、初回依頼、メモリ | サーバー準備コスト |
| 同時リクエスト数 | 個別遅延、全体処理量、メモリ | 同時処理時の待ちと容量 |
| 複数prefixの混在 | hit/miss、解放後の再依頼 | キャッシュ保持範囲 |
キャッシュ容量を減らすときの確認事項
再利用する状態を保持するとメモリも使い続けます。モデルの重み、処理中のKVキャッシュ6、保存済み項目が容量を分け合うため、メモリが不足したら同時数と実際の入力長を減らして試します。
キャッシュ制限は現在版のmlx_lm.server --helpで探して設定します。--prompt-cache-bytesのような保存項目の容量制限と、--max-kv-sizeのような長い会話のキャッシュ形状を変える設定は役割が異なります。helpと起動ログで対応と適用を確認し、1つずつ変更してhit、TTFT、peak memoryを比較してください。
短い文脈と1依頼で安定性を確認してから業務量に合わせて増やします。最初のトークンが速くなっても生成区間が同じなら、次はデコード7を比較します。同時数を増やして許容待ち時間を超えたら減らし、頻繁に使う共通文書を再利用できる容量を残します。
導入版と作業に合わせて設定を維持します
MLX-LM v0.31.0にはサーバーキャッシュと容量制限、v0.31.2にはsystem・userメッセージキャッシュとbatch generatorの改善があります。v0.31.3にはbatch KV cacheと並列tool call8の修正が加わりました。更新時は対応オプションとログを再確認し、同じ依頼で以前の設定と比較します。
同じ指示と文書を繰り返す業務なら、実際の適中と初回応答の差を基準に調整します。新しい文書を1回ずつ読み、現在のMacで十分に応答するならキャッシュを大きく増やす必要はありません。複数アプリが同時に接続し始めたときに同時依頼の試験を追加します。
用語の注釈
プロンプト — モデルに送る入力文です。生成モデルでは作りたい結果を説明する文になり、出力の構成や内容を大きく左右します。
本文に戻るMLX-LM — MLXを使い、言語モデルの読み込み・推論・微調整を行うパッケージです。
本文に戻るユニファイドメモリ — CPUとGPUが同じ物理メモリ領域を共有する構造です。
本文に戻るトークン — モデルが入力や出力を分けて処理する単位です。
本文に戻る最初のトークンまでの時間 — リクエスト送信から最初の出力トークンが届くまでの時間です。
本文に戻るKVキャッシュ — 過去トークンのAttention用キー・バリューを保存し、後続トークン生成で再利用するメモリです。容量はコンテキスト長やバッチサイズで変わります。
本文に戻るトークンのデコード — 入力とそれまでの回答をもとに、次の出力トークンを順に生成する段階です。
本文に戻るツール呼び出し — ファイル読み取り、検索、コマンド実行などの外部機能を、名前と引数でモデルが要求する形式です。実行の有無はエージェントランタイムと権限設定が決めます。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- プロンプトキャッシュは、処理済み入力の先頭部分であるprefixの計算状態を次の依頼で再利用する機能です。共通の指示や同じ文書を繰り返し受け取るサーバーでは、最初の回答までの入力処理を減らせます。MLX-LMで返品ポリシーを2回送り、再利用される入力とメモリ・待ち時間の変化を確認します。
- 必要なメモリはどのくらいですか?
- この実習ではApple Silicon MacでMLX-LMとmlx-community/Qwen3-4B-4bitを使います。モデルカードの2.26GBはダウンロード容量です。実行には重み、キャッシュ、一時計算領域のためのユニファイドメモリも必要です。