
実行プログラムと拡張機能
最終更新
Continuous Batchingと一人で使うときの速度
完了したリクエストの空きに新しいリクエストを入れ、計算を続けます。
Continuous batchingは完了した要求を実行中のバッチから外し、待機中の新しい要求を空きスロットに入れてサーバー計算資源を使い続ける方式です。総処理量が増えることがありますが、個々の最初のトークン1までの時間・トークン間隔・完了時間は別々に測定します。
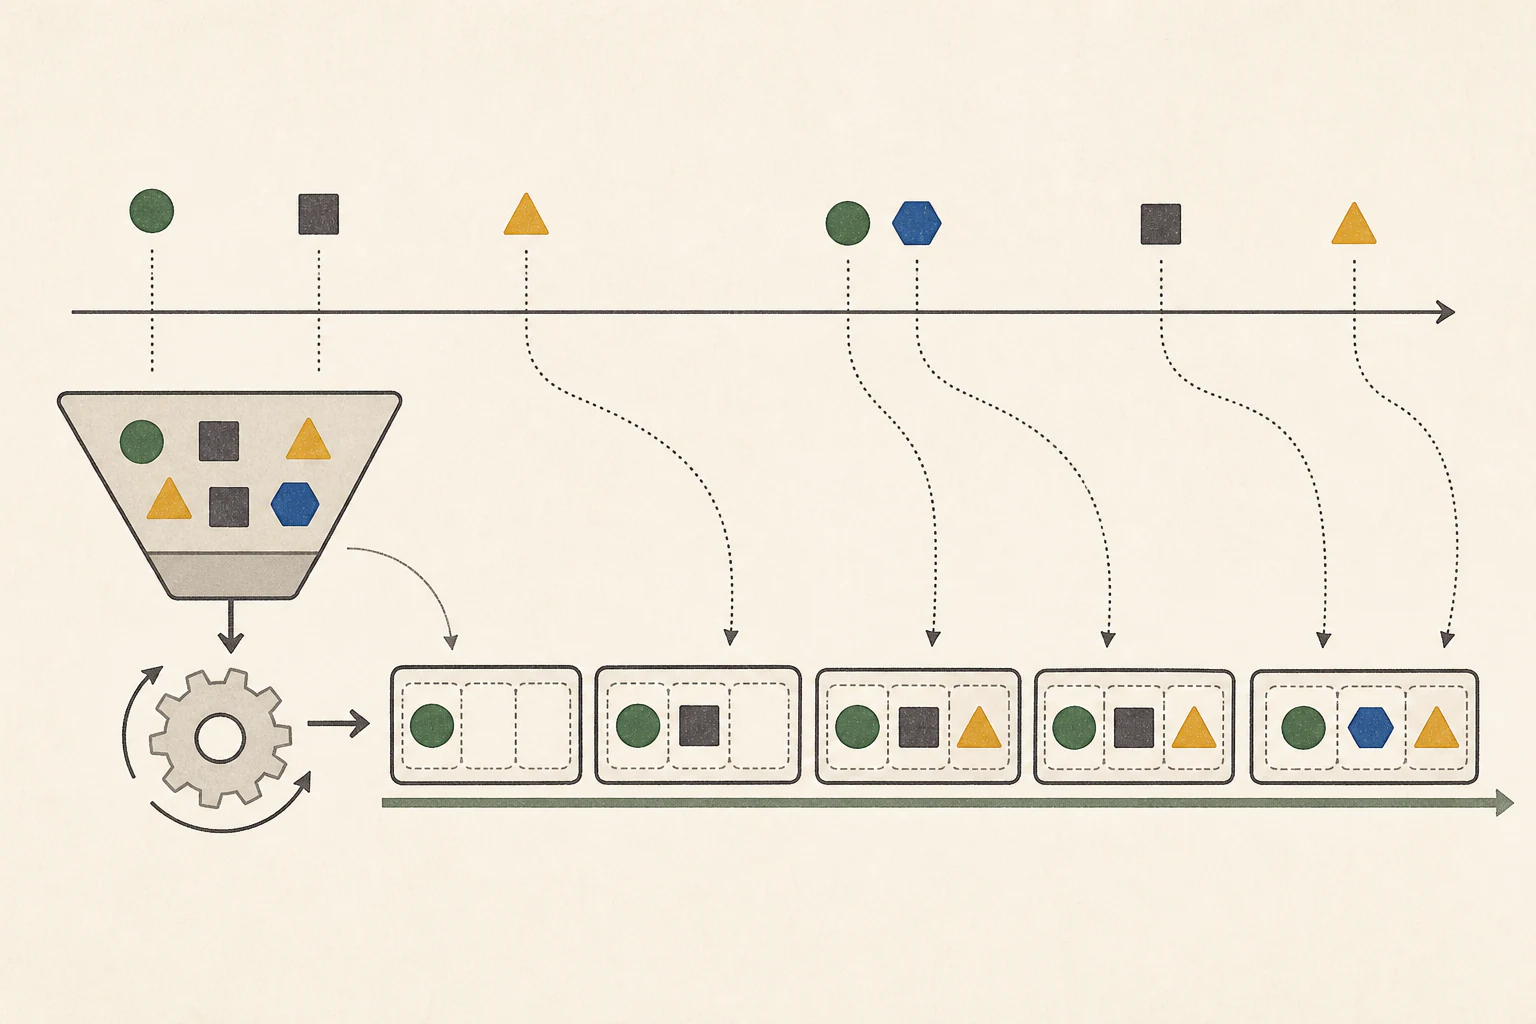
共有サーバーでは、長い契約分析を依頼する人と短い日付確認を送る人がいるかもしれません。到着時刻と回答長が異なると、固定バッチでは要求完了後のスロットが空いたままになりますが、continuous batchingでは待機中の要求でその枠を埋めます。
Continuous batchingは要求完了後のスロットを再利用
固定バッチは決められた要求群を同時に実行するため、短い応答が先に終わると長い要求の完了まで枠が空く場合があります。Continuous batchingは完了要求を外して待機中の要求を追加し、GPU2計算資源を活用し続けます。要求ごとに重みを複製するのではなく、同じモデル重みを複数要求で共有します。
この方式で特に見るのは、重なって到着する要求をサーバーがどれだけ継続して処理できるかです。一人の要求だけなら埋める他のスロットがないため、最初のトークンとトークン間隔を別途確認します。
合算tok/sと一人の応答時間を区別
ダッシュボードの総tok/sは、複数要求で同時生成されたトークンを合算した値の場合があります。個人にとって重要なのは自分の最初のトークンまでの待ち時間・トークン間隔・完了時間です。総スループット3が上がっても、個別要求がキューで待ったりトークン間隔が長くなったりすることがあります。
速度の説明で示される合算値が誰の時間を表すか確認します。サーバーの総処理トークン数は容量比較に使い、文書アプリの体験は要求ごとの遅延で見ます。両指標が同じ割合で変化するとは限りません。
共有重みと要求ごとのKVキャッシュは別物
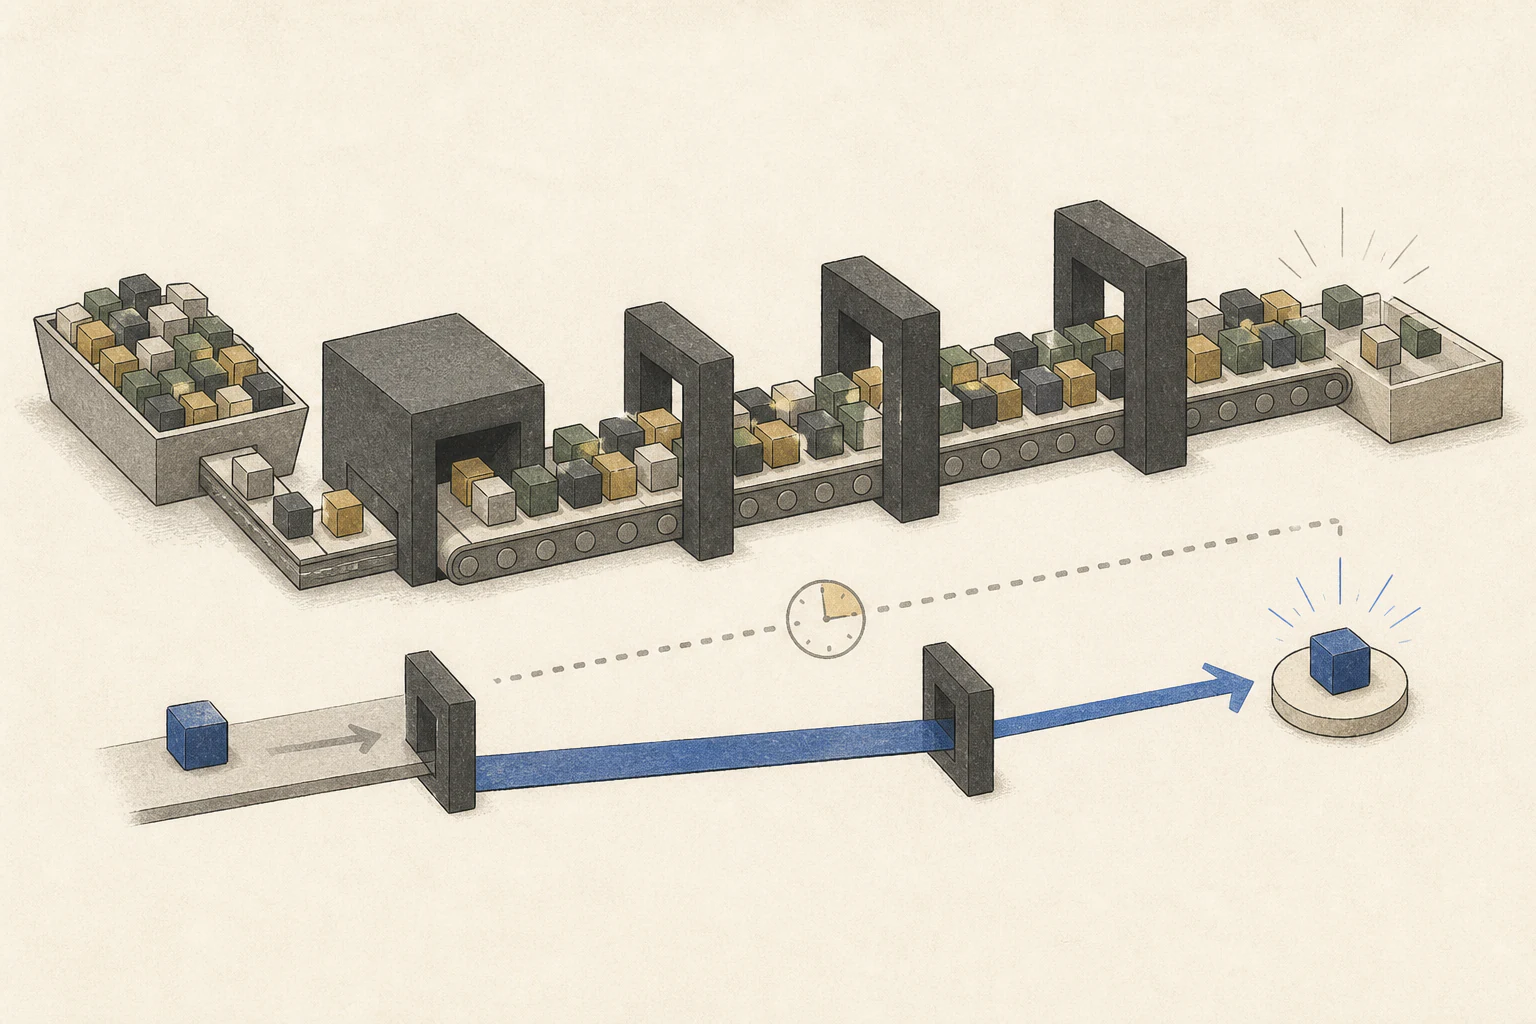
複数要求は同じモデル重みを共有しても、入力コンテキスト・生成出力・続行位置を個別に保持します。この状態には要求ごとのKVキャッシュ4が必要です。同時要求や文書が長くなるとキャッシュメモリも増えるため、余裕を考慮せず同時数とコンテキスト上限を上げないでください。
長文書のprefill5もGPU計算資源を使います。実行中のdecode6と分け合うとトークン間隔が長くなることがあります。一部ランタイム7は長いprefillを分割して要求間でスケジュールしますが、対応とポリシーは実装・設定によって異なります。Paged KVや共通prefixキャッシュはキャッシュ管理や再利用を改善できますが、物理メモリを増やすものではありません。
単一要求向けMTP・投機的デコードがバッチでも動くか確認
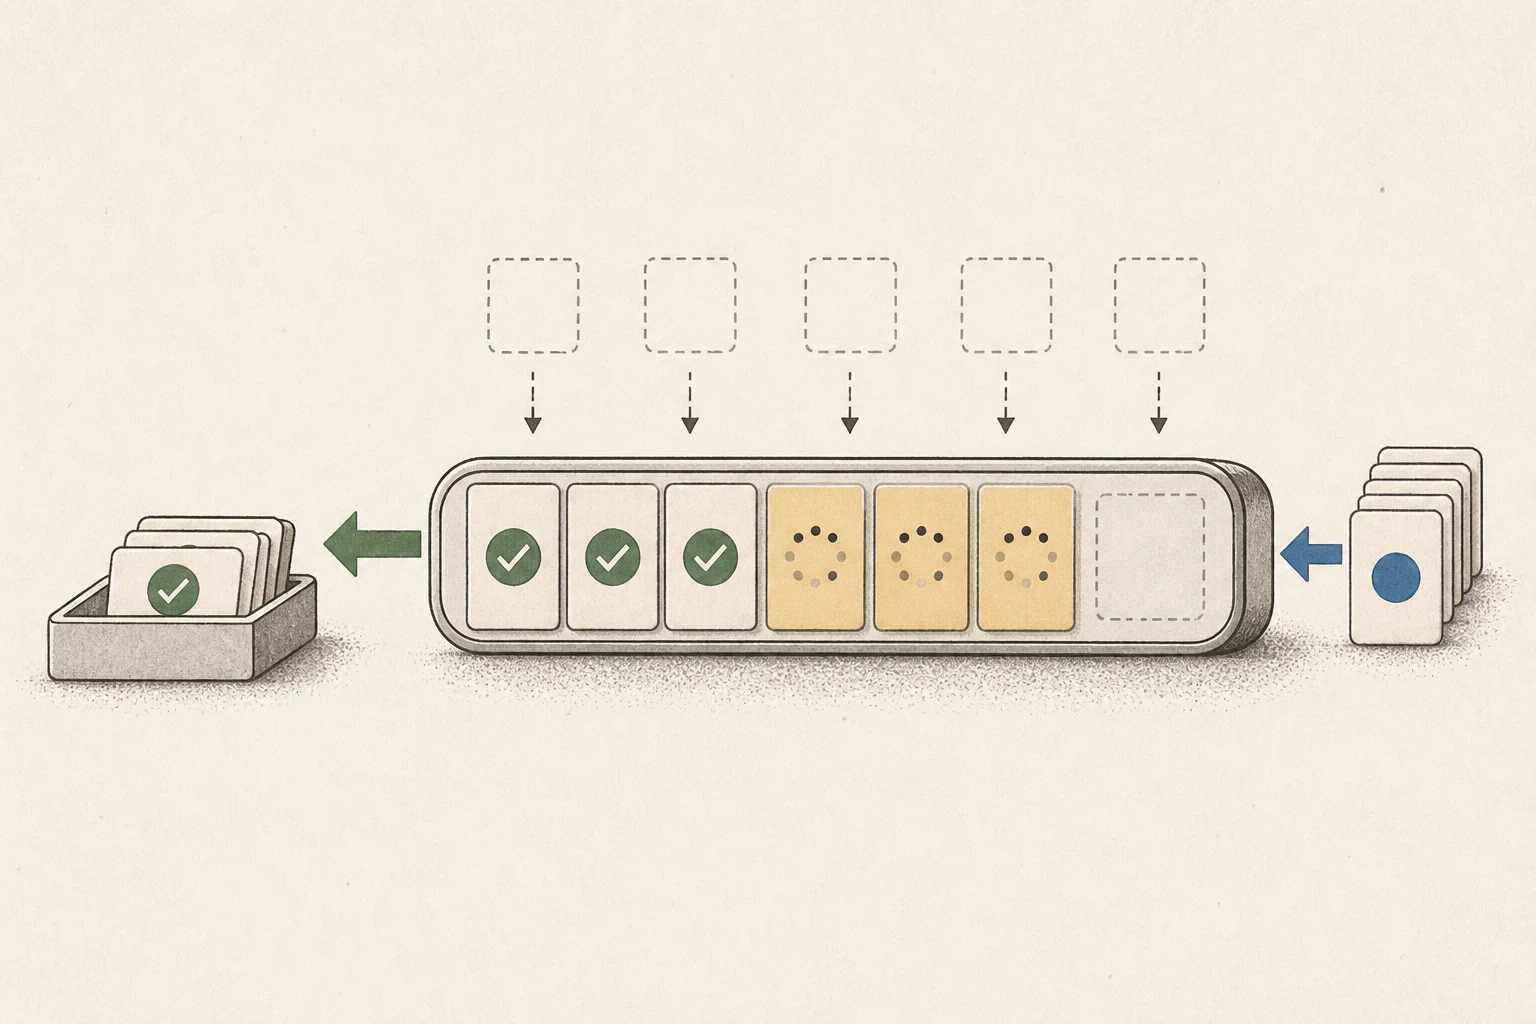
MTP8はモデルに含まれる追加予測ヘッドを使い、投機的デコードは別のドラフトモデルを使う場合があります。どちらも候補トークンを作り、メインモデルが検証する経路を含みます。単一要求で動いてもバッチ実行で対応するかはランタイムとモデル構成によります。
単一要求と複数要求が重なる実行を別々に試し、ログで候補生成と検証経路が実際に使われているか確認します。バッチ経路が非対応なら標準デコードへ戻る場合があります。同時実行時も各会話の最初のトークンとトークン間隔を記録します。
実際の到着順で処理量とユーザー待ちを試す
要求一つの基準を取り、Aの長い分析中にBの短い質問を送り、Bの完了後にCの要約を追加する流れを再現します。到着時刻・最初のトークンまで・トークン間隔・完了時刻・同時数を記録すると、新要求が枠を埋める際の各ユーザーの待ち時間が分かります。
要求が一斉に来る場合と少しずつ届く場合など、実際のアプリに近い到着パターンも試し、平均処理量だけでなく長く待つ要求も確認します。個人利用では単一回答、チーム共有サーバーでは現実的な重なり時の処理量と遅延を運用基準にします。GPU使用率や合算tok/sだけで個人回答の高速化は判断できません。
用語の注釈
トークン — モデルが入力や出力を分けて処理する単位です。
本文に戻るGPU — 多くの計算を並列に処理するプロセッサーです。AIモデルの実行ではモデル計算を担います。
本文に戻るスループット — 一定時間に処理・生成した作業量です。トークン/秒やリクエスト/秒など、単位を合わせて比較します。
本文に戻るKVキャッシュ — 過去トークンのAttention用キー・バリューを保存し、後続トークン生成で再利用するメモリです。容量はコンテキスト長やバッチサイズで変わります。
本文に戻るプリフィル — LLMが入力プロンプトを読み、各トークンの内部表現を計算する段階です。プロンプトが長いほど処理するトークンが増えます。
本文に戻るトークンのデコード — 入力とそれまでの回答をもとに、次の出力トークンを順に生成する段階です。
本文に戻るランタイム — プログラムの実行時に必要な機能を提供するソフトウェア環境です。ローカルAIではモデル実行エンジンを指すこともあります。
本文に戻るMTP — 複数の将来トークンを一度に予測する学習目標、またはそれを行うモデル構成です。投機的デコーディングでは、その予測を候補トークンとして提案できます。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- Continuous batchingは完了した要求を実行中のバッチから外し、待機中の新しい要求を空きスロットに入れてサーバー計算資源を使い続ける方式です。総処理量が増えることがありますが、個々の最初のトークンまでの時間・トークン間隔・完了時間は別々に測定します。
- 必要なメモリはどのくらいですか?
- 複数要求は同じモデル重みを共有しても、入力コンテキスト・生成出力・続行位置を個別に保持します。この状態には要求ごとのKVキャッシュが必要です。同時要求や文書が長くなるとキャッシュメモリも増えるため、余裕を考慮せず同時数とコンテキスト上限を上げないでください。