
実行プログラムと拡張機能
最終更新
FlashAttentionとPagedAttentionの違い
FlashAttentionはデータ移動を減らし、PagedAttentionはKVキャッシュ配置を管理
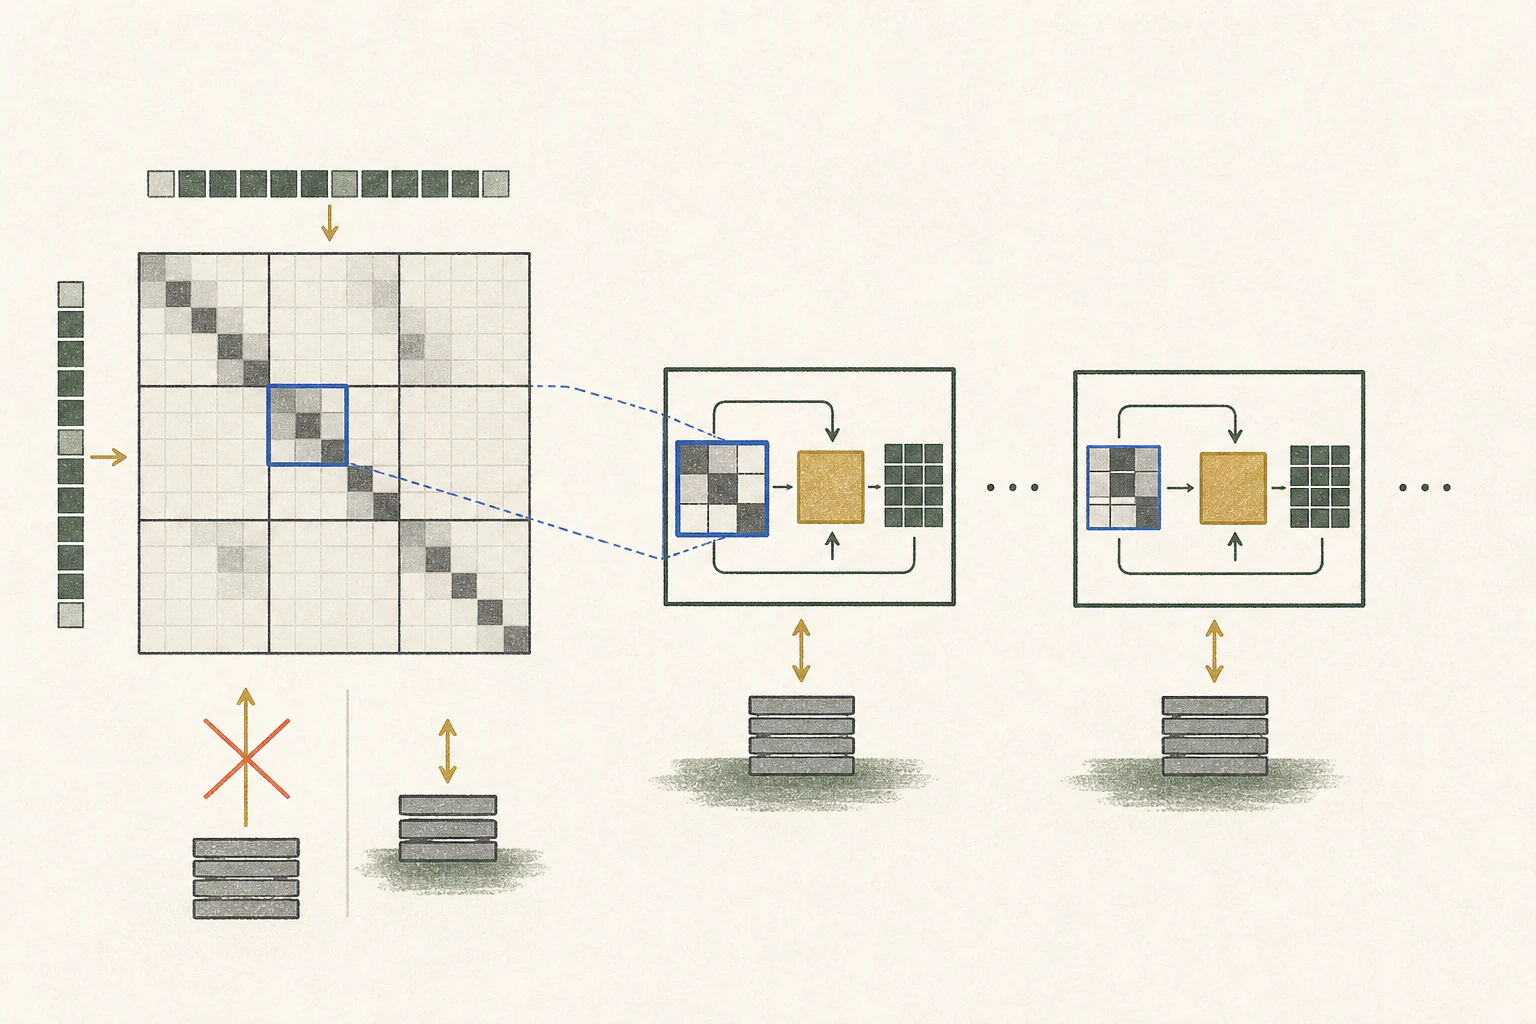
FlashAttention1はattention2計算を小さなtileに分け、中間データのメモリへの反復書き込み・読み込みを減らします。PagedAttentionは複数要求のKVキャッシュ3を固定ブロックに分け、必要量を割り当てて回収します。一方は計算カーネル、もう一方は要求ごとのメモリ管理で役割が異なり、両方が同時に使われる場合もあります。
長いコードリポジトリを読む要求では入力トークン4間の関係を計算するprefill5を行い、回答生成中は続きを作る状態をKVキャッシュに保存します。FlashAttentionは前段のattention計算におけるメモリ移動を、PagedAttentionは複数要求のキャッシュ配置を扱います。
FlashAttentionは長い入力のattention計算をtile化
モデルはattentionで入力トークン同士が参照する情報を計算します。入力が長いほど、中間結果をGPU6メモリへ書き込み再読込する移動が増えます。FlashAttentionは小さなtile単位で処理し、大きな中間配列を何度も保存しないことでデータ移動を減らします。
入力全体をアテンション計算に使いながら、中間結果の保存と移動を減らす方法です。長い入力で最初のトークンを待つ時間が長い場合は、モデル読み込みとプリフィルを分けて記録し、実行ログでFlashAttentionカーネルが選択されたか確認します。
PagedAttentionは要求ごとのKVキャッシュ領域を管理
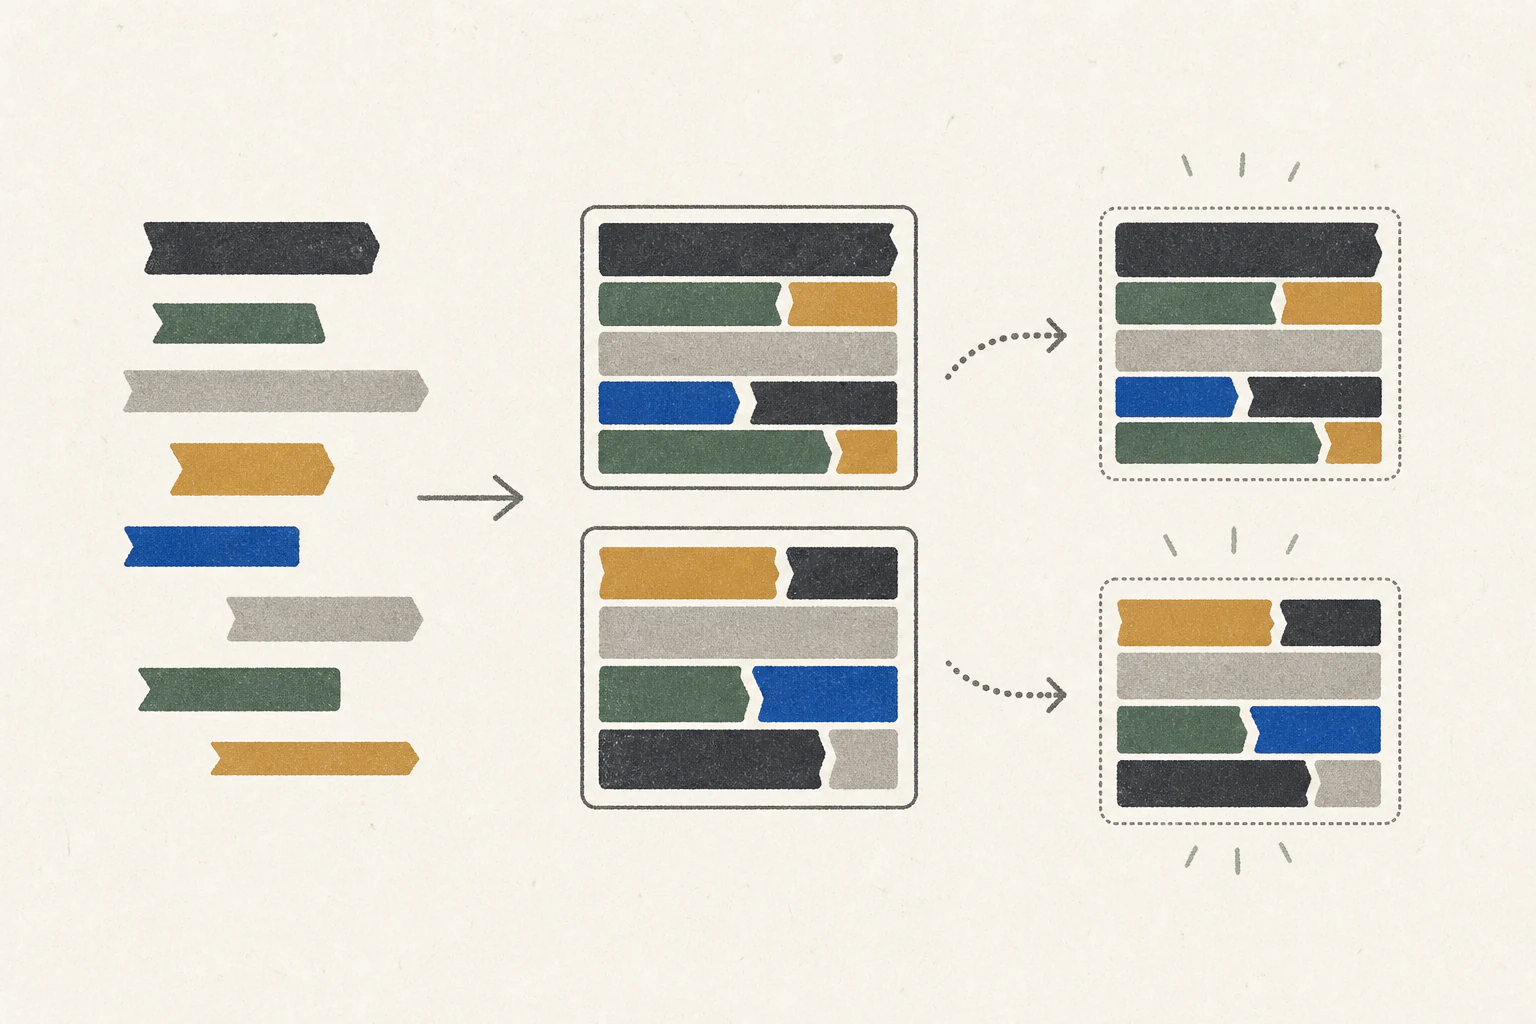
異なる長さの要求が届くと、各会話は入力と生成済みトークンの状態をKVキャッシュに保持します。PagedAttentionはキャッシュを固定サイズのブロックで管理し、要求に必要な分を割り当て、完了後に回収します。要求ごとに大きな連続領域を予約する場合の空きを減らすことが目的です。
リクエストAの処理中に短いBが終われば、Bのブロックを回収してCに割り当てられます。Aの会話に必要な状態はAが終わるまで保持します。同じGPUメモリ内で、リクエストごとの領域を効率よく使う仕組みです。
同時要求や文書が長くなれば、稼働中の状態を保持するキャッシュが必要です。入力prefillが実行中decode7とGPU計算を共有するとトークン間隔が延びることがあり、長いprefillを分割・スケジュールする対応はランタイム8によって異なります。キャッシュ配置を効率化しても稼働状態を収める物理メモリは必要です。
役割が異なるため併用できる
FlashAttentionはattention計算中のメモリ移動を変え、PagedAttentionは各要求のKVキャッシュをブロックに割り当てます。ランタイムが両方をサポートすれば、prefill計算と要求メモリ管理を併せて最適化できます。長いコード入力でprefillが遅い問題と、チーム同時利用でキャッシュが足りない問題は別々に確認します。
対応状況はGPU・モデル構造・量子化9・アプリ版によって異なり、ランタイムが自動選択する場合もあります。メニューにオプション名があるだけで適用を判断せず、ログで実際のカーネルとキャッシュ経路を確認します。設定を強制する前に正常動作する既定値を記録します。
単一要求とチームサーバーを分けて測定
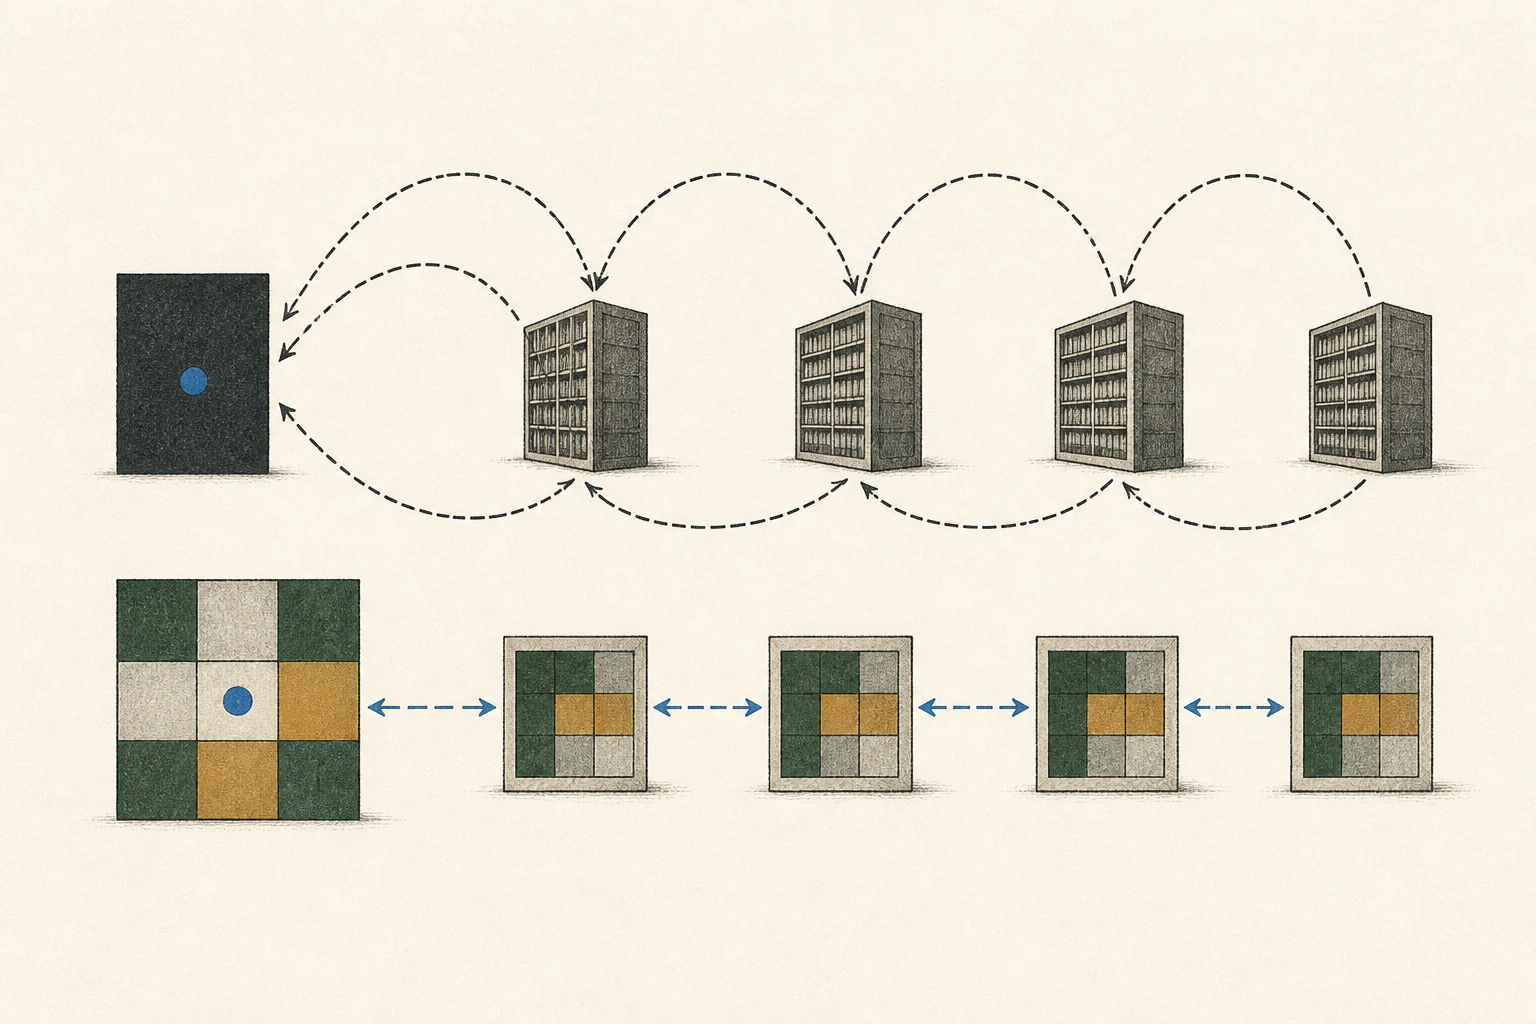
短い関数質問を一つだけ行う個人利用では、同時キャッシュ状態が少なくPagedAttentionのサーバーメモリ配置の効果は小さい場合があります。FlashAttentionの効果もprefillと逐次decodeで同じとは限りません。最初のトークンまでの時間と生成中のトークン間隔を分けて記録します。
チームサーバーでは単一要求の基準を取り、長いコード分析中に短い質問と別の分析を重ねます。最初のトークン・生成区間・ピークメモリ・要求ごとの遅延・総処理量を記録すると、カーネルとキャッシュ管理のどちらの変更が利用者に役立ったか見られます。
ランタイムが提供する設定を一つずつ試し、ログで適用を確認します。利用者が変更できる項目がない場合は設定を作らず、自動選択をログで調べます。入力計算がボトルネックならFlashAttention経路、同時要求時のキャッシュ配置が課題ならPagedAttention対応を確認します。
用語の注釈
FlashAttention — Attentionを小さなタイルに分けて計算し、中間値を高速なオンチップメモリに保つことで、GPUメモリとの往復とAttention行列全体の保存を減らすアルゴリズムです。
本文に戻るAttention — 入力トークン間の関連度を計算し、各位置の情報を現在の表現に反映するニューラルネットワーク演算です。
本文に戻るKVキャッシュ — 過去トークンのAttention用キー・バリューを保存し、後続トークン生成で再利用するメモリです。容量はコンテキスト長やバッチサイズで変わります。
本文に戻るトークン — モデルが入力や出力を分けて処理する単位です。
本文に戻るプリフィル — LLMが入力プロンプトを読み、各トークンの内部表現を計算する段階です。プロンプトが長いほど処理するトークンが増えます。
本文に戻るGPU — 多くの計算を並列に処理するプロセッサーです。AIモデルの実行ではモデル計算を担います。
本文に戻るトークンのデコード — 入力とそれまでの回答をもとに、次の出力トークンを順に生成する段階です。
本文に戻るランタイム — プログラムの実行時に必要な機能を提供するソフトウェア環境です。ローカルAIではモデル実行エンジンを指すこともあります。
本文に戻る量子化 — モデルの重みや計算値を少ないビット数で表し、保存容量やメモリ使用量を減らす方法です。表現が粗くなるため、精度にも影響することがあります。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- FlashAttentionはattention計算を小さなtileに分け、中間データのメモリへの反復書き込み・読み込みを減らします。PagedAttentionは複数要求のKVキャッシュを固定ブロックに分け、必要量を割り当てて回収します。一方は計算カーネル、もう一方は要求ごとのメモリ管理で役割が異なり、両方が同時に使われる場合もあります。
- 必要なメモリはどのくらいですか?
- 異なる長さの要求が届くと、各会話は入力と生成済みトークンの状態をKVキャッシュに保持します。PagedAttentionはキャッシュを固定サイズのブロックで管理し、要求に必要な分を割り当て、完了後に回収します。要求ごとに大きな連続領域を予約する場合の空きを減らすことが目的です。