
まず読み込み
最終更新
プリフィルとデコードの違い:TTFTとtok/sのどちらを見る?
長い入力ではTTFT、長い回答ではdecode速度が待ち時間を左右します
コードとエラーの説明を送ると、LLM1はまず入力を読み、その後レビュー回答を作ります。入力token2を処理する段階がprefill3、回答tokenを順に生成する段階がdecode4です。prefillの後に最初の回答が現れ、decode中に残りが続きます。
コードやエラー説明が長いと最初の回答までの待ち時間が延びることがあります。詳しい回答を求めれば、文章が続く時間も長くなります。同じコードレビューでも入力と出力の長さによって待つ段階が変わります。2つの段階を知ると、自分の作業に必要な速度を比較しやすくなります。
最初の文字が出る前に入力を読みます
コードレビューの依頼にはコード、エラーの状況、求める回答の範囲が含まれます。モデルは回答を書く前に入力をtoken単位で処理し、token間の関係を計算して回答に使う状態を準備します。これがprefillです。その後decodeで回答tokenを順に生成します。複数ファイルを添付すると入力tokenが増え、最初の回答まで長く待つことがあります。
prefillを比較する際は、ファイル数や行数より実際の入力token数を揃えることが重要です。コードのtoken分割方式は異なり、アプリが関連ファイルだけ送る場合も、リポジトリを広く含める場合もあるためです。レビューアプリがモデルに実際に送った入力長を確認すると、処理速度をより正確に比較できます。
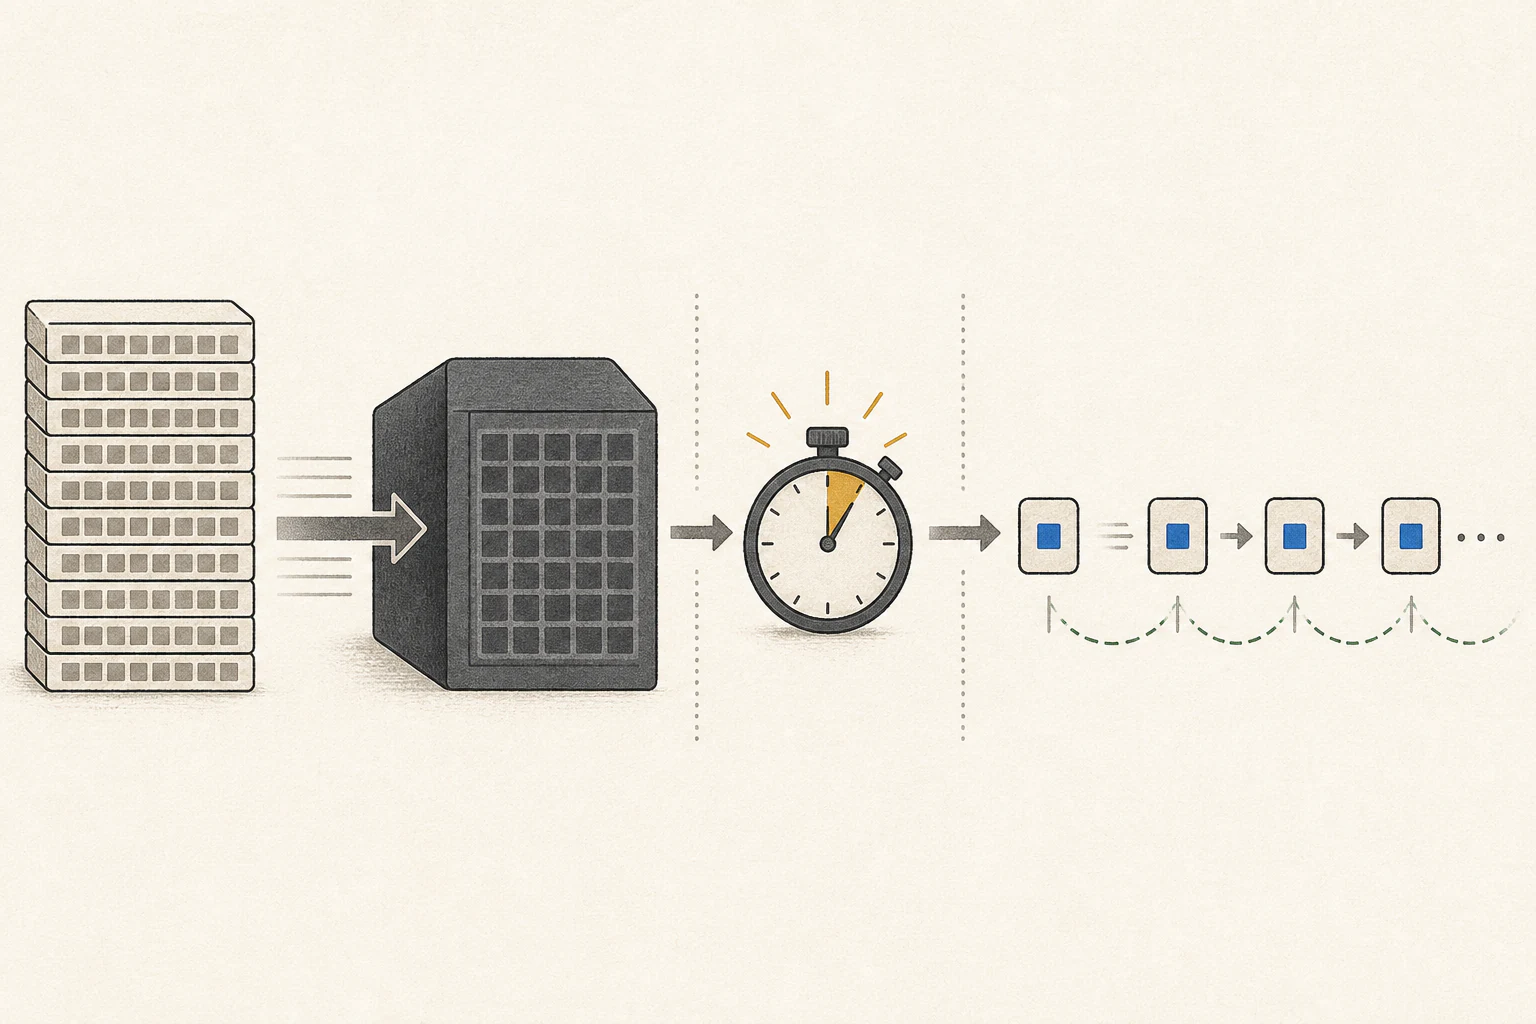
最初のtokenまでの待ち時間をTTFTと呼びます
TTFT5(time to first token)は、リクエストを送ってから最初の出力トークンが画面に現れるまでの時間です。prefillのほか、アプリ側の入力準備、キュー待ち、トークン化、実行準備が含まれる場合があります。prefill処理量は入力トークンを処理する速さ、TTFTはリクエストから最初のトークンまで利用者が待った時間です。
prefill処理量の比較には入力token/秒を、最初の回答までの待ち時間にはTTFTを使います。アプリがキュー待ちや前処理時間を個別に表示しない場合があるため、画面に最初のtokenが現れるまでの実測時間も記録してください。
| 段階・指標 | 処理内容 | 利用者が待つ場面 |
|---|---|---|
| プリフィル | 入力tokenとcontextを処理して回答を準備します。 | コードとエラー説明を送ってから最初のtokenまで |
| TTFT | リクエストから最初の出力tokenまでの全遅延です。 | 回答の最初の部分が画面に現れるまで |
| デコード | 最初のtokenの後に出力tokenを順に生成します。 | 回答が画面に続けて表示される間 |
| 完了時間 | 最初のtokenまでの遅延と回答生成がすべて終わるまでの時間です。 | レビュー全体が完成するまで |
回答が続く速度はdecodeで比較します
最初のtoken以降に回答が続く速さは、毎秒token数(tok/s)で表します。同じtoken数の回答ならtok/sが高いほどdecode時間は短くなります。ただし韓国語の文字数とtoken数は一対一で対応しないため、tok/sだけで完了時間を正確に計算することはできません。
エラー原因を一行だけ尋ねる場合は出力が短く、最初のtokenまでの待ち時間がより大きく感じられることがあります。複数ファイルの修正方針と根拠を求めると回答が長くなり、すぐに始まっても最後まで受け取るのに時間がかかります。必要な回答の長さによって重視する指標が変わります。
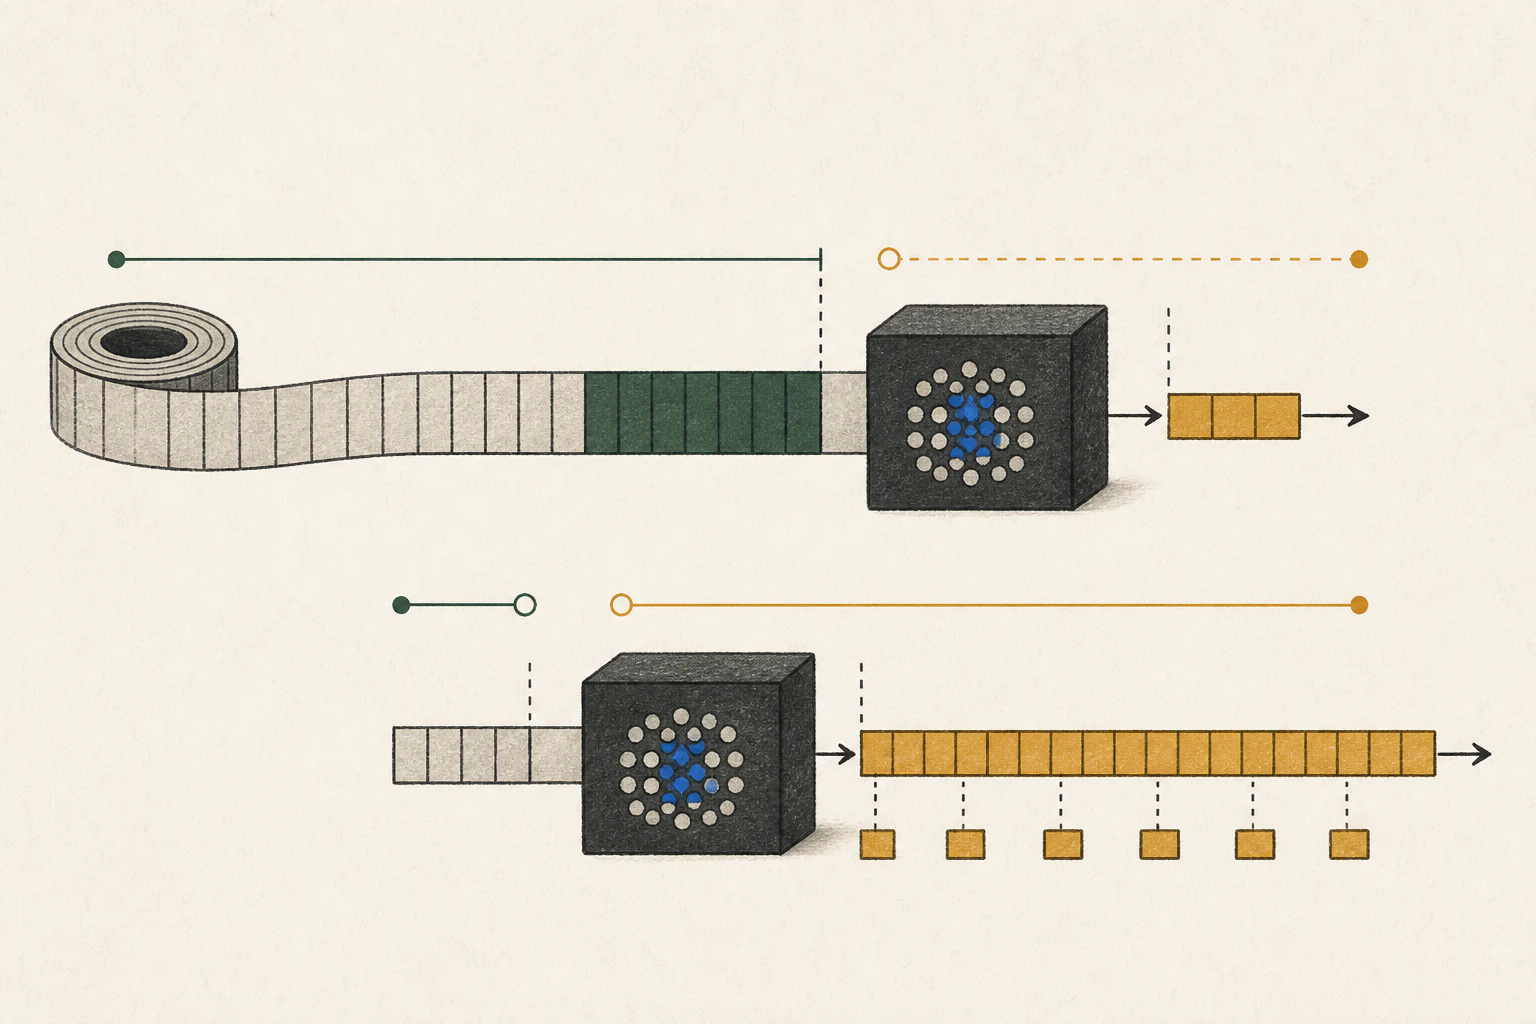
最初の応答から完了までの時間を計算します
たとえばTTFTが8秒、回答が500token、decode速度が50 tok/sなら、生成に500÷50=10秒かかります。最初のtokenまでの待ち時間を加えると完了まで約18秒です。prefill改善でTTFTが4秒なら約14秒、decodeが100 tok/sなら約13秒と見積もれます。実際の完了時間は最初のtokenまでの遅延と残りの回答生成時間を合わせたものです。以下は計算を単純化した仮定であり、機器の実測値ではありません。
左右にスクロールして各項目を比較できます。
| 仮定 | TTFT | デコード速度 | 完了まで |
|---|---|---|---|
| 基準 | 8秒 | 50 tok/s | 約18秒(8+500÷50) |
| prefill改善 | 4秒 | 50 tok/s | 約14秒(4+500÷50) |
| decodeの改善 | 8秒 | 100 tok/s | 約13秒(8+500÷100) |
繰り返し入力と新しい入力は異なる処理を受けます
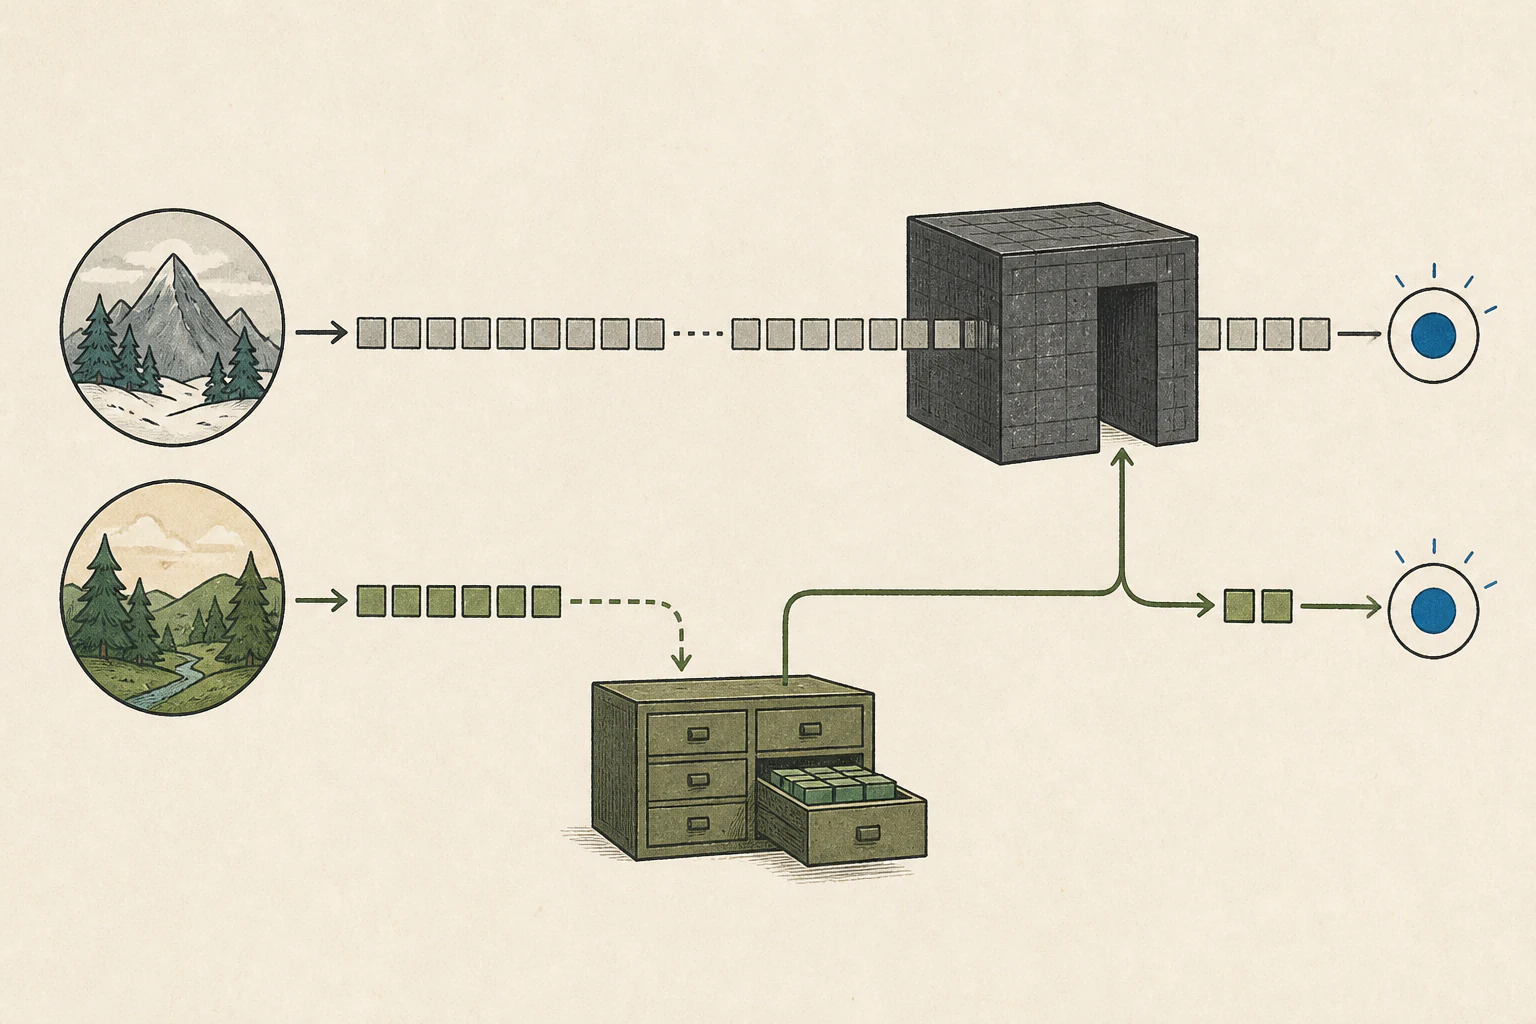
同じコードレビューを続ける際、入力の先頭部分が繰り返されるとprompt6 cacheが計算状態を再利用してTTFTを短縮することがあります。これはSSD7からモデルファイルを再び読み込むこととは異なります。cacheが保持されているか、質問の先頭がどれだけ一致するかによって再利用量が変わります。
SpecPrefill8は長い新規入力から処理するtokenを選び、本体モデルの計算量を減らすことを目指す方法です。prompt cacheが以前のリクエストの共通入力を再利用するのに対し、SpecPrefillは新しい入力から処理対象を選びます。コードレビューでは省かれた部分にエラー原因がある可能性があるため、必要な根拠が回答に残っているか元のコードと照らし合わせます。
後続の質問では別の文書箇所や以前の会話が追加されることがあり、入力全体が短くなるとは限りません。新たに検索された段落は処理が必要ですが、cacheは共通prefixを一部再利用できます。文書、質問、文書処理方法、モデル、アプリのバージョンを記録すると結果を再確認しやすくなります。
自分の作業で待ち時間の段階を比較します
コードと質問を固定してモデルを比較すると、最初の回答が遅いのか、回答が続くのが遅いのかを分けて見られます。同じ条件で複数回実行してTTFTと完了時間を別々に記録し、新しい会話の初回かcacheが残る後続質問かを明記してください。
比較画面では入力長を変えたり、全体モードとdecodeのみのモードを選んだりできます。全体モードは最初のtokenまでの遅延と回答生成を合わせ、decodeのみのモードは出力が続く速度を比較します。表示値は選択条件での推定であり、実際のアプリで同じコードを実行した時間とは異なる場合があります。
用語の注釈
大規模言語モデル — 大量のテキストデータから言語パターンを学び、文脈に沿ったテキストを処理・生成するモデルです。
本文に戻るトークン — モデルが入力や出力を分けて処理する単位です。
本文に戻るプリフィル — LLMが入力プロンプトを読み、各トークンの内部表現を計算する段階です。プロンプトが長いほど処理するトークンが増えます。
本文に戻るトークンのデコード — 入力とそれまでの回答をもとに、次の出力トークンを順に生成する段階です。
本文に戻る最初のトークンまでの時間 — リクエスト送信から最初の出力トークンが届くまでの時間です。
本文に戻るプロンプト — モデルに送る入力文です。生成モデルでは作りたい結果を説明する文になり、出力の構成や内容を大きく左右します。
本文に戻るSSD — フラッシュメモリを使うデータ保存装置です。電源を切ってもデータが保持されます。
本文に戻るSpecPrefill — 軽量モデルで入力トークンの重要度を推定し、選んだトークンをメインモデルへ渡してプリフィル計算を減らす手法です。メインモデルが読まない文脈が生じるため、トークン選択によって回答に反映される情報が変わります。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- コードとエラーの説明を送ると、LLMはまず入力を読み、その後レビュー回答を作ります。入力tokenを処理する段階がprefill、回答tokenを順に生成する段階がdecodeです。prefillの後に最初の回答が現れ、decode中に残りが続きます。