
応答速度と加速
最終更新
llama.cppでDFlashとDSparkを実行する:Qwen3-4Bで確認
DFlash・DSparkはdraftが候補を出し、メインモデルが検証します
speculative decoding1は小型draft modelが後続token2を提案し、メインモデルが検証して一致する連続範囲を採用する生成方式です。llama.cppでQwen3-4Bを使う場合、対応するDFlashまたはDSpark draft GGUF3を準備し、一つずつ比較します。
code reviewの回答開始後に文章が続くのが遅い場合は生成区間を試せます。最初の文字より前の待ちが長い場合はPDF検索、入力処理、メモリが原因かもしれず、draft候補を加えるだけでは短縮しないことがあります。
まずQwen3-4B単体で基準serverを確認します
repository内の関数1つを修正し、空入力と通常入力を扱う同じ依頼を基本実行とdraft実行に送ります。diffとtestで修正要件を確認します。draft提案と複数位置の検証にも計算がかかるため実作業で判断します。
モデルに対応するllama.cppビルドと、ソースフォルダーのconvert_hf_to_gguf.pyを用意してから実行します。そのフォルダーでHugging Faceのモデルを取得し、GGUFに変換してtargetサーバーを起動します。文脈4,096トークンと1リクエストで基準を固定します。標準サーバーが応答しなければ、モデルパス、ビルド対応、メモリを先に確認します。
hf download Qwen/Qwen3-4B --local-dir ./hf-models/Qwen3-4B
python convert_hf_to_gguf.py ./hf-models/Qwen3-4B --outfile ./models/Qwen3-4B.gguf --outtype bf16
llama-server -m ./models/Qwen3-4B.gguf --alias qwen3-4b --host 127.0.0.1 --port 8080 --ctx-size 4096 --parallel 1 --n-gpu-layers autocurl -sS http://127.0.0.1:8080/health
curl -sS http://127.0.0.1:8080/v1/chat/completions -H 'Content-Type: application/json' -d '{"model":"qwen3-4b","messages":[{"role":"user","content":"Reply with one short sentence."}],"temperature":0,"max_tokens":64,"stream":false}'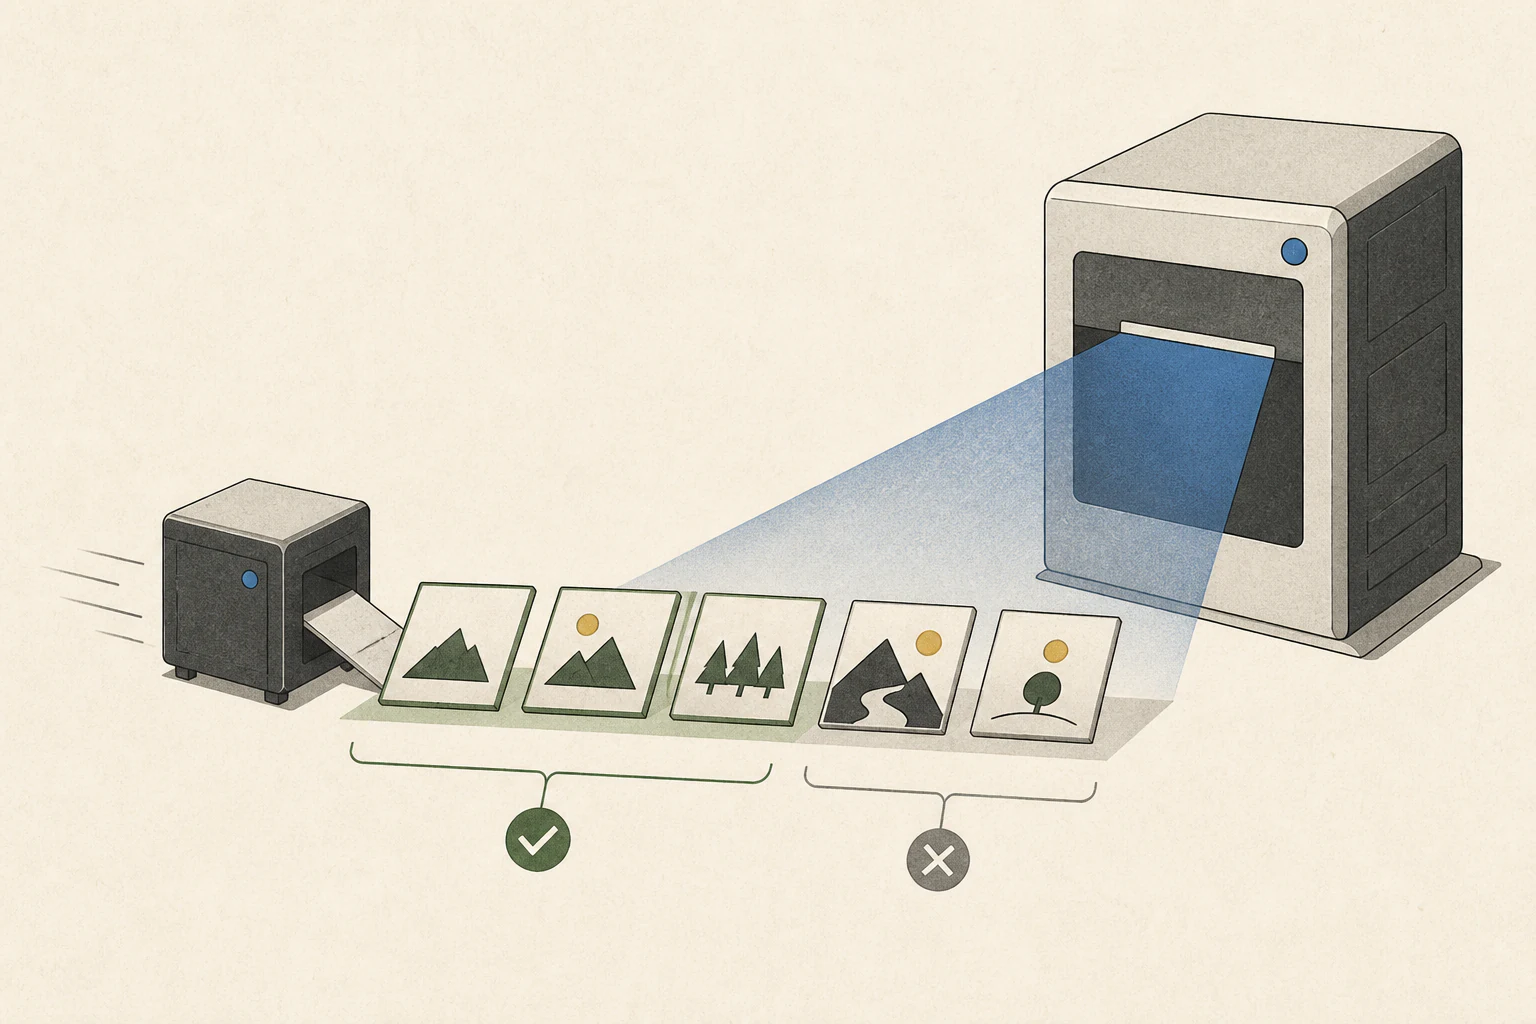
targetに合うDFlashまたはDSparkを選びます
公式例ではz-lab/Qwen3-4B-DFlashをQwen/Qwen3-4B targetと組み合わせます。DFlashはblock diffusion draftを使い、DSparkはdraft構造にMarkov headを加えます。任意の小型モデルを代用せずtarget用に学習されたdraftを使います。
以下のcommandは両modelの原本directoryが準備済みと仮定します。Qwen3-4B targetを固定し、変換したdraftを一度に一つずつ接続します。例のdraft上限はDFlashが15、DSparkが7で、学習済みblockサイズにより制限される場合があります。他モデルではmodel cardと変換結果を確認します。
各比較では 8080 ポートを使うサーバーを一つずつ起動します。基準サーバーのターミナルで Ctrl+C を押して停止し、DFlash サーバーを開始してください。準備ができたら別のターミナルから同じ質問を送り、結果を記録します。
DFlash を停止した後、同じ手順で DSpark を試します。2 つの draft モデルはサーバーを起動する前にダウンロードして変換しておいてください。
hf download z-lab/Qwen3-4B-DFlash --local-dir ./hf-models/Qwen3-4B-DFlash
python convert_hf_to_gguf.py ./hf-models/Qwen3-4B-DFlash --target-model-dir ./hf-models/Qwen3-4B --outtype bf16 --outfile ./models/Qwen3-4B-DFlash.gguf
# Stop the previous server with Ctrl+C before starting this one.
llama-server -m ./models/Qwen3-4B.gguf -md ./models/Qwen3-4B-DFlash.gguf --spec-type draft-dflash --spec-draft-n-max 15 -fa on --jinja --host 127.0.0.1 --port 8080 --ctx-size 4096 --parallel 1

hf download deepseek-ai/dspark_qwen3_4b_block7 --local-dir ./hf-models/dspark_qwen3_4b_block7
python convert_hf_to_gguf.py ./hf-models/dspark_qwen3_4b_block7 --target-model-dir ./hf-models/Qwen3-4B --outtype bf16 --outfile ./models/Qwen3-4B-DSpark.gguf
# Stop the previous server with Ctrl+C before starting this one.
llama-server -m ./models/Qwen3-4B.gguf -md ./models/Qwen3-4B-DSpark.gguf --spec-type draft-dspark --spec-draft-n-max 7 -fa on --jinja --host 127.0.0.1 --port 8080 --ctx-size 4096 --parallel 1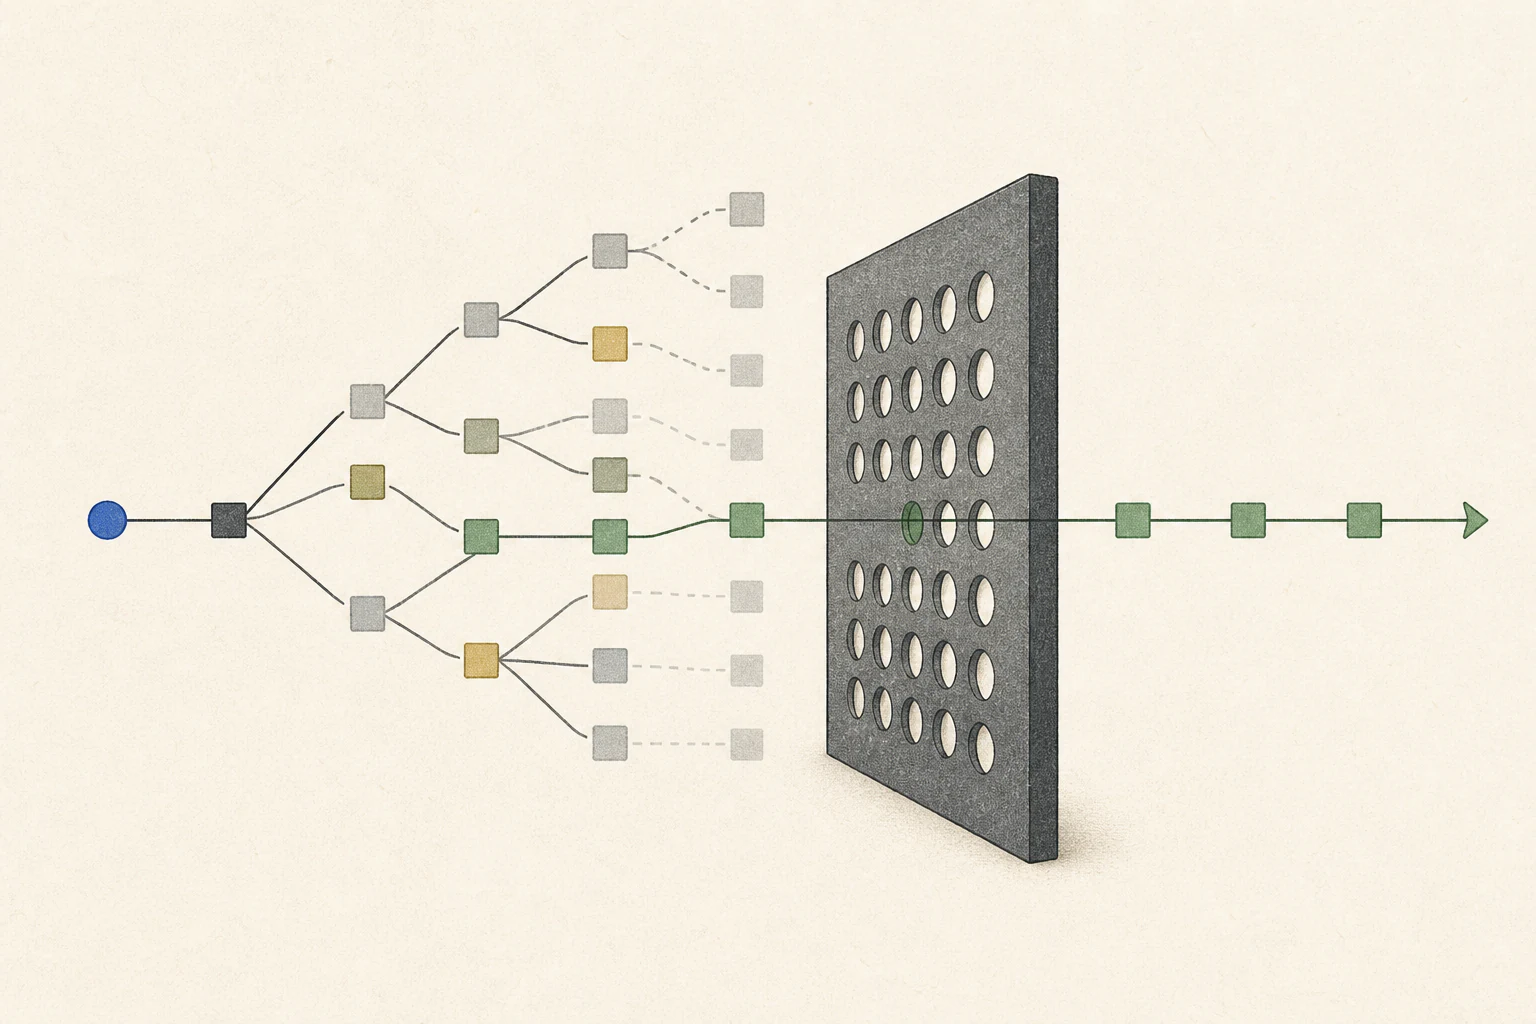
logと応答でdraft経路の適用を確認します
各server logでdraft fileが開き、DFlashまたはDSparkが初期化されたか確認します。メインモデルだけで回答した実行を加速比較に含めません。準備後に同じrequestを送り、choices[0].message.contentに回答があるか、model identifierとerror logも確認します。
基準実行と同じmodel file、prompt4、sampling、context、出力上限、device状態を保ちます。準備後に複数回実行して中央値と範囲を記録し、server初回起動とモデル読み込み済みの実行を分けます。greedy requestで回答を比較し、code diffとtestで修正範囲を確認します。
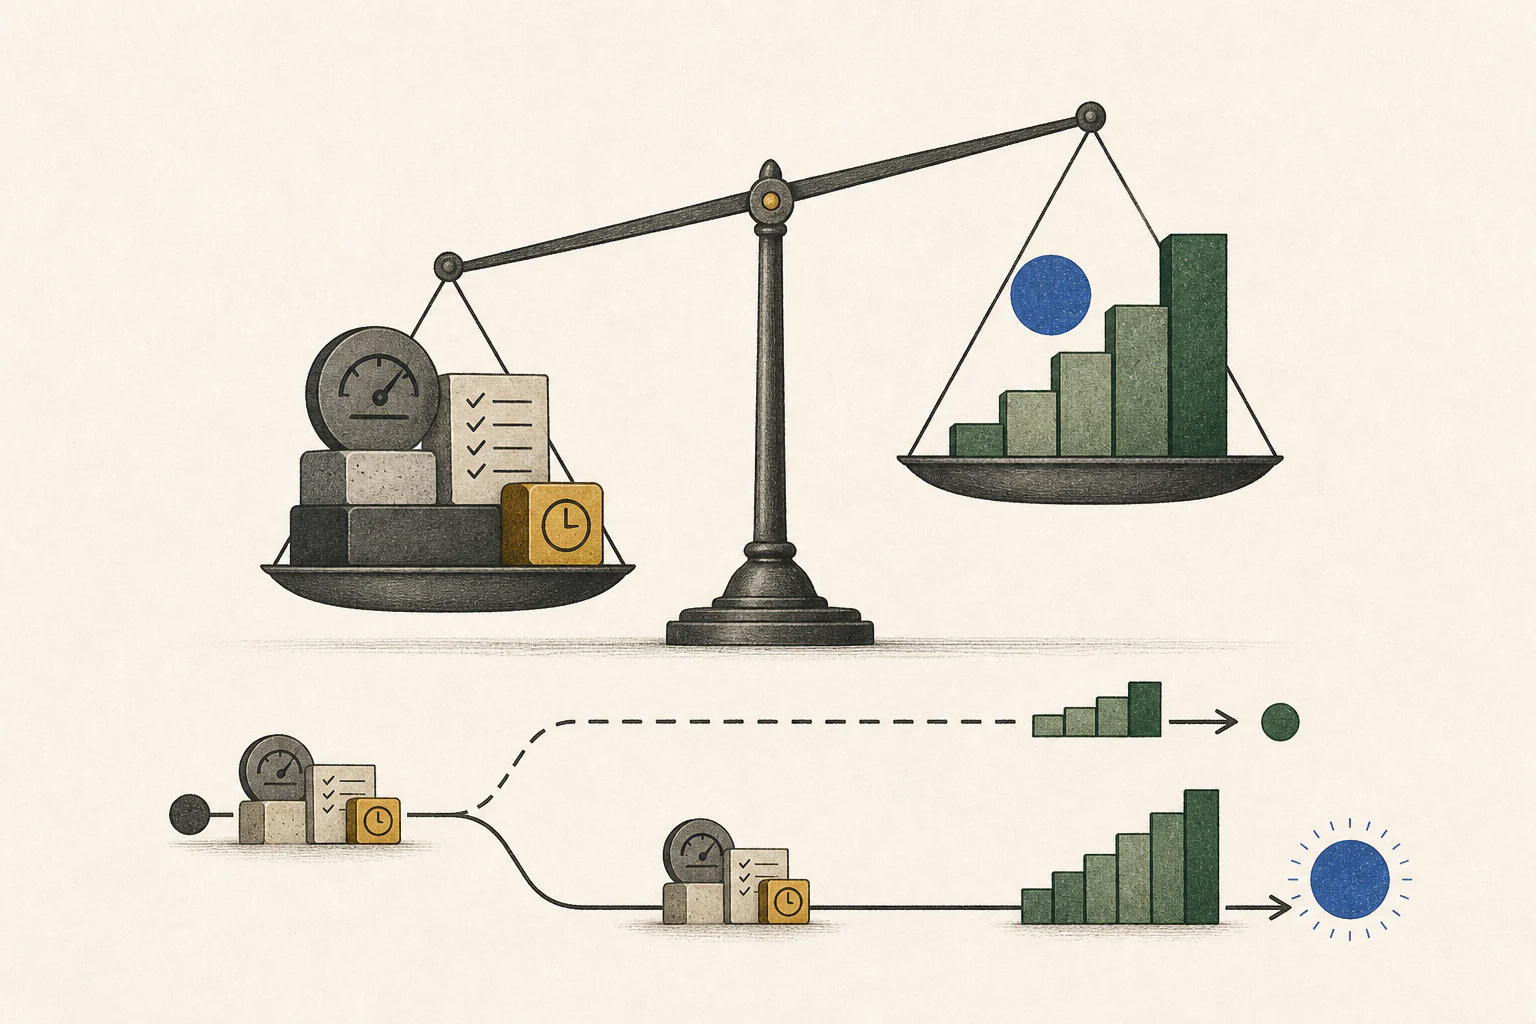
完了時間、生成token数、speculative統計のdraft/accepted長、メモリを記録します。accepted token数だけで待ち時間短縮を判断せず、同じrequestのdecode5と全体完了も比較します。draft初期化やメモリで失敗したらdraftを外し、基準serverが再度応答するか確認してからfile、backend、block上限を一つずつ調べます。
追加メモリと実作業での効果を合わせて判断します
用語の注釈
投機的デコーディング — ドラフトモデル、MTPヘッド、反復文脈の検索が出力候補を先に作り、メインモデルが検証して確定する生成手法です。
本文に戻るトークン — モデルが入力や出力を分けて処理する単位です。
本文に戻るGGUF — モデル情報を格納するファイル形式で、llama.cpp系のツールで広く使われます。
本文に戻るプロンプト — モデルに送る入力文です。生成モデルでは作りたい結果を説明する文になり、出力の構成や内容を大きく左右します。
本文に戻るトークンのデコード — 入力とそれまでの回答をもとに、次の出力トークンを順に生成する段階です。
本文に戻る量子化 — モデルの重みや計算値を少ないビット数で表し、保存容量やメモリ使用量を減らす方法です。表現が粗くなるため、精度にも影響することがあります。
本文に戻るランタイム — プログラムの実行時に必要な機能を提供するソフトウェア環境です。ローカルAIではモデル実行エンジンを指すこともあります。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- speculative decodingは小型draft modelが後続tokenを提案し、メインモデルが検証して一致する連続範囲を採用する生成方式です。llama.cppでQwen3-4Bを使う場合、対応するDFlashまたはDSpark draft GGUFを準備し、一つずつ比較します。
- 必要なメモリはどのくらいですか?
- 完了時間、生成token数、speculative統計のdraft/accepted長、メモリを記録します。accepted token数だけで待ち時間短縮を判断せず、同じrequestのdecodeと全体完了も比較します。draft初期化やメモリで失敗したらdraftを外し、基準serverが再度応答するか確認してからfile、backend、block上限を一つずつ調べます。