
応答速度と加速
最終更新
Prompt Lookupとn-gram投機的デコーディング
繰り返す原文を次のトークン候補に使う
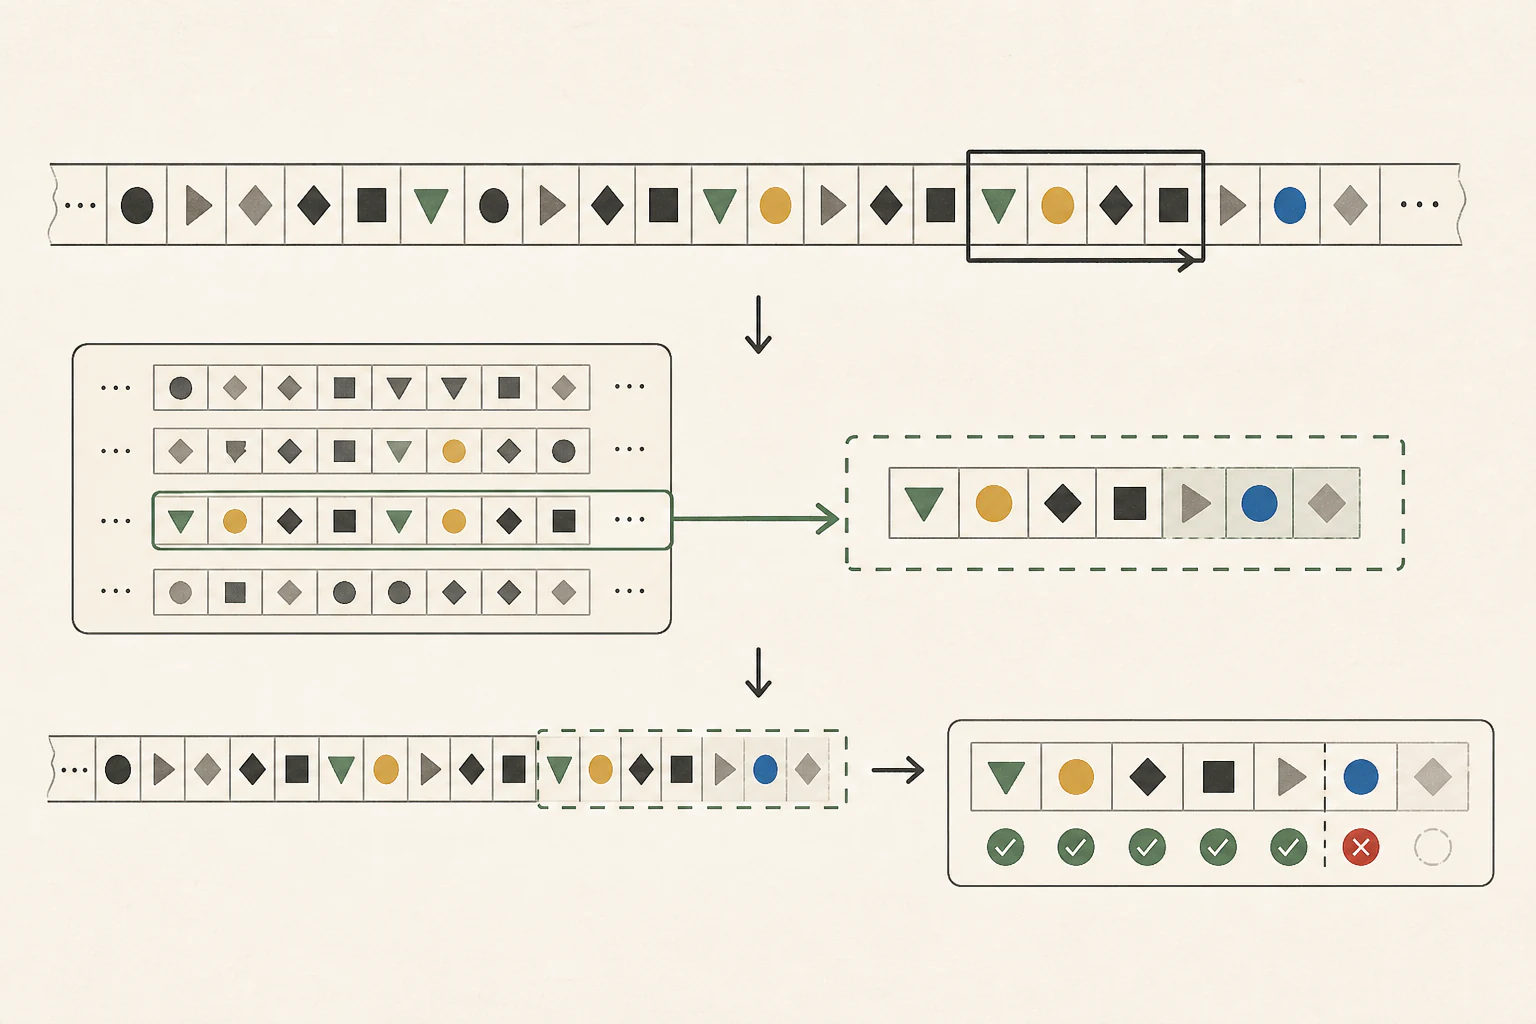
Prompt Lookup1は入力や生成済みの回答から繰り返すトークン2列を探し、その続きを出力候補に使います。本モデルが検証し、一致する部分を回答に残します。原文を多く残すコード修正や文書の書き直しで生成時間を短縮できる場合があります。
関数名だけを変えてコードを再出力するとき、回答の多くはすでに入力に含まれています。Prompt Lookupは繰り返す部分から複数のトークンをまとめて提案します。別の下書きモデルをダウンロードせずに試せる点が利点です。
既出トークンの続きを探す
n-gram3は連続するトークンのまとまりです。入力に「契約期間は2027年3月31日まで」とあり、回答でも同じ文章を使うなら、一致する列の後に続くトークンを候補にできます。契約書全体を別途検索するのではなく、モデルに渡された入力と生成履歴を使います。
検索で候補を作り、本モデルが評価します。現在の文脈に合う連続部分を出力し、食い違う箇所から生成を再開します。繰り返しが長い依頼ほど、まとめて使える候補を見つけやすくなります。
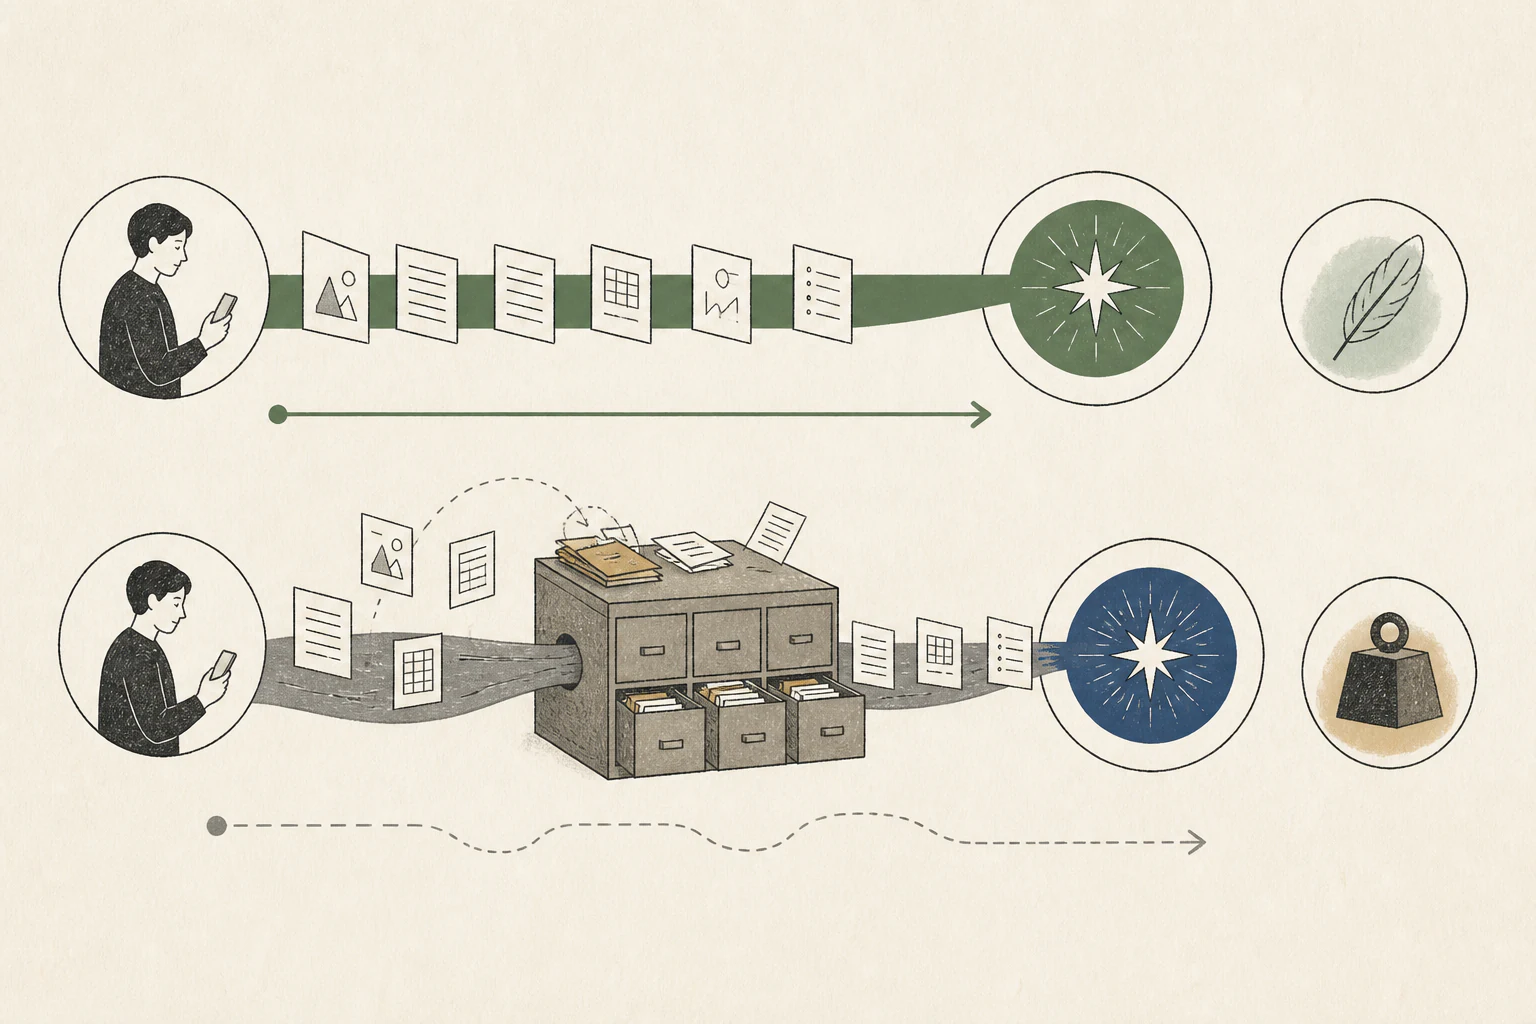
文書アプリが検索した条項だけを渡した場合、候補に使えるのもその範囲です。他のページはアプリの文書検索で取得します。Prompt Lookupは渡された文章を再利用する生成最適化で、検索漏れの対応はアプリ側に残ります。
原文を多く残す作業に向く
関数名を変えて本文を残す、同じ形式で表を書き直す、契約条項を引用する作業から試します。入力と回答の一致が多ければ長い候補が採用される可能性があります。元のコードや必要な条項も入力します。
新しい説明や複数条項の解釈では、新しい文章を作る必要があります。再利用できる候補が少なく、効果が小さい場合があります。書き直しと新しい解釈を分けて比べると、自分の作業に役立つか判断しやすくなります。
変更箇所はコードとテストで確認する
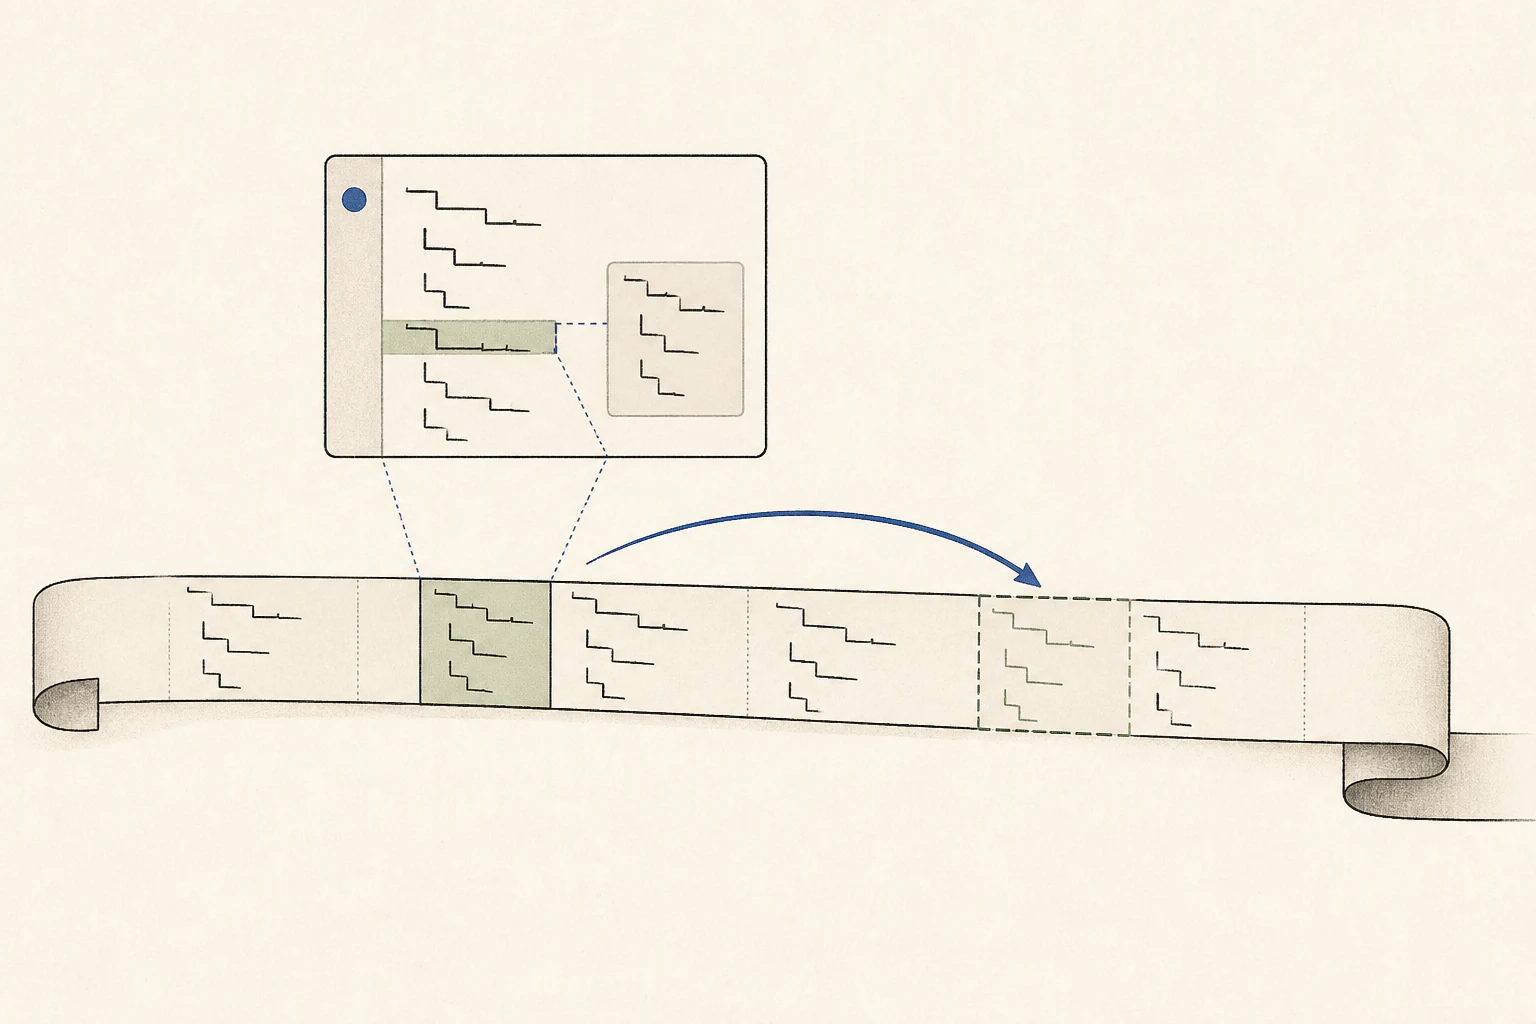
例えばget_renewal_dateをfind_renewal_dateに変更します。古い名前の候補は、新しい名前を選んだ本モデルと一致せず、そこで不採用になる場合があります。その後の入力検査や日付解析が同じなら、再利用できる部分が残ります。
候補の採用ログはトークン生成の経路を示します。依頼どおり動くかは差分とテストで確認します。呼び出し側に旧名が残っていないか、入力検査まで意図せず変わっていないか確認します。
n-gramと候補の長さはまず既定値にします。短い列は一致しやすい一方で異なる文脈も拾い、長い列は具体的ですが表現の差で候補が減ります。基準結果を記録してから一つずつ設定を変えます。
PLEオフロードと役割を分ける
n-gramという言葉はFlash-Nextの大きなPLE4テーブルにも登場します。何を変えるかで整理できます。Prompt Lookupは出力候補を探し、PLEオフロード5はモデルテーブルの保存先を変えます。
| 機能 | 対象 | 主な目的 |
|---|---|---|
| Prompt Lookup | 入力・生成履歴のトークン | 繰り返す出力の生成時間短縮 |
| PLEオフロード | モデルの埋め込みテーブル | RAM・SSDでVRAMへの格納負担を減らす |
同じ作業で有効・無効を比べる
実行ツールの対応機能でPrompt Lookupを確認し、動作するモデルで始めます。関数名変更、条項引用、新しい説明を用意し、同じ入力で有効・無効の結果を記録します。モデル読み込み時間は生成時間と分けます。
ウォームアップ後、同じ条件で複数回実行し中央値を比べます。最初のトークンまでの時間、その後の生成時間、出力トークン数を記録すると、回答が短くなっただけの場合も分けられます。テスト結果と引用漏れも確認します。
正しい結果を維持して繰り返し作業が速くなれば、その用途で使います。読み込み時のメモリ不足は、量子化6や対応するオフロードを先に検討します。モデルが動く容量を確保してから生成最適化を比べます。
用語の注釈
n-gram検索による投機的生成 — プロンプトや生成履歴にある反復トークン列を見つけ、次トークン候補として提案する方式です。文脈検索で候補を作るため、別のドラフトモデルを使わずに利用できます。
本文に戻るトークン — モデルが入力や出力を分けて処理する単位です。
本文に戻るn-gram — 連続するn個のトークンまたは項目からなる列です。文脈検索や投機的生成に使われるほか、一部モデルでは埋め込みテーブルの項目にもなります。
本文に戻るPLE埋め込みテーブル — Per-Layer Embeddingの略で、モデルの特定の層に埋め込み情報を加える構造です。Qwen Flash-Next系はn-gramテーブルを使い、対応する実行環境ではRAMやSSDへオフロードできます。
本文に戻るオフロード — 容量が足りないとき、モデルデータの一部をGPUメモリからシステムRAMやストレージへ移して処理する方法です。データ転送が追加されます。
本文に戻る量子化 — モデルの重みや計算値を少ないビット数で表し、保存容量やメモリ使用量を減らす方法です。表現が粗くなるため、精度にも影響することがあります。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- Prompt Lookupは入力や生成済みの回答から繰り返すトークン列を探し、その続きを出力候補に使います。本モデルが検証し、一致する部分を回答に残します。原文を多く残すコード修正や文書の書き直しで生成時間を短縮できる場合があります。
- 必要なメモリはどのくらいですか?
- 正しい結果を維持して繰り返し作業が速くなれば、その用途で使います。読み込み時のメモリ不足は、量子化や対応するオフロードを先に検討します。モデルが動く容量を確保してから生成最適化を比べます。