
応答速度と加速
最終更新
Qwen3.8-Flash-NextのPLEオフロード:RAM・SSDの条件と実行手順
Flash-NextのPLEデータをSSDやRAMに置くと、高速メモリの負荷を抑えられます
PLE1オフロード2では、Qwen3.8-Flash-Nextの層別埋め込み(per-layer embeddings)をRAM3またはNVMe4 SSD5に置き、必要な値を参照します。oMLXのMLX6経路と、単体DGX SparkのNVFP47・SGLang構成は別々の実行環境です。モデルファイルと空き容量を確認し、ロード・初回リクエスト・反復リクエストの時間とメモリを分けて記録します。
Flash-NextがGPU8メモリに収まらない場合、どの重みを別の場所に置けるか確認します。PLEは対応する経路で別配置できるモデルの構成要素です。読み込みが成功したら、テーブルへのアクセス時間と回答生成速度を確認します。
Flash-NextモデルのPLEテーブルは何をするものですか?
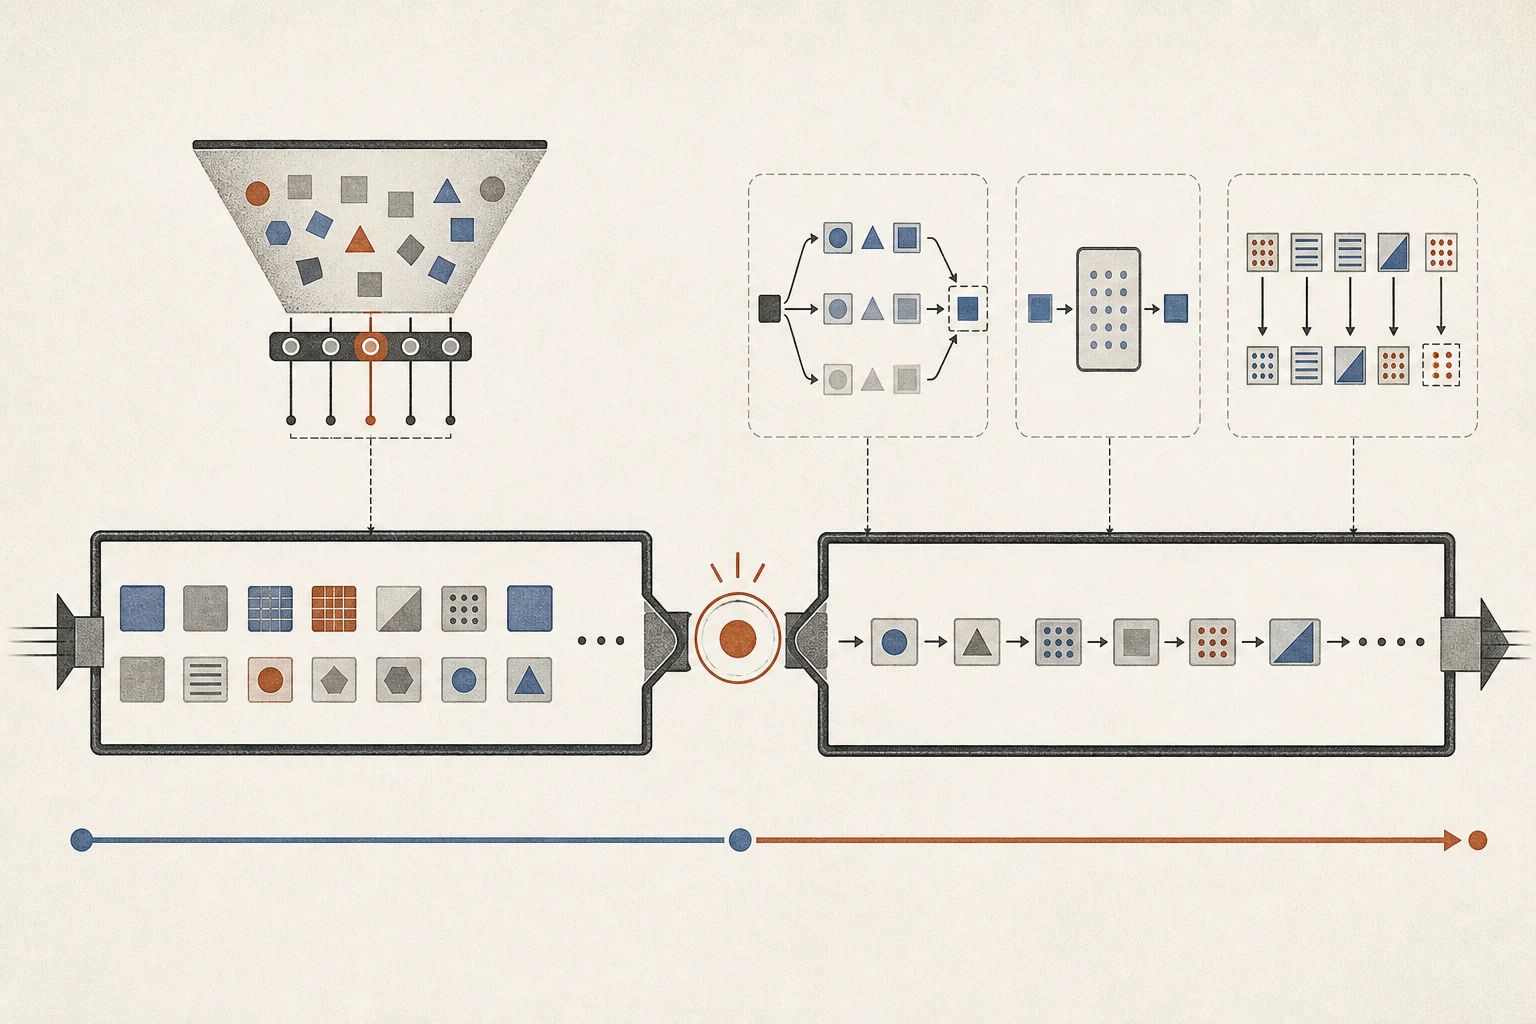
Qwen3.8-Flash-Nextは、質問に答える際にコア言語モデルとPLE(per-layer embeddings、層別埋め込み)を併用します。公開構成は約180Bパラメータで、コアLMが約125B、PLEが約51B、MTP9関連が約4Bです。
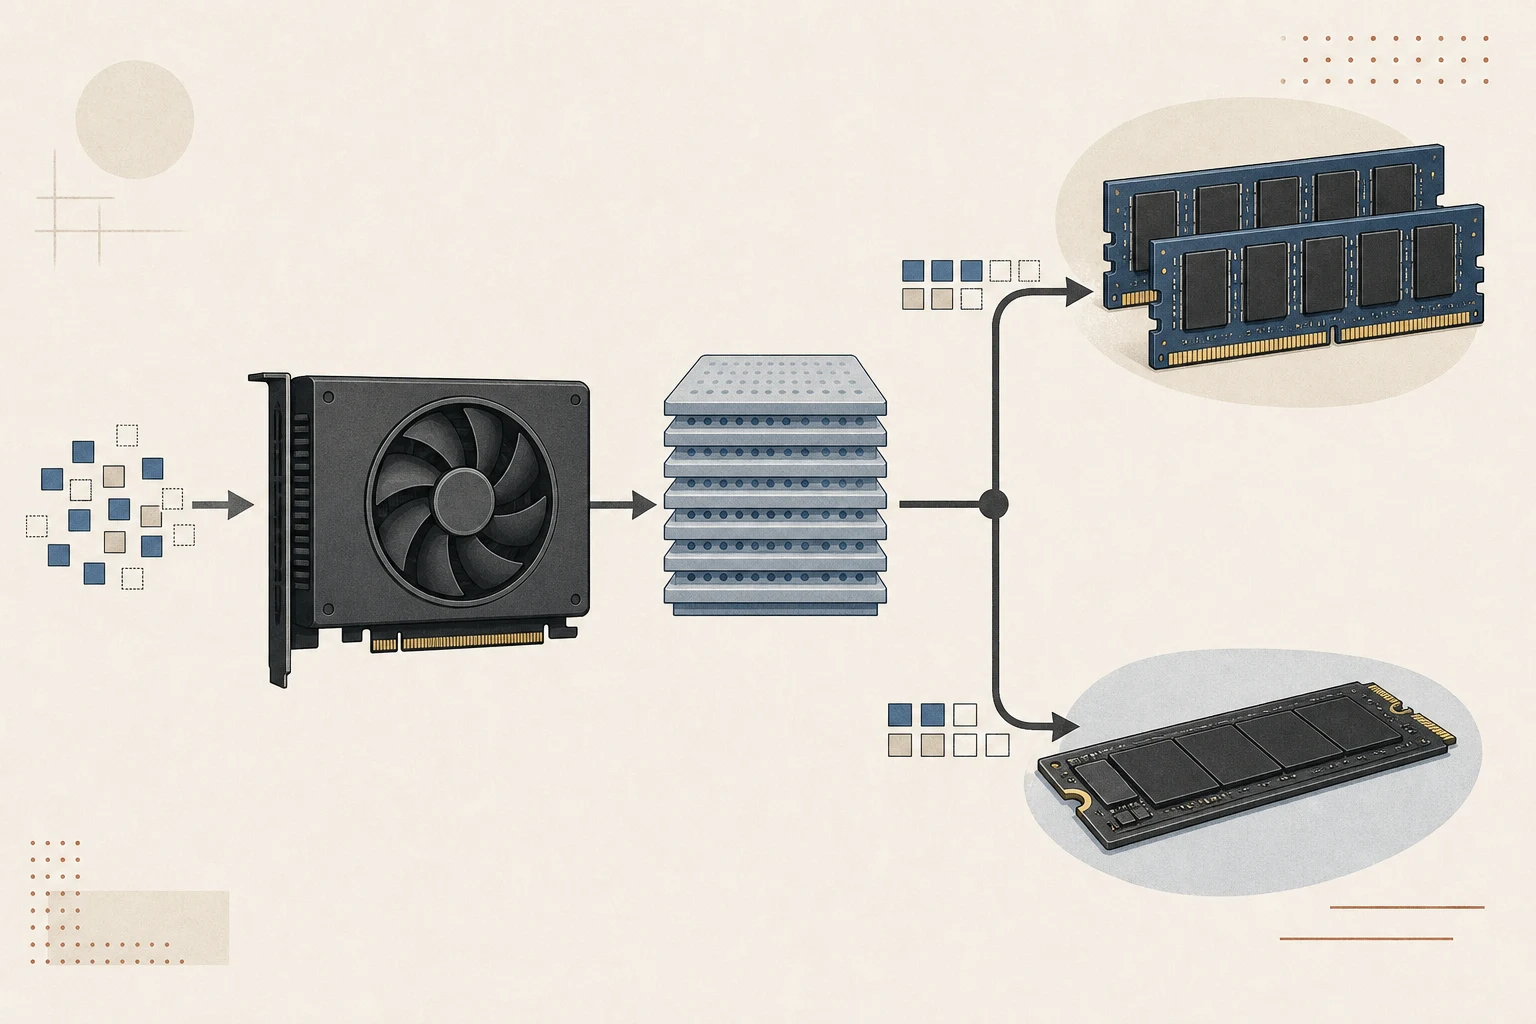
層別埋め込みは、各モデル層がトークン10IDに対応する埋め込み値を参照するテーブルです。オフロード対応ランタイム11では、すべてを高速なGPUメモリに載せず、システムRAMまたはSSDに置いて必要な値を読み込めます。コア重みの量子化12と埋め込みデータの配置は別の設定です。コア重みの配置先と埋め込みファイルの読み込み元を確認してください。
Prompt Lookup13もn-gram14候補検索を使いますが、PLEとは別の機能です。以前の入力や出力にある繰り返しのトークンパターンを探し、次のトークン候補を提案します。Flash-NextのPLEは、実行中にモデル層に対応する埋め込みテーブルを参照します。メモリが限られる環境では、ランタイムが提供するPLEオフロード経路を確認してください。
ハードウェアとランタイムに合わせてオフロード先を選びます
ディスクリートGPU搭載PCでは、対応経路を使ってPLEテーブルをシステムRAMに置き、必要な値をGPUへ渡せます。この場合、VRAM15とシステムRAMは別々に見積もります。Apple siliconではCPU16とGPUがユニファイドメモリ17を共有するため、システム全体のメモリからmacOSとランタイムの使用分を考慮して、モデルに使える余裕を確認してください。
Qwen3.8-Flash-Nextは公開モデル名で、設定ファイルのmodel_type: qwen4_expはoMLXが認識に使う内部タイプです。oMLX 0.7.1.dev1ではJundot/Qwen3.8-Flash-Next-oQ4e-mtpなどの互換MLXチェックポイント18を取得し、モデル設定のqwen4_ple_ssd_offloadを有効にしてPLEをSSD mmapで読み込みます。常駐読み込みがモデルメモリ上限を超え、mmapなら収まる場合は、この経路を自動選択することもあります。
設定後にモデルを再読み込みし、短い初回リクエストを送ります。モデルログでQwen4-ExpとPLEのmmap/SSD経路を示す項目を探し、選択された実行モードを確認してください。その経路がログに見当たらない、またはロードに失敗する場合は、設定の保存、チェックポイントの種類、ログの最初のエラーを確認します。初回読み込みと同じリクエストの反復時の時間も分けて記録してください。
| 環境 | PLEの配置先 | 必要な構成 |
|---|---|---|
| ディスクリートGPU搭載PC | 対応するシステムRAM | PLE RAM対応のランタイムとチェックポイント |
| Apple Silicon Mac | oMLX SSD mmap | Flash-Next MLXローダーと対応配布版 |
| 単体DGX Spark | SGLang file-backed PLE | nvidia/Qwen3.8-Flash-Next-NVFP4とマージ済みパッチ |
SSDの空き容量とページキャッシュを確認します
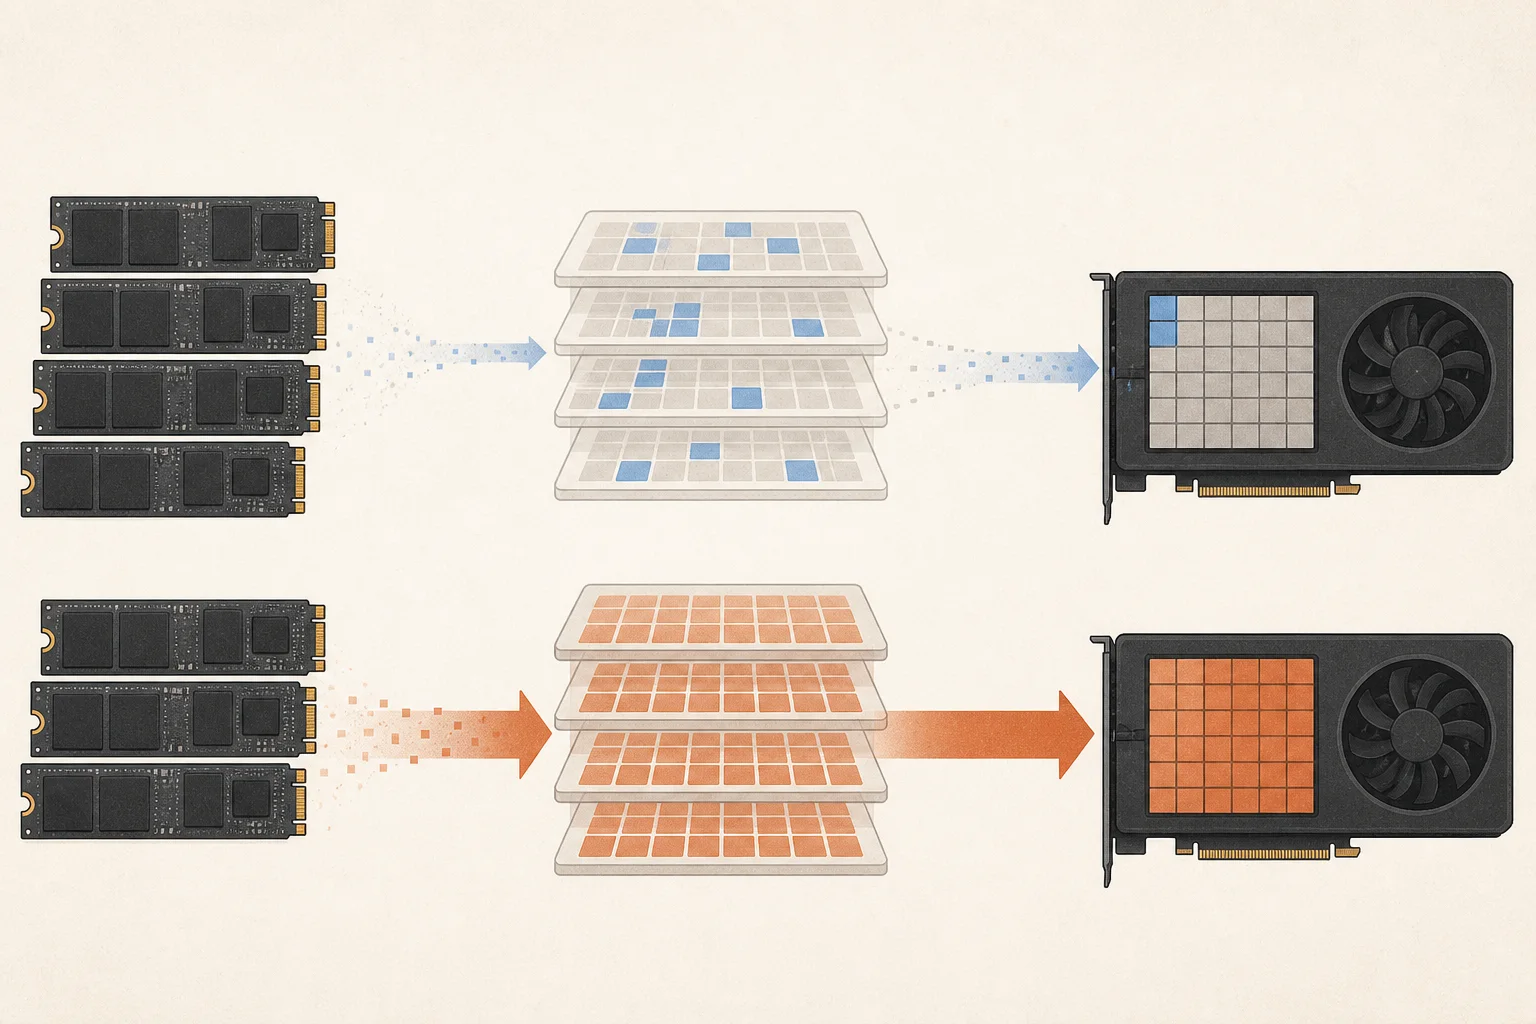
SSD mmapは大きなファイルをプロセスのアドレス空間にマップし、参照されたページを読み込みます。テーブルのページを初めて取得するとSSDの読み込み遅延が発生することがあります。OSがページをRAMのファイルキャッシュに保持すれば次回は速くなる可能性がありますが、ほかのアプリがRAMを使うと追い出され、ストレージから再読み込みになります。
初回実行では、モデルのロード時間、初回リクエストの完了時間、同じリクエストを繰り返したときの時間を分けて記録します。MacではアクティビティモニタのメモリプレッシャーとSSDの動作を、GPU搭載PCではVRAM・RAMの使用量とストレージ読み込みを確認します。初回だけ遅いならファイルキャッシュ、毎回読み込みが起きるならメモリ不足やキャッシュ追い出しの可能性があります。
参考:expert offloadの32K prefill結果
2026年10月9日公開のoMLX 0.7.1.dev1は、Qwen3.8-Flash-Nextの32K prefill19処理量を、M3 Ultraで変更前396、変更後636 tok/sと記録しています。これはexpert重みのオフロード変更を比較した数値であり、PLEテーブルをSSDやRAMに配置した効果を測定したものではありません。
自分の環境で確認するには、同じFlash-Nextチェックポイント、32K入力、エンジン設定、キャッシュ状態を固定します。初回実行とウォーム状態での反復実行を分けて測定してください。prefill処理量、初回トークンまでの時間、生成速度を別々に記録し、SSDキャッシュが温まっていたかも記録します。
oMLXのリリースには、M3 UltraでのFlash-Next group size 32のdecode20比較もあります。MTP offは39→91 tok/s、MTP onは98→134 tok/sです。それぞれの変更前後の条件を分け、該当チェックポイントとMTPの組み合わせを試す際の比較基準として使ってください。
| 処理内容・設定 | 機器 | 変更前 → 変更後 |
|---|---|---|
| 32K prefill · expert offload | M3 Ultra | 396 → 636 tok/s (+61%) |
| group size 32・decode、MTP off | M3 Ultra | 39 → 91 tok/s (+133%) |
| group size 32・decode、MTP on | M3 Ultra | 98 → 134 tok/s (+37%) |
対応している場合はPLEとMTPを順番に試します
oMLXではQwen4-Expチェックポイントにqwen4_ple_ssd_offloadを適用し、モデルログでmmap経路を確認します。DGX Sparkは別の実行経路です。SGLangにマージされたパッチでは、nvidia/Qwen3.8-Flash-Next-NVFP4チェックポイントと--ple-offload-embedding --ple-offload-backend fileを使ってファイルベースのPLEを利用します。NEXTNを追加する場合は、同じパッチの--speculative-algorithm NEXTN設定とチェックポイントに従ってください。oMLXの設定をSparkに流用しないでください。
PLE経路を確認した後、初回と反復のリクエストを記録します。同じチェックポイントがMTPに対応する場合に限り、別途追加します。oMLXではモデル設定のLightning MTPを有効にし、DGX SparkではSGLangパッチのNEXTN構成に従ってください。それぞれの実行でモデルロードと初回・反復リクエストの完了を確認し、初回トークンまでの時間と生成速度を分けて記録します。
モデルがロードされない場合は、SSDの空き容量、チェックポイントのファイル構成、実行ログの最初のエラーを確認します。ロード後の初回アクセスで失敗する場合は、空きメモリ、ファイルパス、読み取り権限を確認してください。反復リクエストが遅くなったら、RAMキャッシュが追い出されていないか、ほかのアプリがどれだけメモリを使うかを調べます。まず入力を短くし、同時リクエスト数を減らして再実行してください。
実際のリクエスト完了時間を基準に拡張を判断します
普段使うモデルで必要な質問に答えられ、ほかのアプリを閉じる必要もないなら、このモデルを実行するためにRAMやSSDを増設する必要はありません。Flash-Nextが必要な具体的な作業を決め、同じチェックポイントで短い質問と長文書のリクエストを試します。最後まで完了するか、初回トークンとその後の生成にどれだけ時間がかかるか確認してください。
ブラウザーやエディターを普段どおり開いた状態で繰り返し実行します。空き容量だけでなく、テーブルのページがRAMに残る場合と追い出される場合を記録すれば、SSDの仕様だけで性能を予測せずに済みます。選んだFlash-Nextチェックポイントとエンジンパッチを継続して管理できる場合に、オフロード構成を維持してください。
用語の注釈
PLE埋め込みテーブル — Per-Layer Embeddingの略で、モデルの特定の層に埋め込み情報を加える構造です。Qwen Flash-Next系はn-gramテーブルを使い、対応する実行環境ではRAMやSSDへオフロードできます。
本文に戻るオフロード — 容量が足りないとき、モデルデータの一部をGPUメモリからシステムRAMやストレージへ移して処理する方法です。データ転送が追加されます。
本文に戻るシステムRAM — プログラムの実行中にデータを一時保存するシステムメモリです。
本文に戻るNVMe — SSDがPCI Express経由で通信する際に使うストレージ用プロトコルです。
本文に戻るSSD — フラッシュメモリを使うデータ保存装置です。電源を切ってもデータが保持されます。
本文に戻るMLX — Appleが開発する機械学習フレームワークで、Apple SiliconのCPUとGPUが共有するメモリを使ってモデルを実行します。
本文に戻るNVFP4 — NVIDIAが定義した4ビット浮動小数点データ形式です。対応状況はGPU世代、モデル、ソフトウェア実装によって異なります。
本文に戻るGPU — 多くの計算を並列に処理するプロセッサーです。AIモデルの実行ではモデル計算を担います。
本文に戻るMTP — 複数の将来トークンを一度に予測する学習目標、またはそれを行うモデル構成です。投機的デコーディングでは、その予測を候補トークンとして提案できます。
本文に戻るトークン — モデルが入力や出力を分けて処理する単位です。
本文に戻るランタイム — プログラムの実行時に必要な機能を提供するソフトウェア環境です。ローカルAIではモデル実行エンジンを指すこともあります。
本文に戻る量子化 — モデルの重みや計算値を少ないビット数で表し、保存容量やメモリ使用量を減らす方法です。表現が粗くなるため、精度にも影響することがあります。
本文に戻るn-gram検索による投機的生成 — プロンプトや生成履歴にある反復トークン列を見つけ、次トークン候補として提案する方式です。文脈検索で候補を作るため、別のドラフトモデルを使わずに利用できます。
本文に戻るn-gram — 連続するn個のトークンまたは項目からなる列です。文脈検索や投機的生成に使われるほか、一部モデルでは埋め込みテーブルの項目にもなります。
本文に戻るVRAM — グラフィックカードのGPUが使うメモリです。モデルの重みや計算途中の値を保存します。
本文に戻るCPU — OSや一般的なプログラム命令を実行する中央処理装置です。AIでは前処理やデータ転送などの汎用処理も担います。
本文に戻るユニファイドメモリ — CPUとGPUが同じ物理メモリ領域を共有する構造です。
本文に戻るチェックポイント — 学習済みモデルの重みなどを保存したファイルです。同じモデル系列でも、版や用途によって異なるチェックポイントを使うことがあります。
本文に戻るプリフィル — LLMが入力プロンプトを読み、各トークンの内部表現を計算する段階です。プロンプトが長いほど処理するトークンが増えます。
本文に戻るトークンのデコード — 入力とそれまでの回答をもとに、次の出力トークンを順に生成する段階です。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- PLEオフロードでは、Qwen3.8-Flash-Nextの層別埋め込み(per-layer embeddings)をRAMまたはNVMe SSDに置き、必要な値を参照します。oMLXのMLX経路と、単体DGX SparkのNVFP4・SGLang構成は別々の実行環境です。モデルファイルと空き容量を確認し、ロード・初回リクエスト・反復リクエストの時間とメモリを分けて記録します。
- 必要なメモリはどのくらいですか?
- 層別埋め込みは、各モデル層がトークンIDに対応する埋め込み値を参照するテーブルです。オフロード対応ランタイムでは、すべてを高速なGPUメモリに載せず、システムRAMまたはSSDに置いて必要な値を読み込めます。コア重みの量子化と埋め込みデータの配置は別の設定です。コア重みの配置先と埋め込みファイルの読み込み元を確認してください。