
メモリとモデル
最終更新
ローカルLLMに必要なVRAM・ユニファイドメモリ容量
VRAMと共有メモリからローカルLLMの余裕を見積もります
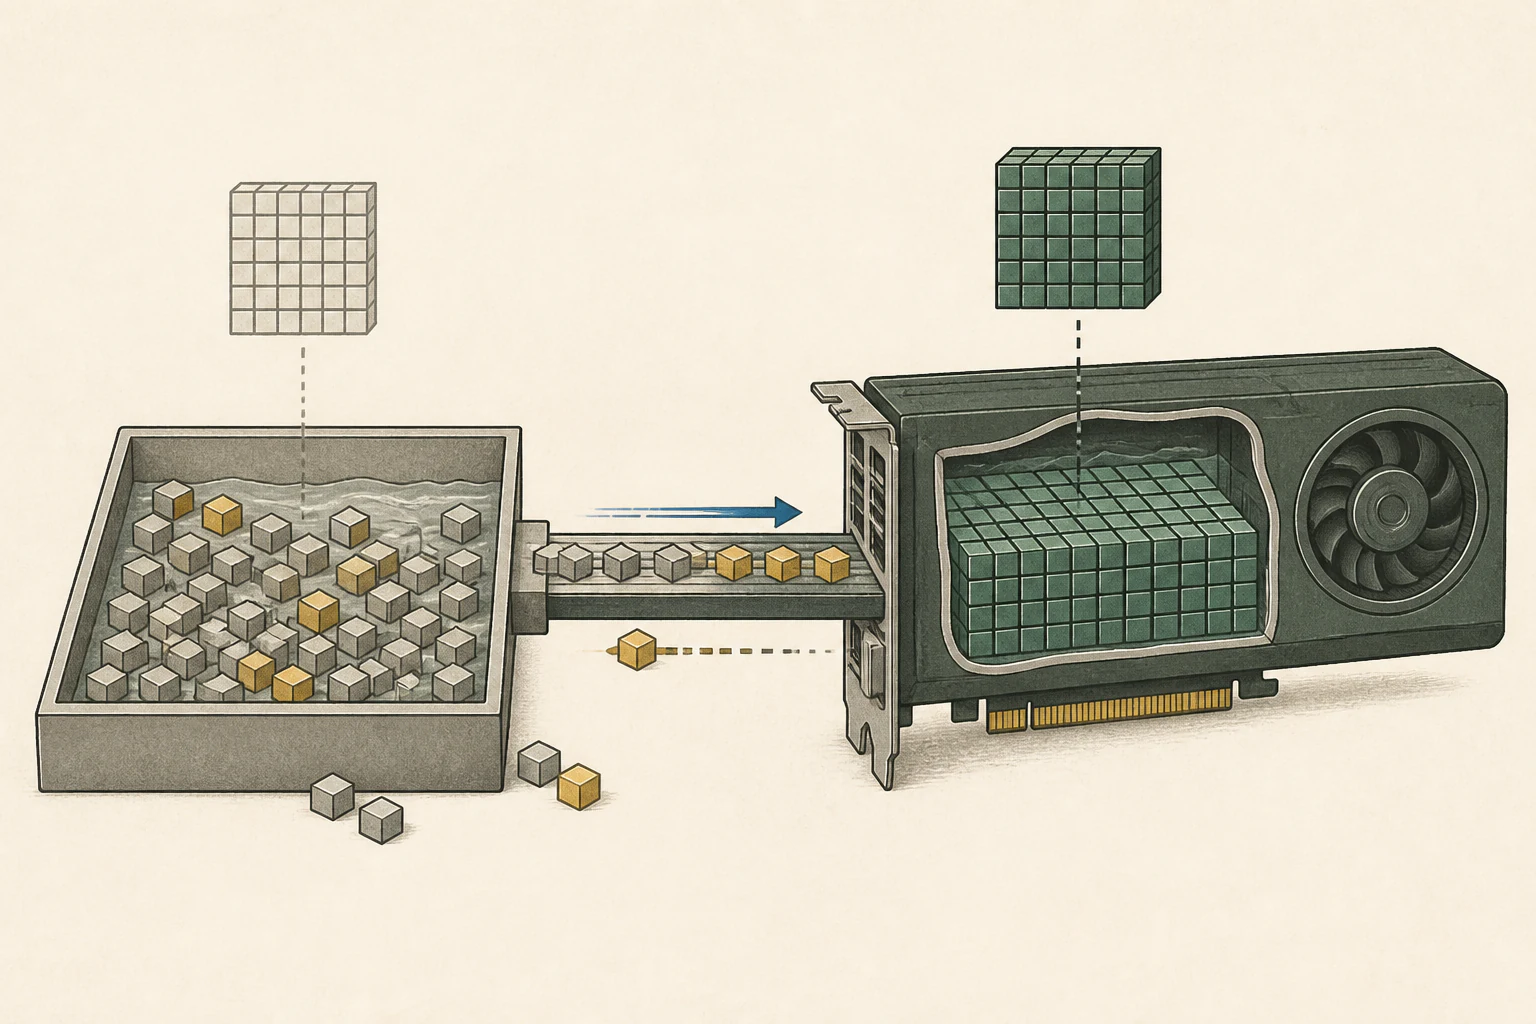
ローカルLLM1を実行すると、プログラムがモデルをコンピューターのメモリに読み込んで回答を計算します。専用グラフィックカード搭載PCではGPU2のVRAM3がモデル計算に使われ、Apple Silicon MacではCPU4とGPUが共有メモリを使います。モデルを読み込んだ後、普段の入力で会話を続けられる余裕があるか確認する方法を説明します。
モデルファイル以外にも、実行プログラムは計算用の領域を使い、長い入力や後続質問を処理すると会話状態を保存するKV cache5も増えます。PCとMacのメモリ構造を見た後、長文要約を例に容量と速度を考えます。
同じモデルで文書を要約して追加質問を送り、メモリ不足になる段階と回答速度の両方を確認します。
PCではVRAMとシステムRAMが分かれています
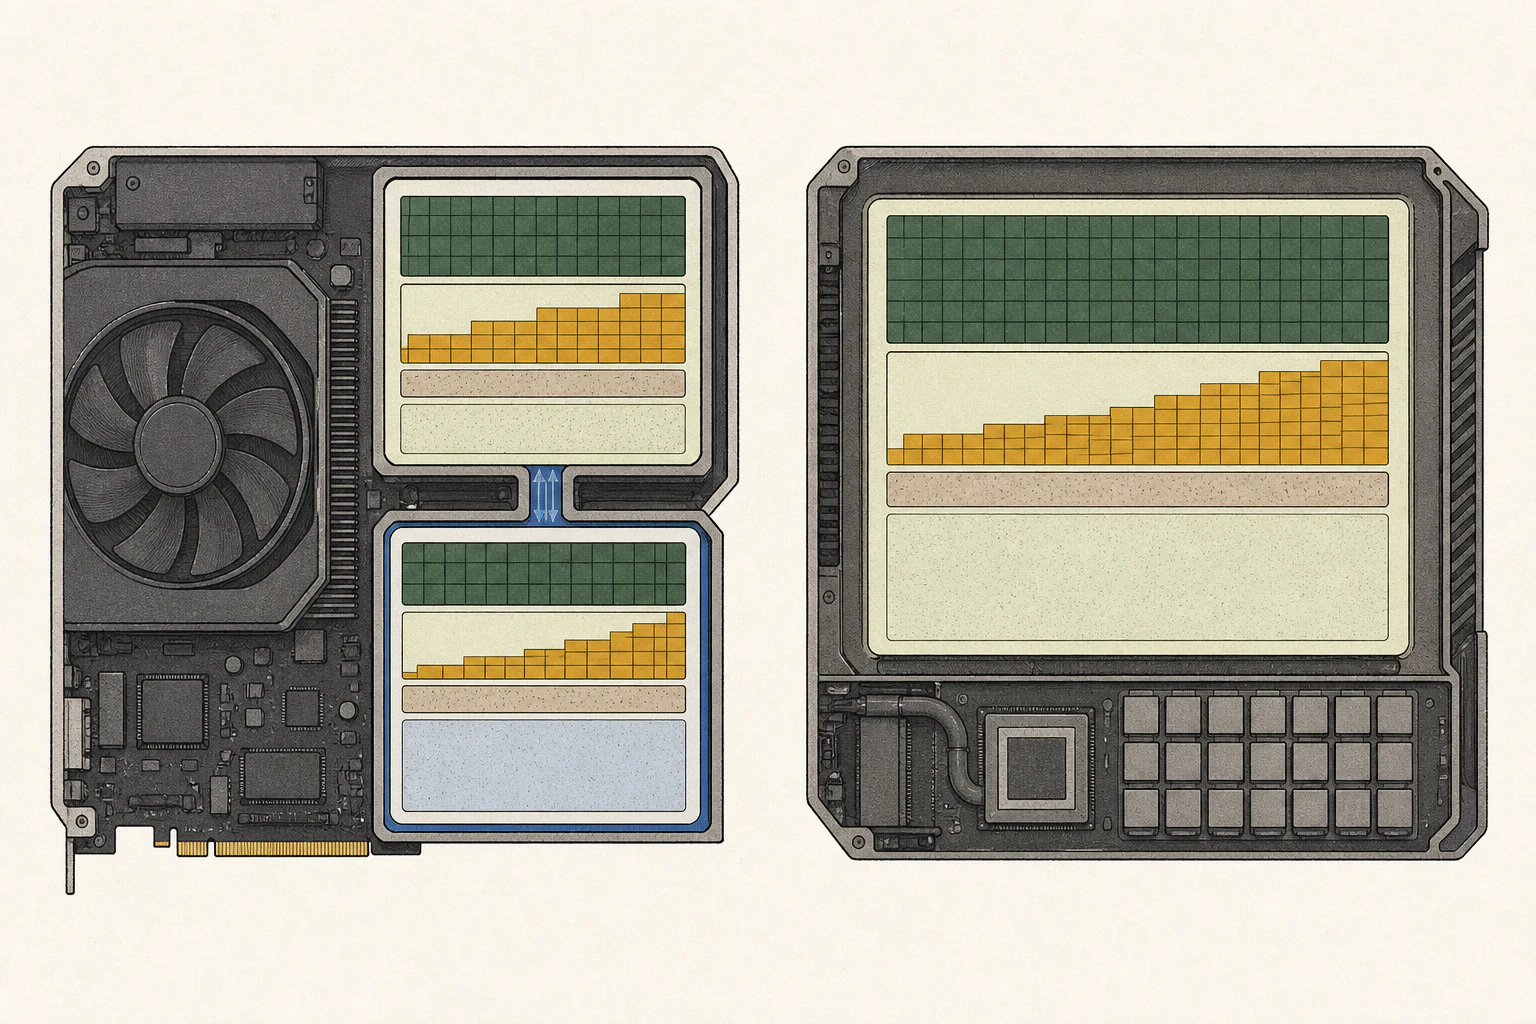
MacではCPUとGPUが同じメモリを使います
Apple Silicon MacのCPUとGPUは同じ物理メモリを共有します。この構造を共有メモリと呼びます。PCのようにVRAMとシステムRAMを足すのではなく、Macに表示された共有メモリを1つの領域として考えます。Apple Metal8文書はCPUとGPUがシステムメモリを共有する構造を説明しています。
32GB MacではmacOS・ブラウザ・文書アプリが使った残りを、モデルと計算が分けて使います。普段のアプリを開いてモデルを読み、追加質問まで試してください。プレッシャーとアプリの反応で日常の余裕が分かります。
左右にスクロールして各項目を比較できます。
| 構成 | GPUが使うメモリ | CPUとアプリが主に使うメモリ | 容量を見るとき |
|---|---|---|---|
| ディスクリートGPU搭載PC | グラフィックカードのVRAM | システムRAM | VRAMとRAMを別々に確認します。 |
| Apple Silicon Mac | CPU・GPUが共有するメモリ | 同じ共有メモリ | OSとアプリの使用分を残します。 |
モデルファイル以外の作業領域も見積もります
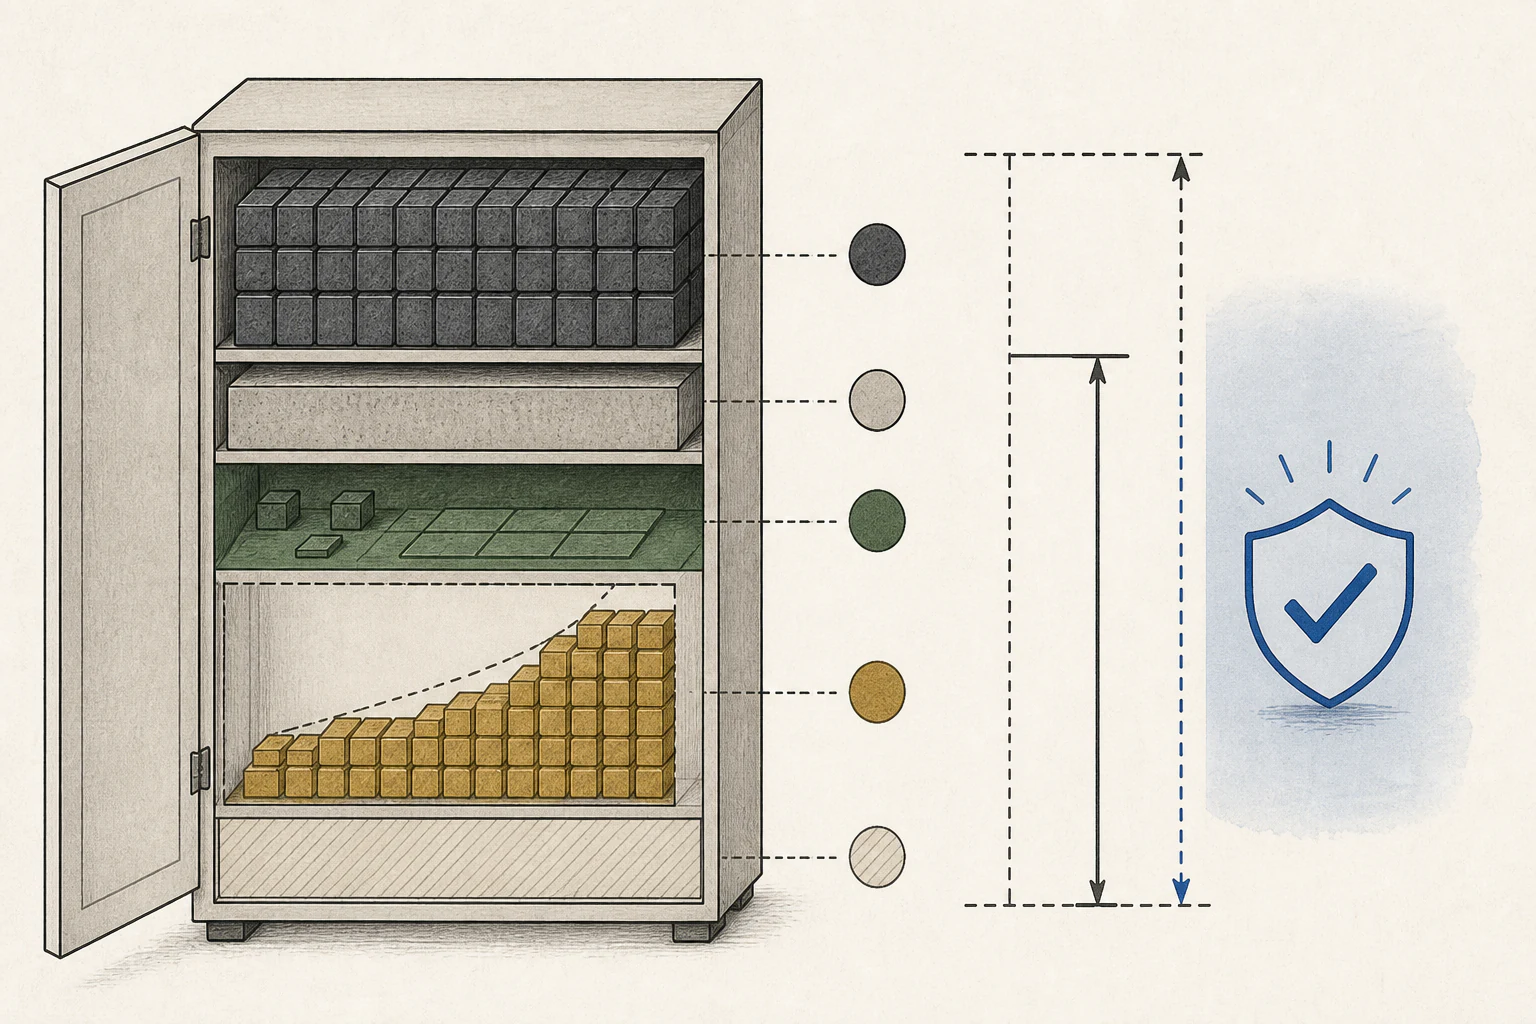
モデルファイルには回答を作る重みが保存されています。実行プログラムは重みを読み込み、入力を読んだり回答を生成したりする一時作業領域も使います。長文への後続質問には会話状態を保持するKV cacheも必要です。そのため、重みに加えて実行領域と会話状態の容量も見込みます。
説明用に20GBのモデルファイルを24GBのVRAMで実行すると仮定すると、計算上は4GBが残ります。この領域を実行プログラムの作業領域とKV cacheで分け合います。実際のメモリ使用量はファイル形式と実行方法で変わるため、この計算は概算として扱い、アプリで読み込み後の使用量を確認してください。
| 項目 | 計算 | 次の確認 |
|---|---|---|
| GPU VRAM | 24GB | 専用メモリの総量 |
| モデルファイル | −20GB | 重みの容量の目安 |
| 計算上の残り | =4GB | 実行領域とKV cacheで共用します。 |
| 実際の実行 | 実際の条件で確認 | 長い入力と後続質問まで試します。 |
メモリ容量と帯域幅は別の問いに答えます
容量はモデルと計算状態を置く場所が足りるかを示します。帯域幅はGPUとメモリの間でデータをどれだけ速く送受信できるかを表します。容量が十分でもデータ供給が遅ければ計算が待つことがあり、帯域幅が高くてもモデルを置く場所がなければ実行できません。まず作業に足りる容量を選び、その範囲で帯域幅と演算性能を比べます。
モデルが長い入力や後続質問を問題なく処理できるのに応答が遅い場合は、メモリを増やすより速度指標を比較します。入力中にメモリが不足する、または他のアプリを閉じる必要がある場合は、まず容量の余裕を検討してください。
VRAMが足りない場合はRAMへのoffloadを試します
一部の実行プログラムでは、モデルの一部のlayerをGPUのVRAMに置き、残りをシステムRAMから計算できます。VRAMに収まらないモデルを実行するoffload9方式です。一方でCPU計算とメモリ間のデータ転送が増えて回答が遅くなることがあるため、読み込み可否と要約完了時間の両方を確認します。
実行アプリの設定でGPUに載せるlayer数やメモリ割り当てを探します。設定を1つずつ変更し、同じモデルと長文で要約と後続質問を完了させて時間を比較してください。GPUに載せる量を増やすとRAMで計算する部分を減らせますが、VRAMが不足すると読み込みに失敗することがあります。設定名と対応範囲はアプリによって異なるため、ヘルプを確認してください。
2枚のGPUにモデルを分割して実行します
24GBカード2枚の合計は48GBです。モデル分割を有効にすると、実行ソフトが重みと作業領域を各カードへ配置します。カード間の転送にも時間がかかるため、読込後に同じ質問の初回応答と完了時間を1枚構成と比べます。
llama.cppサーバー文書にはGPUに載せるモデルlayer数と複数GPUの分割モードが記載されています。1つのモデルを分割する方式と、GPUごとに別々のリクエストを処理する方式は異なります。使うアプリがそのruntime10と分割オプションに対応するか先に確認してください。
購入前に普段の作業でメモリを試します
モデル一覧でモデルと量子化11ファイルのサイズを確認し、実行アプリがそのファイルに対応するか確かめます。PCではVRAMとシステムRAMを別々に、Macでは共有メモリを確認してください。OSと普段開いているアプリの使用分も残します。量子化は重みを少ないbit数で保存し、ファイルと実行時メモリを減らす方法です。
普段扱う文書を入力して要約し、続けて質問します。WindowsではタスクマネージャーのGPU欄で専用メモリを、Macではアクティビティモニタのメモリタブでメモリプレッシャーとアプリ使用量を確認します。Appleの案内によると、メモリプレッシャーは空きメモリやswapなどを反映します。どの段階で不足するか、アプリが遅くなるか記録すると、現在の構成が十分か分かります。
普段の入力を最後まで処理でき、速度も問題なければ現在の容量で始めます。長い入力で不足する場合は量子化や対応するoffloadを試し、それでも頻繁に止まるなら大容量の構成を比較してください。処理は完了するのに回答が遅い場合は帯域幅や演算性能を調べます。速度計算ツールで見積もりを比べ、購入前に使うアプリと入力でもう一度確認してください。
用語の注釈
大規模言語モデル — 大量のテキストデータから言語パターンを学び、文脈に沿ったテキストを処理・生成するモデルです。
本文に戻るGPU — 多くの計算を並列に処理するプロセッサーです。AIモデルの実行ではモデル計算を担います。
本文に戻るVRAM — グラフィックカードのGPUが使うメモリです。モデルの重みや計算途中の値を保存します。
本文に戻るCPU — OSや一般的なプログラム命令を実行する中央処理装置です。AIでは前処理やデータ転送などの汎用処理も担います。
本文に戻るKVキャッシュ — 過去トークンのAttention用キー・バリューを保存し、後続トークン生成で再利用するメモリです。容量はコンテキスト長やバッチサイズで変わります。
本文に戻るシステムRAM — プログラムの実行中にデータを一時保存するシステムメモリです。
本文に戻るCUDA — NVIDIA GPUで汎用計算を行うソフトウェア基盤です。
本文に戻るMetal — Apple機器でグラフィックスやGPUの並列計算を実行する低水準の技術です。
本文に戻るオフロード — 容量が足りないとき、モデルデータの一部をGPUメモリからシステムRAMやストレージへ移して処理する方法です。データ転送が追加されます。
本文に戻るランタイム — プログラムの実行時に必要な機能を提供するソフトウェア環境です。ローカルAIではモデル実行エンジンを指すこともあります。
本文に戻る量子化 — モデルの重みや計算値を少ないビット数で表し、保存容量やメモリ使用量を減らす方法です。表現が粗くなるため、精度にも影響することがあります。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- ローカルLLMを実行すると、プログラムがモデルをコンピューターのメモリに読み込んで回答を計算します。専用グラフィックカード搭載PCではGPUのVRAMがモデル計算に使われ、Apple Silicon MacではCPUとGPUが共有メモリを使います。モデルを読み込んだ後、普段の入力で会話を続けられる余裕があるか確認する方法を説明します。
- 必要なメモリはどのくらいですか?
- 32GB MacではmacOS・ブラウザ・文書アプリが使った残りを、モデルと計算が分けて使います。普段のアプリを開いてモデルを読み、追加質問まで試してください。プレッシャーとアプリの反応で日常の余裕が分かります。