
メモリとモデル
最終更新
KVキャッシュのメモリを削減:vLLM FP8設定と回答確認
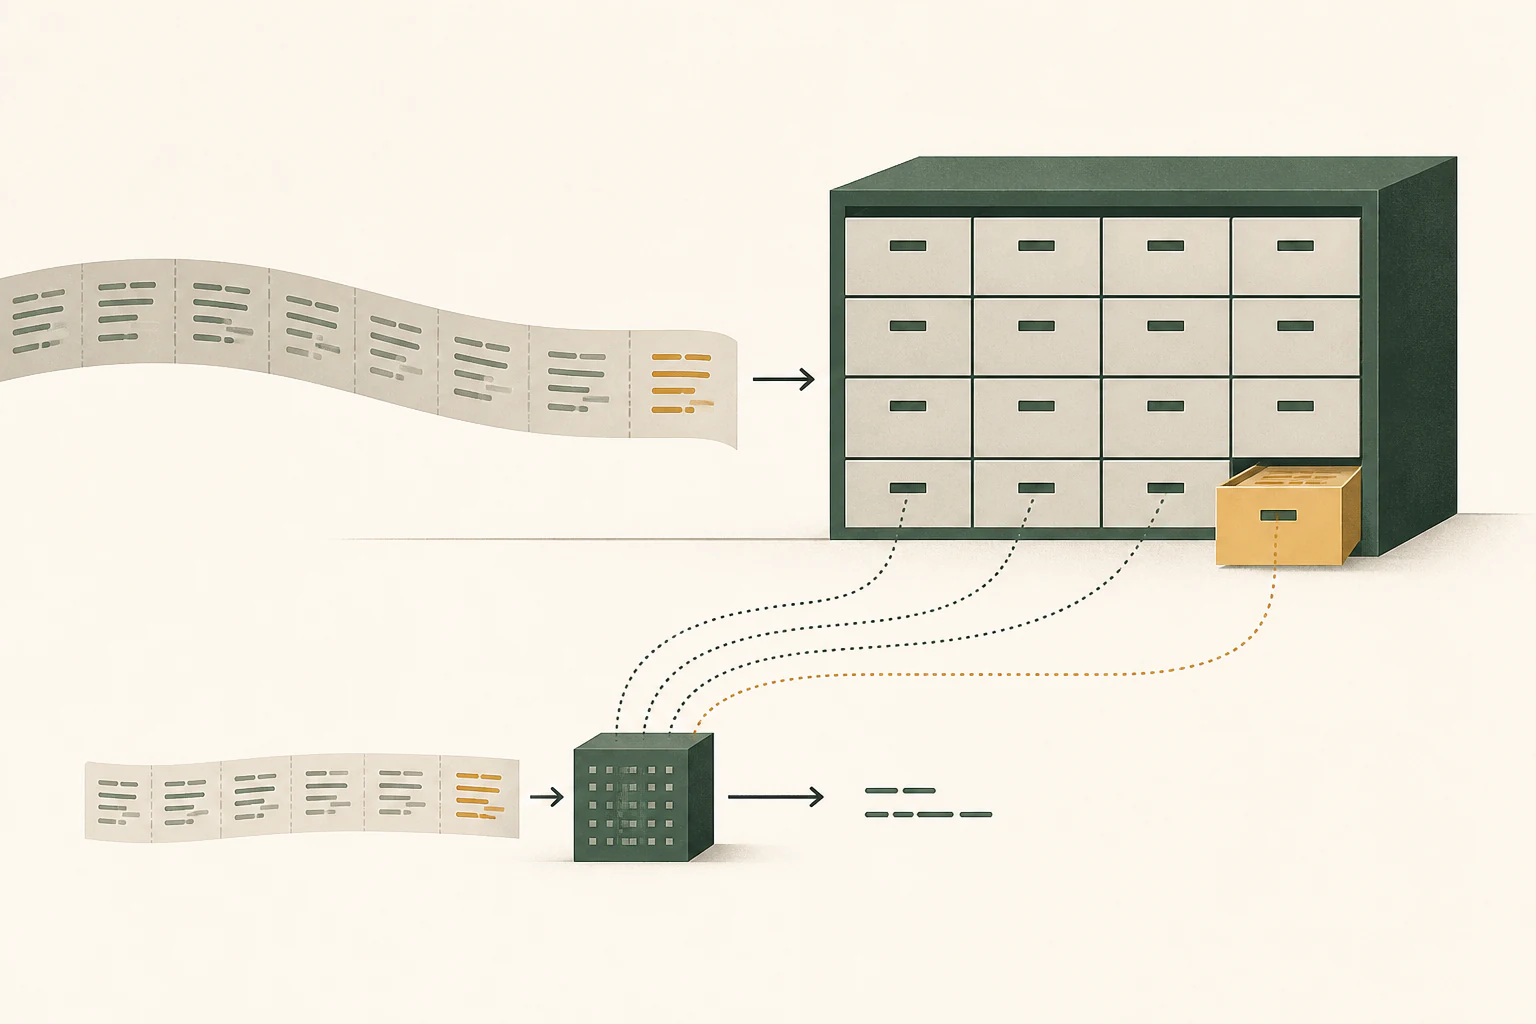
KVキャッシュは前の文脈の計算状態を保存します。
KVキャッシュ1は、言語モデルが処理したトークン2のkeyとvalueを保存する領域です。回答を続ける際にこの状態を再利用し、前の文脈の計算を繰り返す手間を減らします。長い文脈や同時リクエストではキャッシュのメモリ使用量も増えるため、vLLMのFP83設定で容量を減らす方法を紹介します。
ここでは関数に空リストを渡したときのエラーを尋ね、テストコードを提案してもらう作業で比較します。標準キャッシュとFP8キャッシュで同じコードを送り、回答、メモリ使用量、完了時間を記録して設定変更の効果を確かめます。
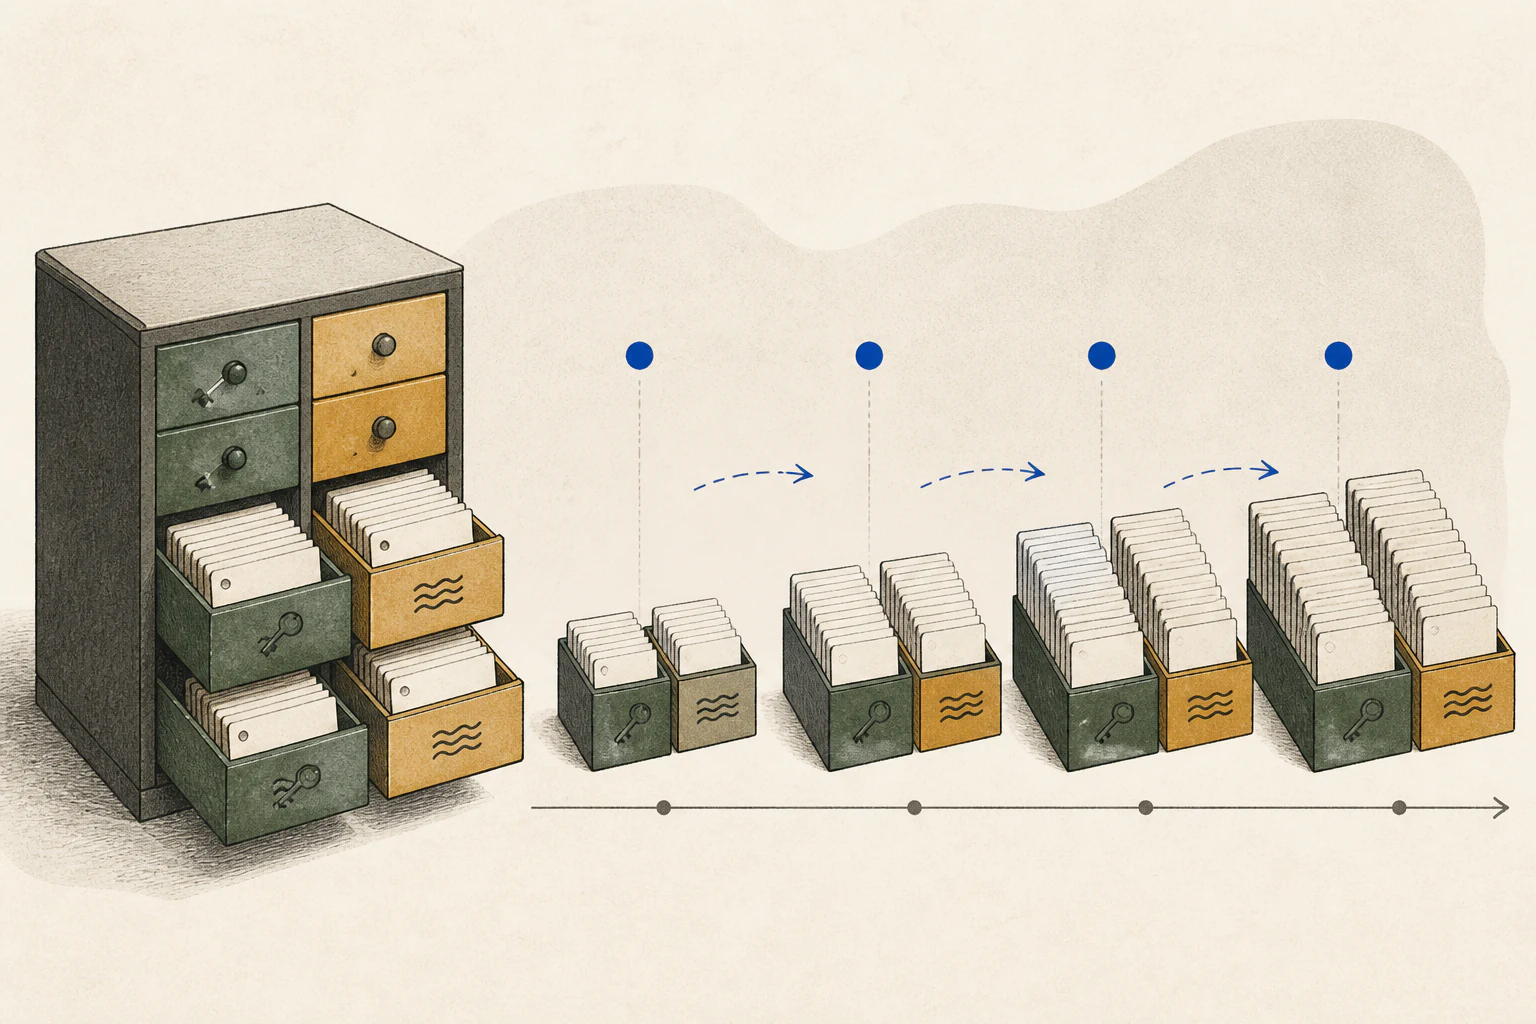
会話を続けると保持する状態が増えます
モデルはプリフィル4段階で入力トークン間の関係を計算します。回答を1トークンずつ生成する際には前のトークンを再び参照します。KVキャッシュのkeyとvalueを使えば、前の文脈の状態を最初から作り直さずに計算を続けられます。
関数の説明を受けた後にテストを依頼すると、次のリクエストに元のコードと前の回答が含まれることがあります。新しい質問と出力が文脈に加わるため、モデルファイルが同じでもキャッシュ使用量は変わります。アプリによる古いメッセージの除外や文脈の再構成も影響します。
質問が1行でも、アプリがコードファイル全体や長いPDFを添付すれば入力トークンは増えます。アプリのトークン表示やサーバーログで実際の入力長を確認してください。同時リクエストには個別の状態も必要なので、1人の会話と複数作業の重複を分けて試します。
重みとキャッシュの精度を別々に選ぶ理由
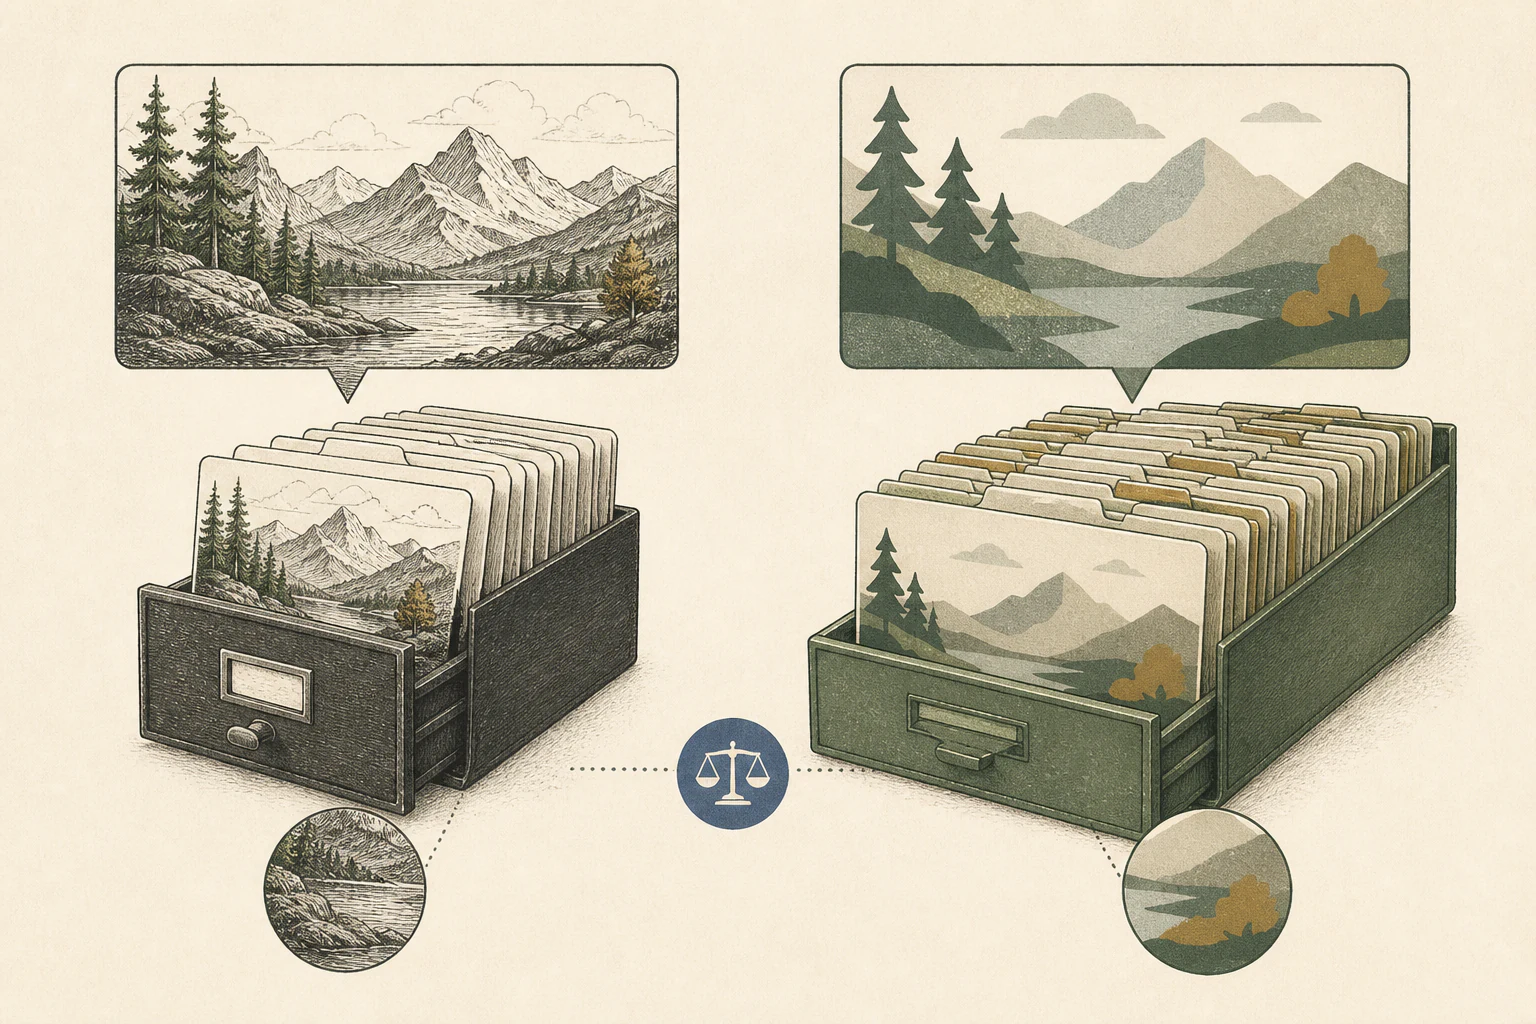
Q4やNVFP45はモデルの重みの保存形式です。KVキャッシュは実行中に作られる状態で、独自の精度を使います。対応する実行環境では8ビットや4ビットで保存し、長い文脈に必要な容量を減らせます。
キャッシュの変換には計算が加わり、値の精度も変わります。そのためメモリ節約、生成速度、回答の正確さを個別に比較します。短い文脈では変換コストが効果を相殺する場合があり、プリフィル性能もhead dimensionとbackendに左右されます。
| 領域 | 内容 | 影響する条件 |
|---|---|---|
| モデルの重み | 学習済みモデルデータ | モデルサイズ、量子化、配置先 |
| KVキャッシュ | 前のトークンの計算状態 | 文脈長、層構造、精度、同時リクエスト |
| 実行バッファー | 現在の演算の一時データ | backend、バッチ、実行設定 |
まず標準サーバーで回答を受け取ります
以下の例はgpt-oss-20bに対応するvLLM環境で実行します。モデル配置とキャッシュ作成のためのメモリ余裕が必要です。GPU6数やメモリ利用率を任意に固定せず、導入したbackendのモデル対応と読み込みログを確認します。
最初のコマンドを実行し、サーバーの準備ができたら別のターミナルでcurlコマンドを送ります。first_item関数はリストの最初の要素を読むため、空リストではインデックスエラーが発生します。回答が原因を説明し、空リストのテストを提案しているか確認して基準結果を保存します。
vllm serve openai/gpt-oss-20b --host 127.0.0.1 --port 8000 --max-model-len 8192curl --fail-with-body http://127.0.0.1:8000/v1/chat/completions -H 'Content-Type: application/json' -d '{"model":"openai/gpt-oss-20b","messages":[{"role":"user","content":"Review this function for empty-list input and suggest one test: def first_item(items): return items[0]"}],"temperature":0,"max_tokens":128}'キャッシュだけをFP8に変えて同じ依頼を送ります
基準の依頼が成功したらサーバーを停止し、--kv-cache-dtype fp8を加えて再起動します。モデル、文脈、重み形式、同時リクエスト数は維持します。ログでFP8 KVと実際のattention7 backendを確認してから、同じcurlリクエストを送ります。
FP8 KVにはGPU、attention backend、モデル構造の対応が必要です。公式のHopper・Blackwell評価はその経路の資料として読み、ほかのGPUでは導入版の対応表を確認します。GPT-OSSのようにglobal attentionとsliding-window層が混在するモデルでは、短い窓の層を標準精度のままにする設定も比較できます。
2つ目のコマンドの--kv-cache-dtype-skip-layers sliding_windowがその選択肢です。対応するビルドで全層FP8とskip-layer設定を個別に実行し、同じ関数の質問を送ります。
vllm serve openai/gpt-oss-20b --host 127.0.0.1 --port 8000 --max-model-len 8192 --kv-cache-dtype fp8vllm serve openai/gpt-oss-20b --host 127.0.0.1 --port 8000 --max-model-len 8192 --kv-cache-dtype fp8 --kv-cache-dtype-skip-layers sliding_windowメモリ節約と回答結果を合わせて記録します
モデル読み込み後、準備用リクエストを除いて繰り返し測定します。TTFT8、トークン間遅延、完了時間、peak GPU memoryを記録し、まず1リクエストずつ比較します。長い文脈や同時利用が目的なら、その後に入力長かリクエスト数を1つずつ増やします。新しい入力とprefix再利用の入力も分けて記録します。
空リストのエラー説明と提案されたテストを実際のコードと照合します。複数の関数質問をあらかじめ用意して同じ方法で比較すれば、1つの質問の偶然に頼らずに済みます。速度差が小さくても、長い入力をメモリに収めたり多くの依頼を安定して終えたりできれば目的に合った改善です。
キャッシュ上限や古い状態の削除を使う場合は、会話の最初に渡した情報を後でも回答できるか確認します。 新しい会話では正しく、続いた会話だけで失敗する場合は、実際に送信したメッセージと状態保持設定を照合してください。アプリ全体のメモリグラフは不足の時点を探すために使い、KVキャッシュ自体はサーバーの指標で確認します。
起動エラーとメモリ不足では戻す設定が異なります
dtypeやbackendエラーで起動できなければ、FP8オプションを外して基準コマンドを再実行します。FP8だけが失敗するならキャッシュ対応を確認してください。標準設定も失敗する場合はモデル対応、ドライバー、導入版を先に調べます。
長い依頼でメモリが不足したら、文脈か同時リクエスト数を1つずつ減らします。回答がコードの条件を繰り返し見落とすなら標準精度に戻して同じ質問を比較します。必要な文脈と同時数で正確さと安定性を保てる設定を残してください。
用語の注釈
KVキャッシュ — 過去トークンのAttention用キー・バリューを保存し、後続トークン生成で再利用するメモリです。容量はコンテキスト長やバッチサイズで変わります。
本文に戻るトークン — モデルが入力や出力を分けて処理する単位です。
本文に戻るFP8 — 一つの値を8ビットで表す浮動小数点形式です。
本文に戻るプリフィル — LLMが入力プロンプトを読み、各トークンの内部表現を計算する段階です。プロンプトが長いほど処理するトークンが増えます。
本文に戻るNVFP4 — NVIDIAが定義した4ビット浮動小数点データ形式です。対応状況はGPU世代、モデル、ソフトウェア実装によって異なります。
本文に戻るGPU — 多くの計算を並列に処理するプロセッサーです。AIモデルの実行ではモデル計算を担います。
本文に戻るAttention — 入力トークン間の関連度を計算し、各位置の情報を現在の表現に反映するニューラルネットワーク演算です。
本文に戻る最初のトークンまでの時間 — リクエスト送信から最初の出力トークンが届くまでの時間です。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- KVキャッシュは、言語モデルが処理したトークンのkeyとvalueを保存する領域です。回答を続ける際にこの状態を再利用し、前の文脈の計算を繰り返す手間を減らします。長い文脈や同時リクエストではキャッシュのメモリ使用量も増えるため、vLLMのFP8設定で容量を減らす方法を紹介します。
- 必要なメモリはどのくらいですか?
- キャッシュ上限や古い状態の削除を使う場合は、会話の最初に渡した情報を後でも回答できるか確認します。 新しい会話では正しく、続いた会話だけで失敗する場合は、実際に送信したメッセージと状態保持設定を照合してください。アプリ全体のメモリグラフは不足の時点を探すために使い、KVキャッシュ自体はサーバーの指標で確認します。