
応答速度と加速
最終更新
Lightning MTPとは?oMLX 0.7.1rc1で回答生成を速くする
Lightning MTPは候補をまとめて検証し、回答生成の逐次計算を減らします。
Lightning MTP1はApple Silicon向けoMLXの生成経路で、対応モデルのMTP headを使って次トークン2候補を先に用意し、メインモデルが正しいと確認した連続候補を回答に反映します。チェックポイント3にMTP weightが残っていることを確認し、通常生成と同じ入力で最初のトークンまでの時間、生成時間、完了時間、回答品質を比較します。
PDFへの質問では最初の文字が出る前の待ちが長いのか、回答開始後の生成が遅いのかを分けます。Lightning MTPが主に変えるのは後者です。文書入力処理や初回のモデル読み込みは別に確認します。
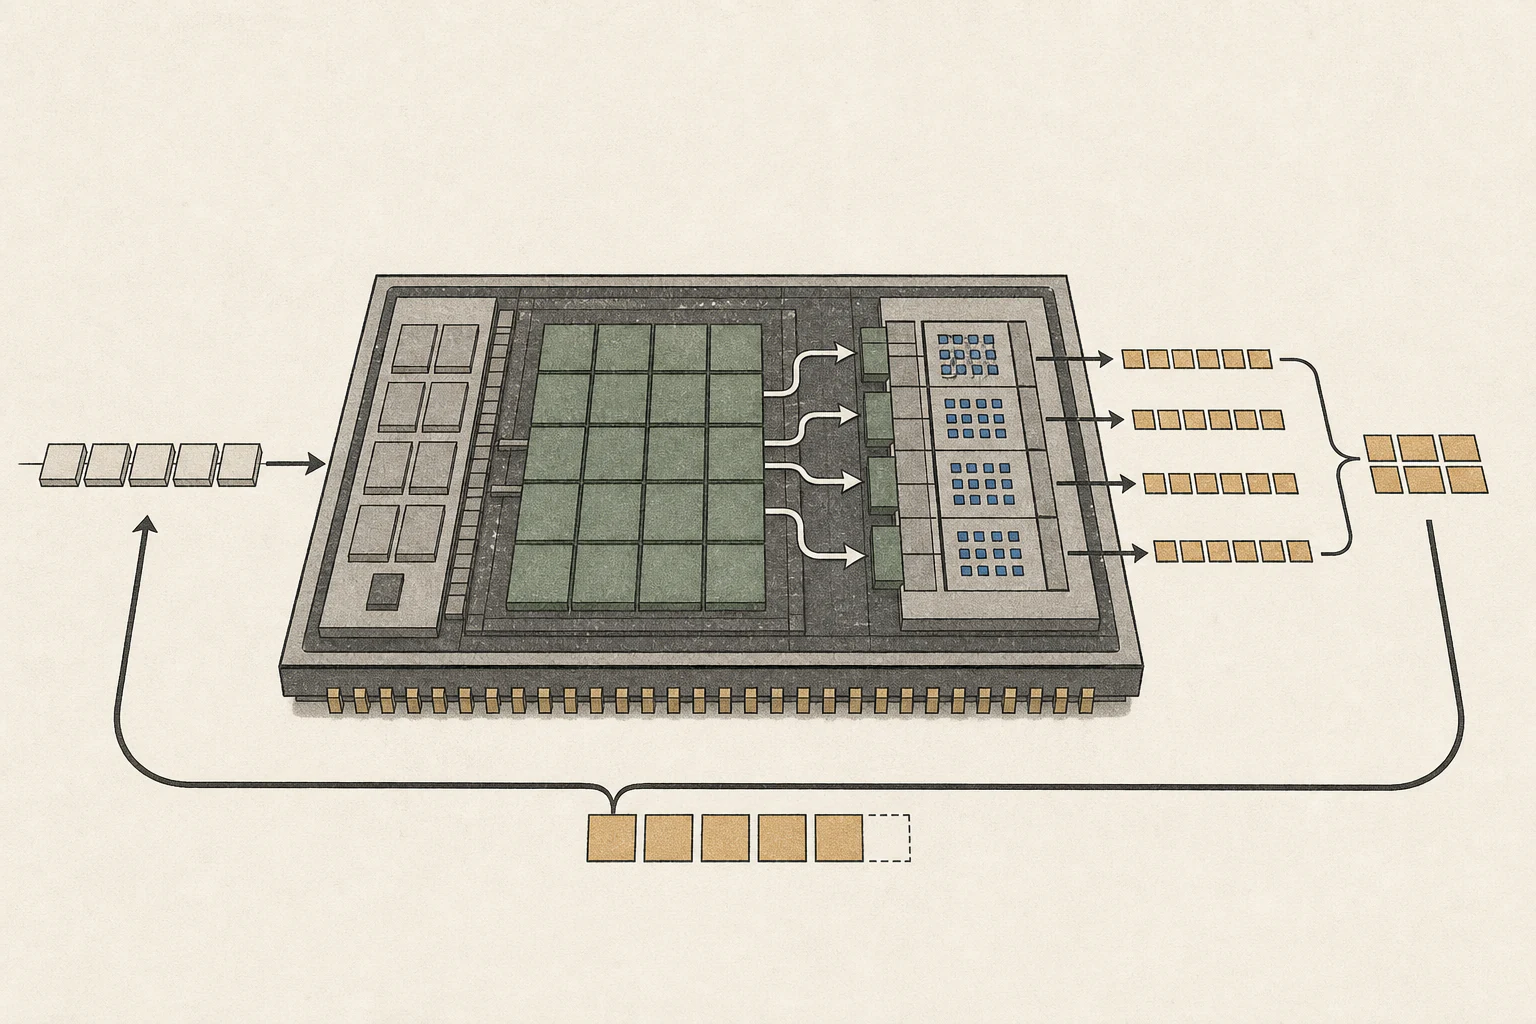
MTPは回答の生成中に次トークン候補を用意します
PDFについて質問するアプリをoMLX API4に接続すると、oMLXがモデルを実行して回答を返します。通常生成では、モデルが次のトークンを1つ選び、それをコンテキストに加えてから次のトークンを再計算します。Multi-Token Prediction(MTP)はモデルと一緒に学習した補助予測headで次トークン候補を先に作り、メインモデルがまとめて確認します。メインモデルが連続して正しいと確認した候補を回答に含め、最初の不一致以降の候補を破棄して通常生成を続けます。
候補の生成と確認にも計算が必要です。候補がよく採用されるモデルやリクエストでは逐次計算を減らせますが、採用率が低いと節約幅も小さくなります。候補の深さだけで判断せず、同じ質問で全体の完了時間と回答を比べてください。
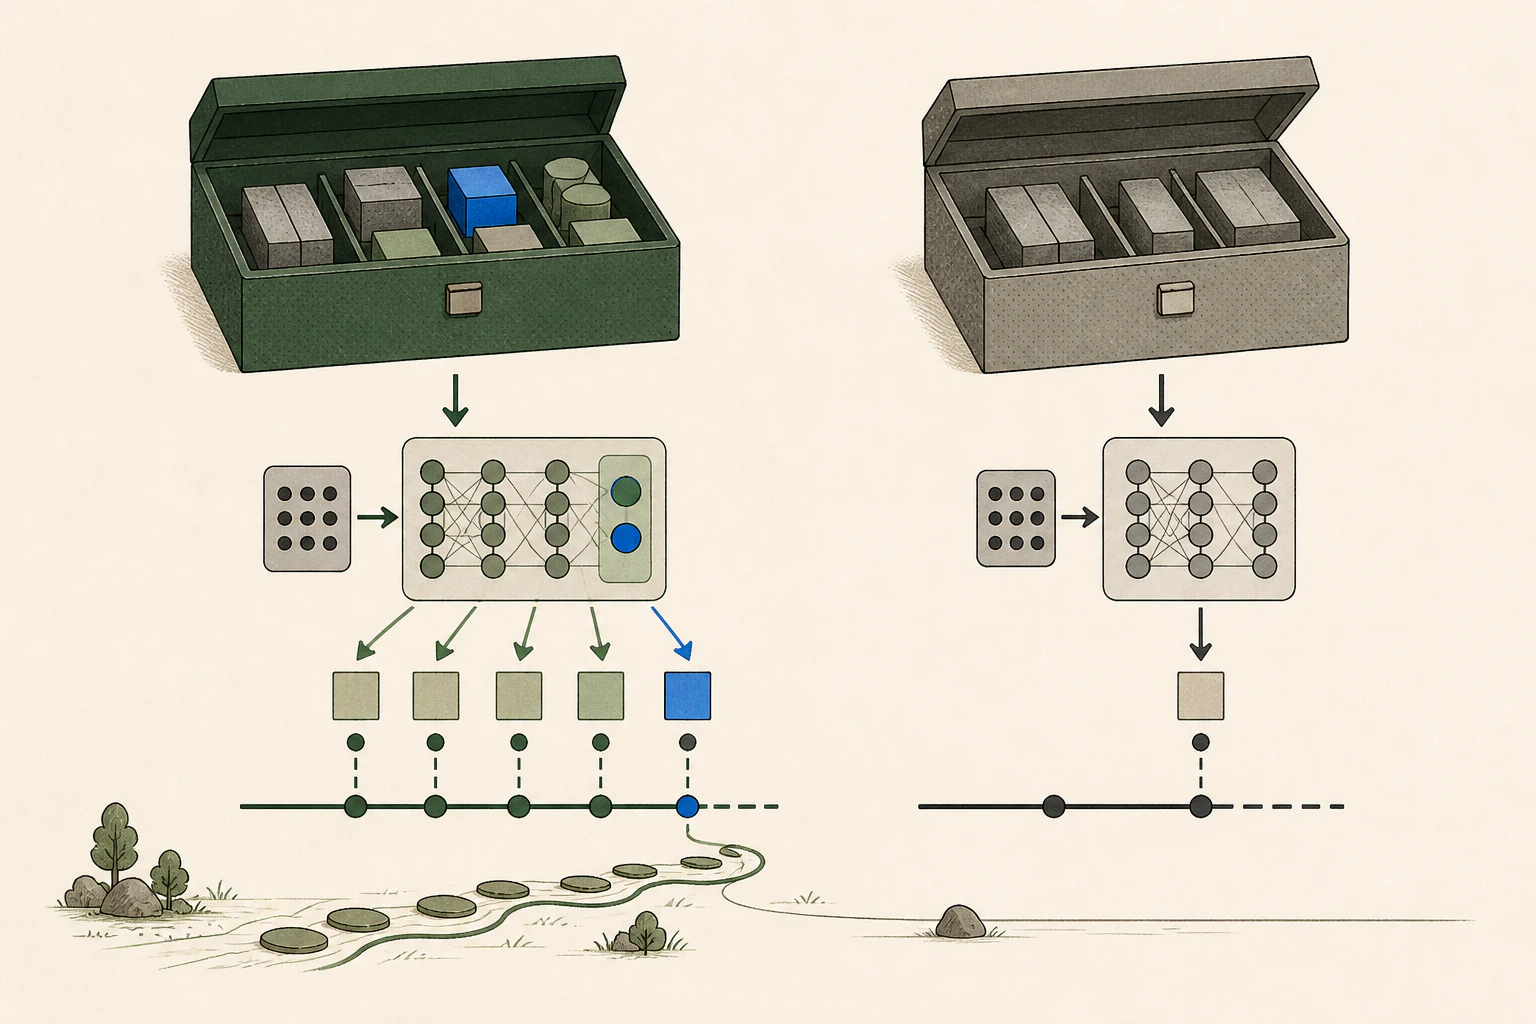
MTP weightを保持したチェックポイントを用意します
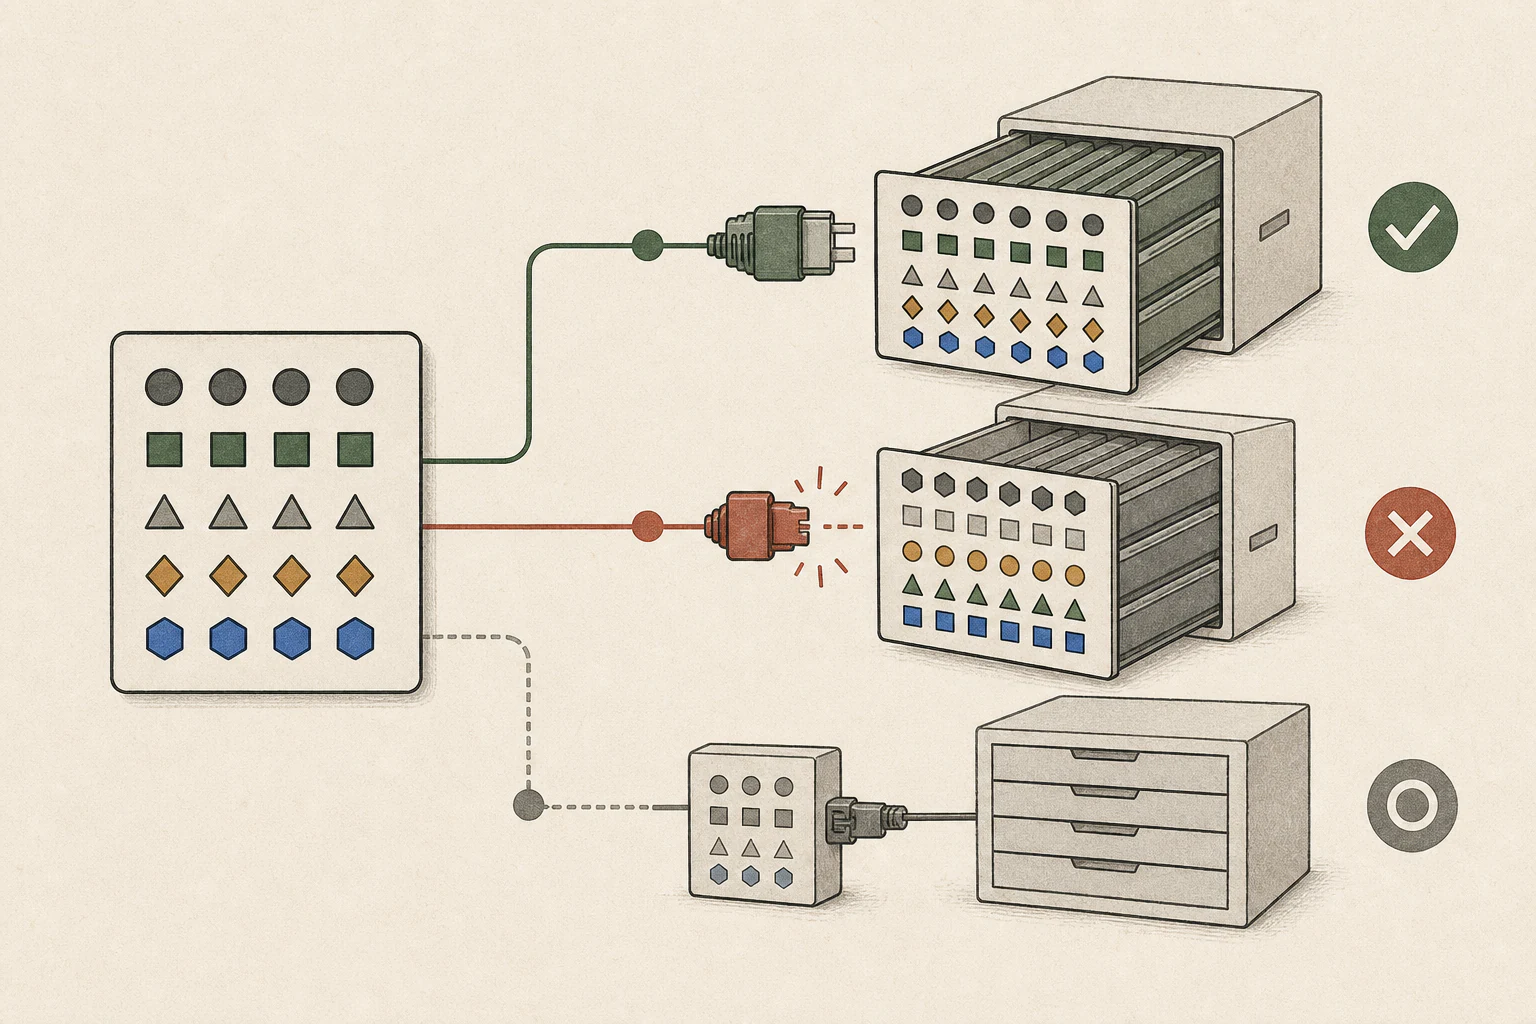
対応する組み合わせを選ぶには、oMLXリリースのモデル一覧でバージョンとアーキテクチャを確認します。チェックポイントの案内でファイル形式を調べ、変換後のファイルにMTP headのtensorが残っていることも確認してください。最後に、そのチェックポイントのMTP項目がモデル設定に表示されるか確認します。
最初の比較では、通常生成で正常に回答するファイルを基準として残し、対応するMTPチェックポイントを1つ追加します。モデルが読み込まれない場合は、MTP設定を変える前にファイルパス、メモリ、チェックポイント形式を確認してください。同じモデルの通常版とMTP版がある場合は、ファイルサイズだけでなくMTP tensorの有無も確認します。
0.7.1.dev1の数値はM3 Ultraでのファイル編集結果です
2026年10月9日公開の開発版で報告されたファイル編集の範囲と完了結果を表にまとめました。これはリクエストを完了するまでの時間を測ったものです。自分の作業に当てはめるには、以下のようにモデルと入力条件をそろえて比較します。
| モデル系統 | タスク・条件 | リリースの報告 |
|---|---|---|
| Qwen · Gemma 4 · GLM-5.3 · MiMo | ファイル編集 · temperature 1.0 · M3 Ultra | 通常生成より1.5~2倍速く完了 |
自分の作業に当てはめるには、モデルとチェックポイント、入力、出力長、temperatureをそろえます。ウォームアップ後、同じファイル編集リクエストを通常生成とMTPで交互に実行してください。全体の完了時間と、生成コードが要件を満たすかを記録します。PDFへの質問や短い会話では、ファイル編集の結果を流用せず、その作業を直接試してください。
長い入力でTurboQuantと組み合わせた生成速度
0.7.1rc1にはTurboQuantの4bit KVキャッシュ5とLightning MTPを組み合わせた改善も含まれます。M3 UltraのQwen3.8-27Bでは16K・32K入力後の生成速度が向上しました。同モデルを使っている場合、長い入力でこの組み合わせを比較できます。
| 入力長 | 変更前 | 変更後 |
|---|---|---|
| 16K | 39.9 tok/s | 68.8 tok/s |
| 32K | 39.0 tok/s | 66.2 tok/s |
M3 Ultra・Qwen3.8-27B・TurboQuant KV 4bit+Lightning MTP・各変更直前のコードと比較した開発者測定・反復回数とsampling全条件はリリース表に記載なし
16Kでは毎秒の生成が約29トークン増えました。実際には同じ文書と出力長で、最初のトークンまでと回答完了までを別々に測ります。TurboQuantはKVキャッシュの表現、Lightning MTPは候補生成を変えるため、両方の設定を記録します。
同じ入力で最初のトークンから回答確認まで比べます
冒頭で例に挙げたPDFへの質問でMTPを試す場合は、同じファイル、ページ、質問を使います。前の節のファイル編集結果とは作業が異なるため、実際によく行うタスクを選んで別に測定してください。文書の読み込みから最初のトークンまでにはプリフィル6とリクエスト待ちが含まれ、その後のトークン速度は生成区間を示します。最後の文までの全体時間も記録します。MTPが変更するのは生成経路なので、入力読み込みとモデルの初回ロード時間は別に確認してください。
通常生成とMTPをそれぞれウォームアップしてから、各3回ずつ交互に試し、中央値を比べると一時的なバックグラウンド処理の影響を抑えられます。入力token数、回答長、temperature、KV cache設定、同時リクエスト数をそろえてください。回答が質問の根拠を保っているかも確認します。複数リクエストを処理するサーバーでは、単独リクエストと同時リクエストを別々に測定し、負荷時の違いを確認してください。
MTPを有効にしても生成が遅い場合は、ログのLightning MTP処理、候補深度、採用状況を確認します。通常生成に戻った場合はモデル構造とcacheの組み合わせを照合します。Lightning MTP動作中も採用率が低ければ、同じ要求で深度とcheckpointを一つずつ変えて比較します。
KV cacheとバッチ条件も確認します
KVキャッシュは処理済みトークンの計算結果を保持し、後続の生成で再利用します。別の要求でも共通入力を再利用するかは、サーバーのprefixキャッシュ設定で変わります。MTPの前後は新しい会話と同じ文書への追加質問を分け、入力長と要求順もそろえて記録します。
同時リクエストが入ると、エンジンのバッチ処理とメモリ使用量が変わります。サーバーでMTPを評価する際は、まず単独リクエストで正常応答とスループット7の基準値を記録します。次に実際の同時リクエストのパターンを再現し、同じ入力でエラーと全体スループットを比較します。使用するモデルとチェックポイントで測定してください。
MTPで繰り返し速度が上がり、回答品質も保たれる場合は、そのチェックポイントと対応するoMLXバージョンを組み合わせて使います。モデルを頻繁に変更する場合や、変換ファイルにMTP headがない場合は、通常生成を基準にします。サーバーログで実際の実行経路を確認し、同じリクエストの変更前後の時間と回答の正確さを記録してください。
用語の注釈
MTP — 複数の将来トークンを一度に予測する学習目標、またはそれを行うモデル構成です。投機的デコーディングでは、その予測を候補トークンとして提案できます。
本文に戻るトークン — モデルが入力や出力を分けて処理する単位です。
本文に戻るチェックポイント — 学習済みモデルの重みなどを保存したファイルです。同じモデル系列でも、版や用途によって異なるチェックポイントを使うことがあります。
本文に戻るAPI — 別のコードからプログラムの機能を呼び出すための決められたインターフェースです。
本文に戻るKVキャッシュ — 過去トークンのAttention用キー・バリューを保存し、後続トークン生成で再利用するメモリです。容量はコンテキスト長やバッチサイズで変わります。
本文に戻るプリフィル — LLMが入力プロンプトを読み、各トークンの内部表現を計算する段階です。プロンプトが長いほど処理するトークンが増えます。
本文に戻るスループット — 一定時間に処理・生成した作業量です。トークン/秒やリクエスト/秒など、単位を合わせて比較します。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- Lightning MTPはApple Silicon向けoMLXの生成経路で、対応モデルのMTP headを使って次トークン候補を先に用意し、メインモデルが正しいと確認した連続候補を回答に反映します。チェックポイントにMTP weightが残っていることを確認し、通常生成と同じ入力で最初のトークンまでの時間、生成時間、完了時間、回答品質を比較します。
- 必要なメモリはどのくらいですか?
- 冒頭で例に挙げたPDFへの質問でMTPを試す場合は、同じファイル、ページ、質問を使います。前の節のファイル編集結果とは作業が異なるため、実際によく行うタスクを選んで別に測定してください。文書の読み込みから最初のトークンまでにはプリフィルとリクエスト待ちが含まれ、その後のトークン速度は生成区間を示します。最後の文までの全体時間も記録します。MTPが変更するのは生成経路なので、入力読み込みとモデルの初回ロード時間は別に確認してください。