
メモリとモデル
最終更新
コンテキスト長・RoPE・スライディングウィンドウ
文書、会話、回答はコンテキストの空間を共有します。
コンテキストウィンドウは、LLM1が1回のリクエストで参照できるトークン2数の上限です。文書だけでなく、指示、質問、過去の会話、新しい回答もこの空間を使います。文書が長くなるほど、回答の余裕とKVキャッシュ3に必要なメモリを合わせて計算します。
たとえば、契約書を入れて更新日を聞き、次に例外条項も含めたメモを依頼します。2回目のリクエストには、契約書に前の質問と回答が加わる場合があります。最初はうまくいったのに続きが途中で切れるなら、実際の入力と出力上限から調べると原因を見つけやすくなります。
文書のほかにアプリが送る内容も含まれます。
アプリは質問の前にシステム指示、役割の表示、ツールの説明を付ける場合があります。会話を引き継ぐアプリは以前の質問と回答も含めます。文書アプリは契約書全体を送ることも、検索した関連箇所だけを送ることもあります。画面の入力より実際のリクエストが長くなる場合があるため、トークン表示や実行ログを確認します。
トークン数は、文字数やPDFのページ数から正確に換算しにくいものです。韓国語、数字、表、コードの分割方法で変わるためです。比較には同じ文書の実際の入力トークン数を使い、続きのリクエストでは過去の会話がどれだけ含まれたかも確認します。
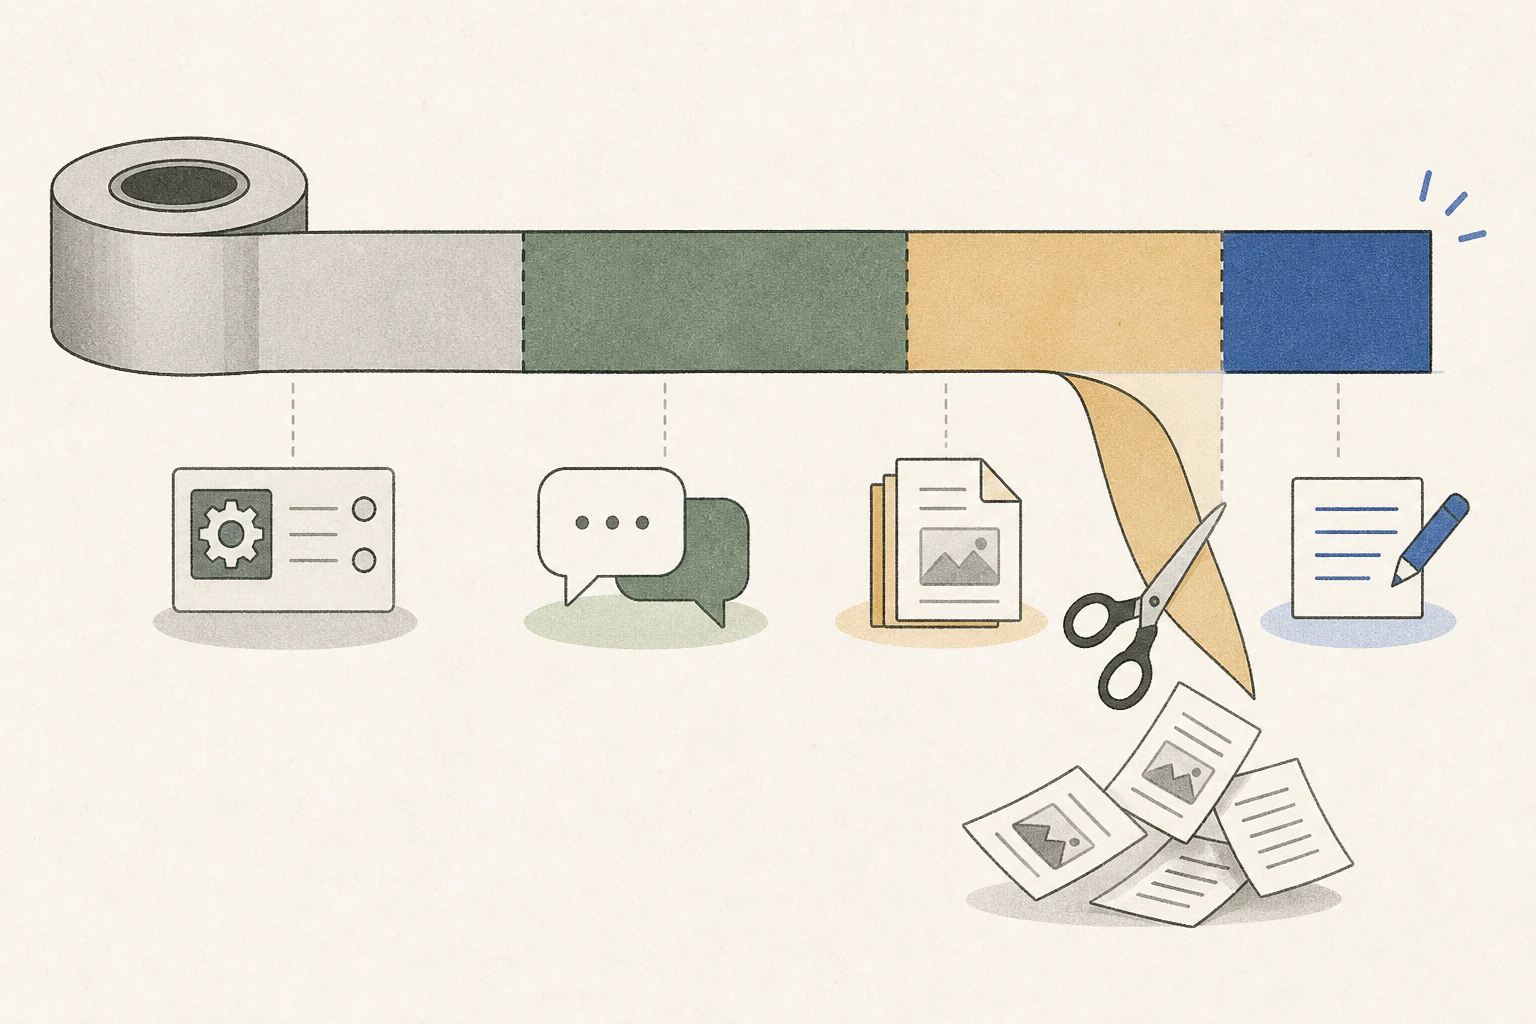
16,000トークンの中に回答の余裕を残してみましょう。
全体の上限を16,000トークンと仮定します。指示と契約書が12,000、過去の会話が3,000なら、残りは1,000です。回答の上限を2,000にするには、入力を減らすか、対応範囲内で全体の上限を増やします。アプリのリクエスト制限と出力予約の方式に合わせて調整してください。
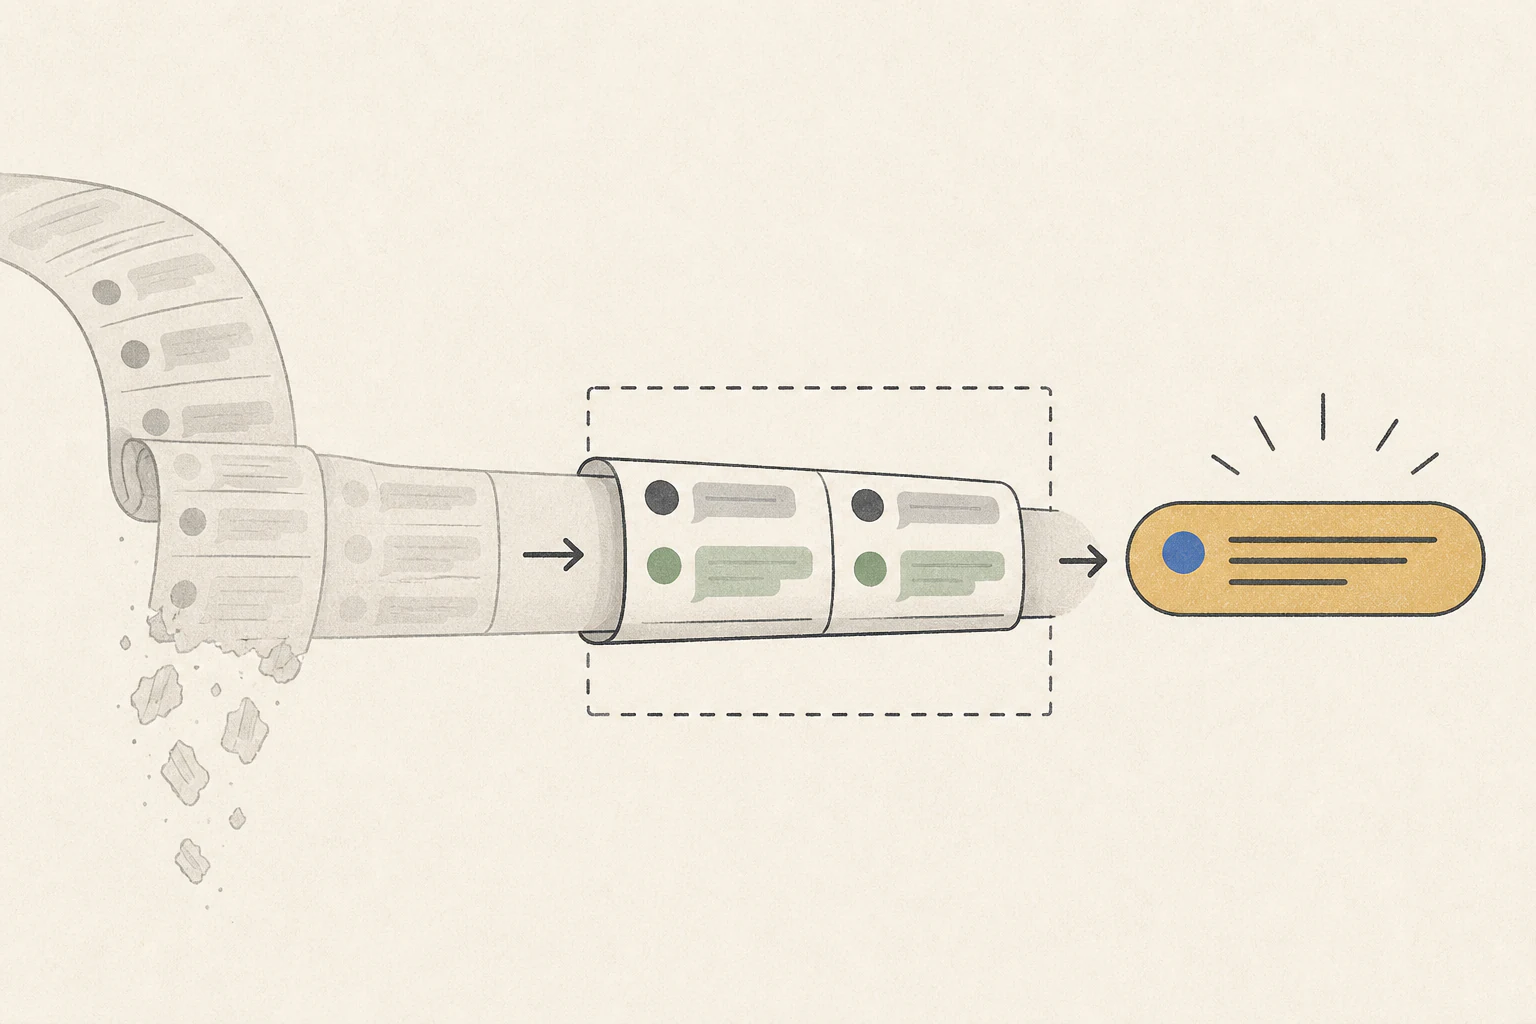
上限を超えると、アプリはリクエストを拒否したり古い会話を減らしたりする場合があります。エラーならログのトークン上限を、前の条件が抜けた回答ならモデルに実際に渡った内容を確認します。回答が途中で止まった場合は、出力上限、実際の生成長、終了や切り詰めの表示も調べてください。
| 項目 | トークン数 |
|---|---|
| 全体の上限 | 16,000 |
| 指示と契約書 | 12,000 |
| 過去の会話 | 3,000 |
| 回答に残る余裕 | 1,000 |
対応する最大長と、実際に使う長さを分けます。
モデルカードの128Kや256Kは、対応する最大コンテキスト長です。実行プログラムは範囲内で使用する長さを設定し、キャッシュを事前に確保したり必要に応じて増やしたりします。そのため、同じ短い質問でも設定を大きくすると使用可能なメモリが変わる場合があります。
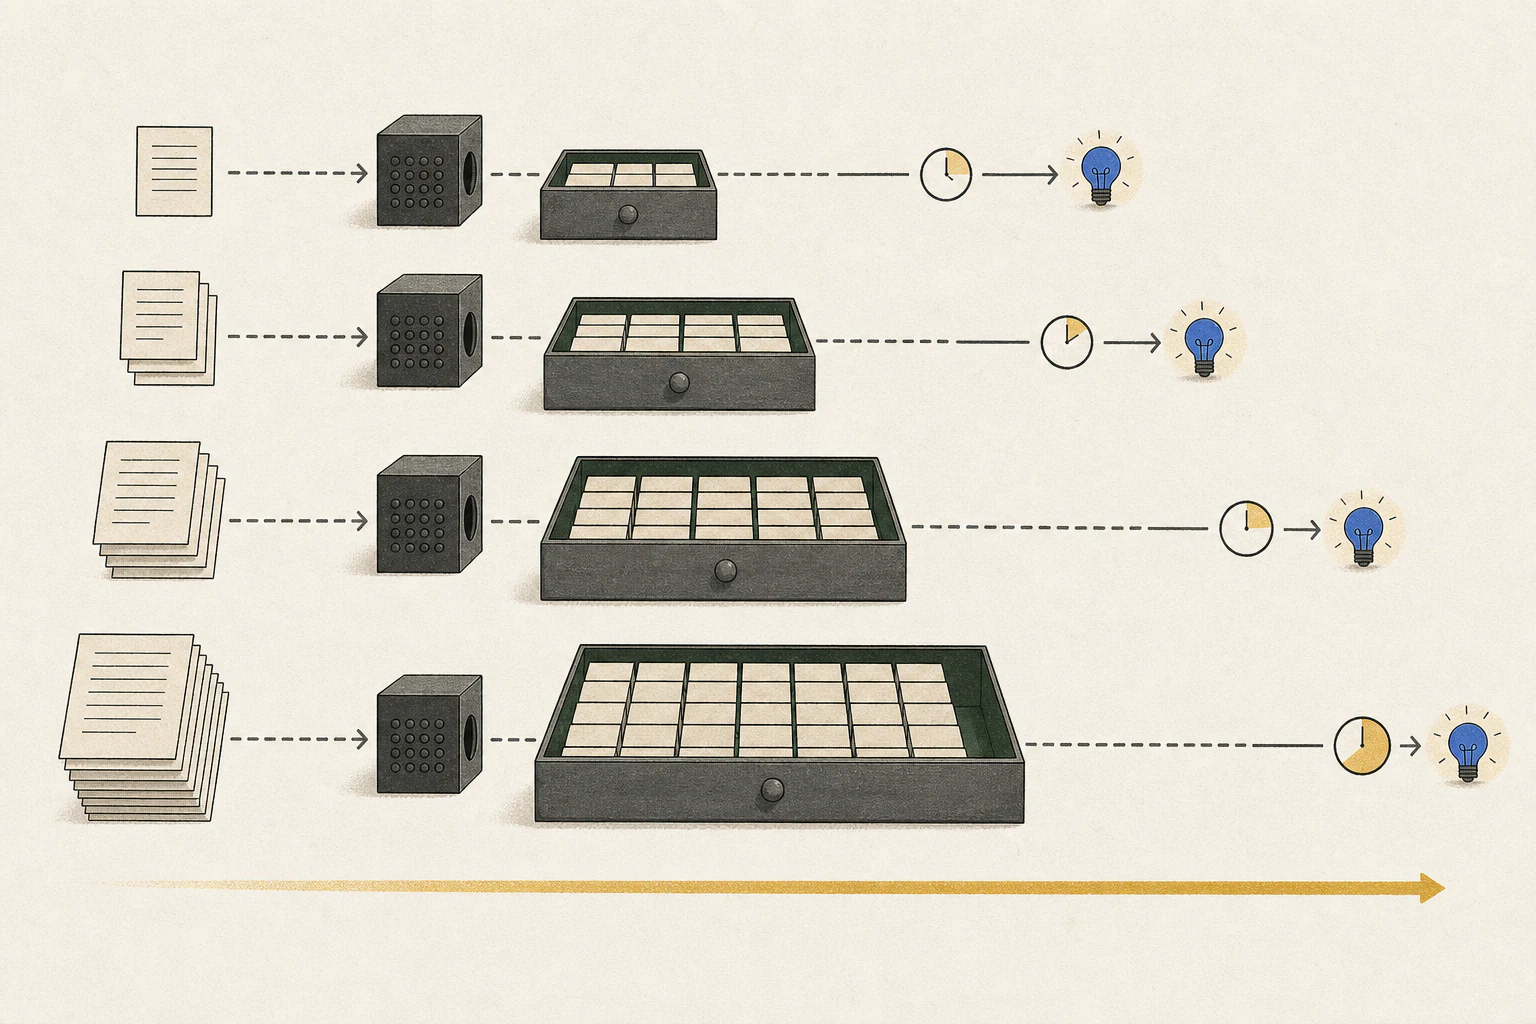
長い入力はプリフィル4の計算を増やし、以前のトークンを参照するKVキャッシュにも空間を使います。重みファイルが同じでも実行メモリが増える理由です。モデル、KV形式、精度、同時リクエスト数を固定して文脈長5だけを増やし、ピークメモリと最初のトークンまでの時間を記録すると、必要な上限を見つけやすくなります。
重みのQ4とKVキャッシュの精度は別の設定です。同時に変えず、1つずつ調整してください。普段の文書と回答が安定して収まる長さを基本とし、時々扱う長い文書には検索や分割要約を使う方法も選べます。
文書の前後の条件をまとめて答えられるか試します。
契約書の前半の更新日と後半の解約例外をまとめて質問します。条項番号や根拠の文も求めて原文と照合すると、必要な内容が回答に反映されたか確かめられます。関連箇所だけを検索して送るアプリでは、両方の条件が検索結果にあるかを先に確認しましょう。
RoPE拡張は位置表現を調整してコンテキスト範囲を広げる方法です。モデルと実行プログラムの条件に従い、前・中・後の根拠を同じ質問で試します。スライディングウィンドウは近い文脈を中心に処理するモデル構造で、アプリが古い会話を消すのはリクエストを組み立てる動作です。どの段階で情報が減るかが分かると、設定と入力のどちらを変えるべきか判断できます。
用語の注釈
大規模言語モデル — 大量のテキストデータから言語パターンを学び、文脈に沿ったテキストを処理・生成するモデルです。
本文に戻るトークン — モデルが入力や出力を分けて処理する単位です。
本文に戻るKVキャッシュ — 過去トークンのAttention用キー・バリューを保存し、後続トークン生成で再利用するメモリです。容量はコンテキスト長やバッチサイズで変わります。
本文に戻るプリフィル — LLMが入力プロンプトを読み、各トークンの内部表現を計算する段階です。プロンプトが長いほど処理するトークンが増えます。
本文に戻るコンテキスト長 — 1回のリクエストでモデルが扱える入力と生成内容のトークン範囲です。上限や実際のメモリ使用量はモデルと実行設定によります。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- コンテキストウィンドウは、LLMが1回のリクエストで参照できるトークン数の上限です。文書だけでなく、指示、質問、過去の会話、新しい回答もこの空間を使います。文書が長くなるほど、回答の余裕とKVキャッシュに必要なメモリを合わせて計算します。
- 必要なメモリはどのくらいですか?
- モデルカードの128Kや256Kは、対応する最大コンテキスト長です。実行プログラムは範囲内で使用する長さを設定し、キャッシュを事前に確保したり必要に応じて増やしたりします。そのため、同じ短い質問でも設定を大きくすると使用可能なメモリが変わる場合があります。