
実行プログラムと拡張機能
最終更新
複数のGPUでローカルLLMを動かすには
GPUを2枚使うと、モデルを分割したり複数のリクエストを分担したりできます。
マルチGPU1実行には、一つのモデルを複数カードに分割する方法と、各カードにモデル複製を置いてリクエストを分配する方法があります。24GB GPU 2枚の物理メモリは合計48GBですが、ランタイム2がモデルとキャッシュを分割しなければ、一つの要求でまとめて使えません。モデル容量・単一回答の遅延・チーム全体の処理量は個別に確認します。
共有コーディングサーバーに24GB GPUを2枚導入する場合、まず大きなモデルの読み込み・単一回答の高速化・複数ユーザーの待ち行列のどれが課題かを決めます。カード追加にはランタイム要件・カード間通信・冷却・電源の条件も伴います。
重みとキャッシュを各GPUに配置します。
24GBカード2枚の物理メモリは合計48GBです。ただしアプリが1枚目だけを使うなら、2枚目のメモリは1枚目へのモデル読み込みを助けません。一つの大きなモデルに両方を使うには、ランタイムが重みと実行中のKVキャッシュ3を分配する経路に対応する必要があります。
OSが2枚を認識することと、特定モデルが実際に両方で動くことは別の確認です。ランタイムログとGPUごとのメモリを見て、モデルが分割されたか一方だけに読み込まれたかを確認します。作業領域やリクエストごとのキャッシュにもメモリが必要なため、48GBすべてを重みに使うことはできず、配置が偏れば一方が先に上限に達することがあります。
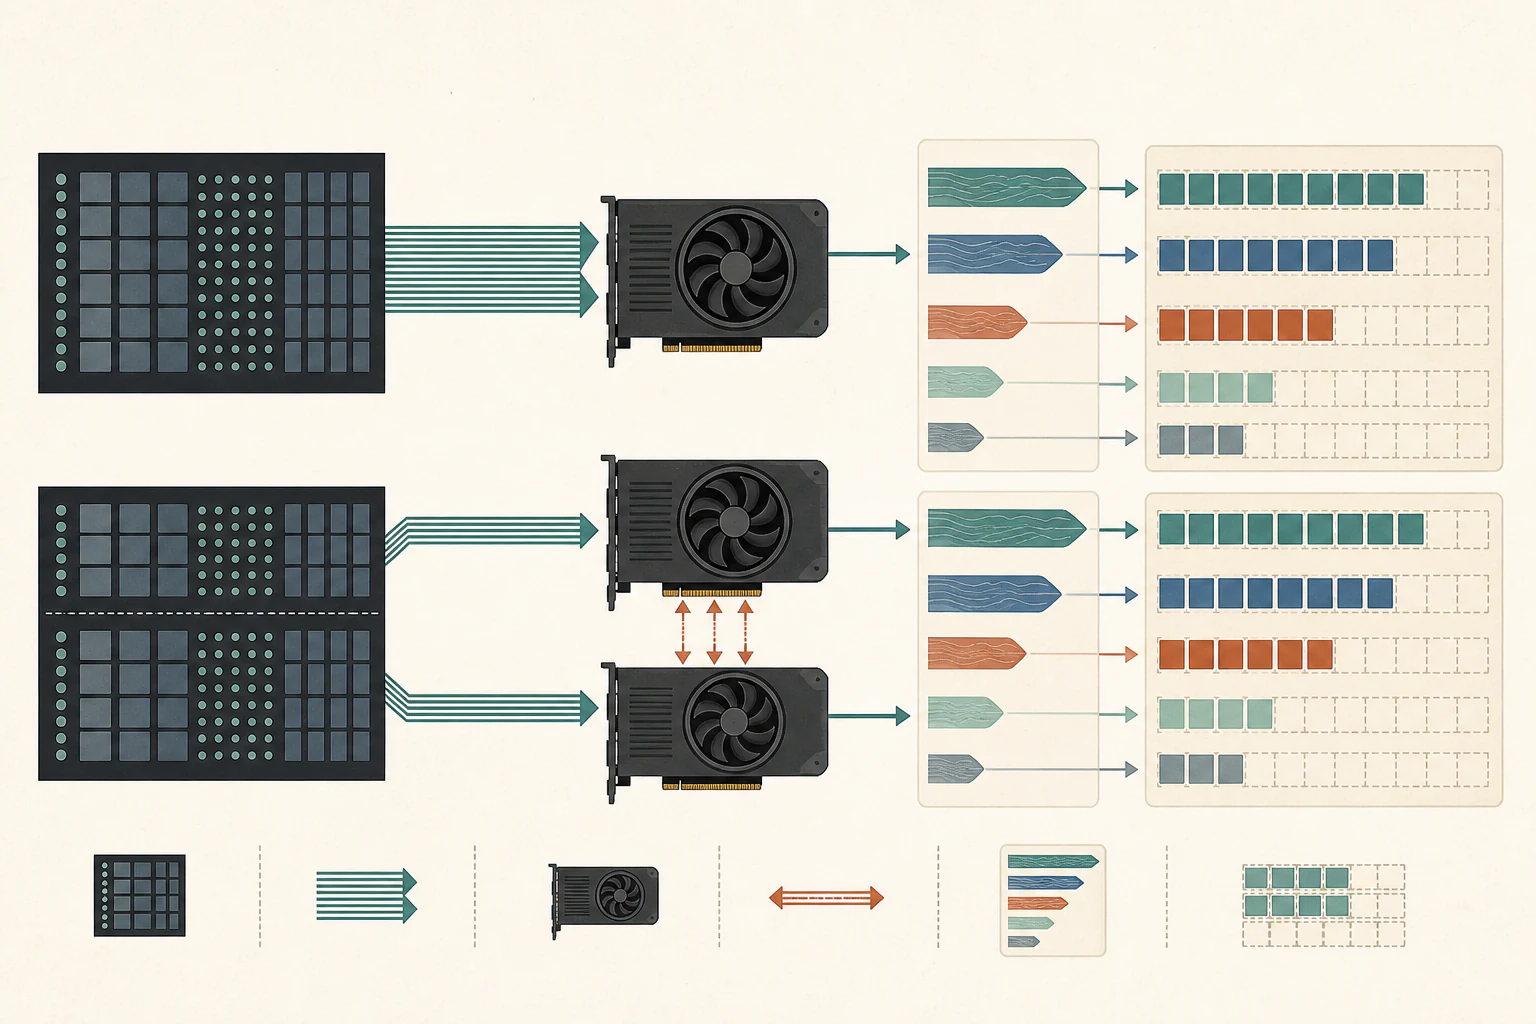
レイヤー分割はモデルの前段と後段を別カードに配置
レイヤー分割ではモデル前段の層を一方、後段をもう一方のGPUに置きます。入力は前段から処理され、中間結果が次のカードへ渡るため、1枚に収まらない重みを分けて配置できます。
後続層は前段の結果を受け取って計算を続けるため、カード間の転送と待ち時間が繰り返されます。モデルを配置できる効果と一人の応答が速くなる効果は別々に測定します。複数リクエストをどれだけ重ねられるかはランタイムのスケジューリング次第で、GPUメモリ容量が異なると均等分割も難しくなります。
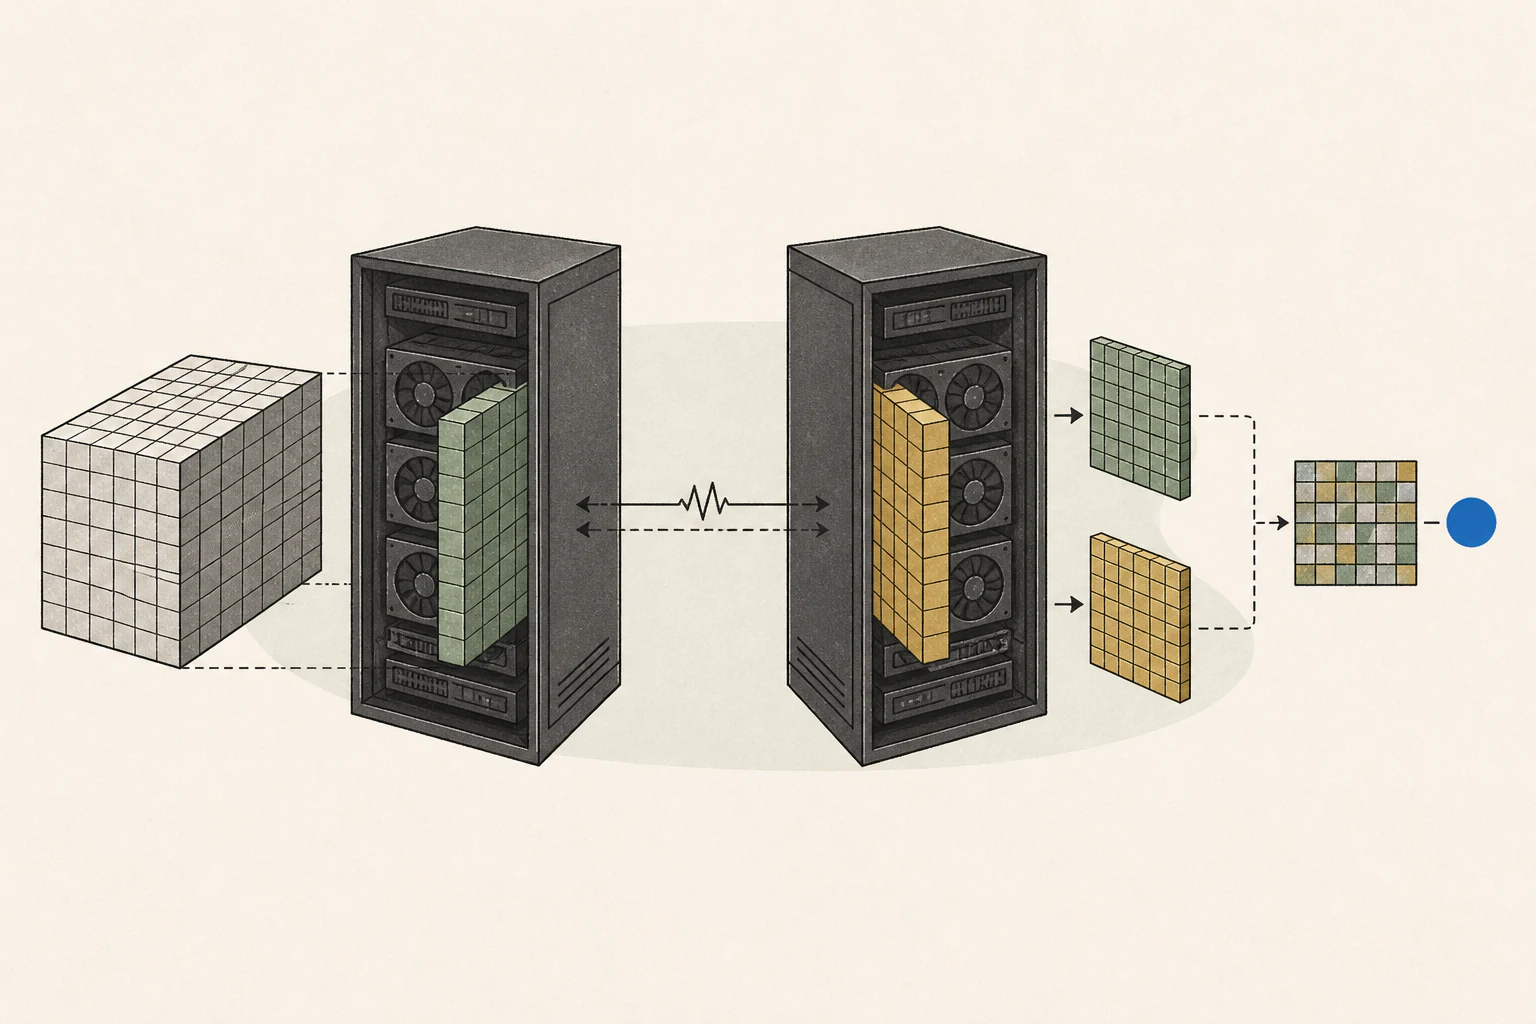
Tensor parallelismは層内計算を分割し頻繁に通信
Tensor parallelism4は同じモデル層の計算を複数GPUで分担し、結果を交換します。前段と後段の層を別カードに置くレイヤー分割とは異なり、層の処理中にGPU間通信を繰り返します。
マザーボードのPCIe世代だけでなく、各スロットの実レーン数と2枚装着時の接続条件を確認します。NVLinkを使う場合はカードが対応するか、必要な接続部品を取り付けられるかも調べます。インターコネクトが制限されると通信コストが計算時間の削減分を相殺するため、カード仕様や帯域を単純に足して2倍の速度を予測できません。アプリがどの並列方式を実装し、対象モデル形式に対応するかも確認します。
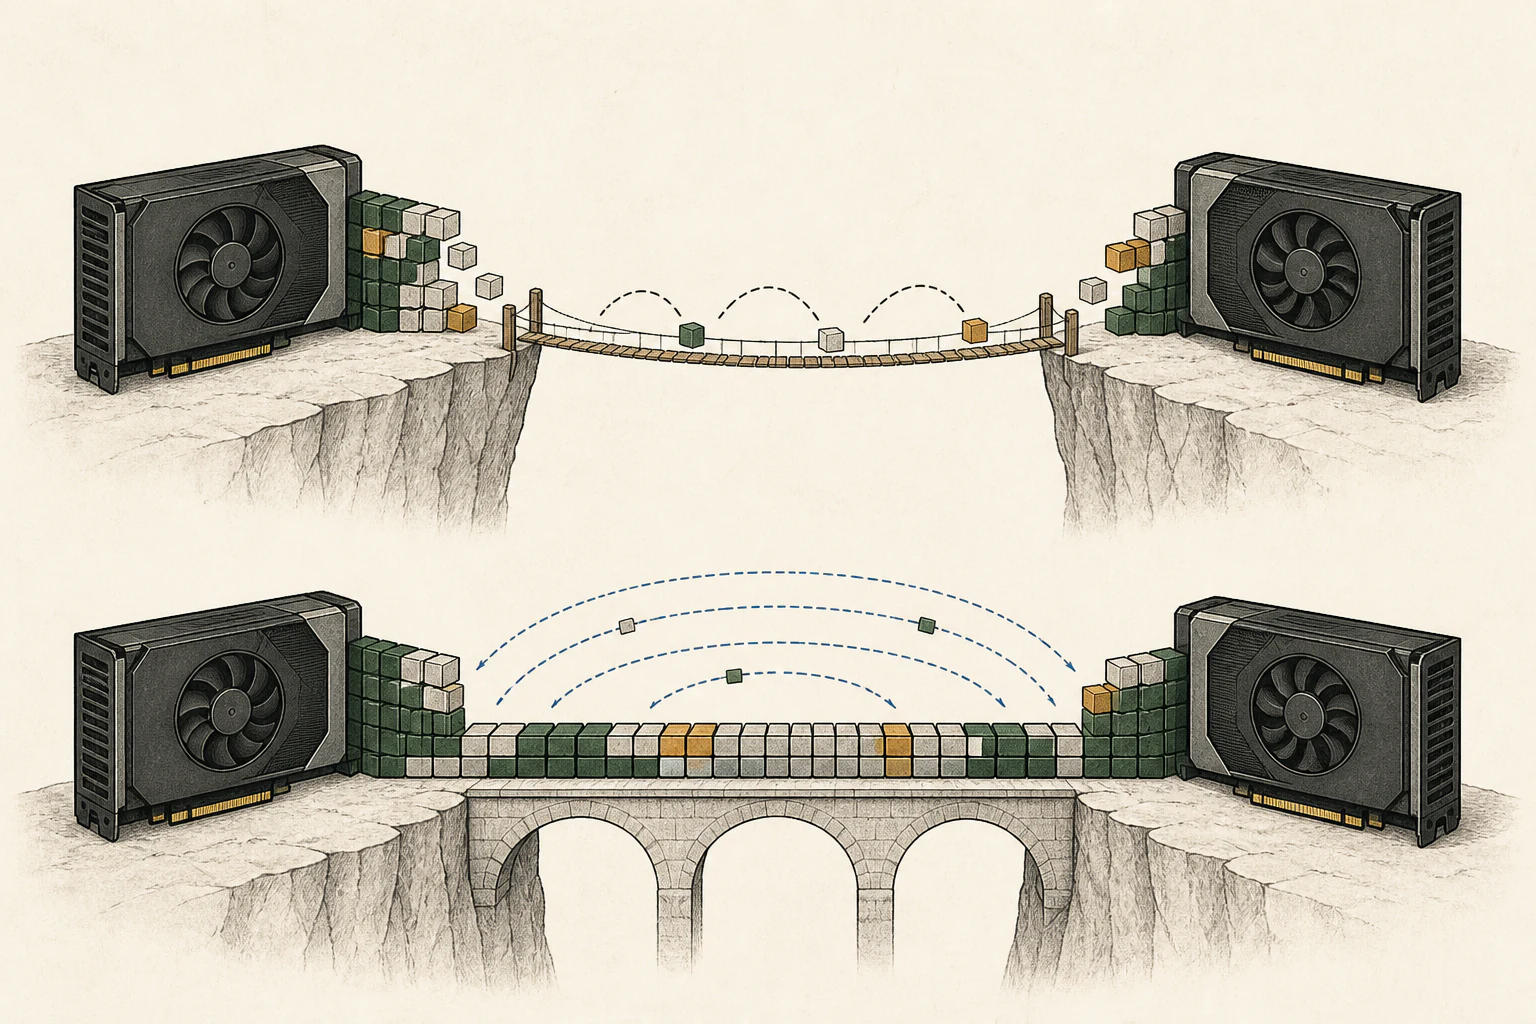
モデル複製は一つの計算ではなく複数要求を分配
モデルが1枚のGPUに収まるなら、同じモデルを両方のカードに配置して別々のリクエストを処理できます。チーム全体の処理量や待ち行列には役立つ可能性がありますが、一つのリクエストの計算を分けるわけではないため、一人の回答が自動的に速くなるわけではありません。
レイヤー分割やテンソル並列は1枚に収まらないモデルへの対応で、複製は同じモデルを使う複数リクエストの分配に対応します。同時リクエスト時の各ユーザーの待ち時間とピークメモリを試し、スケジューラーがどう割り当てるか確認します。総スループット5が上がっても、個別の初回応答や最長待ち時間が長いことがあります。
購入前にスロット・電源・冷却・実行経路を確認
マザーボードのスロット数だけで判断しないでください。カードの厚さで並べて取り付けられない場合があり、電源ユニットとケーブルが2枚に対応するか、ケース内の風量と冷却スペースが十分か確認します。カード価格だけでなく、長時間稼働時の騒音と電力も考慮します。
大きなモデルが必要で対応する分割経路も確認できているなら、複数GPUを検討する根拠があります。一人で使うモデルの速度が目的なら、通信・設置コストと単一カードの代替案を比べます。購入前に利用アプリ・モデル形式・分割か複製かを決めておけば、購入後に経路が合わない問題を減らせます。
大きなMoEを分割するならexpert cacheも比較
MoE6がGPUに収まりきらないときは、一部のexpert重みをRAM7に置いて必要なときに転送します。llama.cppの複数GPU MoEキャッシュは、よく使うexpertをGPUに残して転送を減らします。重みがすべてGPUに収まる構成では、まず通常の分割設定を比較してください。
| 設定 | 入力tok/s | 生成tok/s |
|---|---|---|
標準--fit | 440.7 | 34.78 |
--fit + expert cache | 402.0 | 60.38 |
| CPU expert + cache | 321.5 | 64.39 |
開発中の公開測定・RTX 4090×2、layer split・Qwen3.8-Flash-Next Q4_0 93.7 GiB、expert 65 GiB・EPYC 7742、16スレッド、NUMA node 1つ・SPEED-Bench qualitative 11入力、各分類1回、出力長設定512、temperature 0、同時リクエスト1件。キャッシュ設定は統合前のGPU別容量を使用しています。元の測定と最終実装
この記録ではキャッシュを有効にすると生成が速くなりましたが、入力処理は遅くなっています。長い文書の最初の回答を早く受け取りたいならprefill8も比較してください。短い入力から長い回答を作る処理は、decode9改善の利点を得やすくなります。
統合されたb11507以降では、キャッシュの合計容量を指定します。例えば--moe-cache-mib 8192 --tensor-split 1,1は、2枚のGPUに約4 GiBずつ配分する設定です。キャッシュは重み・KV cache・作業領域とVRAM10を共有するため、既存設定の空きを確認し、小さい容量から増やしてください。
用語の注釈
GPU — 多くの計算を並列に処理するプロセッサーです。AIモデルの実行ではモデル計算を担います。
本文に戻るランタイム — プログラムの実行時に必要な機能を提供するソフトウェア環境です。ローカルAIではモデル実行エンジンを指すこともあります。
本文に戻るKVキャッシュ — 過去トークンのAttention用キー・バリューを保存し、後続トークン生成で再利用するメモリです。容量はコンテキスト長やバッチサイズで変わります。
本文に戻るテンソル並列 — モデルの層内の行列や演算を複数の装置に分割して計算する方式です。部分結果をまとめるために装置間通信が必要です。
本文に戻るスループット — 一定時間に処理・生成した作業量です。トークン/秒やリクエスト/秒など、単位を合わせて比較します。
本文に戻るMoE — 複数の専門家サブネットワークから入力に応じて一部を選ぶモデル構造です。総パラメータ数と1トークン処理時に有効な数は異なることがあります。
本文に戻るシステムRAM — プログラムの実行中にデータを一時保存するシステムメモリです。
本文に戻るプリフィル — LLMが入力プロンプトを読み、各トークンの内部表現を計算する段階です。プロンプトが長いほど処理するトークンが増えます。
本文に戻るトークンのデコード — 入力とそれまでの回答をもとに、次の出力トークンを順に生成する段階です。
本文に戻るVRAM — グラフィックカードのGPUが使うメモリです。モデルの重みや計算途中の値を保存します。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- マルチGPU実行には、一つのモデルを複数カードに分割する方法と、各カードにモデル複製を置いてリクエストを分配する方法があります。24GB GPU 2枚の物理メモリは合計48GBですが、ランタイムがモデルとキャッシュを分割しなければ、一つの要求でまとめて使えません。モデル容量・単一回答の遅延・チーム全体の処理量は個別に確認します。
- 必要なメモリはどのくらいですか?
- 24GBカード2枚の物理メモリは合計48GBです。ただしアプリが1枚目だけを使うなら、2枚目のメモリは1枚目へのモデル読み込みを助けません。一つの大きなモデルに両方を使うには、ランタイムが重みと実行中のKVキャッシュを分配する経路に対応する必要があります。