
応答速度と加速
最終更新
LLMのメモリ帯域幅 vs 演算性能:速度のボトルネックを見つける方法
メモリ帯域幅と演算性能は、それぞれ異なる待ち時間を短くします。
メモリ帯域幅1は、メモリから演算装置へ1秒間に送れるデータ量です。GPU2の演算性能は、そのデータを使って処理できる計算量です。LLM3が回答を1トークン4ずつ生成するときと長い入力を読むときでは仕事が異なり、2つの仕様の影響も変わります。
文書を要約するときは、最初の返答が遅いのか、返答が始まってから文章がゆっくり続くのかを分けて考えましょう。前者は入力を処理するプリフィル5、後者は回答を生成するデコード6に関わります。どこで待っているかが分かると、機器の仕様表で何を先に比較すべきか判断できます。
1トークンずつ生成するときは、重みを繰り返し読み込みます。
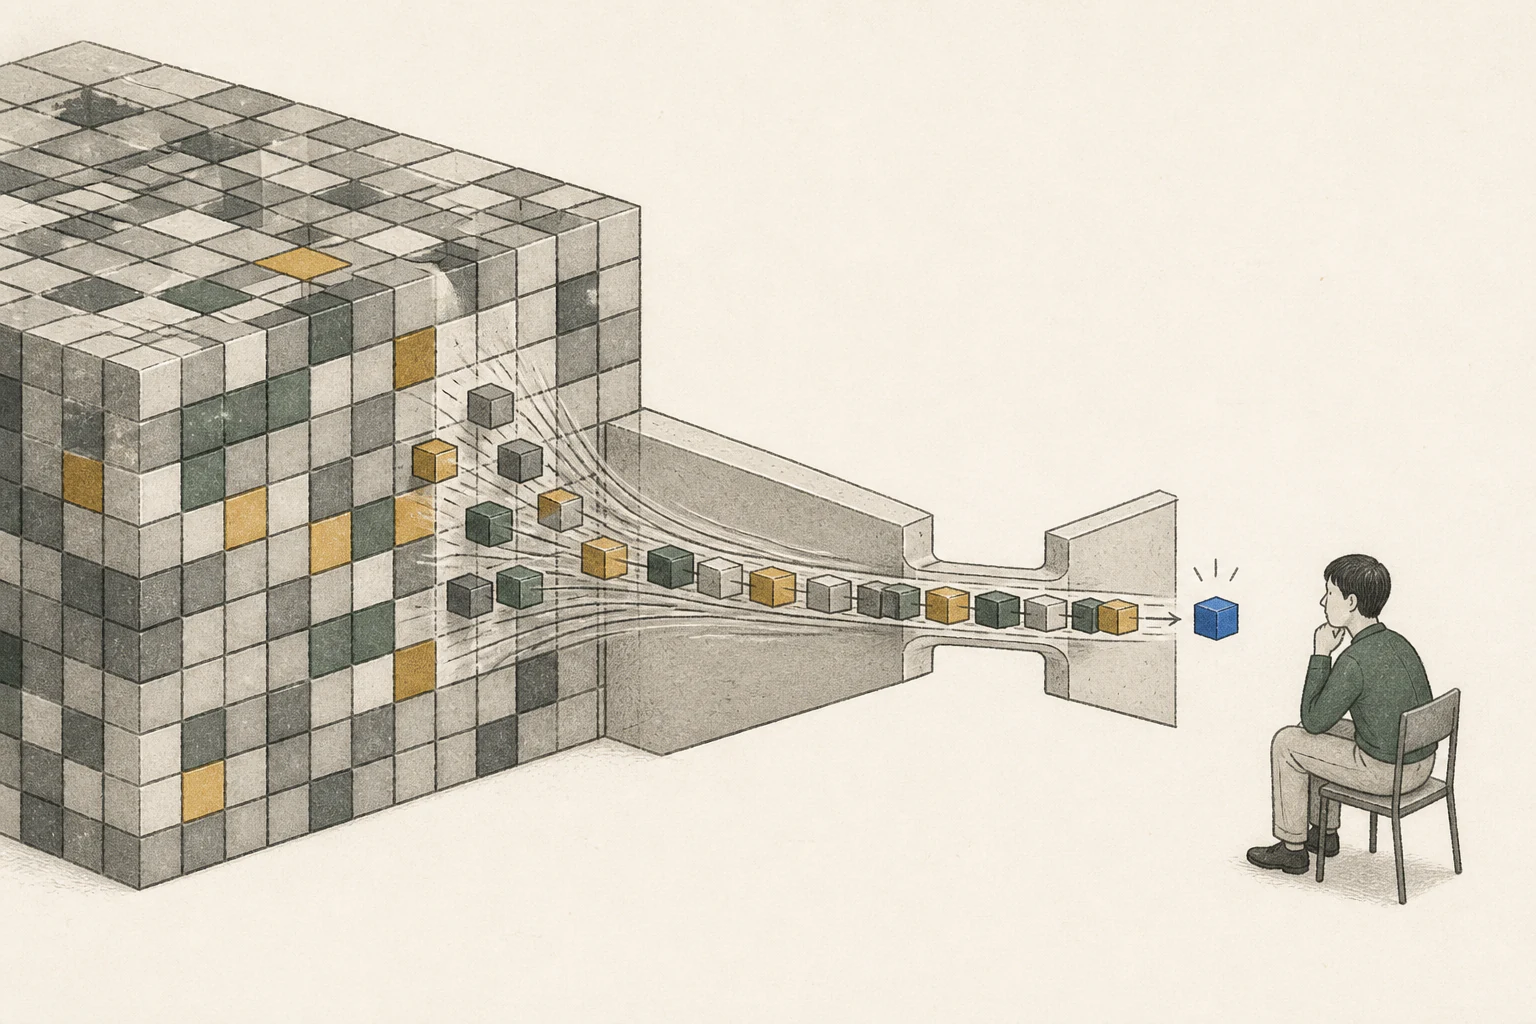
LLMはモデルに保存された重みを使って次のトークンを計算します。1人への回答では、前のトークンが決まってから次を生成します。その間、必要な重みをメモリから繰り返し取得します。演算装置がデータを待っているなら、演算ユニットを増やす前にその待ち時間を短くする必要があります。
ここでは容量と帯域幅の役割が異なります。モデルとKVキャッシュ7を置くには十分な容量が必要で、計算用のデータを速く供給するには帯域幅が必要です。モデルが収まっているのに回答が遅い場合は、容量を増やすだけでなく、実際のデコード速度とデータの供給経路を調べると役立ちます。
20GBを読む時間を計算してみましょう。
1トークンの計算に必要な重みが20GBで、実際の転送速度が400GB/sだと仮定します。読む時間は20÷400=0.05秒です。1秒間に繰り返すと1÷0.05=20回になります。読む量が減るか転送が速くなると、同じデータを待つ時間が短くなる仕組みです。
この例で計算したのは重みを読む時間だけです。実際のtok/sには演算、KVキャッシュへのアクセス、実行プログラムの処理時間も含まれます。仕様上の最大帯域幅ではなく実際の転送速度を仮定しており、MoE8のように一部の重みを選ぶ構造では読み込む量も変わります。式は帯域幅の役割を理解するために使い、機器の速度は同じモデルの実行結果で比較しましょう。
長い文書を読むときは、多くのトークンをまとめて処理します。
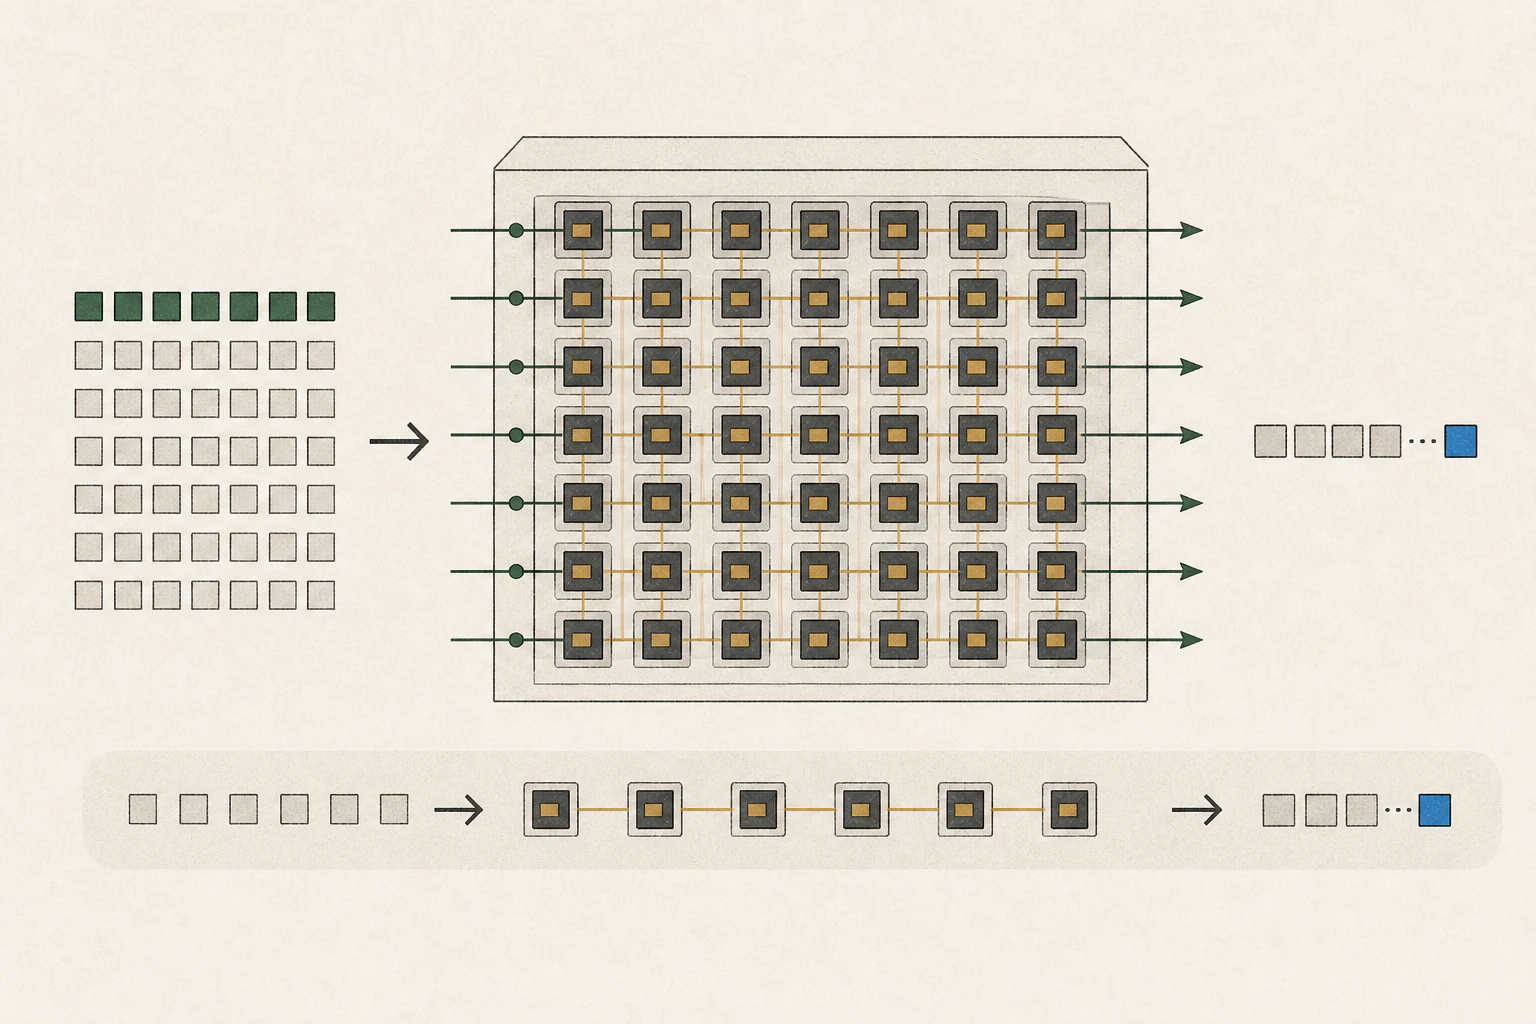
文書を受け取ると、モデルは回答の前に入力トークンを処理します。プリフィルではすでに与えられたトークンをまとめて計算でき、演算装置を広く活用できます。長い契約書を送ってから最初の返答まで時間がかかるなら、プリフィルの処理量と最初のトークンまでの遅延を比較しましょう。
複数の利用者のリクエストをまとめるバッチ処理でも、同じ重みを複数の計算に使えます。サーバー全体のトークン処理量が増える一方、個々のリクエストは待ち行列で待つ場合があります。個人のチャットでは1つの回答の速度を、共同サーバーでは個別の遅延と全体の処理量を合わせて確認しましょう。
量子化とコンテキスト長も、データの移動に影響します。
量子化9は重みを少ないビットで保存し、読む量を減らせます。その表現を効率よく計算するカーネルがあれば、容量と速度の両方に役立ちます。同じ元モデルでも、形式と実行プログラムを記録して、どの組み合わせで時間が短くなったか確認できるようにしましょう。
会話が長くなると、以前の文脈を保持するKVキャッシュも大きくなります。生成中にキャッシュを参照する負担が増え、短い質問と長い文書で速度が変わることがあります。入力の長さを固定し、出力トークン数も記録すると、作業量の変化による差を減らせます。
遅い区間に合わせて機器を比較します。
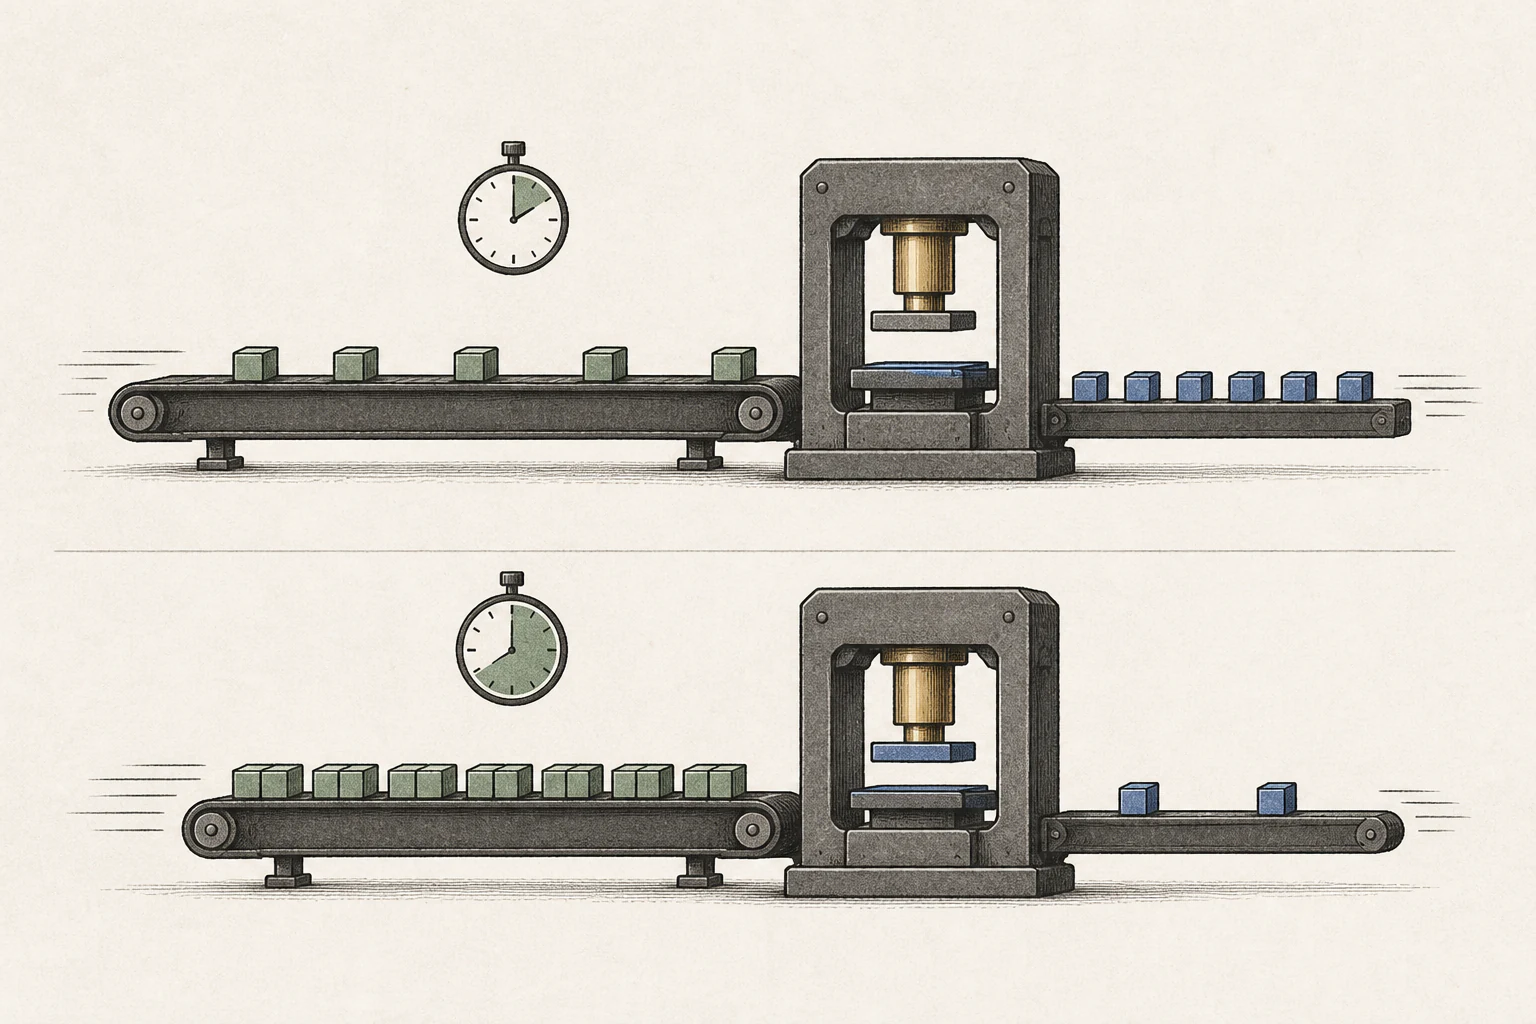
まずモデルと実際の文脈がメモリに収まるか確認します。その後、同じ文書と質問で、最初のトークンまでの時間、生成速度、完了までの時間を記録してください。3つを分けると、高性能な機器が作業のどの部分を短縮するのか判断しやすくなります。
| 遅い区間 | 先に比べるもの |
|---|---|
| 回答がゆっくり続く | 同じモデルのデコード、帯域幅、実行経路 |
| 長い入力の後、最初の返答が遅い | 同じ入力長でのプリフィルとTTFT |
| 複数のリクエストが待ち行列に並ぶ | 同時リクエストでの個別遅延と全体処理量 |
用語の注釈
メモリ帯域幅 — メモリとプロセッサー間で単位時間に転送できるデータ量です。通常はバイト毎秒(B/s)で表します。
本文に戻るGPU — 多くの計算を並列に処理するプロセッサーです。AIモデルの実行ではモデル計算を担います。
本文に戻る大規模言語モデル — 大量のテキストデータから言語パターンを学び、文脈に沿ったテキストを処理・生成するモデルです。
本文に戻るトークン — モデルが入力や出力を分けて処理する単位です。
本文に戻るプリフィル — LLMが入力プロンプトを読み、各トークンの内部表現を計算する段階です。プロンプトが長いほど処理するトークンが増えます。
本文に戻るトークンのデコード — 入力とそれまでの回答をもとに、次の出力トークンを順に生成する段階です。
本文に戻るKVキャッシュ — 過去トークンのAttention用キー・バリューを保存し、後続トークン生成で再利用するメモリです。容量はコンテキスト長やバッチサイズで変わります。
本文に戻るMoE — 複数の専門家サブネットワークから入力に応じて一部を選ぶモデル構造です。総パラメータ数と1トークン処理時に有効な数は異なることがあります。
本文に戻る量子化 — モデルの重みや計算値を少ないビット数で表し、保存容量やメモリ使用量を減らす方法です。表現が粗くなるため、精度にも影響することがあります。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- メモリ帯域幅は、メモリから演算装置へ1秒間に送れるデータ量です。GPUの演算性能は、そのデータを使って処理できる計算量です。LLMが回答を1トークンずつ生成するときと長い入力を読むときでは仕事が異なり、2つの仕様の影響も変わります。
- 必要なメモリはどのくらいですか?
- LLMはモデルに保存された重みを使って次のトークンを計算します。1人への回答では、前のトークンが決まってから次を生成します。その間、必要な重みをメモリから繰り返し取得します。演算装置がデータを待っているなら、演算ユニットを増やす前にその待ち時間を短くする必要があります。