
メモリとモデル
最終更新
MoEとDenseの違い:活性パラメータが小さくてもメモリが必要な理由
MoEは必要なエキスパートを選んで計算し、全体の重みを保持します。
MoE1は、複数のエキスパートブロックから一部を選んで次のトークン2を計算するモデル構造です。Denseモデルは各トークンで重みの大部分を使います。MoEの「全体35B・アクティブ3B」は、保持する規模と1トークンの計算に参加する規模を分けた表示です。
ダウンロードには全体の重みのファイルが必要で、速度には実際に使う計算経路が関わります。2つの数字の違いを知ると、大きなモデル名だけで候補から外したり、アクティブ数だけでメモリを少なく見積もったりするのを減らせます。
ルーターがトークンに合うエキスパートを選びます。
MoEのエキスパートは、モデル内の計算ブロックです。学習したルーターが入力に応じてブロックを選び、その結果で計算を続けます。人が「韓国語担当」「コーディング担当」と決めた小さなモデルの集合ではなく、トークンごとに計算経路を選ぶ構造として理解すると分かりやすくなります。
Denseでは各層の重みの大部分が計算に参加します。MoEでは共有部分と選ばれたエキスパートが参加し、次のトークンでは別のエキスパートが選ばれることがあります。そのため、あるトークンで使わなかった重みも、後の計算で実行プログラムが参照できる必要があります。
- コンテキスト長・RoPE・スライディングウィンドウ
- プリフィルとデコードの違い:TTFTとtok/sのどちらを見る?
- GGUFとMLX、ダウンロードするモデル形式の選び方
- LLMのメモリ帯域幅 vs 演算性能:速度のボトルネックを見つける方法
- Nemotron 3.5 Boltの74Bモデルを24GBで動かせる?
- Nemotron 3.5 Super VLをDGX Spark・RTX PRO 6000で使うには?
- Ling 3.1 Flashの実行にはどんなサーバーが必要ですか?
- LFM2.5-24B-A2BのローカルLLM:韓国語対応24B MoEを自分のPCで
- 35BのMoEが、小さな密モデルより速いことがある理由
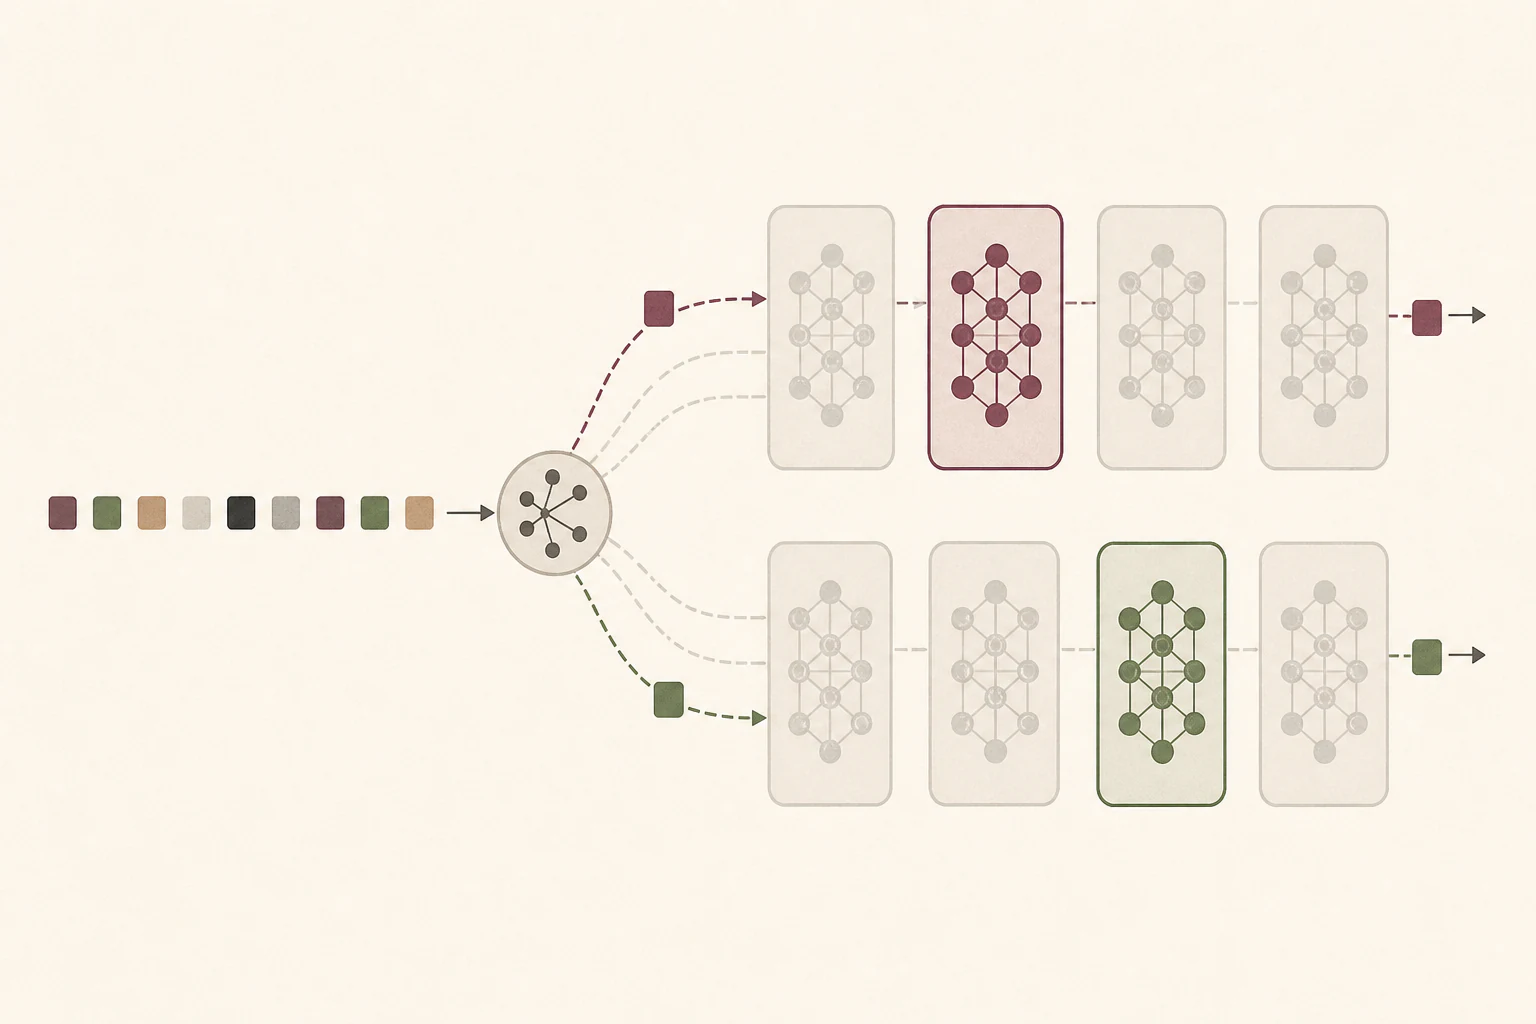
全体35Bとアクティブ3Bは役割が異なります。
Bは10億個のパラメーターを意味します。全体35Bは共有部分とエキスパートの重みを合わせた規模で、アクティブ3Bは1トークンの計算経路に参加する規模です。ダウンロードとメモリでは全体の数を、トークンごとの計算ではアクティブ数を先に見る理由です。
すべてを4ビットで保存する単純な例を計算すると、350億×4ビット÷8は175億バイト、十進単位で17.5GBです。アクティブ3Bだけなら1.5GBですが、全体のモデルには残りのエキスパートも必要です。実際のQ4ファイルには量子化3の補助値、メタデータ、別の精度で残す部分が加わるため、配布ファイルの実際の容量を確認します。
| 表示 | 意味 | 使う場面 |
|---|---|---|
| 全体35B | モデル全体に保存された重みの規模 | ファイルと必要メモリを調べる |
| アクティブ3B | トークンごとの計算に参加する規模 | 計算量と実行経路を理解する |
計算が少なくなると、速度に有利な条件が生まれます。
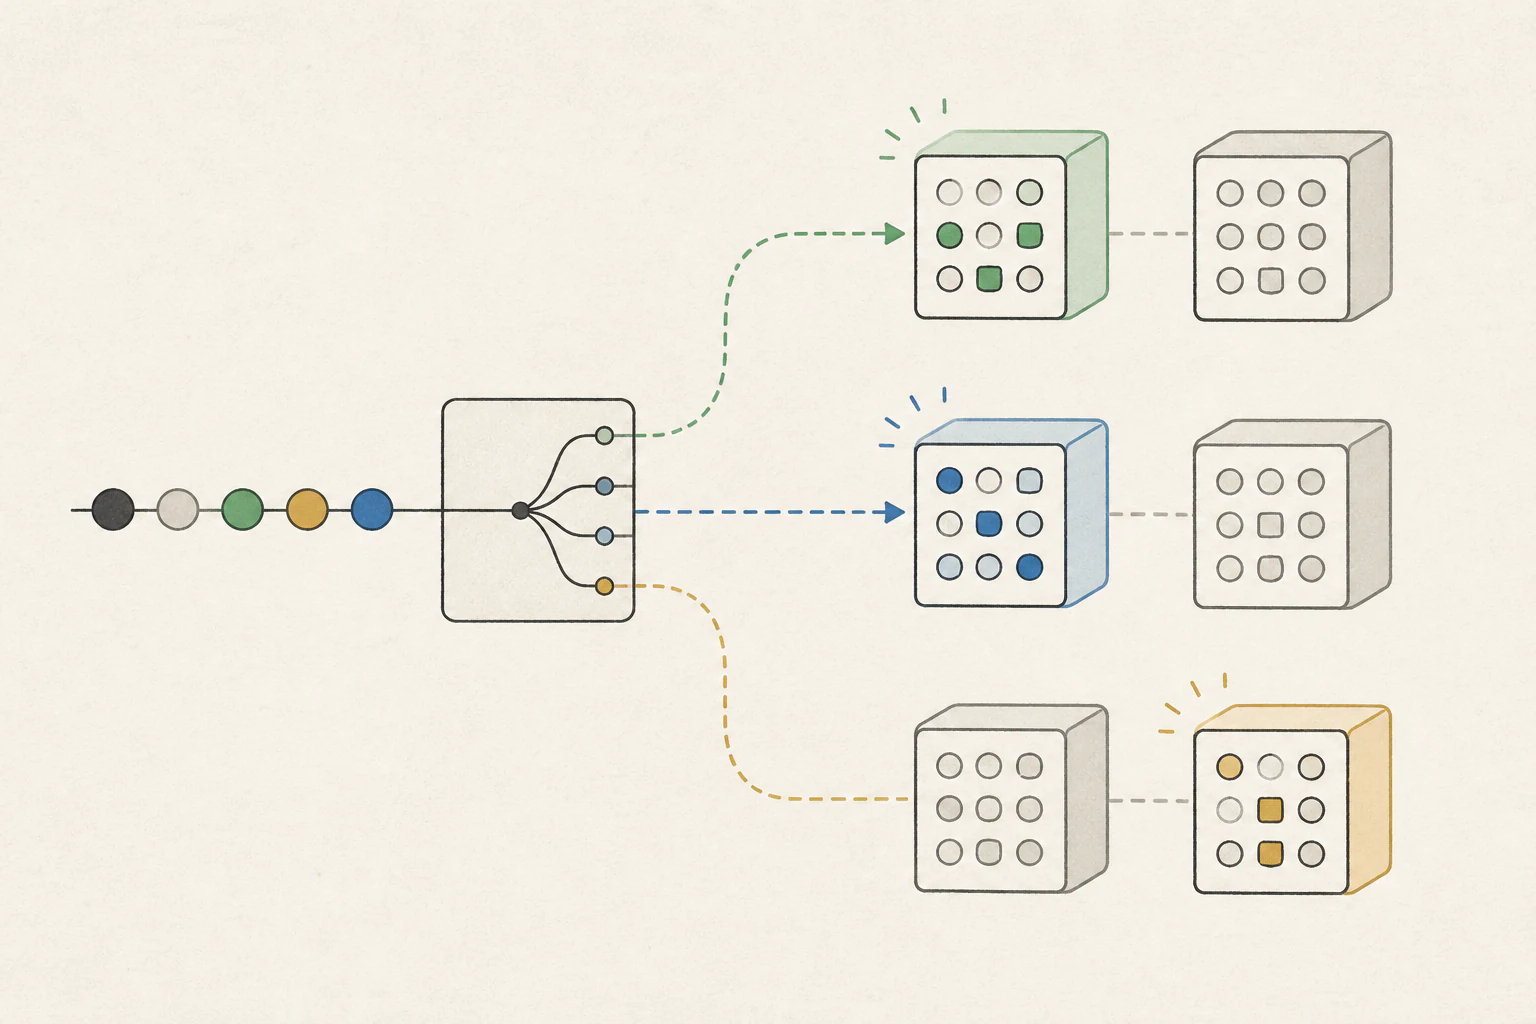
コード修正は、テストが終わるまで比較します。
たとえば、空文字列でエラーになる関数を修正してみます。2つのモデルに同じコードとエラー説明を送り、「戻り値の形式を維持して空の入力に対応して」と依頼します。通常入力、空入力、既存の呼び出し元のテストを実行すれば、求めた動作が保たれたか確認できます。
最初の返答までの時間、コードの生成速度、テストを通すまでの追加修正回数を分けて記録します。返答が速くても何度も修正が必要なら、作業全体は長くなることがあります。自分のコードで必要な結果が得られるかと待ち時間を合わせて比べると、使うモデルを選びやすくなります。
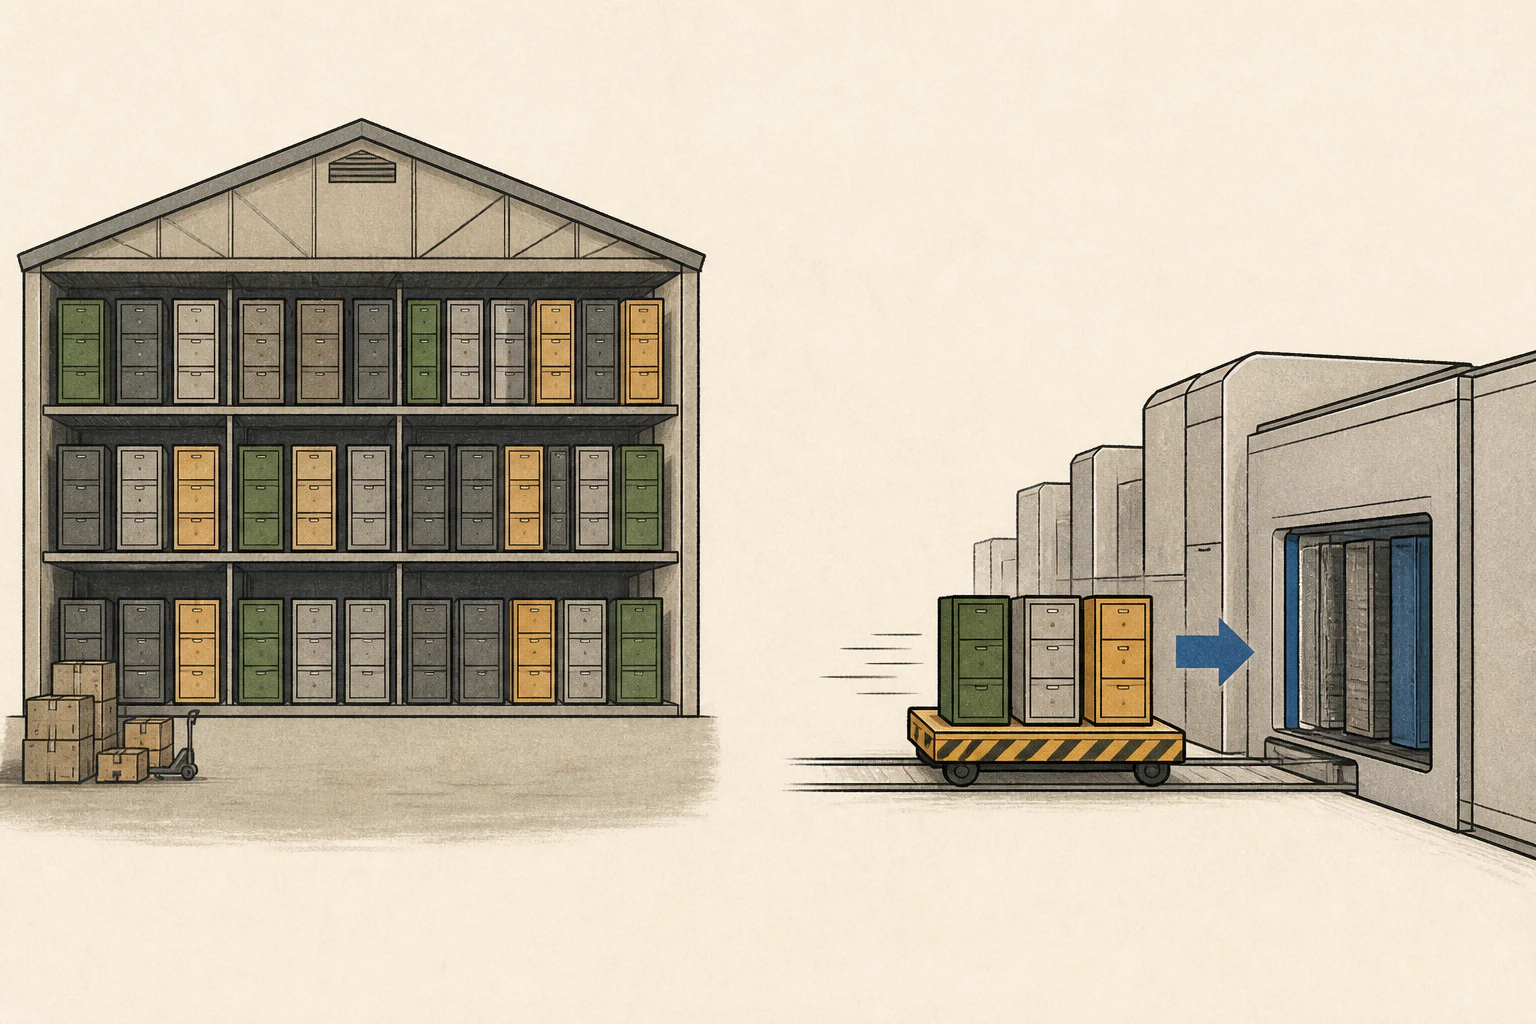
機器選びではファイル、文脈、結果の順に確認します。
用語の注釈
MoE — 複数の専門家サブネットワークから入力に応じて一部を選ぶモデル構造です。総パラメータ数と1トークン処理時に有効な数は異なることがあります。
本文に戻るトークン — モデルが入力や出力を分けて処理する単位です。
本文に戻る量子化 — モデルの重みや計算値を少ないビット数で表し、保存容量やメモリ使用量を減らす方法です。表現が粗くなるため、精度にも影響することがあります。
本文に戻るトークンのデコード — 入力とそれまでの回答をもとに、次の出力トークンを順に生成する段階です。
本文に戻るシステムRAM — プログラムの実行中にデータを一時保存するシステムメモリです。
本文に戻るオフロード — 容量が足りないとき、モデルデータの一部をGPUメモリからシステムRAMやストレージへ移して処理する方法です。データ転送が追加されます。
本文に戻るKVキャッシュ — 過去トークンのAttention用キー・バリューを保存し、後続トークン生成で再利用するメモリです。容量はコンテキスト長やバッチサイズで変わります。
本文に戻るプリフィル — LLMが入力プロンプトを読み、各トークンの内部表現を計算する段階です。プロンプトが長いほど処理するトークンが増えます。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- MoEは、複数のエキスパートブロックから一部を選んで次のトークンを計算するモデル構造です。Denseモデルは各トークンで重みの大部分を使います。MoEの「全体35B・アクティブ3B」は、保持する規模と1トークンの計算に参加する規模を分けた表示です。
- 必要なメモリはどのくらいですか?
- 実際には、ルーティング、不規則なメモリアクセス、エキスパートの負荷、実行カーネルにも時間がかかります。一部の重みをシステムRAMに置くオフロードでは、転送時間も加わります。アクティブ規模の小ささを生かすには、現在の機器でのメモリ配置とモデルの対応経路を確認します。