
メモリとモデル
最終更新
LLMの量子化:Q4・Q8・FP16をどう選ぶか
量子化でモデルを小さく保存し、メモリの負担を減らします。
LLM1の量子化2は、モデルの重みを少ないビットで表す方法です。同じ元モデルをQ4やQ8にすると、保存ファイルと実行メモリを減らせます。使うアプリ、空きメモリ、自分の作業での回答品質を合わせてファイルを選びます。
ダウンロード一覧にQ4_K_M、Q8、FP163が並んでいると、最小のファイルを選びたくなります。小さいファイルは今の機器に大きなモデルを載せるのに役立ちますが、圧縮方法によって回答や速度も変わることがあります。表示の意味を理解してから、同じ質問で候補を絞りましょう。
重みを表すビット数を減らします。
モデルは重みという数値を使って入力を処理し、次のトークン4を計算します。量子化は、その数値を少ない段階で表して小さく保存する処理です。16ビットから4ビットにすると、数値自体のビット数は4分の1になります。実際のファイルには補助値、メタデータ、高精度で残す部分もあるため、ダウンロード容量を確認します。
重みの表現が変わると、同じPDFでも回答が変わることがあります。量子化で元の値を表す段階が減るためです。容量が減って実行できる利点と、仕事に必要な情報が回答に残るかを合わせて比べます。
| 表示 | 重み表現の目安 | 検討する場面 |
|---|---|---|
| Q4 | 主に4ビット量子化 | メモリを減らしてモデルを実行する |
| Q8 | 主に8ビット量子化 | 余裕がありQ4との品質差を比較する |
| FP16 | 16ビット浮動小数点 | 高精度と必要メモリを検討する |
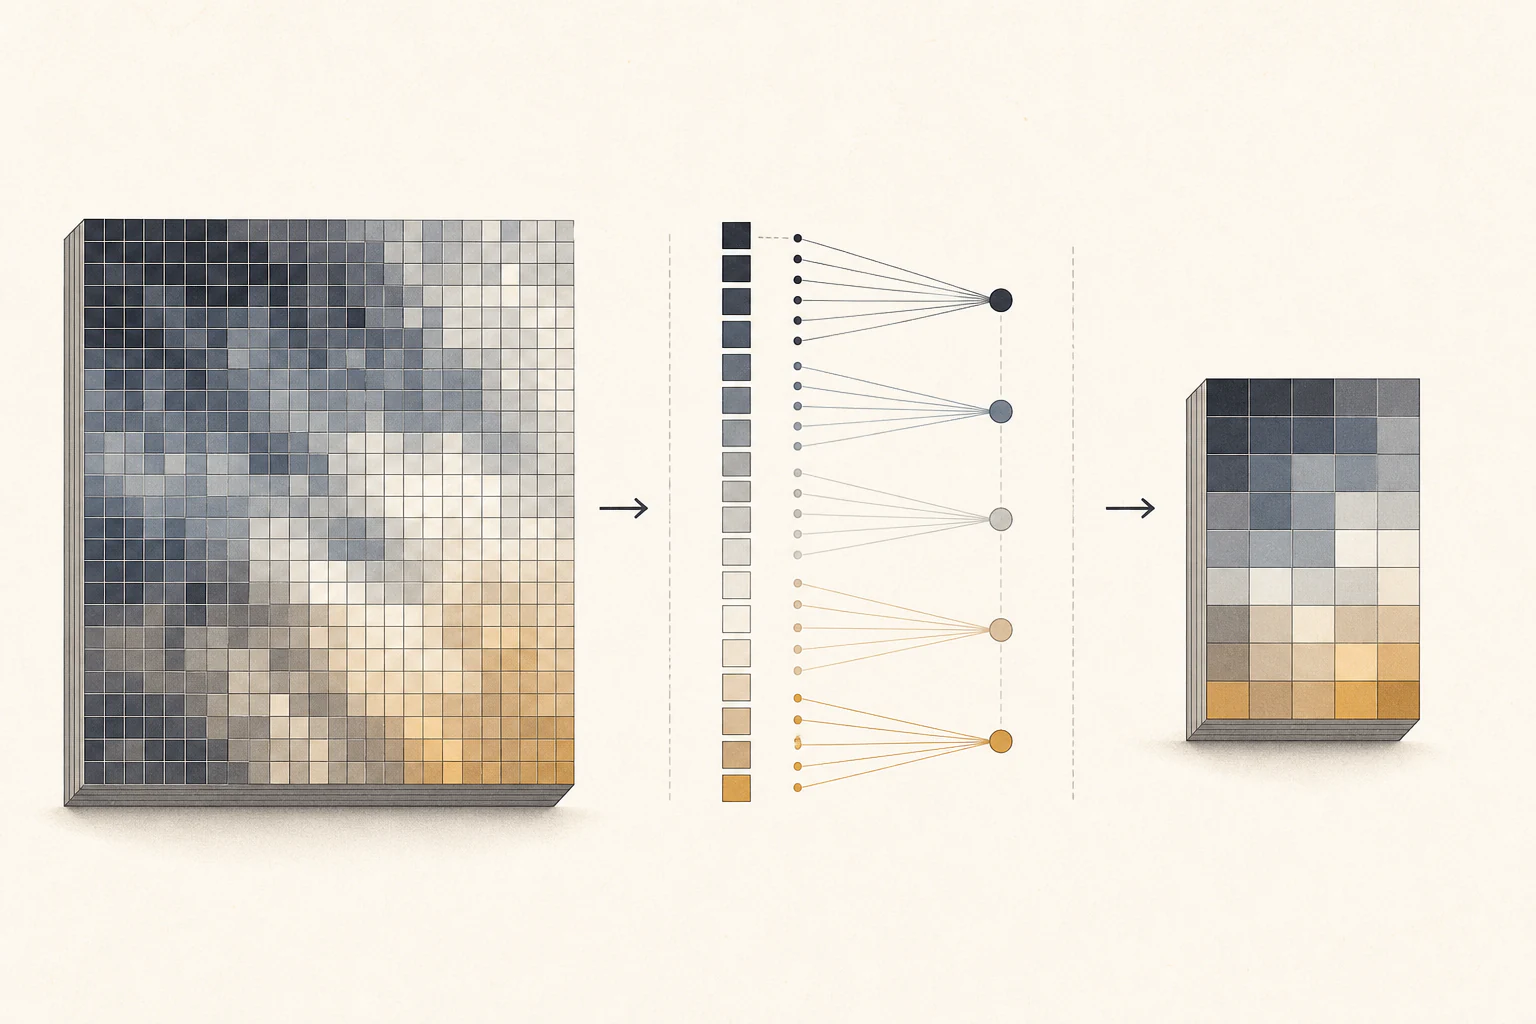
まず使うアプリに合ったファイルを選びます。
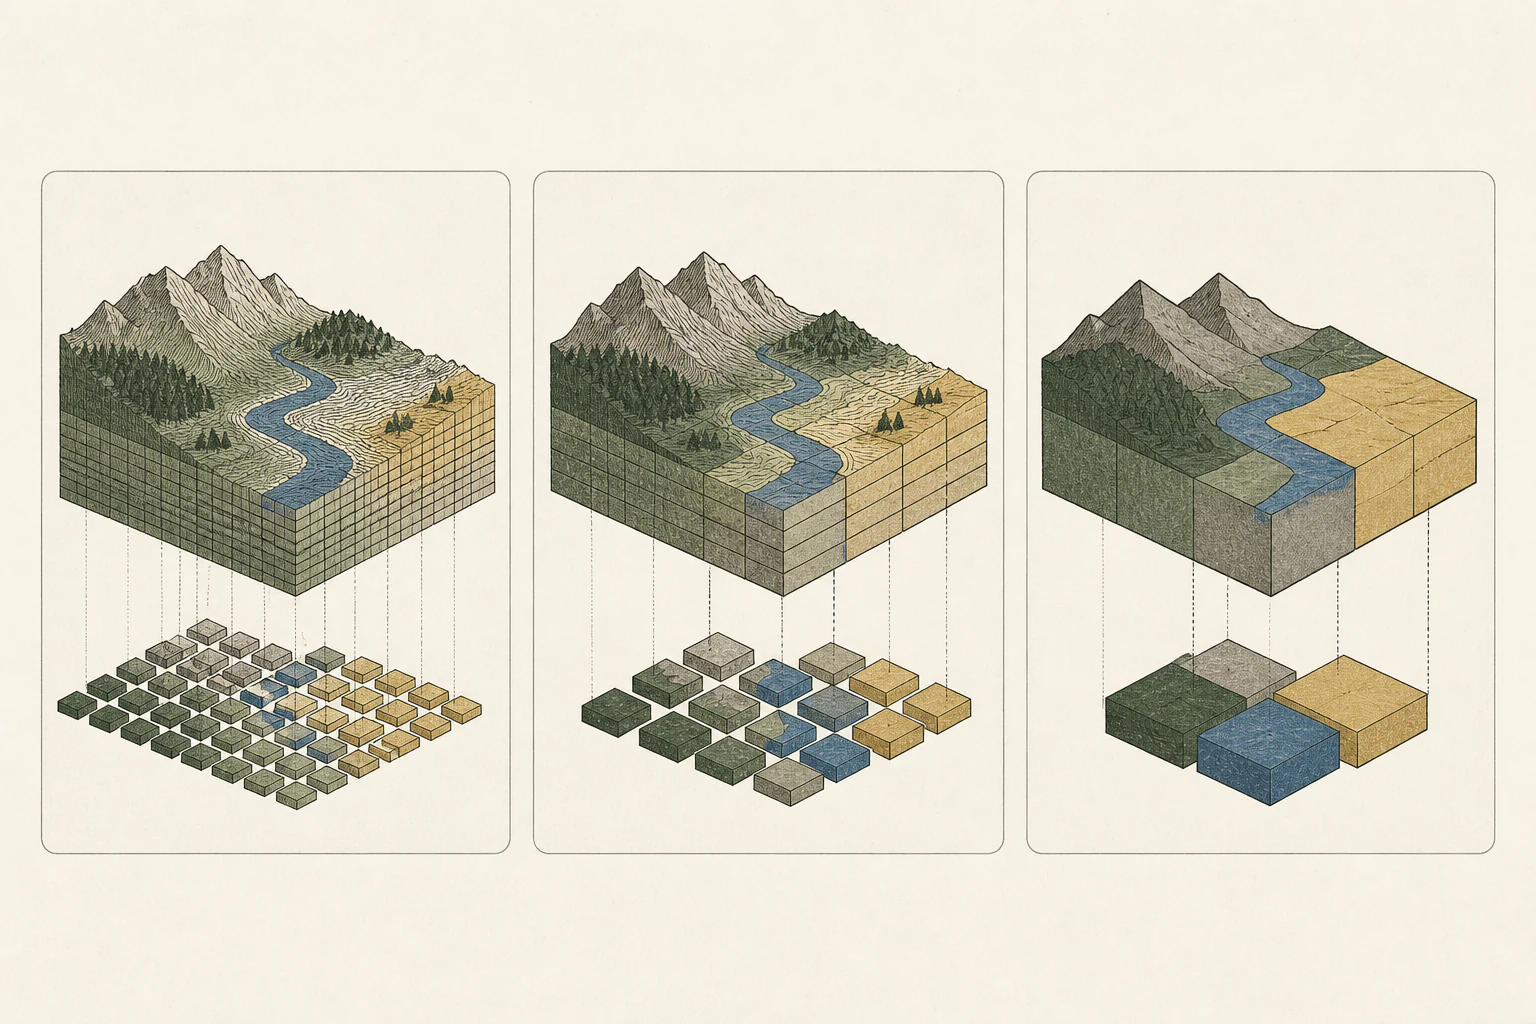
小さなファイルが実行経路を変えることもあります。
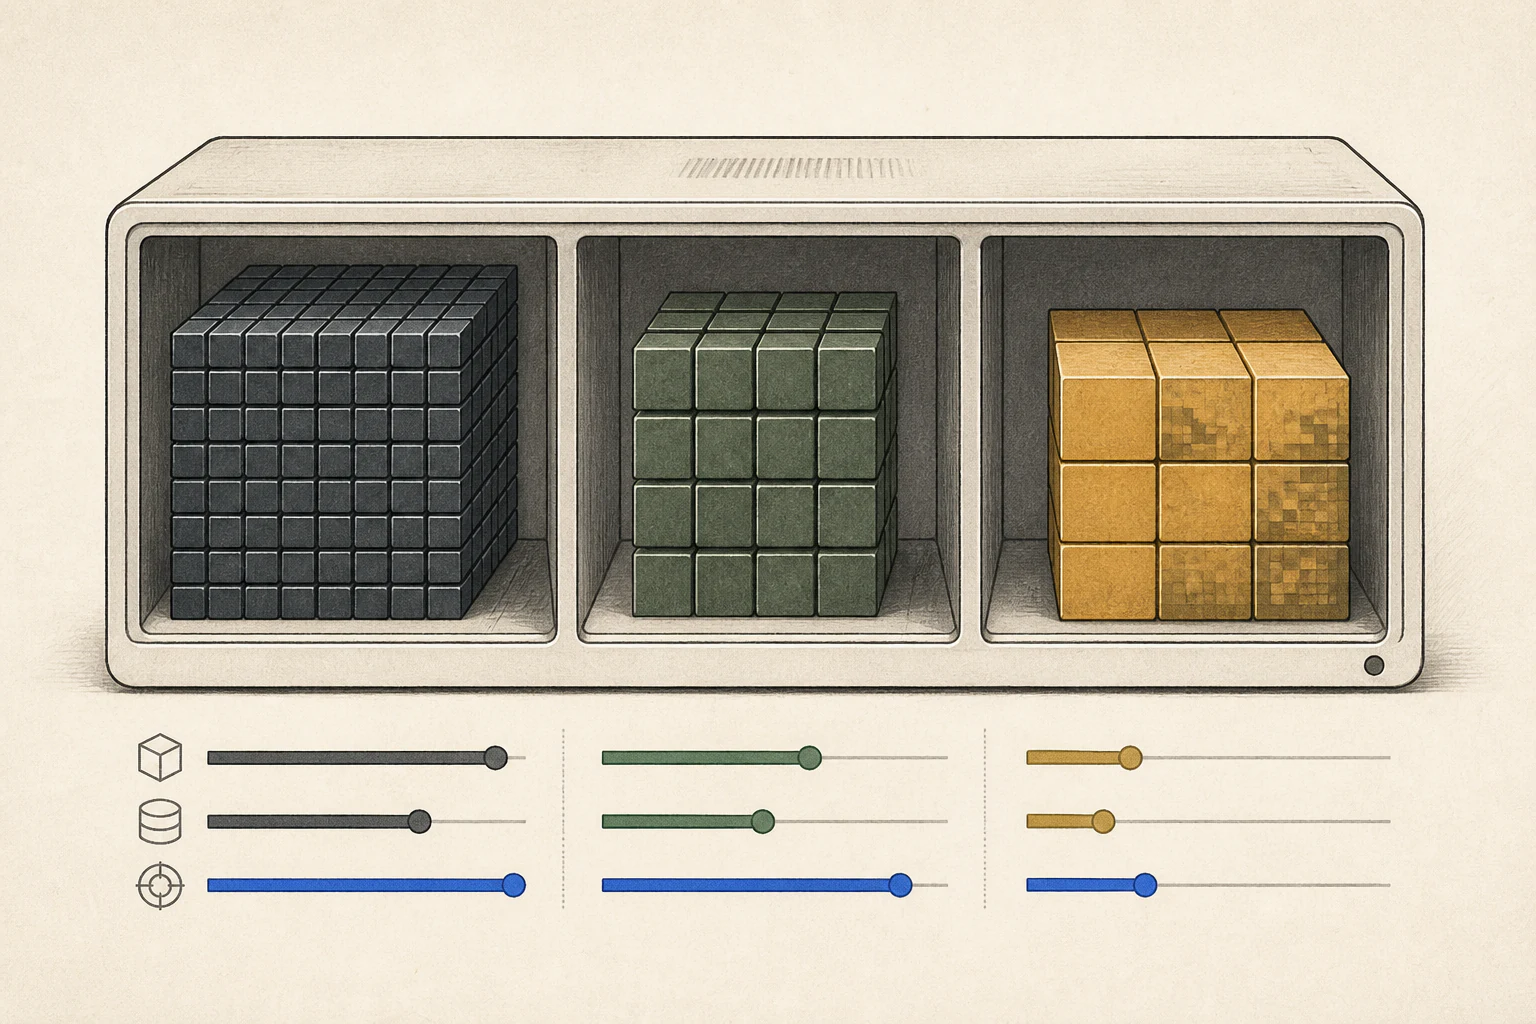
重要な質問で回答と確認時間を比較します。
契約書の更新日と自動更新の例外を調べるなら、原文で正答と根拠を先に示しておきます。同じPDFと質問をQ4とQ8に送り、日付、適用対象、例外を照合します。重み表現の差を調べるには、文書アプリが抽出する入力も同じにします。
可能ならサンプリング設定とシードも合わせ、複数の質問で繰り返します。誤った根拠、抜けた条件、答えられなかった項目を分け、人の再確認時間を記録します。Q4で必要な回答が安定するなら今の構成で始められ、重要な誤りがQ8で繰り返し減るならメモリ追加を検討する根拠になります。
重みの量子化とKVキャッシュ14の精度は1つずつ変えます。大きなQ4モデルと小さなQ8モデルでは規模と構造も変わるため、それぞれの構成で作業を終える結果と時間を比べます。最小ファイルや最大ビット数より、作業が安定して終わる構成を選ぶことが目標です。
用語の注釈
大規模言語モデル — 大量のテキストデータから言語パターンを学び、文脈に沿ったテキストを処理・生成するモデルです。
本文に戻る量子化 — モデルの重みや計算値を少ないビット数で表し、保存容量やメモリ使用量を減らす方法です。表現が粗くなるため、精度にも影響することがあります。
本文に戻るFP16 — 16ビット浮動小数点形式です。BF16とビット幅は同じですが、指数部と仮数部の配分が異なります。
本文に戻るトークン — モデルが入力や出力を分けて処理する単位です。
本文に戻るGGUF — モデル情報を格納するファイル形式で、llama.cpp系のツールで広く使われます。
本文に戻るMLX — Appleが開発する機械学習フレームワークで、Apple SiliconのCPUとGPUが共有するメモリを使ってモデルを実行します。
本文に戻るMTP — 複数の将来トークンを一度に予測する学習目標、またはそれを行うモデル構成です。投機的デコーディングでは、その予測を候補トークンとして提案できます。
本文に戻るVRAM — グラフィックカードのGPUが使うメモリです。モデルの重みや計算途中の値を保存します。
本文に戻るシステムRAM — プログラムの実行中にデータを一時保存するシステムメモリです。
本文に戻るGPU — 多くの計算を並列に処理するプロセッサーです。AIモデルの実行ではモデル計算を担います。
本文に戻るオフロード — 容量が足りないとき、モデルデータの一部をGPUメモリからシステムRAMやストレージへ移して処理する方法です。データ転送が追加されます。
本文に戻るプリフィル — LLMが入力プロンプトを読み、各トークンの内部表現を計算する段階です。プロンプトが長いほど処理するトークンが増えます。
本文に戻るトークンのデコード — 入力とそれまでの回答をもとに、次の出力トークンを順に生成する段階です。
本文に戻るKVキャッシュ — 過去トークンのAttention用キー・バリューを保存し、後続トークン生成で再利用するメモリです。容量はコンテキスト長やバッチサイズで変わります。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- LLMの量子化は、モデルの重みを少ないビットで表す方法です。同じ元モデルをQ4やQ8にすると、保存ファイルと実行メモリを減らせます。使うアプリ、空きメモリ、自分の作業での回答品質を合わせてファイルを選びます。
- 必要なメモリはどのくらいですか?
- 可能ならサンプリング設定とシードも合わせ、複数の質問で繰り返します。誤った根拠、抜けた条件、答えられなかった項目を分け、人の再確認時間を記録します。Q4で必要な回答が安定するなら今の構成で始められ、重要な誤りがQ8で繰り返し減るならメモリ追加を検討する根拠になります。