
実行プログラムと拡張機能
最終更新
GGUFとMLX、ダウンロードするモデル形式の選び方
GGUFとMLXはファイルだけでなく実行経路も異なります
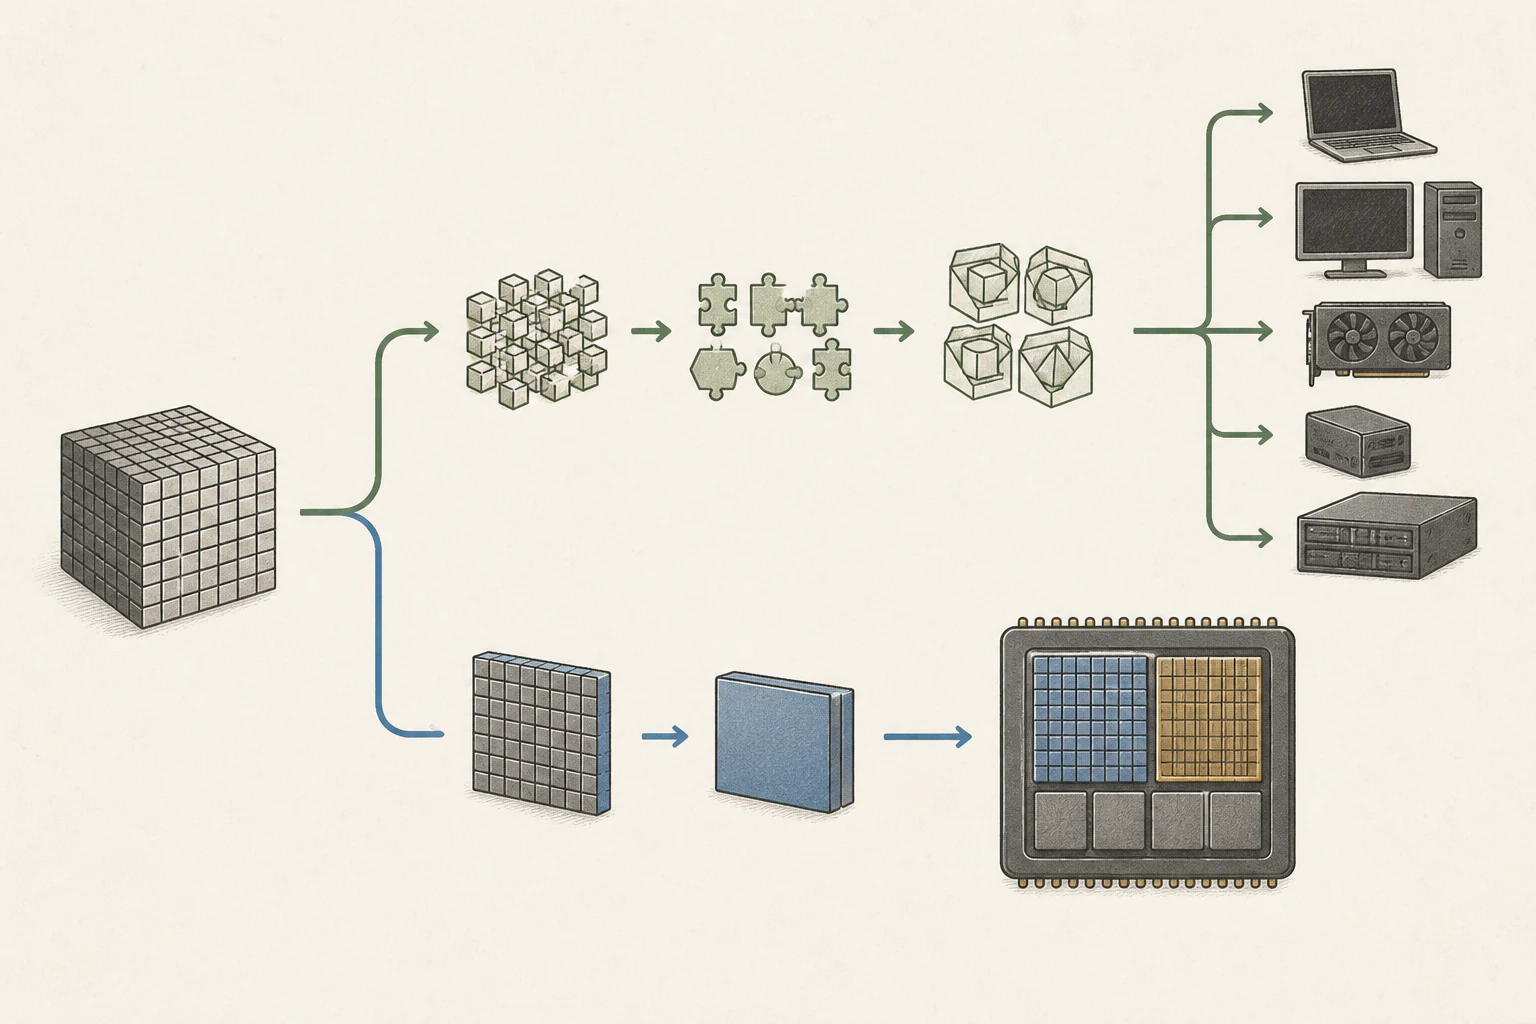
GGUF1はモデルの重みと設定を収めるファイル形式で、MLX2はApple Siliconでモデルを実行するフレームワークです。配布ページの「MLXモデル」は、そのフレームワーク用に変換した重みと設定を指します。先に使うアプリを決めると、どの配布版をダウンロードすべきか選びやすくなります。
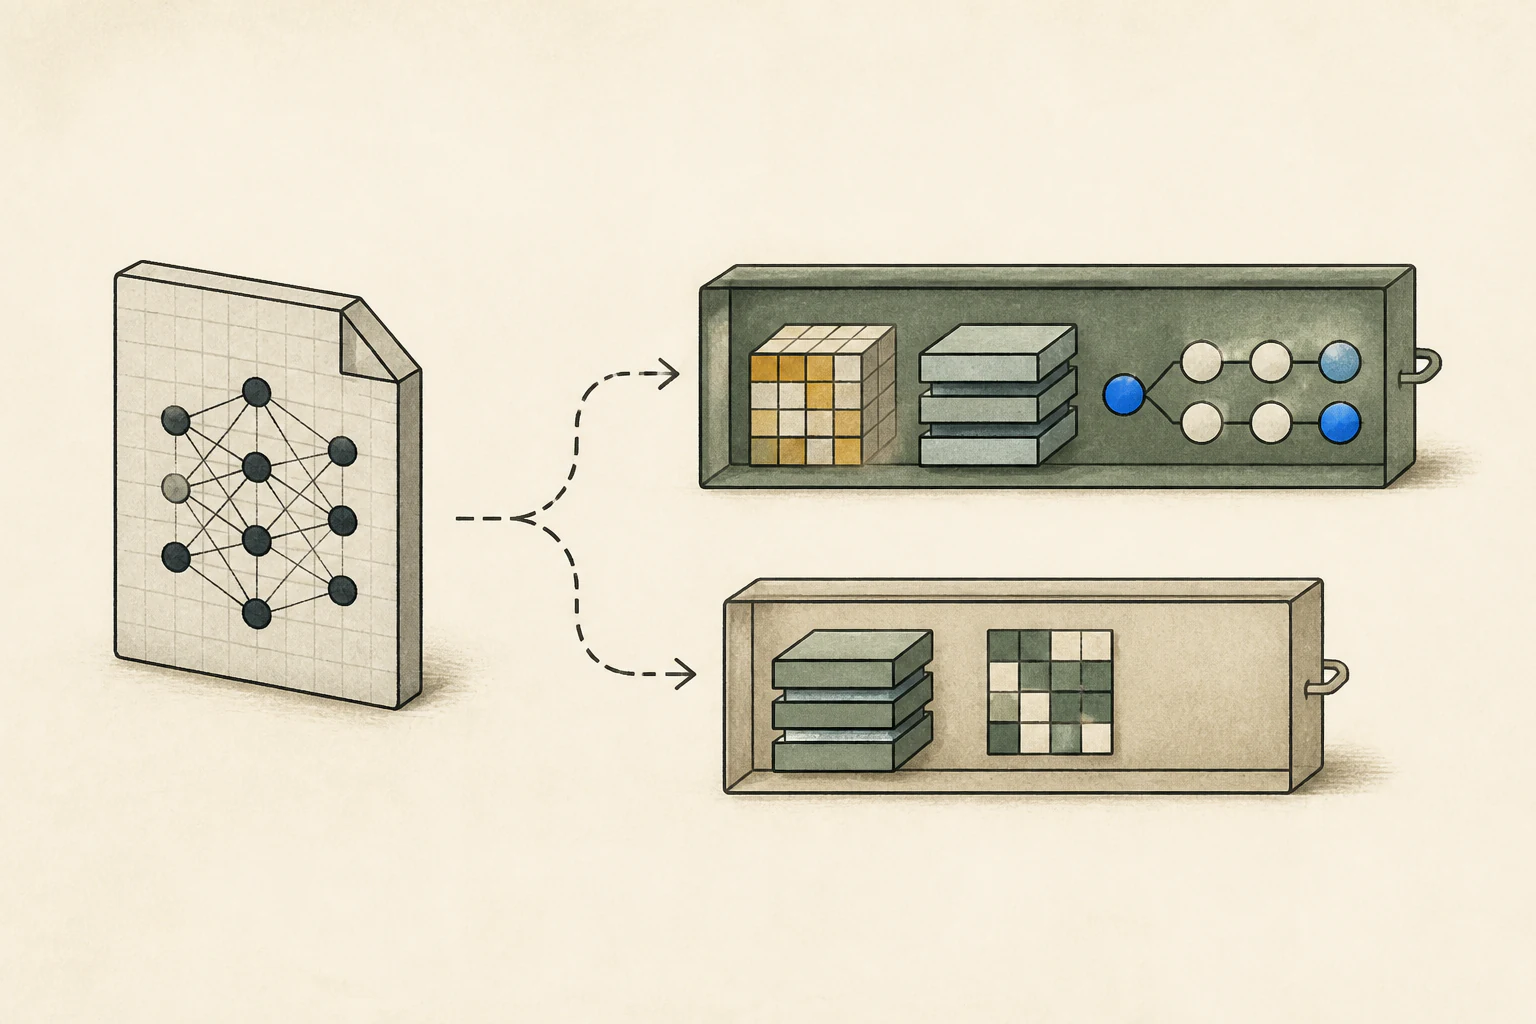
契約PDFから更新日や自動更新の例外を探すためにモデルを取得すると、同じ名前の下にGGUFファイルとMLX用フォルダーが並ぶことがあります。実行プログラムは重みだけでなくモデル構造やトークン3化方式も理解する必要があるため、ファイルを選ぶ前にアプリがその配布版に対応しているか確認します。
GGUFコンテナーとMLX配布経路を区別
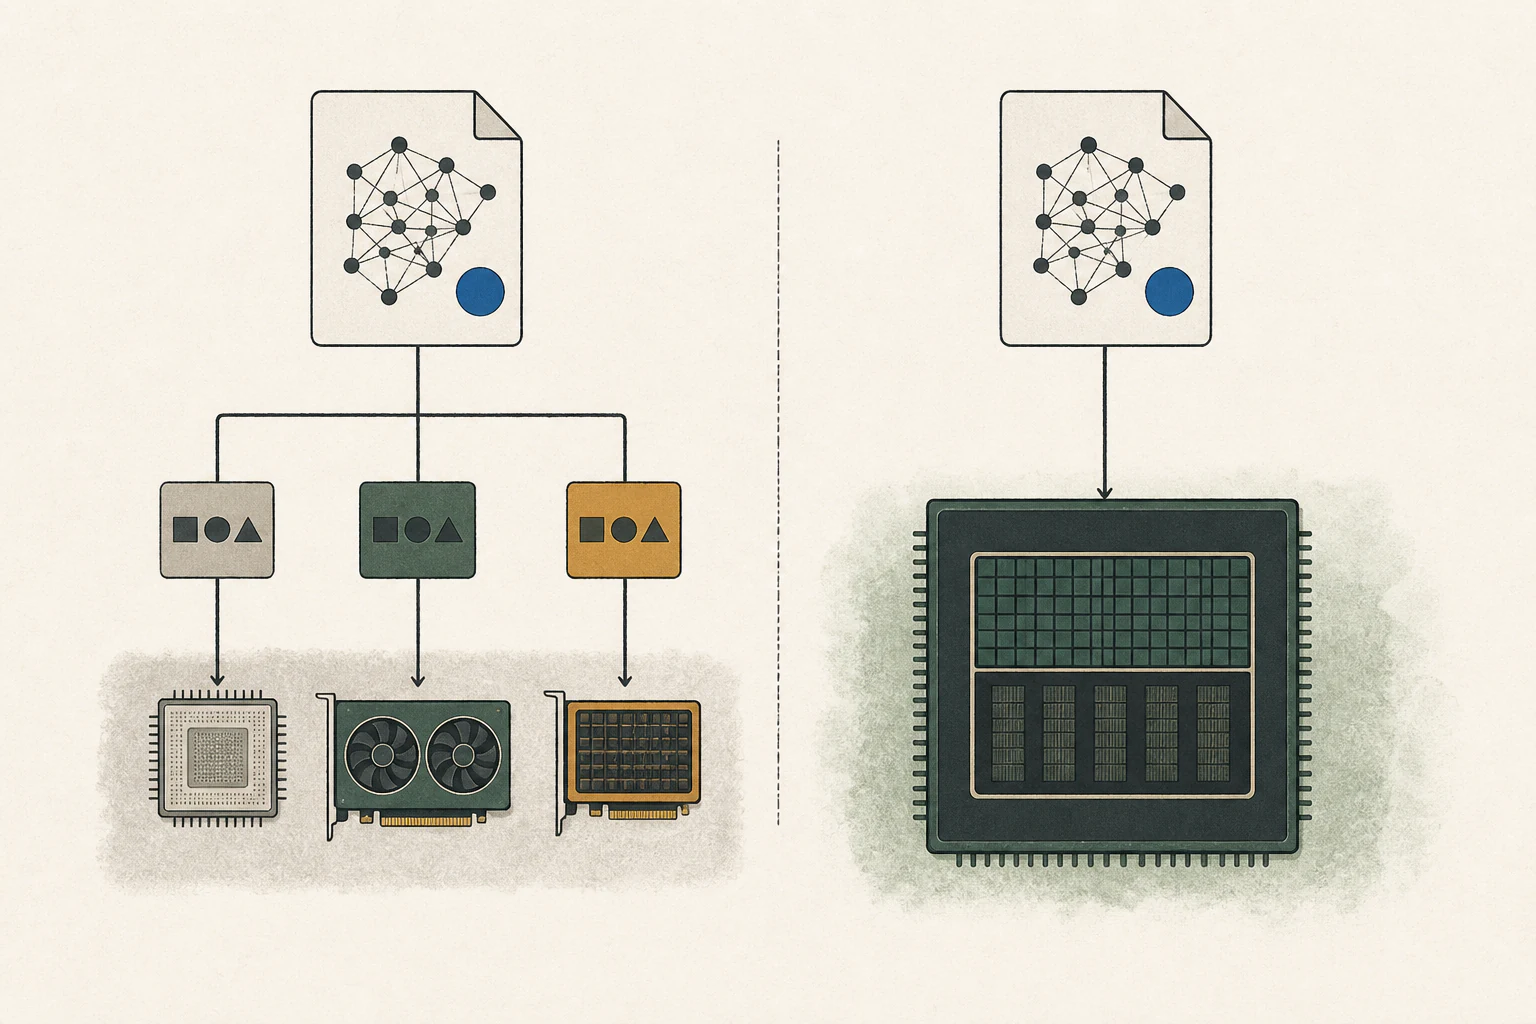
GGUFは重みやメタデータなどを格納するGGML・llama.cpp系コンテナーです。.gguf拡張子だからといって新しいモデル構造すべてに自動対応するわけではなく、ランタイム4が内部構造と必要な構成要素を理解する必要があります。読み込みに失敗した場合は拡張子だけでなく、そのランタイム版のモデル別対応条件を確認します。
MLX配布版はApple SiliconのMLX環境で使うようモデルファイルと設定を整えます。同じ種類の拡張子同士の比較ではなく、異なる実行環境向けの配布経路を比べています。フォルダー名や拡張子を変えるだけでは変換されません。
ダウンロード前にアプリとファイル構成を確認
実際に使うアプリの設定やモデル追加画面でランタイムを確認します。Windows・Linuxのllama.cppアプリなら対応GGUFが自然な選択で、MacのMLXベースアプリなら推奨MLX配布版を確認します。MacでもGGUFを使えるため、OSだけで決めないでください。
GGUFが複数分割されている場合は必要なファイルをすべて取得します。MLXフォルダーには設定・トークナイザー・重みが揃っているか確認します。ダウンロード完了と分割ファイルの欠落を調べ、チェックサムがあれば照合し、似た名前の量子化5版を混ぜないよう一覧とローカルファイル名を比べます。
アプリにモデルを登録したら、簡単なテキスト質問と契約書入力を順に試します。ファイル名・アプリとランタイムのバージョン・選択経路を記録すると、エラー箇所を絞り込みやすくなります。
量子化表記と実行形式を分けて比較
GGUFとMLXの配布版はいずれも複数の精度で提供される場合があります。Q4や4-bitは量子化表記であり、ファイル形式ではありません。同じビット幅でも方式が異なることがあり、ファイルサイズ・品質・速度が同じとは限りません。
可能なら同じベースモデルと近い精度を使い、同じ契約書・質問・アプリ入力で比較します。最初のトークンまでの時間・生成時間・メモリ・根拠の正確さを記録します。モデル名とtok/sだけでは、初回応答・生成・量子化のどれが差の原因か分かりにくくなります。
チャットテンプレートは役割や指示をモデル入力にどう表現するかに影響します。配布版ごとに異なるテンプレートが適用されると、入力欄に同じ文を入れても実際の入力は異なることがあります。ランタイム比較ではテンプレートを確認し、揃えられない差は記録します。ファイル読込・構造解釈・カーネル選択・メモリ配置も実行経路の一部なので、結果をファイル形式だけの効果とは言えません。
テキスト応答の後に必要機能を個別に試す
「更新日はいつですか」という回答だけでは、PDF処理やすべての実行機能を確認したことにはなりません。アプリがPDFテキストを抽出してモデルに渡すか、画像入力・ツール呼び出し6・MTP7など追加対応が必要な機能が動くかを個別に試します。関連する重みが含まれていてもランタイムが構造や機能に対応していないことがあります。
まず通常のテキスト質問でモデルが読み込まれて応答するか確認し、その後必要な機能を一つずつ試します。テキストは動いてもPDFの表を読めない場合、文書抽出や入力形式が原因かもしれません。通常の質問から失敗する場合は、モデル構造の対応とファイル構成を確認します。分割重みの全取得や別エンコーダーの要否など、失敗段階とログを調べてから正常な可能性のあるファイルを再取得します。
契約書から必要な根拠を得られるかで選ぶ
GGUFとMLXのどちらかがあらゆる機器で優れているわけではありません。実際のアプリで安定して開けるか、契約PDFに必要な機能が動くかを確認してから、同じ文書と質問で品質・最初のトークンまでの時間・生成時間・メモリを比較します。画面やログで選択されたランタイムも記録します。
一方が少し遅くても日付や例外を正確に見つけ、他方が根拠を逃すなら、現時点では作業を完了できる構成が目的に合います。文書抽出を改善した後で高速な経路を再試験できます。両方が根拠を正確に見つけるなら、待ち時間・メモリ・アプリの使いやすさで決めます。
動作する組み合わせが見つかったらファイルとアプリ・ランタイムのバージョンを記録し、更新後も同じ質問で比較できるようにします。判断基準は拡張子やファイルサイズだけでなく、モデルを読み込み必要な機能で文書を正確に処理できるかです。
用語の注釈
GGUF — モデル情報を格納するファイル形式で、llama.cpp系のツールで広く使われます。
本文に戻るMLX — Appleが開発する機械学習フレームワークで、Apple SiliconのCPUとGPUが共有するメモリを使ってモデルを実行します。
本文に戻るトークン — モデルが入力や出力を分けて処理する単位です。
本文に戻るランタイム — プログラムの実行時に必要な機能を提供するソフトウェア環境です。ローカルAIではモデル実行エンジンを指すこともあります。
本文に戻る量子化 — モデルの重みや計算値を少ないビット数で表し、保存容量やメモリ使用量を減らす方法です。表現が粗くなるため、精度にも影響することがあります。
本文に戻るツール呼び出し — ファイル読み取り、検索、コマンド実行などの外部機能を、名前と引数でモデルが要求する形式です。実行の有無はエージェントランタイムと権限設定が決めます。
本文に戻るMTP — 複数の将来トークンを一度に予測する学習目標、またはそれを行うモデル構成です。投機的デコーディングでは、その予測を候補トークンとして提案できます。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- GGUFはモデルの重みと設定を収めるファイル形式で、MLXはApple Siliconでモデルを実行するフレームワークです。配布ページの「MLXモデル」は、そのフレームワーク用に変換した重みと設定を指します。先に使うアプリを決めると、どの配布版をダウンロードすべきか選びやすくなります。
- 必要なメモリはどのくらいですか?
- 可能なら同じベースモデルと近い精度を使い、同じ契約書・質問・アプリ入力で比較します。最初のトークンまでの時間・生成時間・メモリ・根拠の正確さを記録します。モデル名とtok/sだけでは、初回応答・生成・量子化のどれが差の原因か分かりにくくなります。