
応答速度と加速
最終更新
SpecPrefillで最初のトークンまでの待ち時間を短くする
長い入力から必要なトークンを選び、回答開始を早める
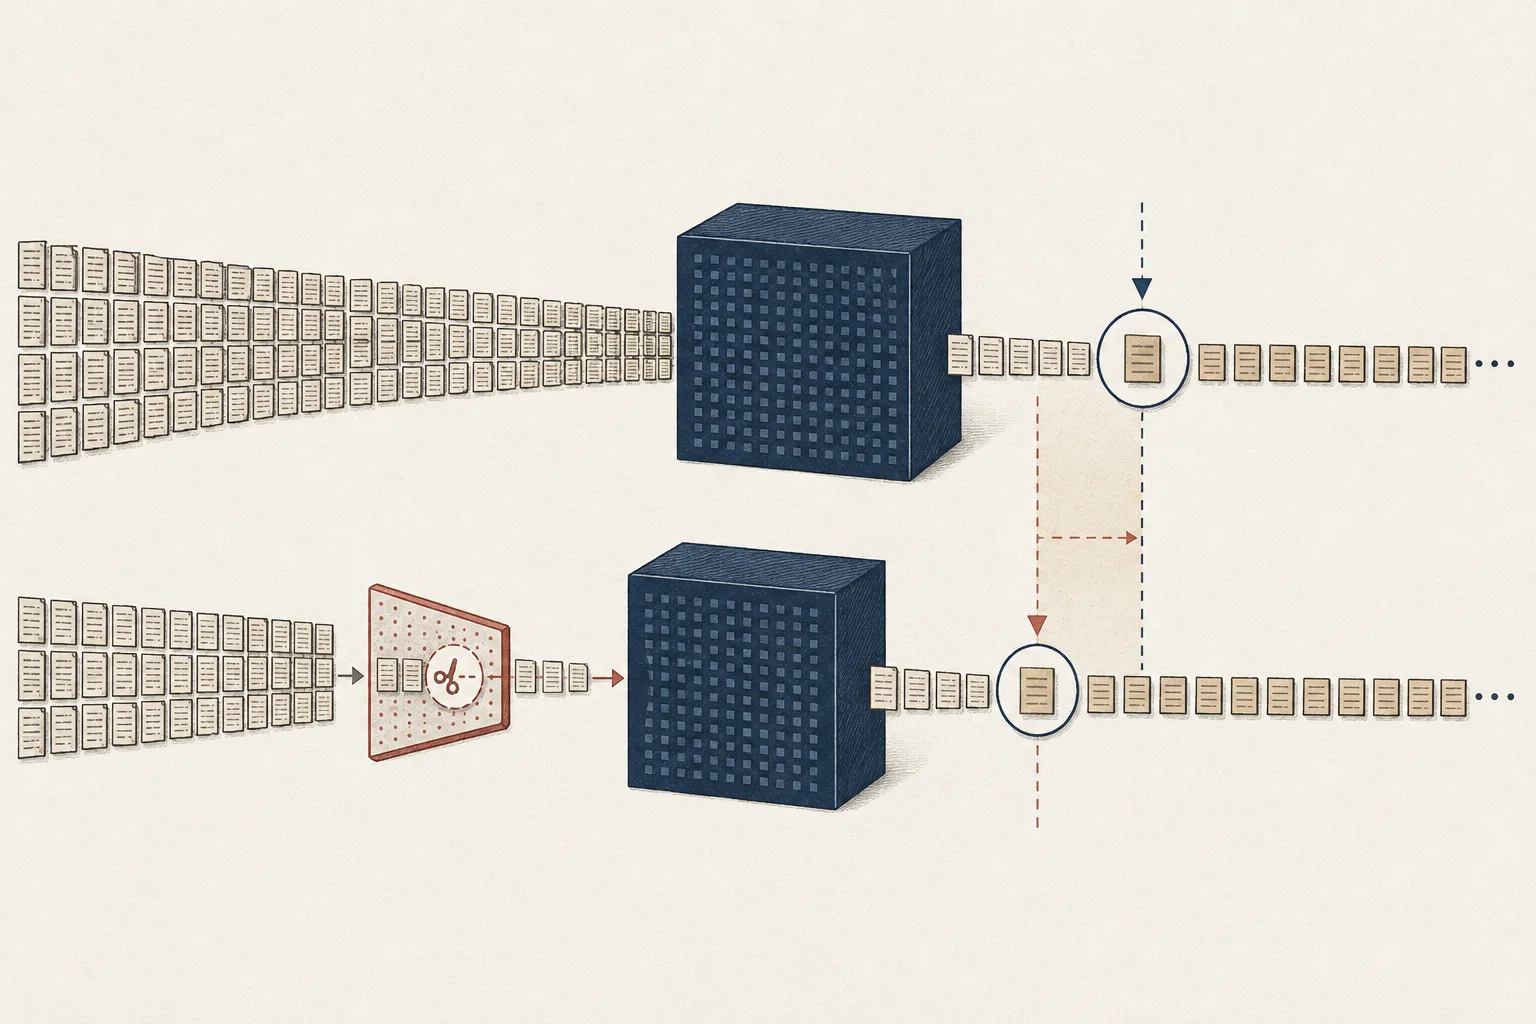
SpecPrefill1は、小さいモデルなどを使って長い入力から本モデルが処理するトークン2を選ぶ実験的な最適化です。入力処理を減らして最初のトークンまでの待ち時間を短縮します。リポジトリや長い文書で、選別時間と回答結果を併せて比較します。
コードとエラーログを渡すと、モデルはコードを書く前に入力を読みます。このプリフィル3に時間がかかる作業でSpecPrefillを試せます。選別の処理が加わるため、短い質問より長い入力を繰り返す用途を比較します。
入力を選んでから本モデルに渡す
空の入力を処理する修正には、関数本体、失敗した呼び出し元、既存テストが必要です。SpecPrefillは本モデルの前にトークン選別を置きます。それらが残っていれば関数と呼び出し元の関係を検討できます。
効果は、本モデルの処理短縮から選別時間を差し引いた分です。短い質問では減らせる入力が少ない場合があります。本モデルと下書きの準備時間も分け、依頼時の準備状態を合わせます。
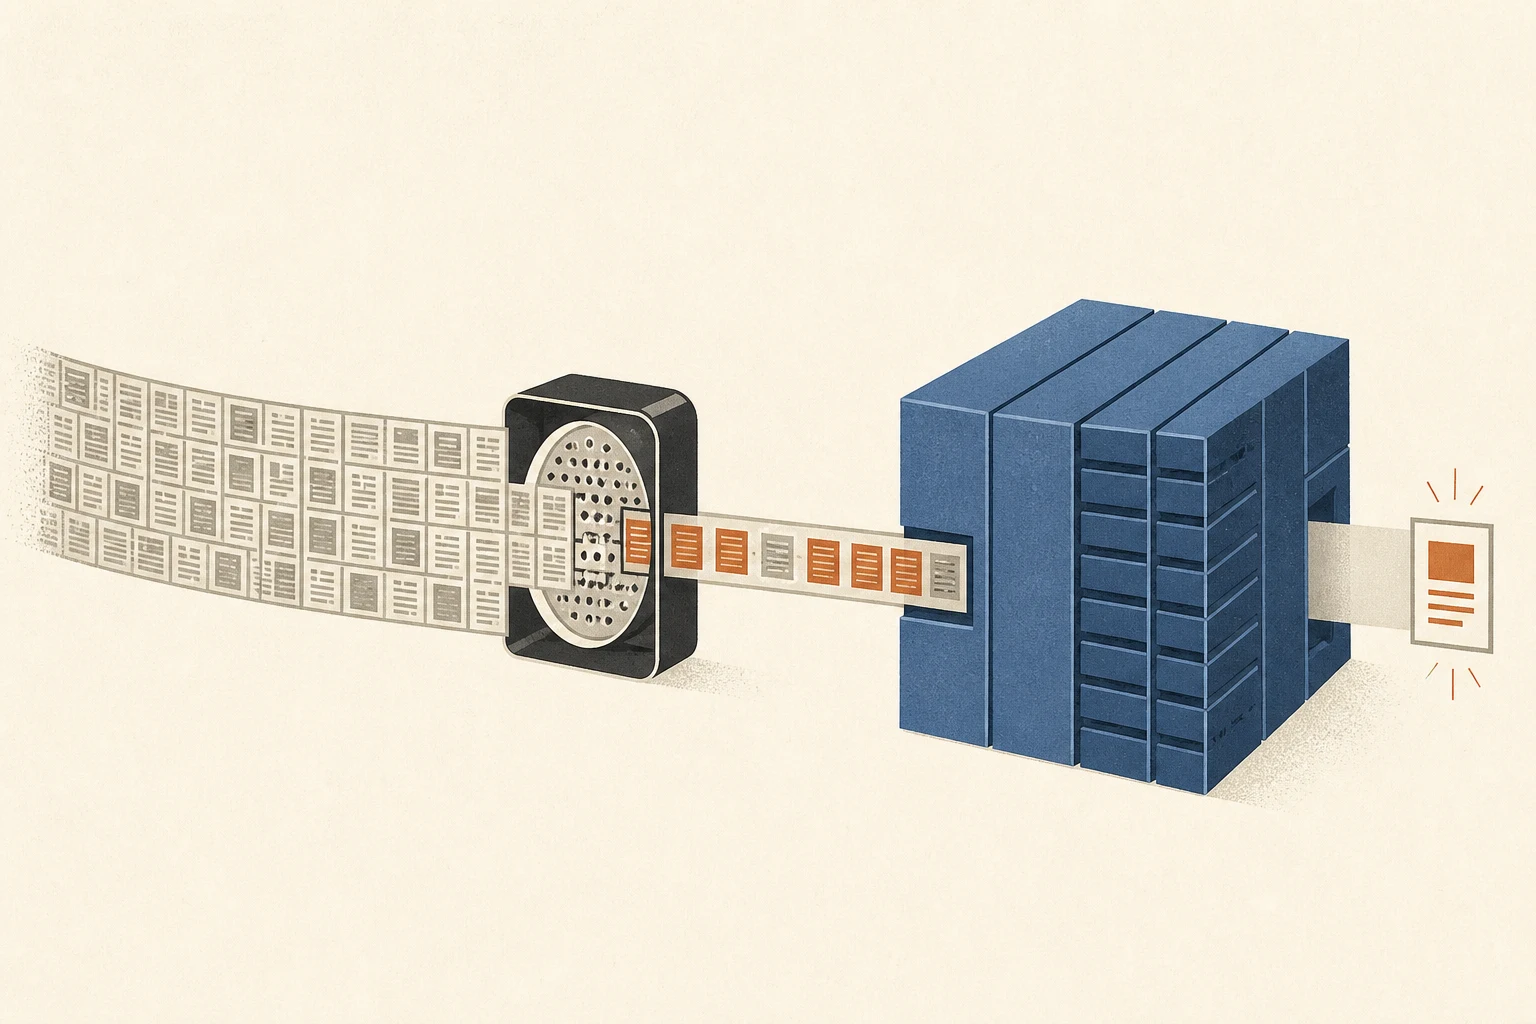
キャッシュと生成加速は別の区間を担当する
MacではoMLXの下書き・MTP構成を合わせる
oMLXのSpecPrefill用下書きは本モデルと同じトークナイザーを使う必要があります。対応する組み合わせで短い依頼を確認し、長い入力を試します。似たモデル名でも実装が異なるため、設定説明と依頼ログを確認します。
native MTPと統合Gemma assistantのLightning経路は、SpecPrefillとは別に設定できます。外部assistantを使うVLM MTP経路とは同時実行できません。SpecPrefill単独を試してから、対応するMTPを追加して生成も比較します。
サイトのMac体験値はおおまかな推定です。未確認のNVIDIA本モデル・下書き構成には倍率を適用しません。実行ツールの対応と同じ依頼の結果で選びます。
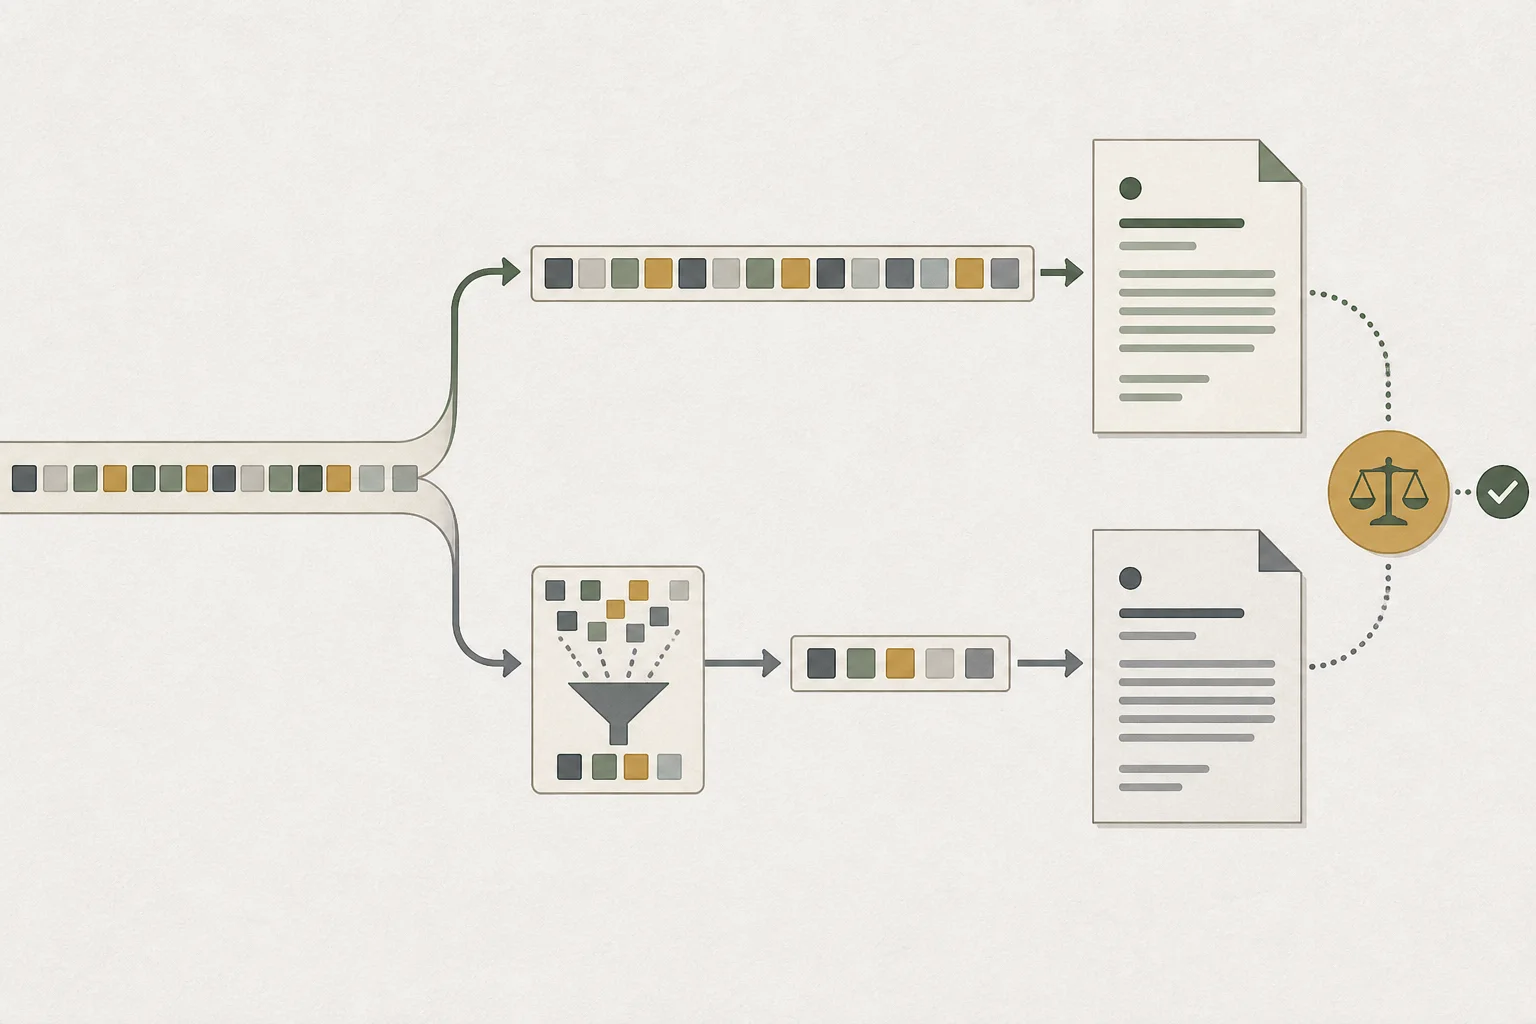
時間と回答結果を一緒に比較する
表は説明用の仮定です。基本実行はプリフィル30秒、生成20秒、確認10秒で計60秒です。選別でプリフィルを減らしても、欠落コードの確認が増えると作業全体は同じ場合があります。読み込み時間は表に含めません。
| 区間 | 基本実行 | SpecPrefill例 |
|---|---|---|
| 入力選別 | 0秒 | 5秒 |
| 本モデルのプリフィル | 30秒 | 15秒 |
| 回答の生成 | 20秒 | 20秒 |
| コード確認 | 10秒 | 20秒 |
| 総作業時間 | 60秒 | 60秒 |
同じ修正依頼で通常文字列と空文字列の返り値、呼び出し元の期待値を比べます。対象が入力の先頭・中央・末尾にある場合も試すと欠落を探せます。選別トークンを表示できる実行ツールでは、残った範囲も直接確認します。
必要な根拠を保てる用途で使う
ファイル探索なら人が候補を開き直せます。すぐ適用する修正は呼び出し元やインターフェースの欠落による影響が大きくなります。同じ選別設定を一律に使わず、代表的な依頼をテストと確認まで完了します。
回答開始が早まり結果も維持できる用途で使います。欠落があれば選別を調整するか基本実行に戻して再比較します。検証した本モデル・下書き構成から広げると、待ち時間の短縮と結果確認を両立できます。
用語の注釈
SpecPrefill — 軽量モデルで入力トークンの重要度を推定し、選んだトークンをメインモデルへ渡してプリフィル計算を減らす手法です。メインモデルが読まない文脈が生じるため、トークン選択によって回答に反映される情報が変わります。
本文に戻るトークン — モデルが入力や出力を分けて処理する単位です。
本文に戻るプリフィル — LLMが入力プロンプトを読み、各トークンの内部表現を計算する段階です。プロンプトが長いほど処理するトークンが増えます。
本文に戻るプロンプト — モデルに送る入力文です。生成モデルでは作りたい結果を説明する文になり、出力の構成や内容を大きく左右します。
本文に戻るMTP — 複数の将来トークンを一度に予測する学習目標、またはそれを行うモデル構成です。投機的デコーディングでは、その予測を候補トークンとして提案できます。
本文に戻る最初のトークンまでの時間 — リクエスト送信から最初の出力トークンが届くまでの時間です。
本文に戻るトークンのデコード — 入力とそれまでの回答をもとに、次の出力トークンを順に生成する段階です。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- SpecPrefillは、小さいモデルなどを使って長い入力から本モデルが処理するトークンを選ぶ実験的な最適化です。入力処理を減らして最初のトークンまでの待ち時間を短縮します。リポジトリや長い文書で、選別時間と回答結果を併せて比較します。