
応答速度と加速
最終更新
長い入力ではローカルLLMの速度順位が逆転する
長文書では生成速度と完了時間の順位が異なることがあります
言語モデルは文章を入力として受け取り、内容を処理してから回答を生成します。decode1 tok/sが2倍の機器でも、長文で最初のtoken2前の待ちが長ければ要約完了が遅れる場合があります。16Kの議事録と300tokenの回答を例に、prefill3待ちと生成時間を合計して完了時刻を比較します。
議事録を数段落に要約する場合、利用者は最後の文が表示されるまで待ちます。この時間には文書を読む最初のtoken前の待ちと要約生成の両方が含まれます。機器表によくあるtok/sは回答開始後の生成だけを示し、全体完了時間とは異なります。
短い質問ではdecodeの速い機器が先に終わります
同じモデルで約300tokenの回答を作ると仮定します。仮想機器Aは最初のtokenまで4秒、その後60 tok/s、Bは6秒と30 tok/sです。これは計算の仕組みを示す仮定で、製品測定値ではありません。
生成区間だけならAは300÷60で約5秒、Bは300÷30で約10秒です。最初のtokenまでの待ちを加えるとAは約9秒、Bは約16秒となり、この短い作業ではAが先に終わります。生成速度が2倍でも全体完了は正確に半分にはなりません。
この説明用計算はtoken速度一定、モデル読み込みとqueueなしと仮定しています。最初のtokenまでの待ちはdecode速度とは別に加算しています。
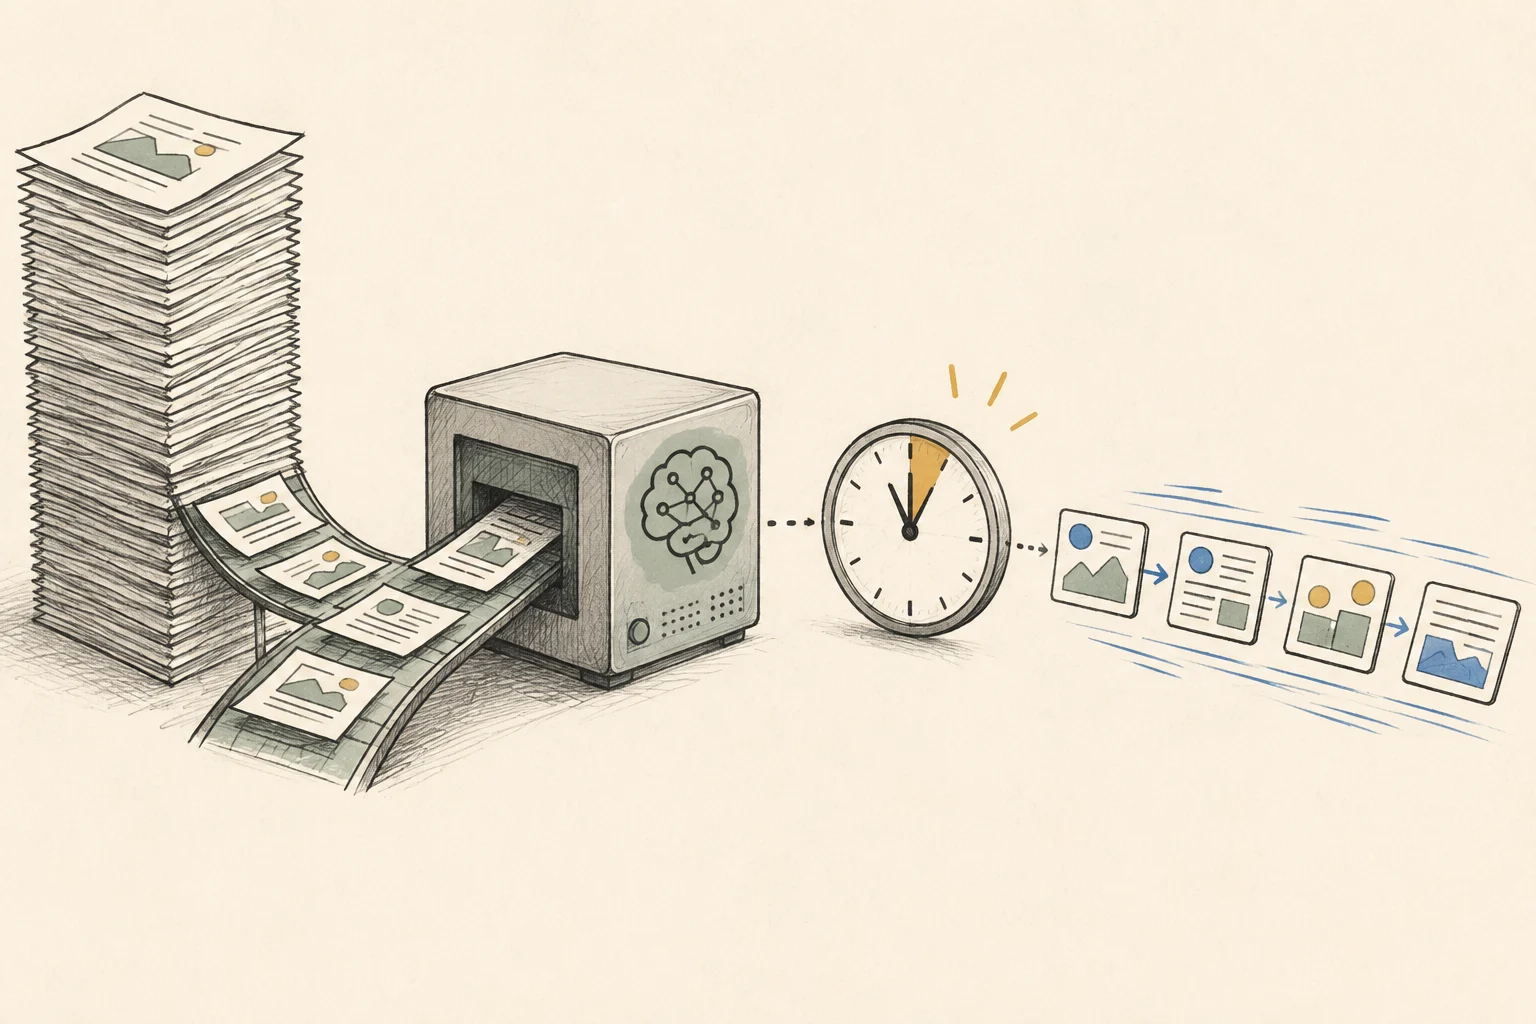
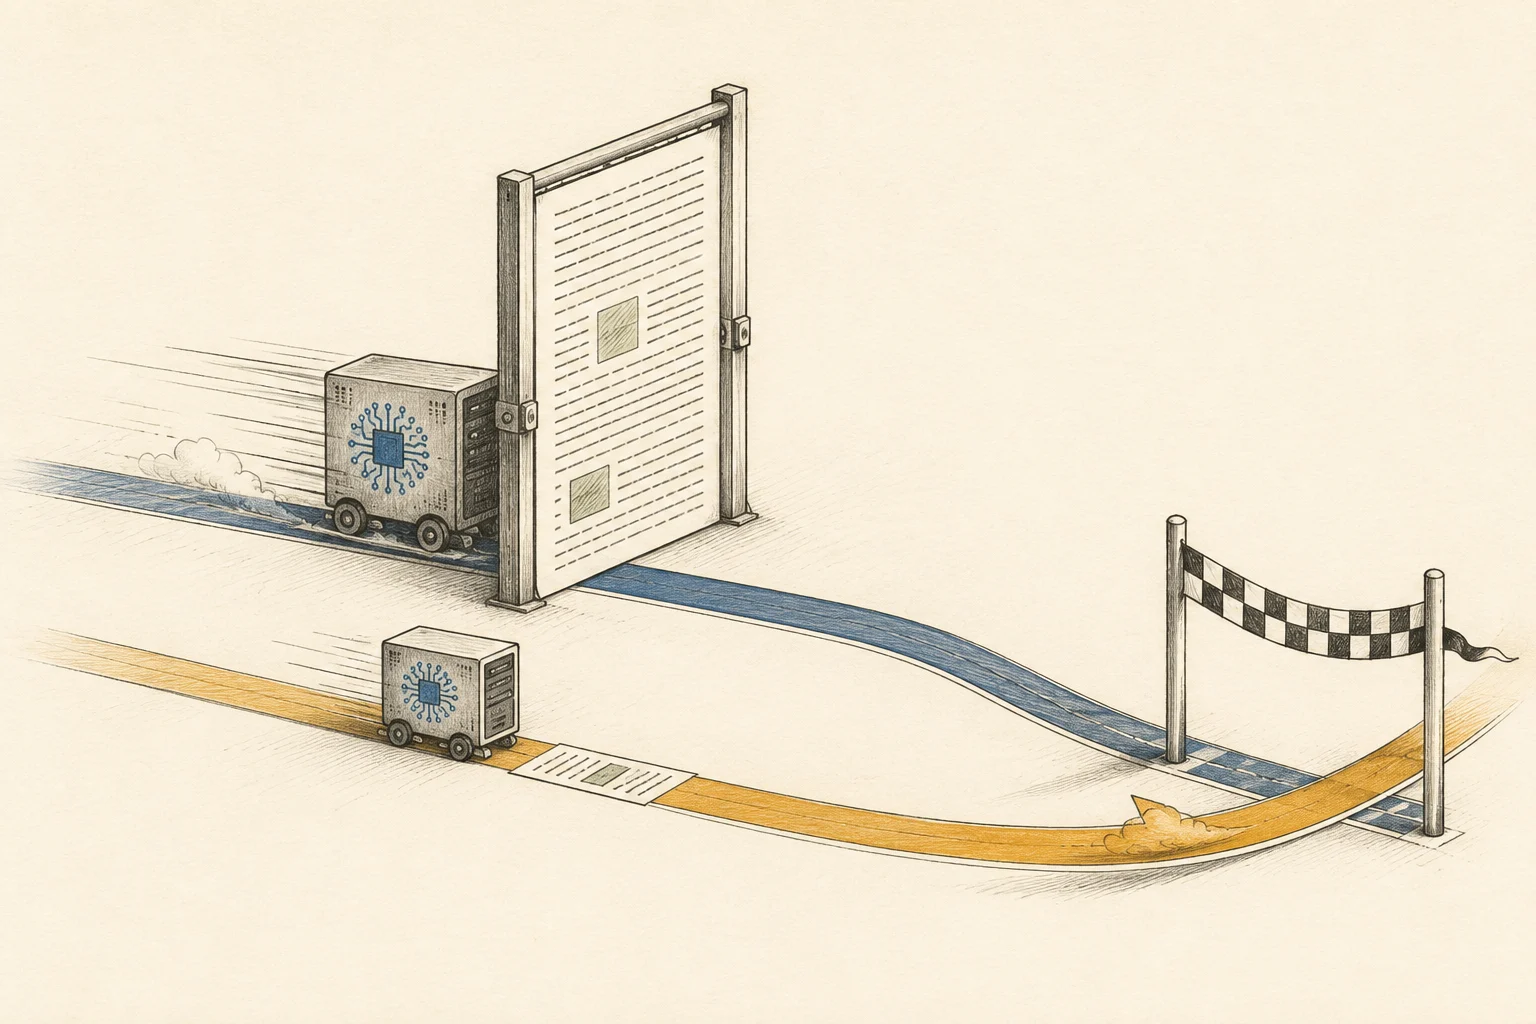
長い入力ではprefill待ちが順位を変えることがあります
同じモデルと300token回答のまま16Kの議事録を入力するとします。この仮想例では最初のtokenまでAが40秒、Bが10秒で、生成時間は前と同じくAが5秒、Bが10秒です。全体はA約45秒、B約20秒となり、生成が2倍速いAではなくBが先に終わります。
プリフィルはモデルが長い入力を処理する段階です。TTFT4はプリフィルにリクエスト待機や実行準備を含めた、最初のトークンまでの待ち時間です。上の計算ではTTFTだけを40秒と10秒に変え、長い入力で完了時間がどう変わるか比較しています。
機器自体ではなく、比較作業の入力長が変わりました。短い質問ではAが先行し、長い議事録ではBが先に終わることは両立します。
| 作業 | 仮想機器A · 60 tok/s | 仮想機器B · 30 tok/s |
|---|---|---|
| 短い入力 · 出力約300トークン | 4秒 + 5秒 = 約9秒 | 6秒 + 10秒 = 約16秒 |
| 16K入力 · 出力約300トークン | 40秒 + 5秒 = 約45秒 | 10秒 + 10秒 = 約20秒 |
回答長とcache状態も揃えます
議事録から日付と担当者だけを探すと回答が短く、最初のtokenまでの待ちが全体の大きな割合を占めます。長い下書きを求めると生成区間が延び、decode差が長く影響します。比較prompt5は入力文書だけでなく期待する回答長も揃えます。
初めて開く議事録と既に処理した文書も分けます。入力cacheが残る反復requestは初回と処理特性が異なる場合があります。processを維持することと入力cacheを再利用することも別条件なので、それぞれ記録します。
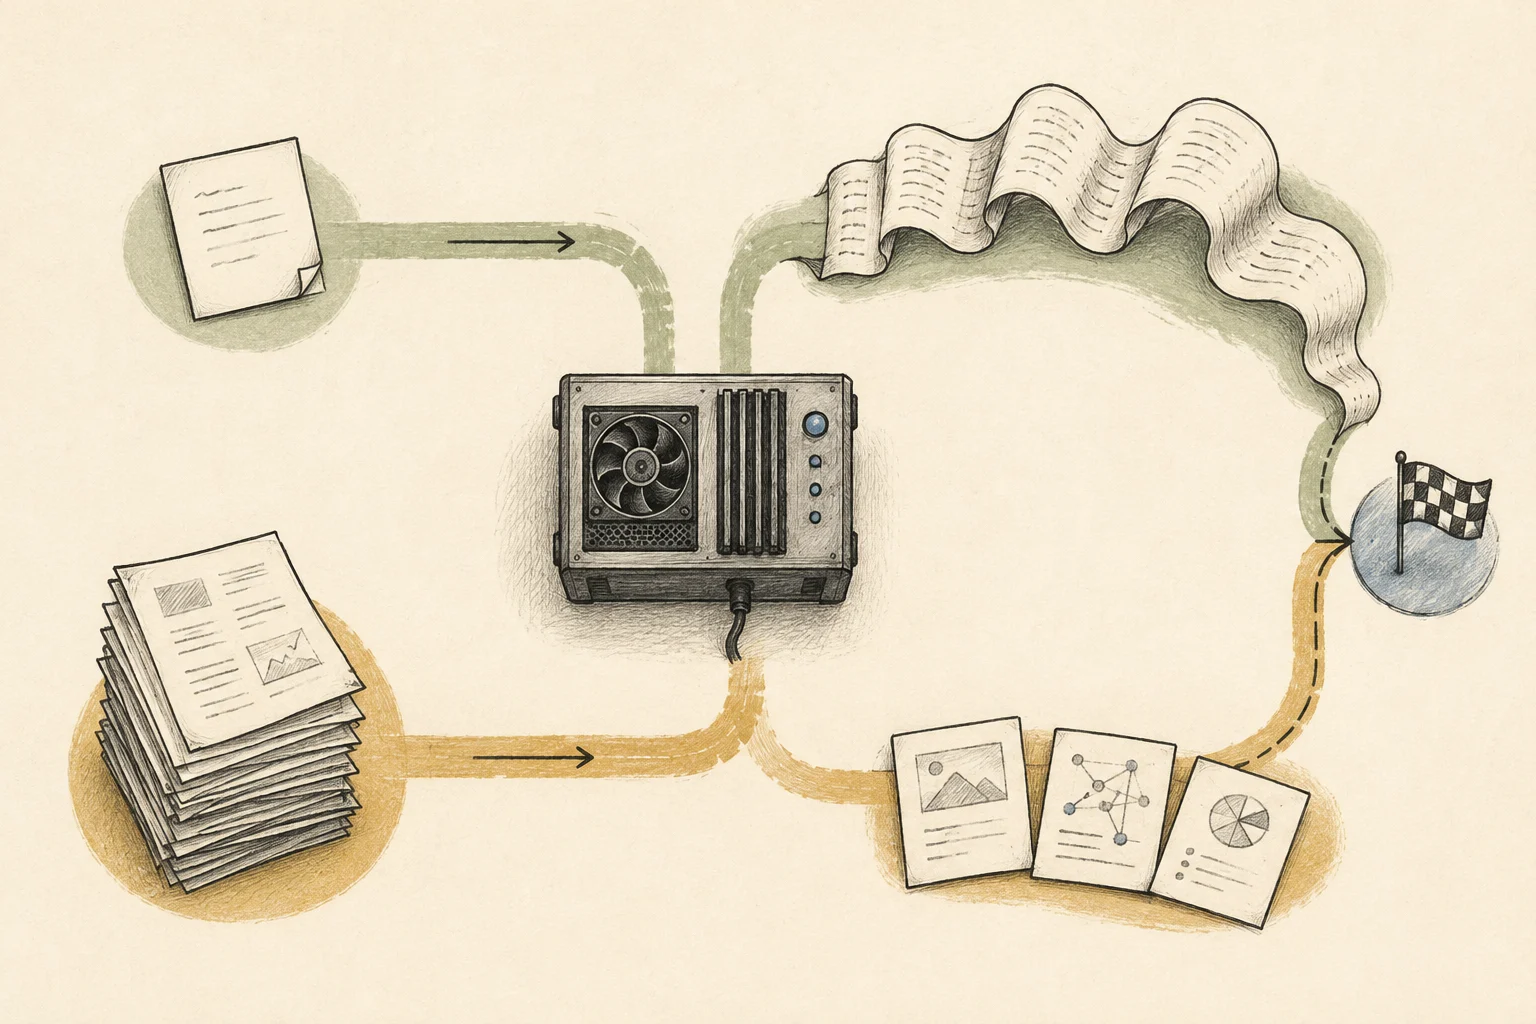
自分の作業の完了時間で機器を比較します
比較画面で4Kと普段の文書に近い16Kを選び、同じモデルを維持します。prefill込みの全体推定を確認してから生成区間と比べ、どの待ちが差を生むか見ます。機器ごとに推奨formatや加速設定が異なる場合はその差も考慮します。
購入前に可能なら使用予定のmodel fileとruntime6で、議事録入力と回答長を使って実行します。最初のtoken、完了時刻、生成token数を別々に記録し、推定と実測を区別します。
Aの生成速度が60 tok/s、Bが30 tok/sのままでも、16Kで最初のtokenまでの待ちが長くなれば全体順位は変わり得ます。実際の16K作業でAが先行し、必要な決定事項も保つなら購入理由になる場合があります。現在の機器が期限内に終わり品質も十分なら、順位だけで予算を使う必要はありません。
用語の注釈
トークンのデコード — 入力とそれまでの回答をもとに、次の出力トークンを順に生成する段階です。
本文に戻るトークン — モデルが入力や出力を分けて処理する単位です。
本文に戻るプリフィル — LLMが入力プロンプトを読み、各トークンの内部表現を計算する段階です。プロンプトが長いほど処理するトークンが増えます。
本文に戻る最初のトークンまでの時間 — リクエスト送信から最初の出力トークンが届くまでの時間です。
本文に戻るプロンプト — モデルに送る入力文です。生成モデルでは作りたい結果を説明する文になり、出力の構成や内容を大きく左右します。
本文に戻るランタイム — プログラムの実行時に必要な機能を提供するソフトウェア環境です。ローカルAIではモデル実行エンジンを指すこともあります。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- 言語モデルは文章を入力として受け取り、内容を処理してから回答を生成します。decode tok/sが2倍の機器でも、長文で最初のtoken前の待ちが長ければ要約完了が遅れる場合があります。16Kの議事録と300tokenの回答を例に、prefill待ちと生成時間を合計して完了時刻を比較します。