
답변 속도와 가속
최종 업데이트
SpecPrefill로 긴 입력의 TTFT 줄이기
긴 입력에서 필요한 토큰을 골라 첫 답변을 앞당겨요
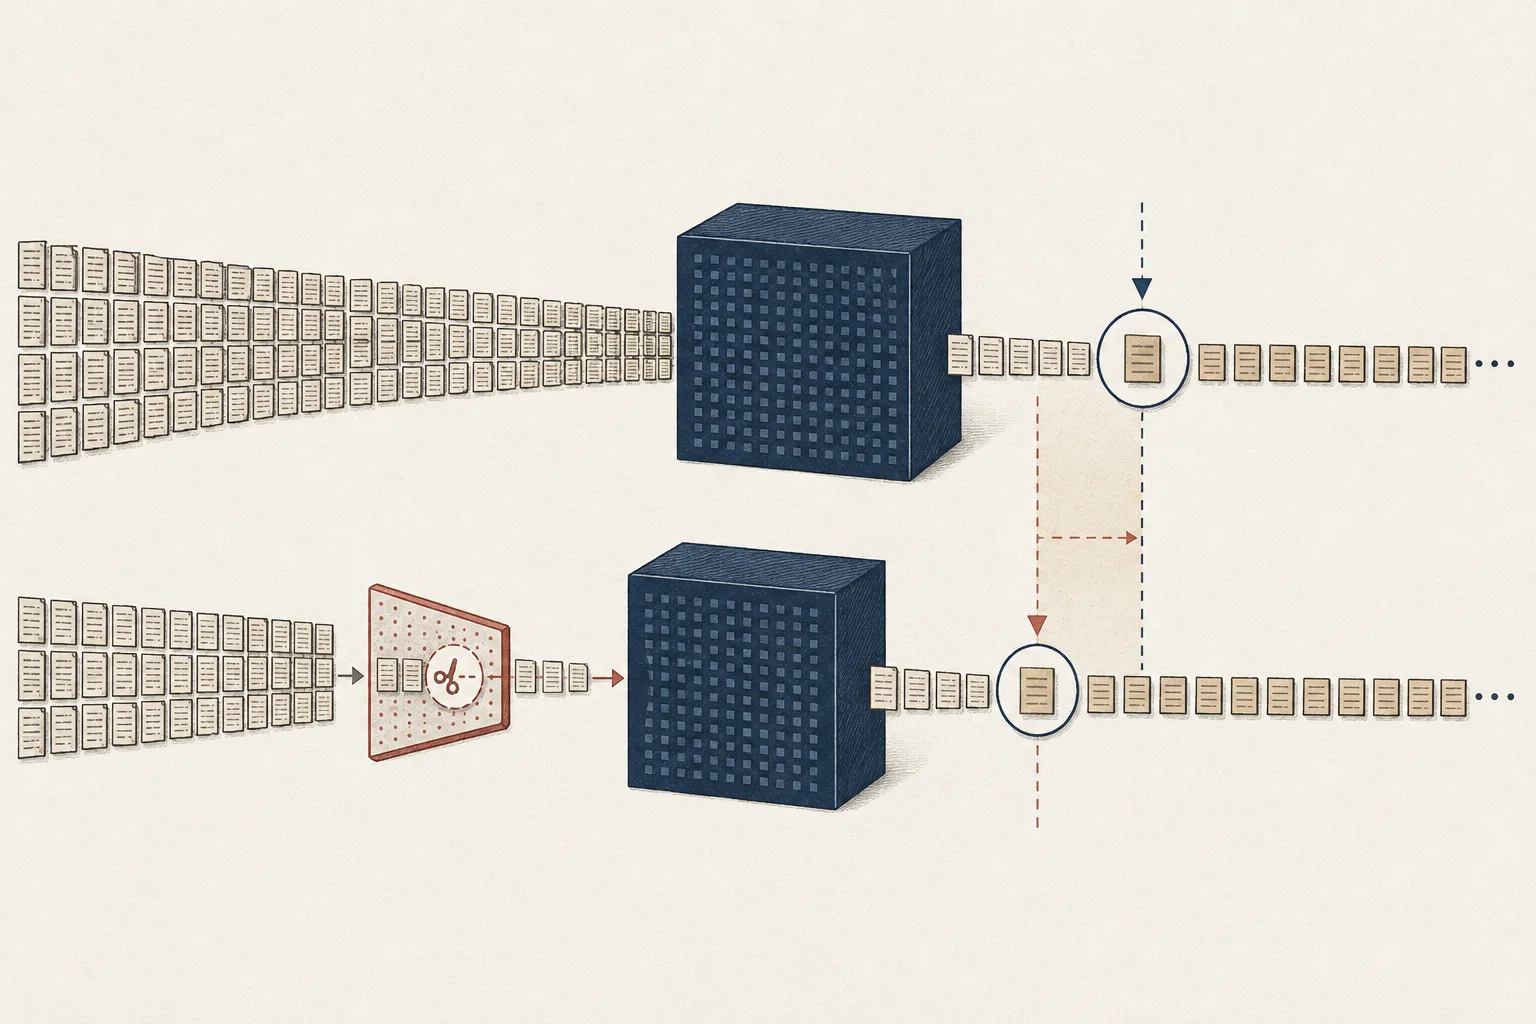
SpecPrefill1은 작은 모델 등의 도움으로 긴 입력에서 본 모델이 처리할 토큰2을 선별하는 실험적 최적화예요. 입력 처리량3을 줄여 첫 토큰까지의 대기 시간을 단축하려는 방식이에요. 저장소나 긴 문서로 시험하고, 선별 시간과 답변 결과를 함께 비교해요.
코드 저장소와 오류 로그를 함께 보내면 모델은 코드를 쓰기 전에 그 입력부터 읽어요. 이 프리필4이 오래 걸리는 작업에서 SpecPrefill을 시험해볼 수 있어요. 먼저 입력을 고르는 비용이 추가되므로 짧은 질문보다는 긴 입력이 반복되는 작업이 비교 대상이에요.
처리할 입력을 고른 뒤 본 모델에 전달해요
빈 입력을 처리하도록 함수를 고쳐 달라는 요청이라면 함수 본문과 오류가 난 호출부, 기존 테스트가 함께 필요해요. SpecPrefill은 긴 입력 중 처리할 토큰을 고르는 단계를 앞에 둬요. 선별 결과에 이 정보가 남아야 본 모델이 함수와 호출부의 관계를 살펴볼 수 있어요.
효과는 줄인 본 모델 처리 시간에서 선별에 든 시간을 뺀 만큼이에요. 짧은 질문은 줄일 입력이 적어 이득이 작을 수 있어요. 모델을 불러오는 시간과 초안 모델 준비 시간도 따로 기록하고, 요청을 보낼 때 양쪽 모델이 준비된 상태를 맞춰요.
캐시와 생성 가속은 다른 구간을 맡아요
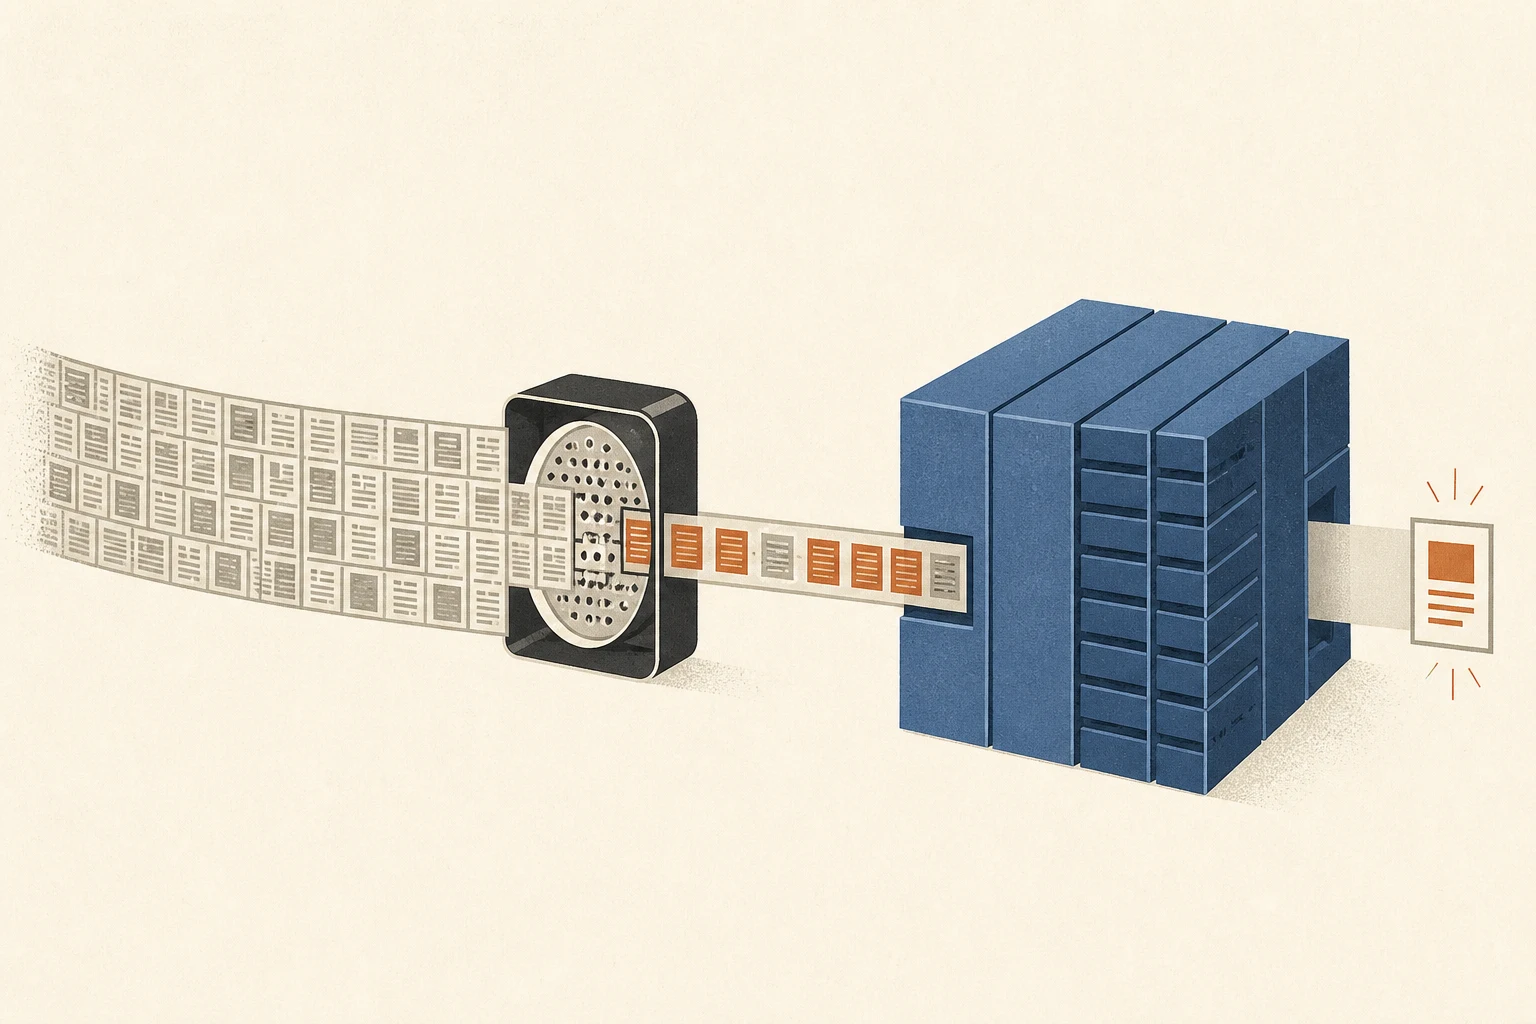
프롬프트5 캐시는 앞선 요청에서 계산한 공통 입력을 재사용해요. SpecPrefill은 이번 입력에서 처리할 토큰을 고르고, MTP6는 답변을 생성할 때 다음 토큰 후보를 만들어요. 첫 답변이 늦는지, 답변을 이어 쓰는 속도가 느린지에 따라 손볼 구간이 달라져요.
같은 저장소와 요청 문구를 쓰고 캐시 상태도 기록해요. 기준 실행에만 공통 입력 캐시가 남아 있으면 비교 결과에 캐시 효과가 섞여요. 캐시를 비우기 어렵다면 비웠다고 가정하지 않고 관찰한 상태를 그대로 적어요. TTFT7와 이후 디코드8 속도를 나눠 비교하면 어느 단계가 달라졌는지 알 수 있어요.
Mac은 oMLX의 초안·MTP 조합을 맞춰요
oMLX의 SpecPrefill용 초안 모델은 본 모델과 같은 토크나이저를 써야 해요. 앱이 허용하는 모델·초안 조합을 선택하고 짧은 요청에서 동작을 확인한 뒤 긴 입력을 시험해요. 같은 모델 이름이라도 초안 구현이 다를 수 있으니 설정 설명과 요청 로그를 함께 확인해요.
native MTP와 병합된 Gemma assistant의 Lightning 경로는 SpecPrefill과 별도로 설정할 수 있어요. 외부 assistant를 쓰는 VLM MTP 경로는 SpecPrefill과 동시에 실행할 수 없어요. 먼저 SpecPrefill만 시험하고, 지원되는 MTP를 추가해 생성 구간까지 비교하는 순서가 좋아요.
사이트의 Mac 체감 수치는 대략적인 추정 범위예요. 확인하지 않은 NVIDIA 타깃·초안 조합에는 배율을 적용하지 않아요. 실제 선택은 사용하는 런타임9의 지원 조합과 같은 요청의 결과를 기준으로 해요.
시간과 답변 결과를 함께 비교해요
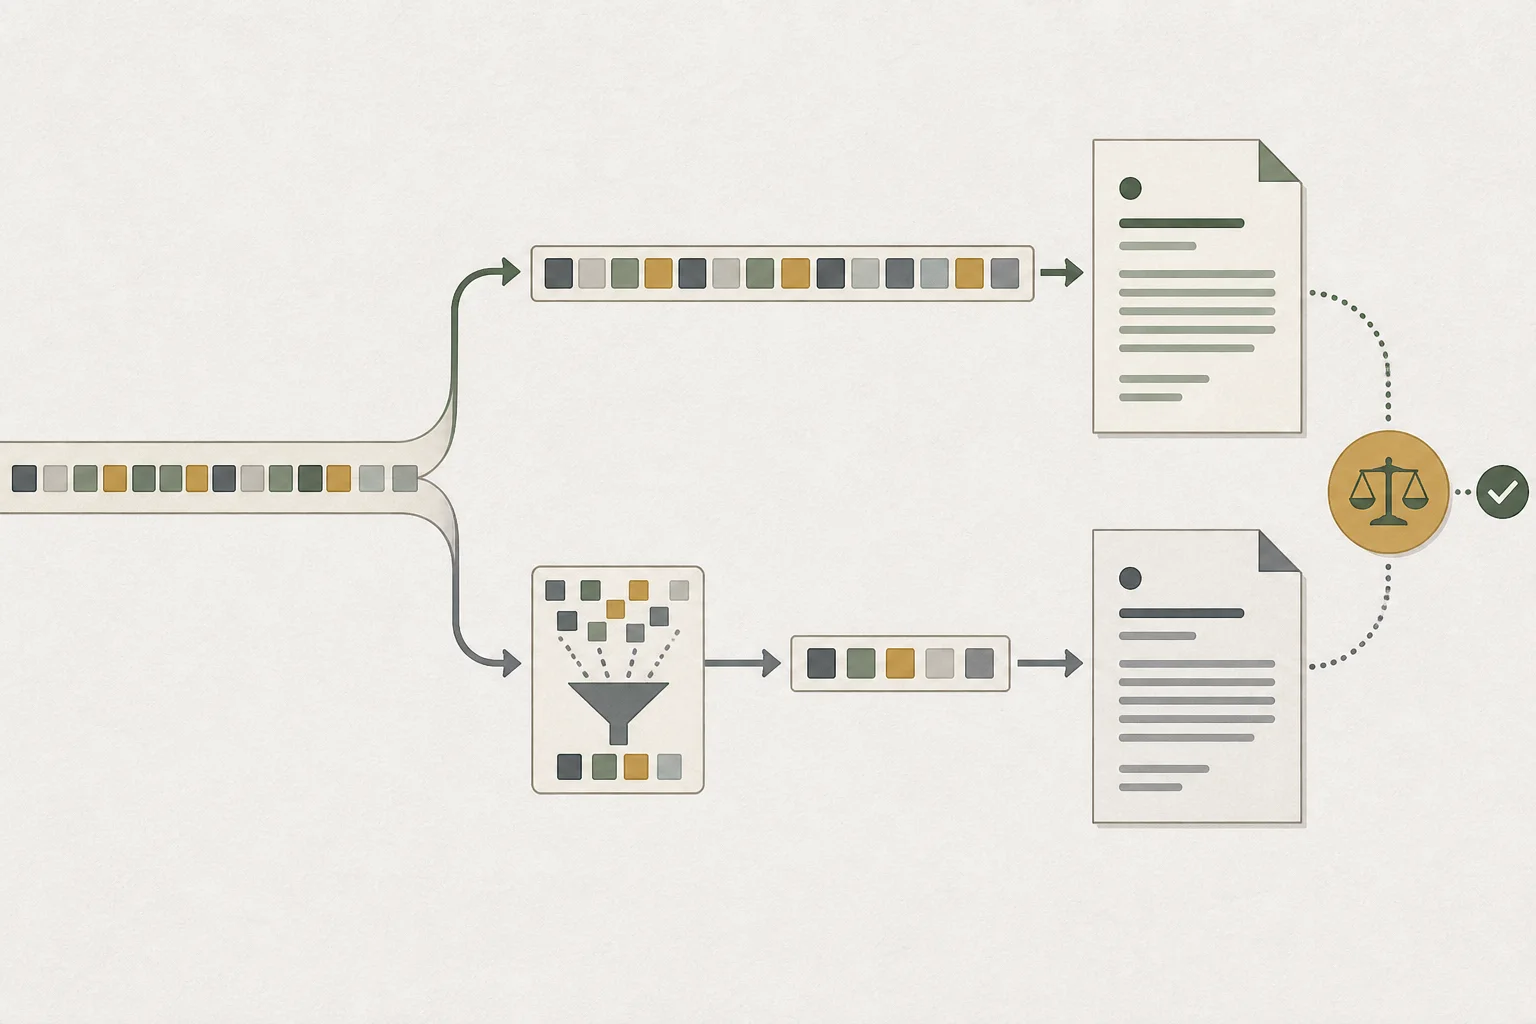
아래는 시간 구성을 설명하기 위한 가정이에요. 기본 실행은 프리필 30초, 생성 20초, 검토 10초로 총 60초예요. 선별 뒤 프리필이 줄어도 누락된 코드를 찾느라 검토가 길어지면 전체 작업 시간은 같을 수 있어요. 모델 적재 시간은 표 밖에 두었어요.
| 구간 | 기본 실행 | SpecPrefill 예시 |
|---|---|---|
| 입력 선별 | 0초 | 5초 |
| 본 모델 프리필 | 30초 | 15초 |
| 답변 생성 | 20초 | 20초 |
| 코드 검토 | 10초 | 20초 |
| 총 작업 시간 | 60초 | 60초 |
같은 코드 수정 요청에서 일반 문자열과 빈 문자열의 반환값, 호출부의 기대값을 비교해요. 수정 대상과 호출부가 저장소 앞·중간·뒤에 있을 때도 시험하면 필요한 정보가 누락되는지 찾기 쉬워요. 선별 토큰을 볼 수 있는 실행기는 입력에 남은 구간도 직접 대조해요.
필요한 근거를 유지하는 작업에 적용해요
관련 파일을 찾는 탐색 요청은 사람이 후보를 다시 열어볼 수 있어요. 바로 적용할 코드 수정은 호출부나 인터페이스가 빠졌을 때 영향이 더 커요. 같은 선별 설정을 두 작업에 일괄 적용하기보다 평소 요청 하나로 테스트와 검토까지 마쳐보세요.
첫 답변이 빨라지고 결과도 유지되는 작업에서 설정을 남겨요. 누락이 나타나면 선별 조건이나 기본 실행으로 돌아가 같은 요청을 다시 비교해요. 검증한 모델·초안 조합부터 사용 범위를 넓히면 긴 입력의 대기를 줄이면서 결과를 확인하는 흐름을 유지할 수 있어요.
용어 각주
SpecPrefill — 가벼운 모델로 입력 토큰의 중요도를 추정하고, 선택한 토큰을 본 모델에 전달해 프리필 계산을 줄이는 기법입니다. 본 모델이 읽지 않는 문맥이 생기므로 토큰 선택이 답변에 반영될 정보를 바꿀 수 있습니다.
본문으로 돌아가기토큰 — 모델이 입력이나 출력을 나누어 처리하는 단위입니다.
본문으로 돌아가기처리량 — 일정 시간 동안 처리하거나 생성한 작업량입니다. 토큰/초, 요청/초처럼 단위를 함께 확인해야 비교할 수 있습니다.
본문으로 돌아가기프리필 — LLM이 입력 프롬프트를 읽고 각 토큰의 내부 표현을 계산하는 단계입니다. 입력이 길수록 처리할 토큰이 많아집니다.
본문으로 돌아가기프롬프트 — 모델에 보내는 입력문입니다. 생성 모델에서는 만들 결과를 설명하는 문장이 되어 출력의 구성과 내용을 크게 좌우합니다.
본문으로 돌아가기MTP — 한 번에 여러 미래 토큰을 예측하도록 학습하는 목표 또는 이를 수행하는 모델 구성입니다. 추측 디코딩에서는 이 예측을 후보 토큰으로 제안할 수 있습니다.
본문으로 돌아가기첫 토큰 지연 — 요청을 보낸 뒤 첫 출력 토큰이 도착하기까지 걸린 시간입니다.
본문으로 돌아가기토큰 디코드 — 입력과 앞서 만든 답변을 바탕으로 다음 출력 토큰을 차례로 생성하는 단계입니다.
본문으로 돌아가기런타임 — 프로그램이 실행될 때 필요한 기능을 제공하는 소프트웨어 환경입니다. 로컬 AI에서는 모델을 실행하는 엔진을 가리키기도 합니다.
본문으로 돌아가기
자주 묻는 질문
- 이 글에서 가장 먼저 확인할 것은 무엇인가요?
- SpecPrefill은 작은 모델 등의 도움으로 긴 입력에서 본 모델이 처리할 토큰을 선별하는 실험적 최적화예요. 입력 처리량을 줄여 첫 토큰까지의 대기 시간을 단축하려는 방식이에요. 저장소나 긴 문서로 시험하고, 선별 시간과 답변 결과를 함께 비교해요.