
답변 속도와 가속
최종 업데이트
긴 입력에서는 로컬 LLM 속도 순위가 뒤집힐 수 있어요
긴 문서에서는 답변 생성 순위와 완료 순위가 달라질 수 있어요
언어 모델은 문장을 입력받아 먼저 내용을 처리하고, 이어서 답을 생성해요. 디코드1 tok/s가 두 배인 장비도 긴 문서의 첫 토큰2 전 대기가 길면 요약을 더 늦게 끝낼 수 있어요. 16K 회의록과 300토큰 답변을 예로 프리필3 대기와 생성 시간을 더해 완료 시점을 비교해요.
회의록을 몇 문단으로 요약할 때 사용자가 기다리는 시간은 마지막 문장이 나올 때까지예요. 이 시간에는 문서를 읽는 첫 토큰 전 대기와 요약 생성이 모두 포함돼요. 장비 표에 자주 보이는 tok/s는 답이 시작된 뒤 생성 구간만 설명하므로 전체 완료 시간과 같지 않아요.
짧은 질문에서는 디코드가 빠른 장비가 먼저 끝나요
같은 모델로 약 300토큰 답을 만든다고 가정해요. 가상 장비 A는 첫 토큰까지 4초, 이후 60 tok/s이고, B는 6초와 30 tok/s예요. 이는 특정 제품의 측정값이 아니라 원리를 계산하기 위한 가정이에요.
생성 구간만 계산하면 A는 300÷60=약 5초, B는 300÷30=약 10초예요. 첫 토큰 대기를 더하면 A는 약 9초, B는 약 16초라 이 짧은 작업에서는 A가 먼저 끝나요. 생성 속도가 두 배여도 전체 완료가 정확히 절반은 아니에요.
이 산술은 토큰 속도가 일정하고 모델 로딩과 대기열이 없다고 놓은 설명용 계산이에요. 첫 토큰까지의 대기는 디코드 속도와 별도로 더했어요.
긴 입력에서는 프리필 대기가 순위를 바꿀 수 있어요
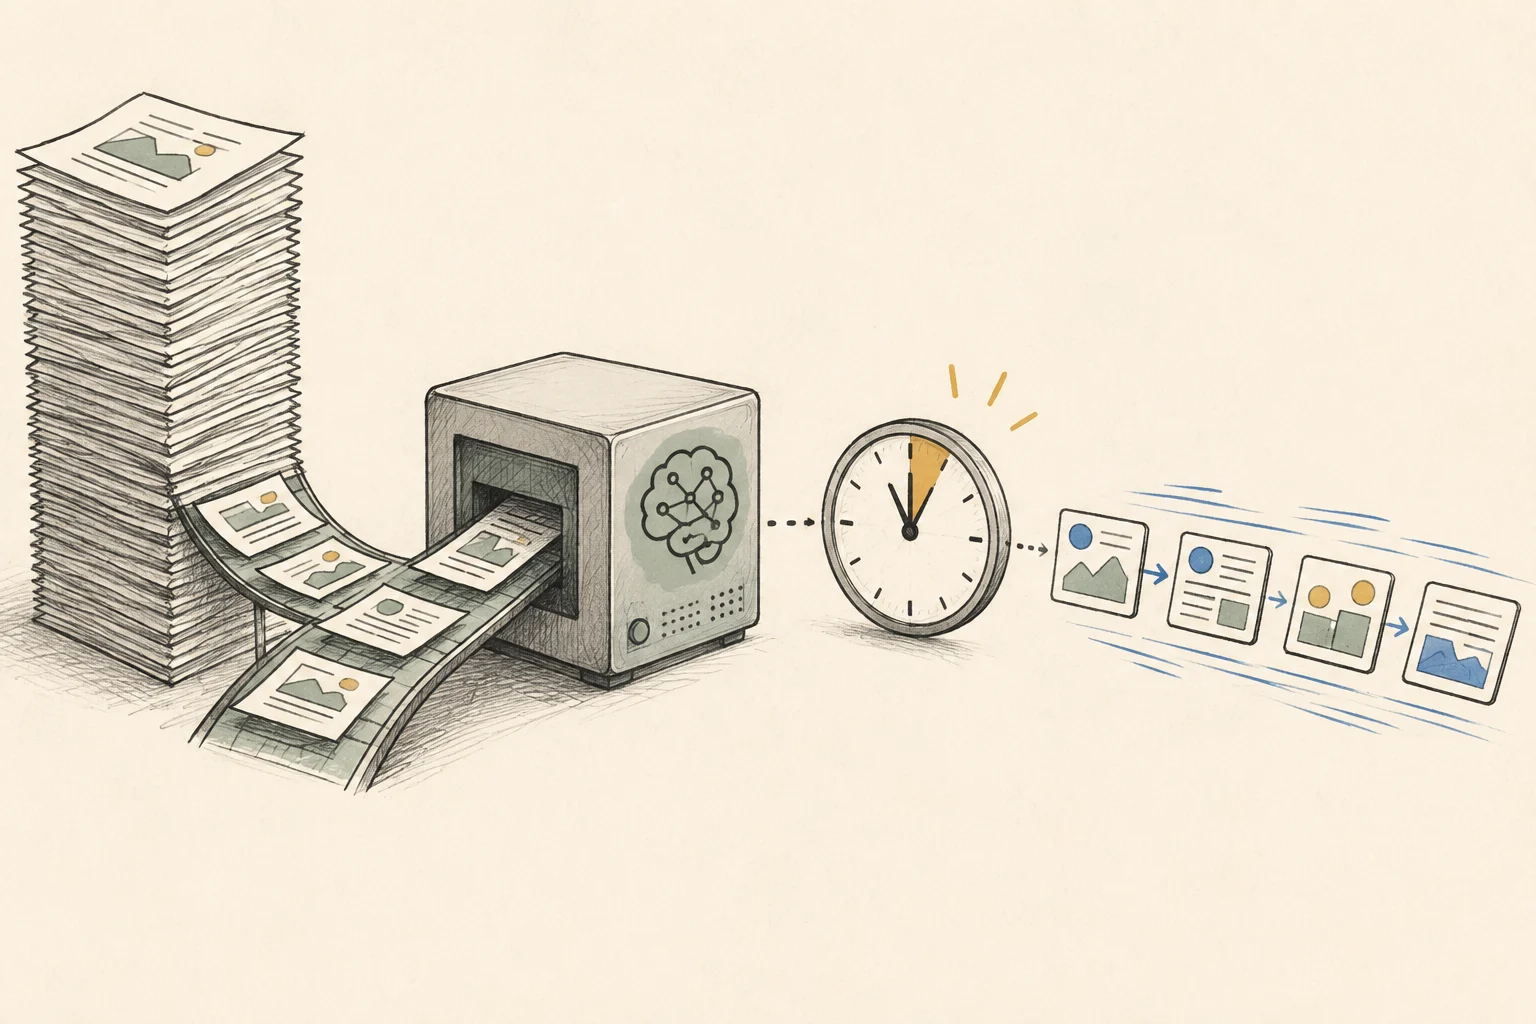
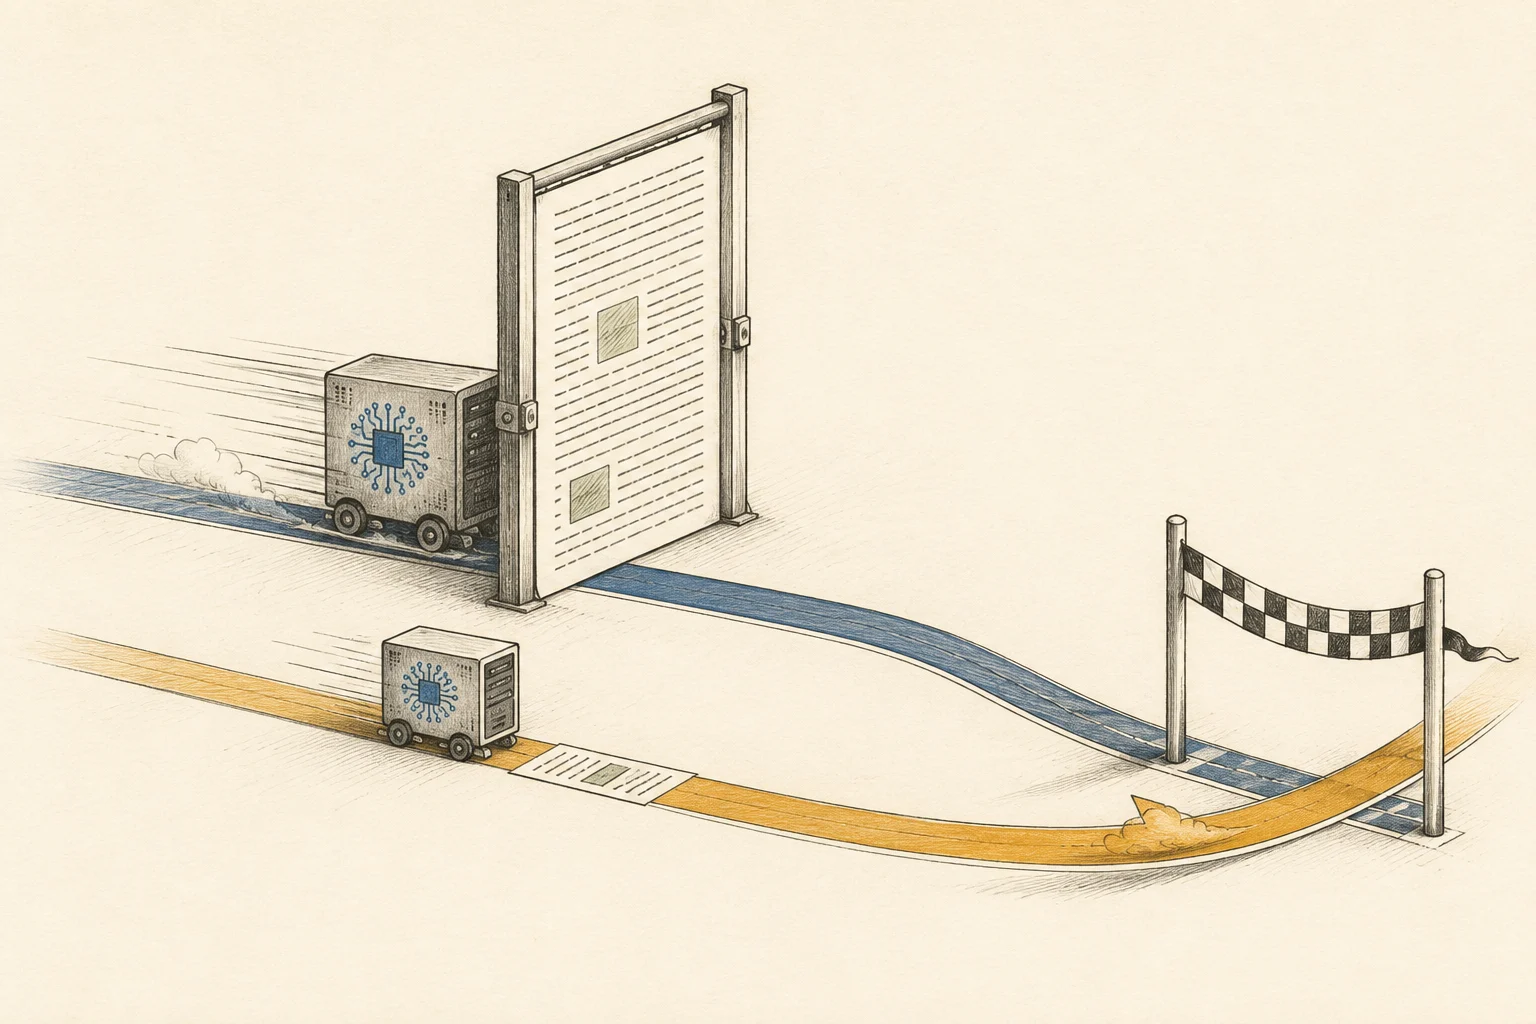
같은 모델과 300토큰 답변을 유지하고 16K 회의록을 입력한다고 해볼게요. 가상 예시에서 첫 토큰까지 A는 40초, B는 10초로 두고, 생성 시간은 앞과 같이 A가 5초, B가 10초예요. 전체는 A 약 45초, B 약 20초가 되어 답변을 쓰는 속도가 두 배인 A보다 B가 먼저 끝나요.
긴 입력을 모델이 처리하는 단계가 프리필이에요. TTFT4는 프리필에 요청 대기나 실행 준비 시간을 더한 첫 토큰까지의 전체 대기예요. 위 계산에서는 TTFT만 40초와 10초로 바꿔, 입력이 길어질 때 전체 완료 시간이 어떻게 달라지는지 비교했어요.
장비 자체가 바뀐 게 아니라 비교하는 작업의 입력 길이가 달라졌어요. 짧은 질문에서 A가 앞선다는 사실과 긴 회의록에서 B가 먼저 끝난다는 결과는 함께 성립할 수 있어요.
| 작업 | 가상 장비 A · 60 tok/s | 가상 장비 B · 30 tok/s |
|---|---|---|
| 짧은 입력 · 출력 약 300토큰 | 4초 + 5초 = 약 9초 | 6초 + 10초 = 약 16초 |
| 16K 입력 · 출력 약 300토큰 | 40초 + 5초 = 약 45초 | 10초 + 10초 = 약 20초 |
답변 길이와 캐시 상태도 같은 조건으로 맞춰요
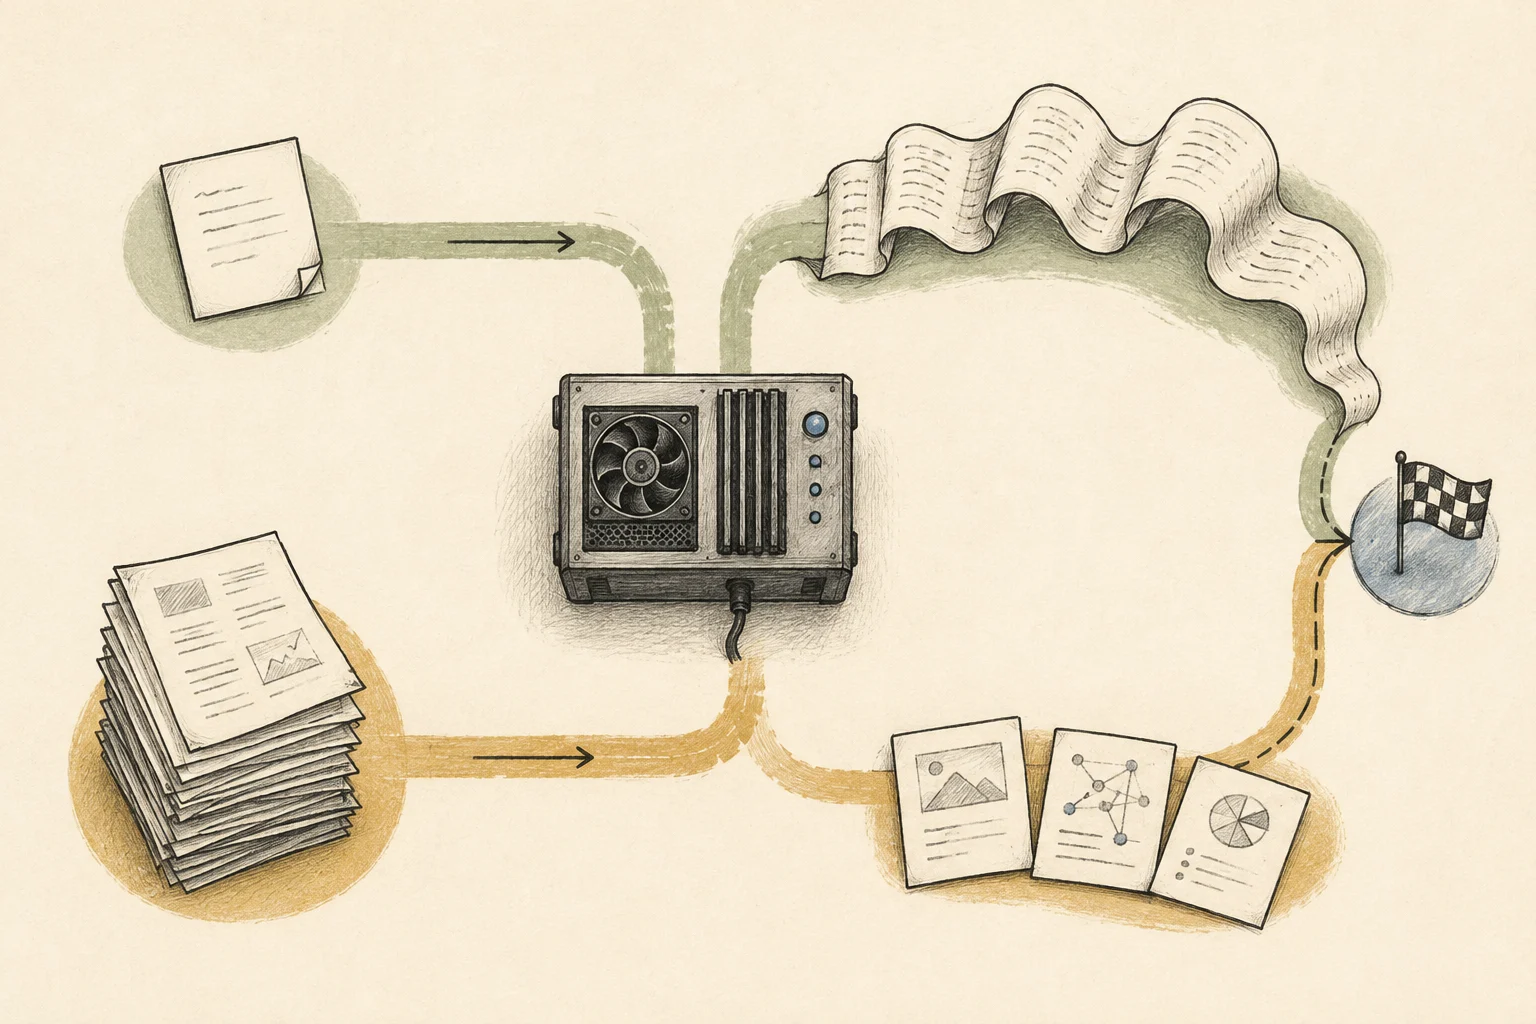
회의록에서 날짜와 담당자만 찾으면 답이 짧아 첫 토큰 대기가 전체에서 큰 몫을 차지해요. 긴 초안을 요청하면 생성 구간이 길어져 디코드 차이가 더 오래 이어져요. 그래서 비교 질문은 입력 문서뿐 아니라 기대하는 답변 길이까지 닮아야 해요.
처음 여는 회의록과 이미 읽어 둔 문서도 분리해요. 캐시가 남은 반복 요청은 입력 처리 양상이 첫 요청과 달라질 수 있어요. 같은 프로세스를 유지하는 것과 입력 캐시를 재사용하는 것도 다른 조건이므로 각각 기록해요.
내 작업의 완료 시간으로 두 장비를 비교해요
비교 화면에서 4K와 평소 문서 길이에 가까운 16K를 각각 선택하고 같은 모델을 유지해요. 전체 흐름으로 프리필 포함 예상치를 본 다음 토큰 생성 구간과 비교해 어떤 대기가 차이를 만드는지 살펴요. 각 장비의 추천 포맷이나 가속 설정이 다르면 그 차이도 함께 고려해요.
실제 구매 전에는 사용할 모델 파일과 런타임5, 회의록 입력과 답변 길이로 시험할 수 있다면 직접 실행해요. 첫 토큰이 나온 시점과 답변 완료, 생성 토큰 수를 각각 기록해 예상치와 실측을 구분해요.
A의 생성 속도 60 tok/s와 B의 30 tok/s는 그대로여도 16K에서 첫 토큰 대기가 길어지면 전체 순위는 달라질 수 있어요. 실제로 16K 작업에서 A가 앞서고 답변이 필요한 결정을 보존한다면 그 차이가 구매 이유가 될 수 있어요. 현재 장비도 제때 끝내고 품질이 충분하다면 더 높은 순위에 예산을 쓸 필요는 없어요.
용어 각주
토큰 디코드 — 입력과 앞서 만든 답변을 바탕으로 다음 출력 토큰을 차례로 생성하는 단계입니다.
본문으로 돌아가기토큰 — 모델이 입력이나 출력을 나누어 처리하는 단위입니다.
본문으로 돌아가기프리필 — LLM이 입력 프롬프트를 읽고 각 토큰의 내부 표현을 계산하는 단계입니다. 입력이 길수록 처리할 토큰이 많아집니다.
본문으로 돌아가기첫 토큰 지연 — 요청을 보낸 뒤 첫 출력 토큰이 도착하기까지 걸린 시간입니다.
본문으로 돌아가기런타임 — 프로그램이 실행될 때 필요한 기능을 제공하는 소프트웨어 환경입니다. 로컬 AI에서는 모델을 실행하는 엔진을 가리키기도 합니다.
본문으로 돌아가기
자주 묻는 질문
- 이 글에서 가장 먼저 확인할 것은 무엇인가요?
- 언어 모델은 문장을 입력받아 먼저 내용을 처리하고, 이어서 답을 생성해요. 디코드 tok/s가 두 배인 장비도 긴 문서의 첫 토큰 전 대기가 길면 요약을 더 늦게 끝낼 수 있어요. 16K 회의록과 300토큰 답변을 예로 프리필 대기와 생성 시간을 더해 완료 시점을 비교해요.