
먼저 읽기
최종 업데이트
프리필·디코드 차이: TTFT와 tok/s 중 무엇을 봐야 하나
긴 입력은 TTFT, 긴 답은 디코드 속도가 기다림을 좌우해요
코드와 오류 설명을 보내면 LLM1은 먼저 입력을 읽고, 이어서 리뷰 답변을 만들어요. 입력 토큰2을 처리하는 단계는 프리필3(prefill), 답변 토큰을 차례로 만드는 단계는 디코드4(decode)예요. 프리필이 끝난 뒤 첫 답이 나오고, 디코드 동안 나머지 답이 이어져요.
코드와 오류 설명이 길면 첫 답을 기다리는 시간이 늘 수 있어요. 자세한 답을 요청하면 문장이 이어지는 시간도 길어질 수 있죠. 같은 코드 리뷰도 입력과 출력 길이에 따라 기다리는 구간이 달라져요. 두 단계를 알면 내 작업에 필요한 속도를 비교하기 쉬워요.
첫 글자가 나오기 전, 입력을 읽어요
코드 리뷰 요청에는 코드, 오류 상황, 원하는 답의 범위가 들어가요. 모델은 답을 쓰기 전에 입력을 토큰 단위로 처리하고 토큰 사이의 관계를 계산해 답변에 쓸 상태를 준비해요. 이 과정이 프리필이에요. 그 뒤 디코드에서 답변 토큰을 차례로 만들어요. 파일 여러 개를 붙이면 입력 토큰이 늘어 첫 답까지 더 기다릴 수 있어요.
프리필 비교에서는 파일 수나 줄 수보다 실제 입력 토큰 수를 맞추는 게 중요해요. 코드의 token 분할 방식이 다르고, 앱이 관련 파일만 보낼지 저장소 내용을 넓게 포함할지도 다르기 때문이에요. 리뷰 앱이 모델에 실제로 보낸 입력 길이를 확인하면 처리 속도를 더 정확히 비교할 수 있어요.
첫 토큰까지의 기다림을 TTFT라고 해요
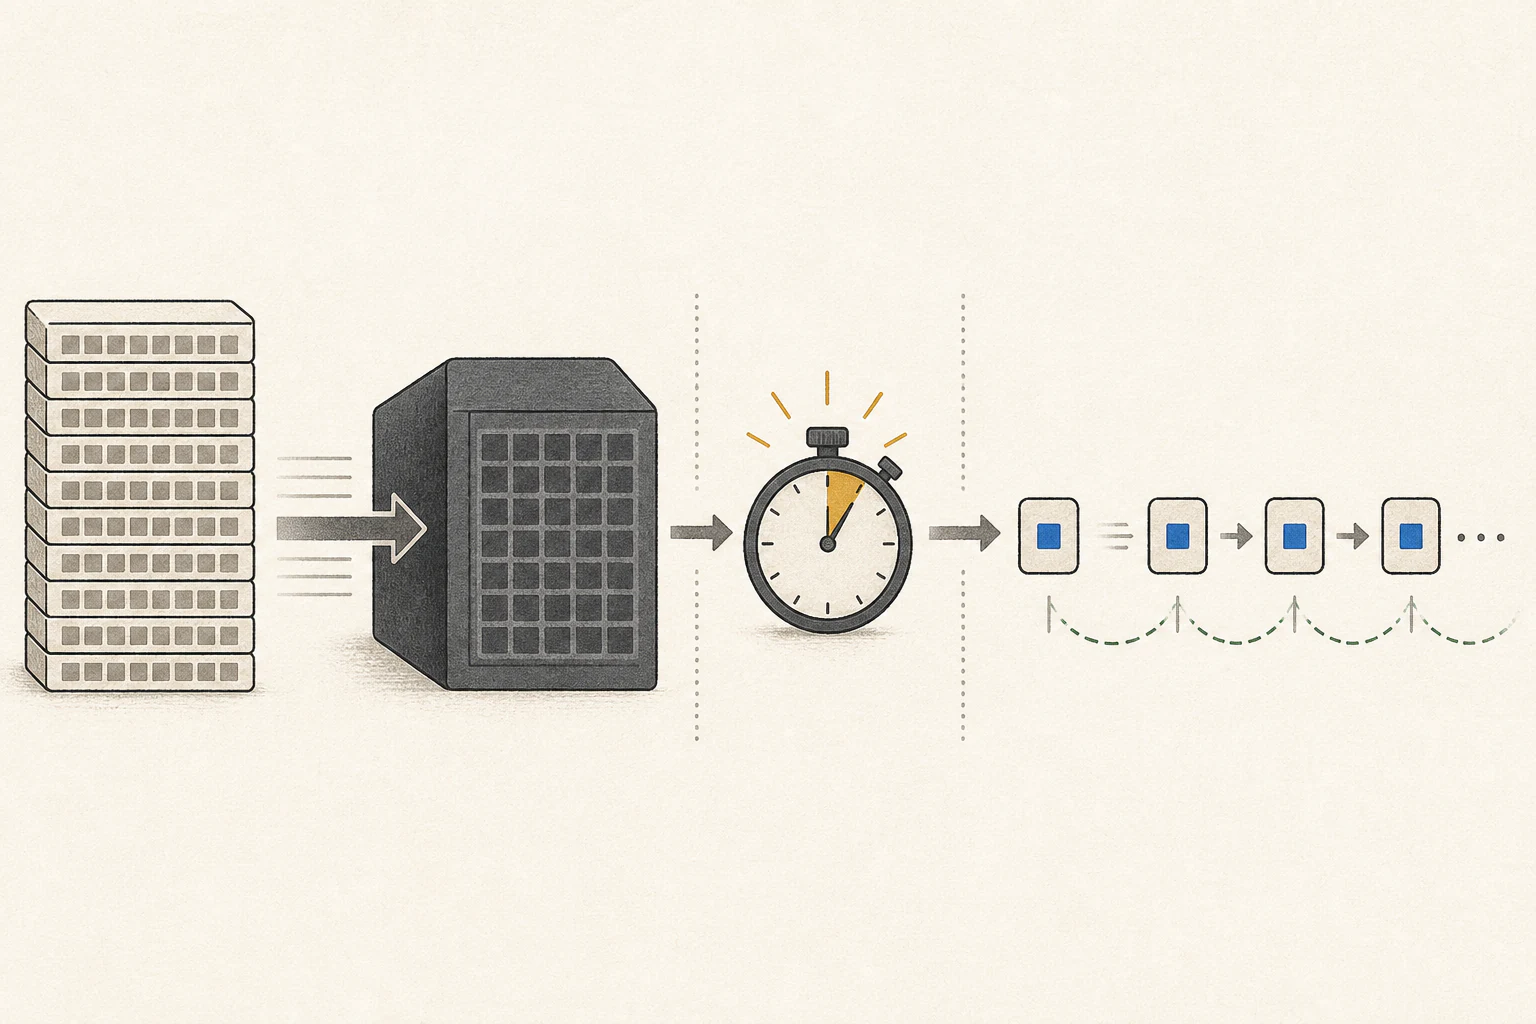
요청을 보낸 순간부터 첫 출력 토큰이 화면에 나타날 때까지가 TTFT5(time to first token)예요. 프리필 외에도 앱의 입력 준비와 요청 대기열, 토큰화, 실행 준비가 포함될 수 있어요. 프리필 처리량6은 입력 토큰을 처리하는 속도이고, TTFT는 요청부터 첫 토큰까지 사용자가 기다린 시간이에요.
입력 토큰/초는 프리필 처리량을, 첫 답까지의 기다림은 TTFT를 보면 돼요. 앱에서 대기열이나 입력 전처리 시간을 따로 보여주지 않을 수 있으므로, 실제 화면에 첫 토큰이 나타날 때까지 직접 잰 시간도 기록해요.
| 단계·지표 | 하는 일 | 사용자가 기다리는 순간 |
|---|---|---|
| 프리필 | 입력 토큰과 문맥을 처리해 답을 준비해요. | 코드와 오류 설명을 보낸 뒤 첫 토큰 전 |
| TTFT | 요청부터 첫 출력 토큰까지의 전체 지연이에요. | 화면에 답변 첫 부분이 나타날 때까지 |
| 디코드 | 첫 토큰 뒤 출력 토큰을 차례로 생성해요. | 답변이 화면에 계속 이어지는 동안 |
| 완료 시간 | 첫 토큰 전 지연과 답변 생성이 모두 끝날 때까지예요. | 전체 리뷰가 완성될 때까지 |
답이 이어지는 속도는 디코드로 비교해요
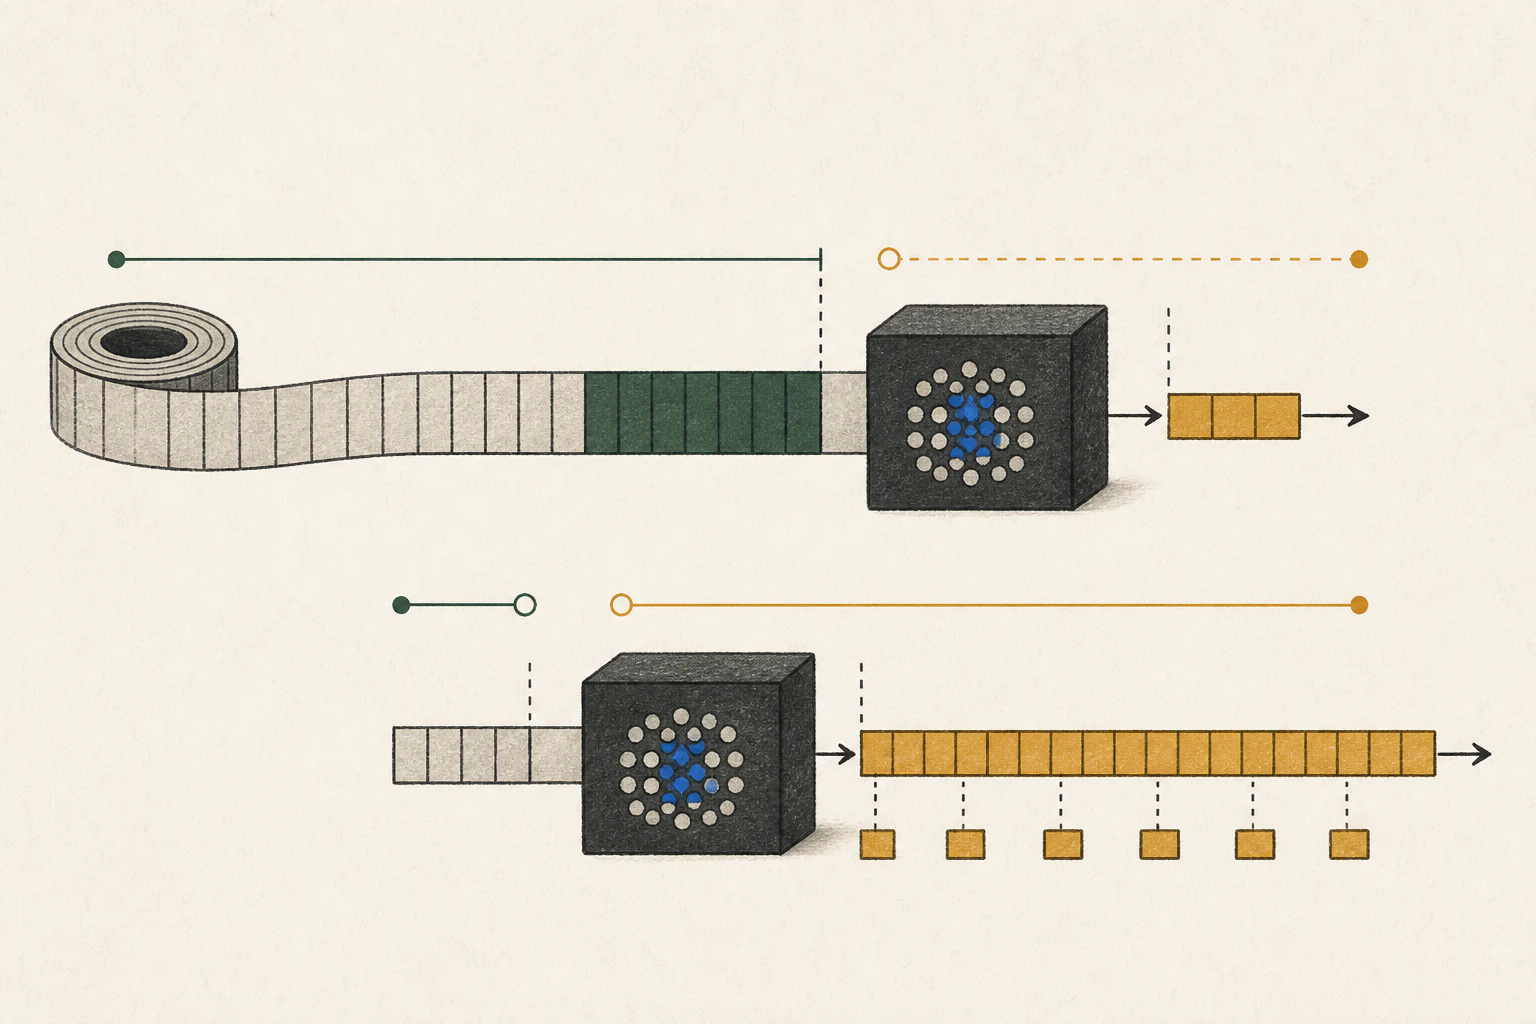
첫 토큰 뒤 답변이 이어지는 속도는 초당 토큰 수(tok/s)로 나타내요. 같은 토큰 수의 답이라면 tok/s가 높을수록 디코드 시간이 짧아요. 다만 한국어 글자 수와 토큰 수는 일대일이 아니므로, tok/s만으로 완료 시간을 정확히 계산할 수는 없어요.
오류 원인 한 줄만 물으면 출력이 짧아 첫 토큰까지의 기다림이 더 크게 느껴질 수 있어요. 여러 파일의 수정 방향과 근거를 요청하면 답이 길어져, 시작은 빨라도 끝까지 받는 데 시간이 걸릴 수 있죠. 원하는 답의 길이에 따라 더 중요하게 볼 지표가 달라져요.
첫 응답부터 완료까지 시간을 계산해요
예를 들어 TTFT가 8초이고 답변이 500토큰, 디코드 속도가 50 tok/s라면 생성에 500÷50=10초가 걸려요. 첫 토큰까지 기다린 시간도 더해 완료까지 약 18초예요. 프리필이 개선돼 TTFT가 4초가 되면 약 14초, 디코드가 100 tok/s가 되면 약 13초로 계산돼요. 실제 완료 시간은 첫 토큰 전 지연과 남은 답변 생성 시간을 합친 값이에요. 아래는 계산을 단순화한 가정이지 장비 실측이 아니에요.
좌우로 밀어 표 전체를 비교하세요.
| 가정 | TTFT | 디코드 속도 | 완료까지 |
|---|---|---|---|
| 기준 | 8초 | 50 tok/s | 약 18초 (8+500÷50) |
| 프리필 개선 | 4초 | 50 tok/s | 약 14초 (4+500÷50) |
| 디코드 개선 | 8초 | 100 tok/s | 약 13초 (8+500÷100) |
반복 입력과 새 입력은 다르게 처리돼요
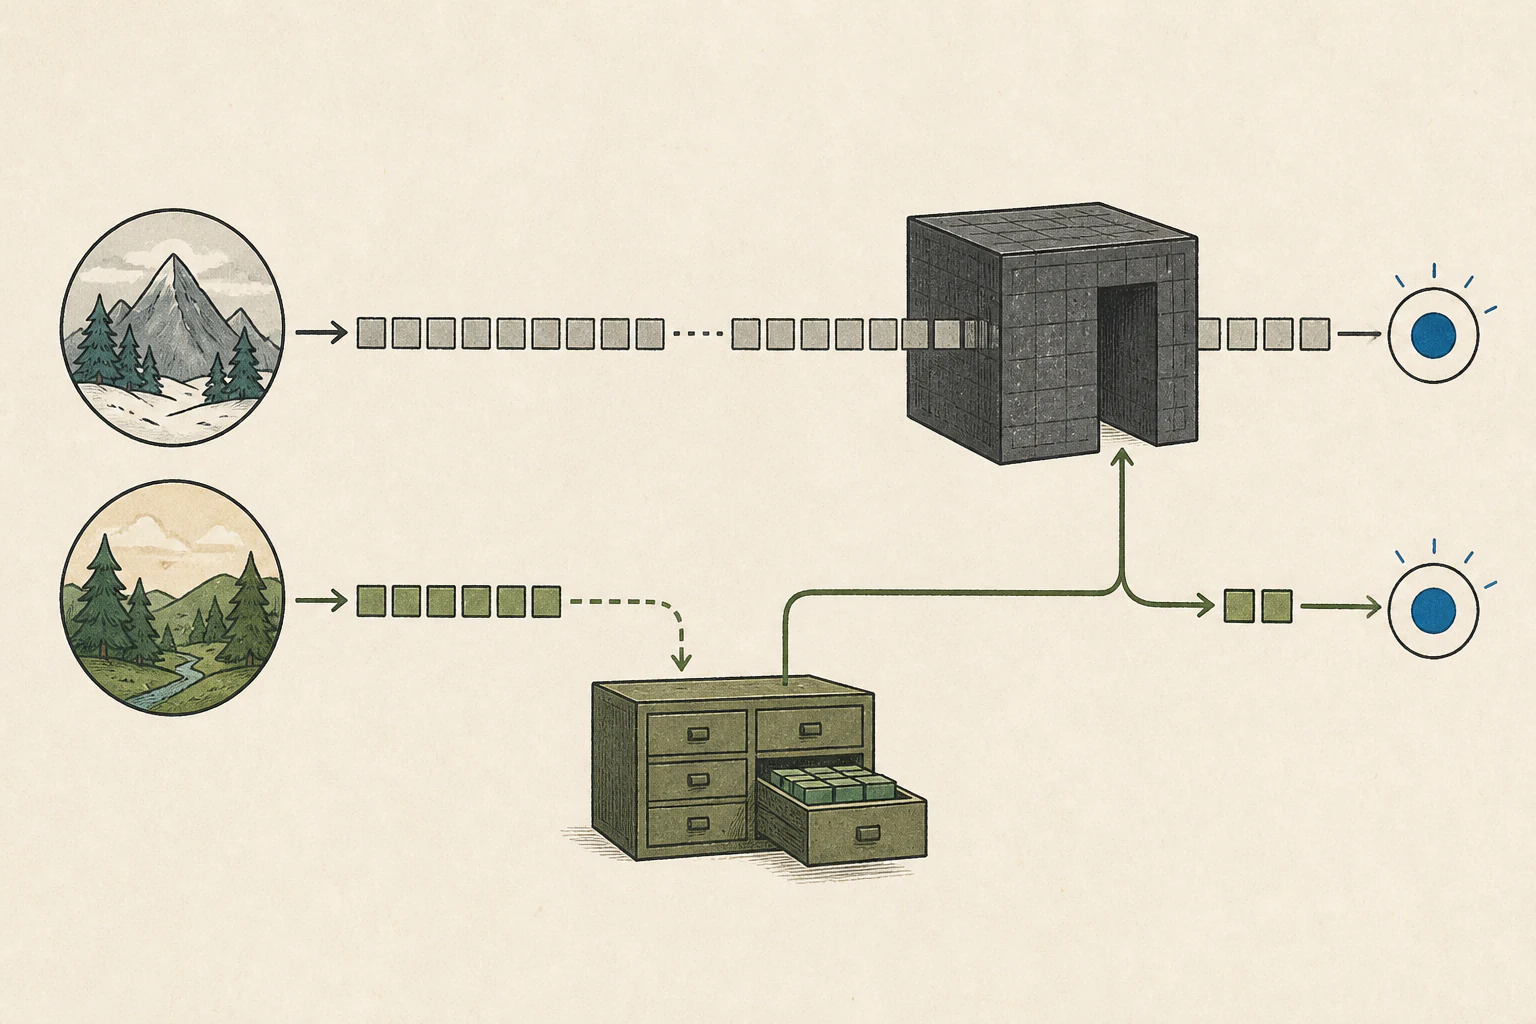
같은 코드 리뷰를 이어갈 때 입력 앞부분이 반복되면 프롬프트7 캐시가 그 계산 상태를 재사용해 TTFT를 줄일 수 있어요. 이는 SSD8에서 모델 파일을 다시 불러오는 일과 달라요. 캐시가 유지되는지, 질문 앞부분이 얼마나 일치하는지에 따라 재사용량이 달라져요.
SpecPrefill9은 긴 새 입력에서 처리할 토큰을 선별해 본 모델이 계산할 양을 줄이려는 방법이에요. 프롬프트 캐시가 이전 요청의 공통 입력을 다시 쓴다면, SpecPrefill은 새 입력에서 처리할 부분을 골라요. 코드 리뷰에서는 빠진 부분에 오류 원인이 있을 수 있으므로 필요한 근거가 답에서 유지되는지 원본 코드와 대조해요.
후속 질문은 문서의 다른 구절이나 앞선 대화를 더 포함할 수 있어 입력 전체가 짧아지지는 않아요. 새로 검색된 문단은 처리해야 하고, 캐시가 일부 공통 prefix를 재사용할 수 있어요. 자료 이름, 질문, 문서 처리 방식, 모델, 앱 버전을 기록하면 결과를 다시 확인하기 쉬워요.
내 작업에서 기다리는 구간을 직접 비교해요
같은 코드와 질문을 고정해 모델을 비교하면 첫 답이 늦는지, 답변이 천천히 이어지는지 나눠 볼 수 있어요. 같은 조건으로 몇 번 실행해 TTFT와 완료 시간을 따로 적고, 새 대화의 첫 요청인지 캐시가 남은 후속 질문인지 표시해요.
비교 화면에서 입력 길이를 바꾸거나 전체 모드와 디코드만 모드를 선택할 수 있어요. 전체 모드는 첫 토큰 전 지연과 답변 생성을 합쳐 보여주고, 디코드만 모드는 출력이 이어지는 속도를 비교해요. 표시값은 선택한 조건의 예상치라 실제 앱에서 같은 코드를 실행한 시간과 다를 수 있어요.
용어 각주
대규모 언어 모델 — 대규모 텍스트 데이터에서 언어 패턴을 학습해 문맥에 맞는 텍스트를 처리하고 생성하는 모델입니다.
본문으로 돌아가기토큰 — 모델이 입력이나 출력을 나누어 처리하는 단위입니다.
본문으로 돌아가기프리필 — LLM이 입력 프롬프트를 읽고 각 토큰의 내부 표현을 계산하는 단계입니다. 입력이 길수록 처리할 토큰이 많아집니다.
본문으로 돌아가기토큰 디코드 — 입력과 앞서 만든 답변을 바탕으로 다음 출력 토큰을 차례로 생성하는 단계입니다.
본문으로 돌아가기첫 토큰 지연 — 요청을 보낸 뒤 첫 출력 토큰이 도착하기까지 걸린 시간입니다.
본문으로 돌아가기처리량 — 일정 시간 동안 처리하거나 생성한 작업량입니다. 토큰/초, 요청/초처럼 단위를 함께 확인해야 비교할 수 있습니다.
본문으로 돌아가기프롬프트 — 모델에 보내는 입력문입니다. 생성 모델에서는 만들 결과를 설명하는 문장이 되어 출력의 구성과 내용을 크게 좌우합니다.
본문으로 돌아가기SSD — 플래시 메모리를 사용하는 데이터 저장 장치입니다. 전원이 꺼져도 데이터가 보존됩니다.
본문으로 돌아가기SpecPrefill — 가벼운 모델로 입력 토큰의 중요도를 추정하고, 선택한 토큰을 본 모델에 전달해 프리필 계산을 줄이는 기법입니다. 본 모델이 읽지 않는 문맥이 생기므로 토큰 선택이 답변에 반영될 정보를 바꿀 수 있습니다.
본문으로 돌아가기
자주 묻는 질문
- 이 글에서 가장 먼저 확인할 것은 무엇인가요?
- 코드와 오류 설명을 보내면 LLM은 먼저 입력을 읽고, 이어서 리뷰 답변을 만들어요. 입력 토큰을 처리하는 단계는 프리필(prefill), 답변 토큰을 차례로 만드는 단계는 디코드(decode)예요. 프리필이 끝난 뒤 첫 답이 나오고, 디코드 동안 나머지 답이 이어져요.