
실행 프로그램과 확장
최종 업데이트
Jev는 무엇인가: 답변을 쓰지 않고 결정을 내리는 System One 모델
Jev는 문장 대신 선택값과 신뢰도를 돌려줘요
Jev는 문서나 문의를 입력받아 정해 둔 선택지와 신뢰도를 반환하는 판단 모델이에요. 담당 부서나 위험 등급처럼 다음 프로그램이 바로 사용할 값을 만들어요. 반복 분류를 자동화하고, 설명이 필요한 단계는 일반 LLM1이나 사람에게 맡길 수 있어요.
Jev형 모델을 내 PC나 Mac에서 로컬로 돌릴 수 있는지 궁금하다면, 먼저 이 모델이 무엇을 돌려주는지부터 확인하세요. 예를 들어 문의를 billing·access·security 중 한 곳에 전달해야 한다면, 설명문보다 담당 부서 값 하나가 다음 단계에 더 유용할 수 있어요. Jev형 요청은 판단 항목과 선택지를 먼저 정하고 문의를 입력해요. 속도의 핵심은 결과 형식이 짧다는 점이에요.
문의 문장을 다음 처리 코드가 쓸 값으로 바꿔요
‘이번 달 요금제가 두 번 청구된 것 같아요’라는 문의를 분류하는 예로 살펴볼게요. 담당 부서 항목에 billing·access·security 선택지를 지정하고 문의 본문을 입력해요. 반환된 billing 값은 청구 담당 작업함으로 연결하고, 신뢰도가 낮은 문의는 사람이 검토하도록 나눌 수 있어요.
분류만 필요한 단계와 환불 절차를 설명하거나 추가 질문으로 모호함을 푸는 단계는 달라요. 다음 프로그램이 담당 부서만 알면 된다면 자유 문장을 다시 해석할 필요가 없지만, 상담 자체를 끝내려면 설명과 대화가 여전히 필요해요.
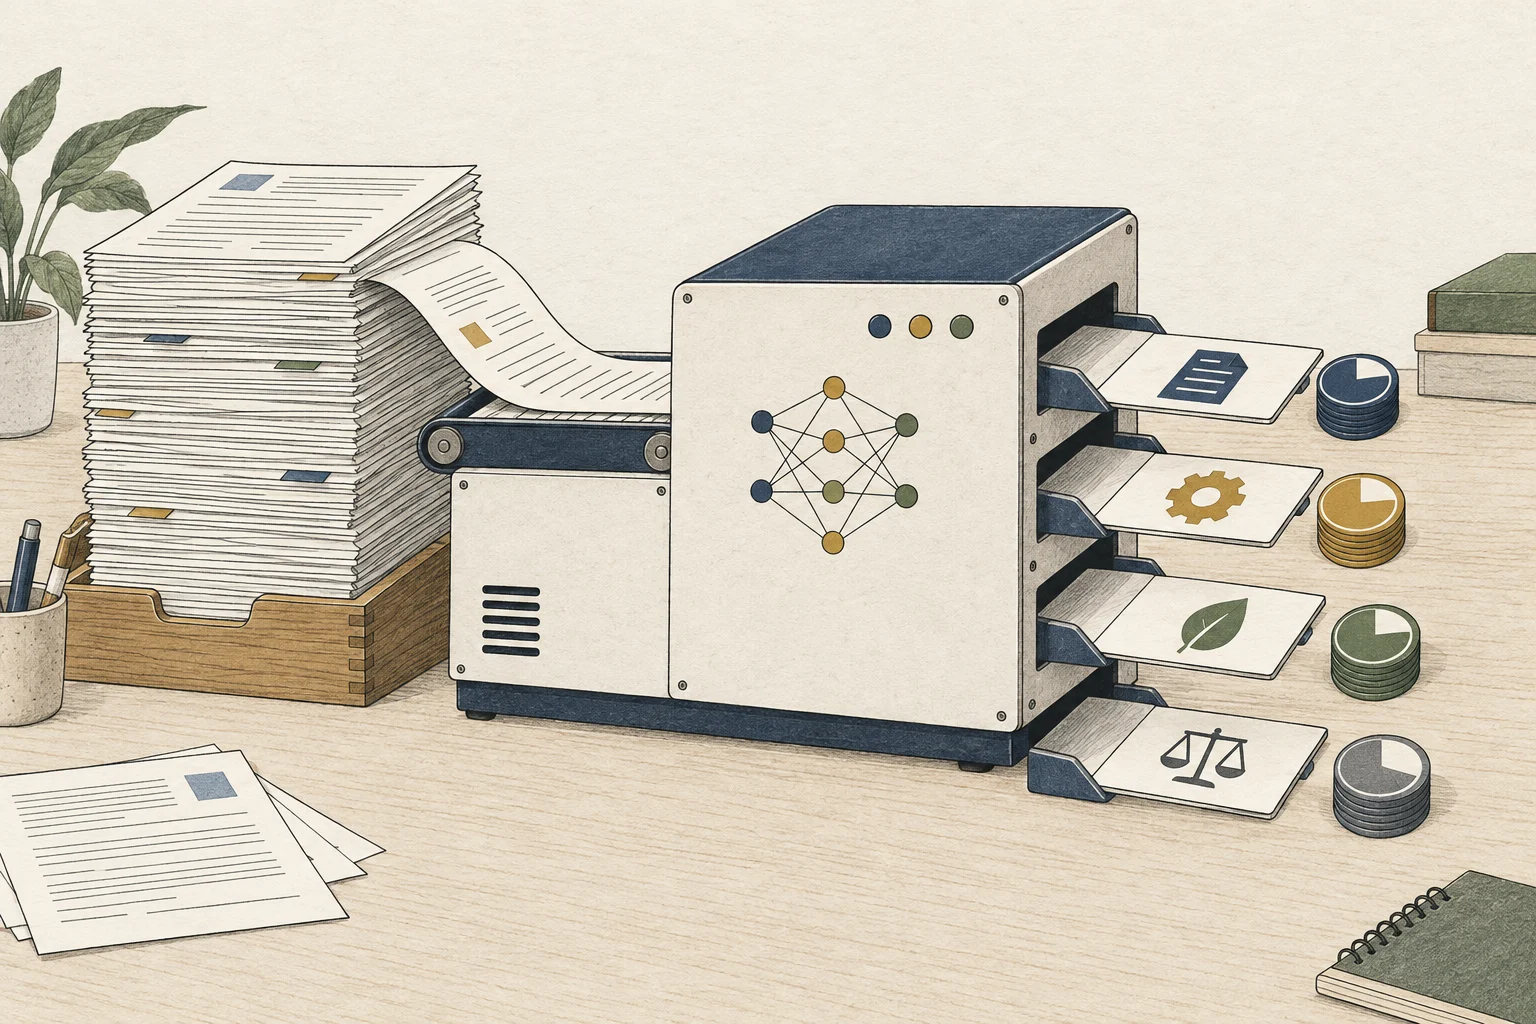
정해진 판단 항목을 함께 계산해요
일반 LLM은 JSON 모드에서도 괄호·키·값을 토큰2별로 생성해요. Jev는 출력 구조와 후보를 미리 정하고 여러 판단을 병렬로 계산할 수 있어 생성해야 할 대상이 달라요. TypeSafe는 자사 서비스의 종단 지연을 70~500ms라고 설명하지만, 이는 해당 서비스가 공개한 범위예요. 지역·입력 길이·질문 수 모두에서 보장되는 시간이 아니에요.
비교하려면 같은 문의 본문과 후보 수를 쓰고 네트워크 대기를 양쪽에 똑같이 포함해요. 일반 LLM의 JSON 생성 시간과 Jev의 종단 시간을 비교하면 측정 범위가 달라요. 이 가이드는 공개값을 해석할 뿐 새 지연 측정이나 모든 조건의 우위를 주장하지 않아요.
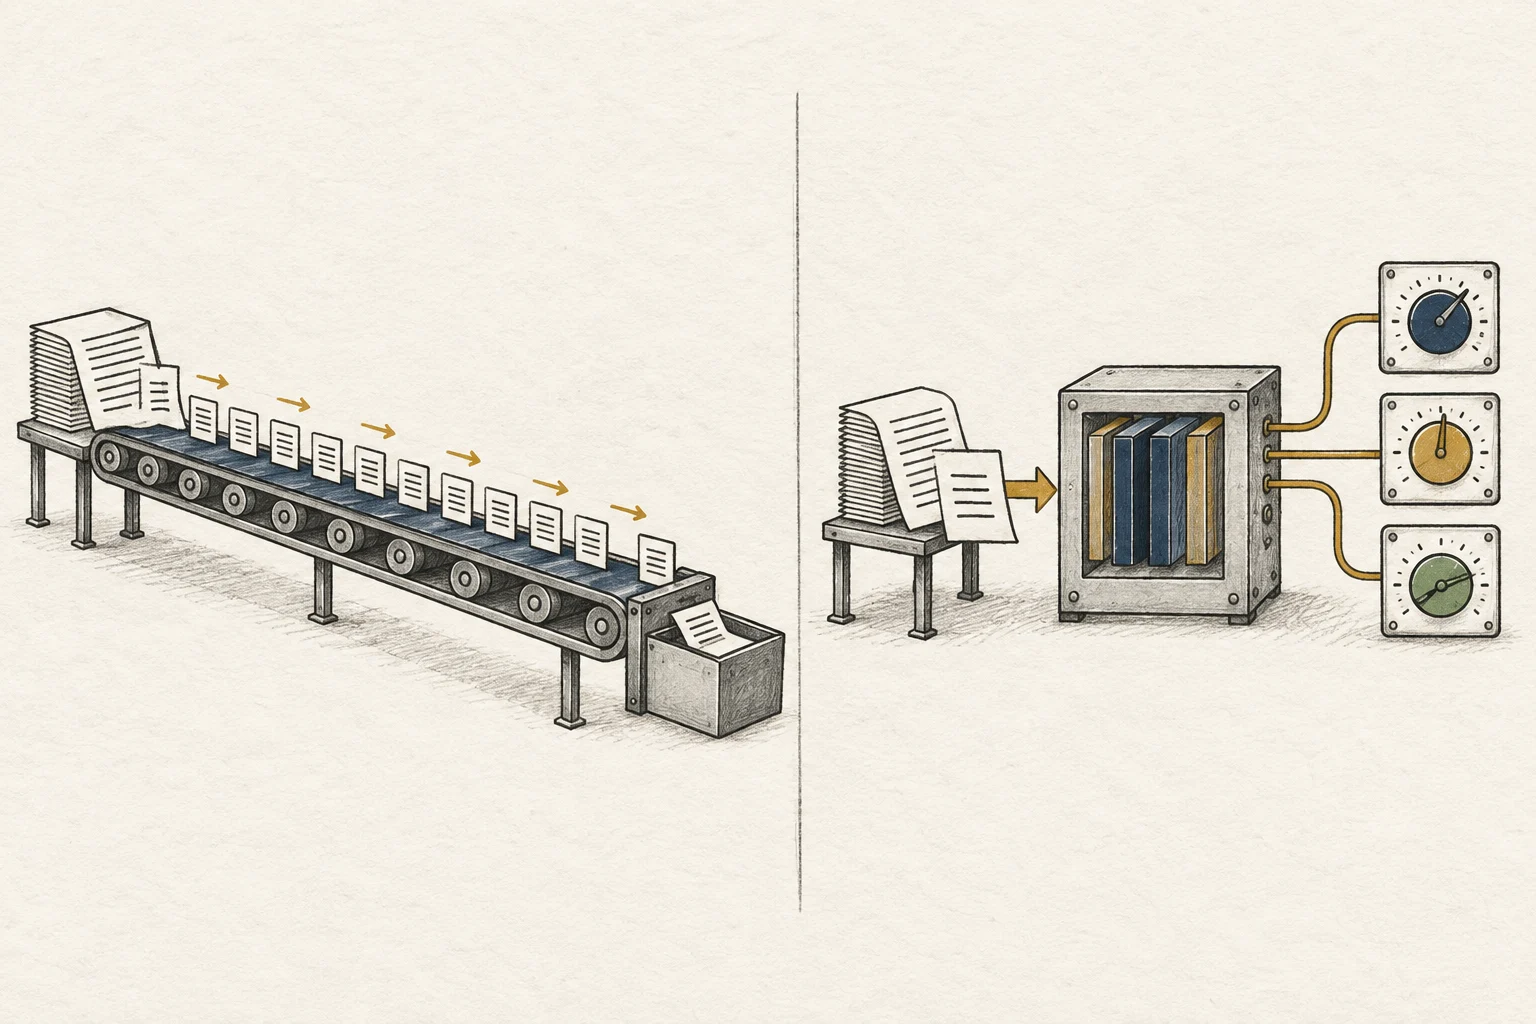
JEV는 답변 문장 대신 선택 점수를 계산해요
JEV형 결정 모델은 상황·질문·허용 선택지를 받아 선택별 점수나 확률을 반환해요. 반복 티켓 분류나 상태 판정처럼 정해진 값이 다음 시스템으로 넘어갈 때 맞고, 자유로운 설명문이 필요한 일은 별도 생성 모델에 맡기는 편이 안전해요.
공개 비교표의 RTX PRO 6000 단일 질문 중앙값은 Julia-1 3ms, Laya 5ms, Kev-4B 12ms, lev 36ms, OpenJev 43ms예요. 이 다섯 항목과 각 모델 규모·언어를 표에 함께 적고, 다른 동시성이나 입력 길이의 운영 지연과 분리해요.
업무의 정답과 검토 기준을 정해요
선택지를 고정하면 billing·access·security 밖의 값을 만들거나 JSON 구조를 깨뜨리는 형식 오류를 줄일 수 있어요. 그러나 결제 두 건이 모두 완료됐는지, 한 건이 승인 대기인지, 계정 접근 이상이 있는지 정보가 빠졌다면 billing 분류가 틀릴 수 있어요. 형식 유효성과 업무 정확도는 별개예요.
확률이 높아도 정답을 보장하지 않아요. 확률 기준보다 낮거나 후보 차이가 작으면 담당자가 읽도록 넘기고, 오류 비용이 큰 권한·결제 판단은 자동 승인하지 않아요. 시험 자료는 사람이 먼저 라벨링하고 자동 결과를 기준 답과 대조해 오분류와 사람 검토 전환을 나눠 살펴요.
반복 분류와 라우팅은 맞고 설명은 LLM에 맡겨요
담당 부서 지정, 위험 점수, 후보 순위, 정책 허용 여부처럼 출력 범위가 정해진 업무는 구조화된 값으로 다음 단계에 넘기기 쉬워요. 반면 이중 청구의 원인 설명, 환불 단계 안내, 추가 사실을 묻는 상담에는 자유 문장이 필요해요. Jev와 일반 LLM을 분류 단계와 설명 단계에 나눠 쓸 수 있지만, 연결만으로 정확도나 속도가 보장되지는 않아요.
자동화 설계에서는 분류값이 다음 단계에 미치는 영향을 그려요. 작업함만 정하는 값과 환불을 자동 승인하는 값은 허용 오류와 검토 방식이 달라요. 같은 모델이어도 뒤에 연결된 권한이 무엇인지에 따라 자동화 범위를 정해야 해요.
판단 head와 후보 점수 경로를 구분해요
Qwen 기반 로컬 구현도 비교할 수 있어요
TypeSafe의 Jev는 가중치와 훈련 방식을 비공개로 운영해요. 로컬에서는 공개 Qwen 체크포인트의 후보 로짓을 읽거나, 공통 문서를 프리필5한 뒤 여러 질문으로 분기하는 프로젝트를 사용할 수 있어요. 이런 프로젝트는 Jev형 선택값 반환을 별도 방식으로 구현해요.
모델·프롬프트6·입력 처리·병렬화가 구현마다 다를 수 있어요. 로컬 구성의 정확도와 확률 보정, 지연은 같은 자료와 조건으로 확인해요. ‘Jev와 같다’고 단정하기보다 ‘Jev형 판단 방식을 재현하려는 구현’이라고 구분해요.
직접 실행해 보고 싶다면 Qwen 기반 로컬 Jev 구현 비교에서 시작하세요. CPU7로 시험하는 방법과 Mac·NVIDIA GPU8를 사용하는 프로젝트를 나눠 정리했어요.
JEV-27B-VL은 이미지에서 선택 확률을 돌려줘요
텍스트 문의에서 담당팀을 고르던 Jev형 판단을 사진이나 화면에 적용할 수 있도록 AutoTrust가 autotrust/JEV-27B-VL을 공개했어요. System 1은 이미지와 문장을 함께 받고 yes/no, 2~256개 후보 중 선택, 0–5점 평가의 확률을 한 번의 forward pass로 반환해요. 같은 저장소의
System 2는 Qwen3.8-27B 기반의 일반 이미지 입력 텍스트·추론을 맡아요. 모델은 Apache-2.0이며 28B BF169 가중치를 포함해요. 공식 모델 카드와 2026-09-30 발표
이미지의 상품 사진을 electronics, clothing, home 중 하나로 분류하는 작업을 생각해 봐요. state에 사진과 판매자 제목을 넣고 question에 분류 기준을 적으면 후보별 확률을 받을 수 있어요. 선택한 항목만 필요할 때는 choice, 안전 여부처럼 참일 확률을 읽을 때는 noul을 사용해요. 확률이 높다는 이유만으로 결제나 권한을 자동 처리하지 말고, 사람이 라벨링한 이미지 묶음으로 오분류와 보류 기준을 먼저 평가해요.
명령이 끝나면 JSON 응답에 후보 목록과 probabilities가 돌아와요. hf: command not found는 huggingface_hub CLI10 설치 여부를, 이미지 요청이 거절되면 state 배열의 {"image": URL} 형태와 이미지 URL 접근 가능성을 먼저 확인해요. /v1/decide 경로 오류는 서버 로그에서 serve_decide.py가 vLLM 개발 환경으로 시작됐는지 확인해요. 공식 결정 API와 이미지 입력 형식
| 경로 | 적합한 입력 | 공식 실행 조건 |
|---|---|---|
Ollama /v1/systemone | Nimble·Tev 기반 텍스트 선택·참거짓·점수 | Ollama 0.35.0 이상 및 지원 모델 |
JEV-27B-VL /v1/decide | 텍스트와 이미지의 선택 확률 | vLLM 개발 빌드, 80GB+ GPU 권장 |
python -m pip install -U huggingface_hub
hf download autotrust/JEV-27B-VL --local-dir JEV-27B-VL
python3 JEV-27B-VL/serve_decide.py --model JEV-27B-VL --served-model-name autotrust/JEV-27B-VL --host 127.0.0.1 --port 8000 --enable-lora --max-lora-rank 32 --lora-modules jev-decision=JEV-27B-VL/adapter_vllm --logprobs-mode processed_logprobs --max-model-len 32768 --enable-prefix-caching --mamba-cache-mode align --limit-mm-per-prompt '{"image": 8}' --max-num-seqs 8 --trust-request-chat-templatecurl http://127.0.0.1:8000/v1/decide -H 'Content-Type: application/json' -d '{"kind":"choice","state":["Photo: ", {"image":"https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/p-blog/candy.JPG"}],"question":"Which category fits this image?","options":["food","electronics","clothing","home"]}'정확도와 대기시간을 같은 업무 표본에서 봐요
티켓 100개에 gold action과 ‘판단 불가’ 선택지를 넣고, 모델별 정확 일치율·오류 유형·빈 응답을 집계해요. 같은 장치에서 입력 길이별 지연을 반복 측정해 p50·p95도 함께 기록해요.
비용이 큰 자동 결정은 confidence 임계값 아래에서 사람에게 넘기세요. 빠른 결과만으로 배포하지 않고, 잘못된 자동화가 실제 업무에 미치는 손실과 검토 비용도 함께 비교해요.
화면 조작 점수는 입력 요소와 시험 규모까지 읽어요
AutoTrust는 2026-10-03 카드 업데이트에서 headless Chromium 브라우저의 무작위 다단계 작업 60개 중 95%를 완료했고, 클릭마다 약 0.26초가 걸렸다고 보고했어요. 작업은 쇼핑·설정·메일 화면에서 3~7번 클릭하는 구성이에요. 각 대상의 번호 상자뿐 아니라 화면 요소의 텍스트도 모델에 제공했어요. 번호 상자만 준 별도 조건에서는 완료율이 10%였으므로, 95% 결과를 스크린샷만 보내는 일반 GUI 성공률로 읽으면 안 돼요. 공식 카드의 computer-use 조건
로봇 팔 결과도 실제 로봇 장비가 아니라 MuJoCo 시뮬레이션의 무작위 장면 20개에서 75%를 완료한 값이에요. 한 단계 판단은 약 240ms였어요. 화면 조작의 click 지연과 로봇 판단 지연은 작업 루프와 환경이 달라 서로 직접 비교할 수 없어요. vLLM 서버의 메모리 표에는 BF16 가중치 52GB와 256K prompt의 KV cache11 약 17GB가 제시되어 있고, 183GB B200에서 측정한 조건이에요. 80GB GPU는 --max-model-len 131072부터 시작하라고 카드가 권해요.
| 시험 | 공식 평가 결과 | 조건과 한계 |
|---|---|---|
| 브라우저 computer use | 60개 중 95%, 약 0.26초/click | headless Chromium, 3–7 click, 번호 상자+요소 텍스트 |
| MuJoCo 로봇 팔 | 20개 중 75%, 약 240ms/decision | 시뮬레이션, 실제 robot 실측 아님 |
| 256K 텍스트 prompt | 약 8,700 prompt tok/s | 단일 B200, 요청 하나씩, 250K prompt |
용어 각주
대규모 언어 모델 — 대규모 텍스트 데이터에서 언어 패턴을 학습해 문맥에 맞는 텍스트를 처리하고 생성하는 모델입니다.
본문으로 돌아가기토큰 — 모델이 입력이나 출력을 나누어 처리하는 단위입니다.
본문으로 돌아가기체크포인트 — 학습된 모델의 가중치 등을 저장한 파일입니다. 같은 모델 계열도 버전이나 용도에 따라 다른 체크포인트를 쓸 수 있습니다.
본문으로 돌아가기API — 프로그램의 기능을 다른 코드에서 호출하기 위한 약속된 인터페이스입니다.
본문으로 돌아가기프리필 — LLM이 입력 프롬프트를 읽고 각 토큰의 내부 표현을 계산하는 단계입니다. 입력이 길수록 처리할 토큰이 많아집니다.
본문으로 돌아가기프롬프트 — 모델에 보내는 입력문입니다. 생성 모델에서는 만들 결과를 설명하는 문장이 되어 출력의 구성과 내용을 크게 좌우합니다.
본문으로 돌아가기CPU — 운영체제와 일반 프로그램 명령을 실행하고, AI에서는 전처리·데이터 이동 등 범용 연산을 맡는 중앙 처리 장치입니다.
본문으로 돌아가기GPU — 많은 계산을 병렬로 처리하는 프로세서입니다. AI 모델 실행에서는 모델 계산을 맡습니다.
본문으로 돌아가기BF16 — 모델 수치를 저장하고 계산하는 16비트 부동소수점 형식입니다. FP32와 같은 폭의 지수부를 써 넓은 값 범위를 표현합니다.
본문으로 돌아가기CLI — Command-Line Interface의 약자입니다. 터미널에 명령어를 입력해 프로그램을 조작하는 방식입니다.
본문으로 돌아가기KV 캐시 — 어텐션에서 이전 토큰의 키·값을 저장해 다음 토큰 생성 때 재사용하는 메모리입니다. 문맥 길이와 배치 크기에 따라 용량이 달라집니다.
본문으로 돌아가기
자주 묻는 질문
- 이 글에서 가장 먼저 확인할 것은 무엇인가요?
- Jev는 문서나 문의를 입력받아 정해 둔 선택지와 신뢰도를 반환하는 판단 모델이에요. 담당 부서나 위험 등급처럼 다음 프로그램이 바로 사용할 값을 만들어요. 반복 분류를 자동화하고, 설명이 필요한 단계는 일반 LLM이나 사람에게 맡길 수 있어요.
- 필요한 메모리는 어느 정도인가요?
- 로봇 팔 결과도 실제 로봇 장비가 아니라 MuJoCo 시뮬레이션의 무작위 장면 20개에서 75%를 완료한 값이에요. 한 단계 판단은 약 240ms였어요. 화면 조작의 click 지연과 로봇 판단 지연은 작업 루프와 환경이 달라 서로 직접 비교할 수 없어요. vLLM 서버의 메모리 표에는 BF16 가중치 52GB와 256K prompt의 KV cache 약 17GB가 제시되어 있고, 183GB B200에서 측정한 조건이에요. 80GB GPU는 `--max-model-len 131072`부터 시작하라고 카드가 권해요.
- 조건과 출처는 어디서 확인하나요?
- System 2는 Qwen3.8-27B 기반의 일반 이미지 입력 텍스트·추론을 맡아요. 모델은 Apache-2.0이며 28B BF16 가중치를 포함해요. [공식 모델 카드](https://huggingface.co/autotrust/JEV-27B-VL)와 [2026-09-30 발표](https://huggingface.co/blog/autotrust/autotrustjev-27b-vl-a-decision-model-that-learned)