
실행 프로그램과 확장
최종 업데이트
Qwen으로 로컬 Jev 비슷하게 만들기: SemIf·Simple Jev·openjev-sglang
Qwen 기반 Jev형 구현은 로짓 읽기·API 실험·서버 처리 목적이 달라요
Qwen을 사용하는 Jev형 프로젝트는 문서와 선택지를 입력받아 분류값과 후보 점수를 반환해요. SemIf는 4B 개인 장비 실험, Simple Jev는 0.8B CPU1 API2 시연, openjev-sglang은 35B 서버 병렬 처리에 초점을 둬요. 사용할 장비와 판단 업무에 맞춰 시작점을 골라요.
Jev형 판단을 로컬에서 만들려는 프로젝트는 점수만 읽는 구현, API 시연, 전용 학습, 서버 처리량3처럼 출발점이 달라요. 먼저 모델과 실행 경로를 파악한 뒤, 목적에 맞는 같은 자료로 선택 정확도와 지연을 따로 확인해요.
후보 토큰의 점수를 읽어 선택값을 만들어요
담당 부서 후보를 billing·access·security로 정하고 문의를 입력하면, 모델의 다음 위치 점수(logit)를 읽어 후보 안에서 softmax 상대 확률을 구할 수 있어요. 출력 문장이나 긴 JSON은 생성하지 않고 서버 코드가 구조를 만들어요. 다만 각 라벨이 예상대로 한 토큰4인지, 모델이 뜻을 구분하는지, 확률이 실제 정답률에 맞는지는 따로 검증해야 해요.
설명용 예로 후보 점수가 2·1·0이면 softmax는 약 66.5%·24.5%·9.0%예요. 이는 세 후보 안에서 정규화한 점수이지 첫 후보가 실제 정답일 확률을 보증하지 않아요.
SemIf는 4B 개인 장비 비교에 맞춘 프로젝트예요
SemIf는 이름이 바뀐 이전 OpenJev 저장소에서 이어진 프로젝트로 Qwen3.5-4B 후보 로짓을 직접 읽어요. 여러 질문에서 공통 문서 프리필5을 재사용해 질문별 분기를 병렬 평가할 수 있고, CUDA6의 RTX 3090 실험 기록과 Apple Silicon MLX7 백엔드도 공개돼 있어요. 개인 장비에서 재현 가능한 기준점을 찾을 때 서버형보다 가까운 출발점이에요.
빠른 shared 경로의 선택이 기본 점수화와 다를 수 있으므로 지연과 함께 선택값 일치도도 기록해요. 같은 문의와 모델 리비전을 고정하고 fresh 경로와 shared 경로를 같은 평가 자료로 대조해요. 경로 간 결과 일치도만으로 정답 여부를 판단하지 말고 사람이 라벨한 기준 답과 비교해 오분류를 세요.
Simple Jev는 CPU에서 API 형태를 익히는 예제예요
Simple Jev는 분류 헤드를 다시 학습하기보다 Transformers·PyTorch8로 공개 모델의 로짓을 읽어요. Qwen3.5-0.8B를 CPU에서 시작할 수 있는 예제가 있어 고성능 GPU9 없이 요청과 응답 구조를 확인하기 좋아요. 작은 후보 집합으로 선택값과 확률이 예상한 형식으로 나오는지 먼저 시험해요.
요청이 성공하면 API 흐름은 확인된 것이지만 업무 판단의 정확도는 따로 평가해야 해요. 호환 API의 /v1/classifier와 /v1/systemone이 같은 구현을 부르는지도 확인할 수 있어요. 인터페이스 호환성과 품질을 구분하고, 의미상 오류 사례를 모은 뒤 4B 모델이 필요한지 판단해요.
프로젝트를 크기보다 구현 경로로 골라요
Simple Jev는 CPU에서 결정 API 형태를 익히는 작은 출발점이고, SemIf는 Qwen 4B 계열을 개인 장비에서 비교하는 경로예요. openjev-sglang은 B200 서버의 병렬 실행을 다루므로 데스크톱 실습과 같은 전제로 보면 안 됩니다.
후보 점수 API와 /v1/systemone 서버 요청은 서로 다른 실행 방식이에요. 공통으로 비교할 티켓과 action 이름은 고정하되, 각 저장소 예제가 요구하는 입력 필드와 선택지 순서에 맞춰 요청을 변환하세요.
openjev-sglang은 B200 서버의 병렬 처리 기준선이에요
openjev-sglang은 Qwen3.6-35B-A3B NVFP410 체크포인트11를 SGLang에서 제공하고 radix cache와 병렬 요청을 활용해요. 공개 기본 환경은 B200 한 장이므로 개인 GPU용 설치 예시로 읽지 않아요. 참고할 점은 여러 질문의 공통 접두사를 유지해 프리필을 재사용하는 서버 설계예요.
공개 64개 질문 처리량은 가속기·입력 길이·동시성 조건의 값이에요. 처리량과 한 요청의 지연은 달라요. 예를 들어 64개가 4초에 완료됐다는 가정은 초당 16개 처리량일 뿐, 각 요청이 1/16초 만에 끝났다는 뜻은 아니에요. 이 계산은 개념 설명용 가정이며 B200 측정치를 재표현한 것이 아니에요.
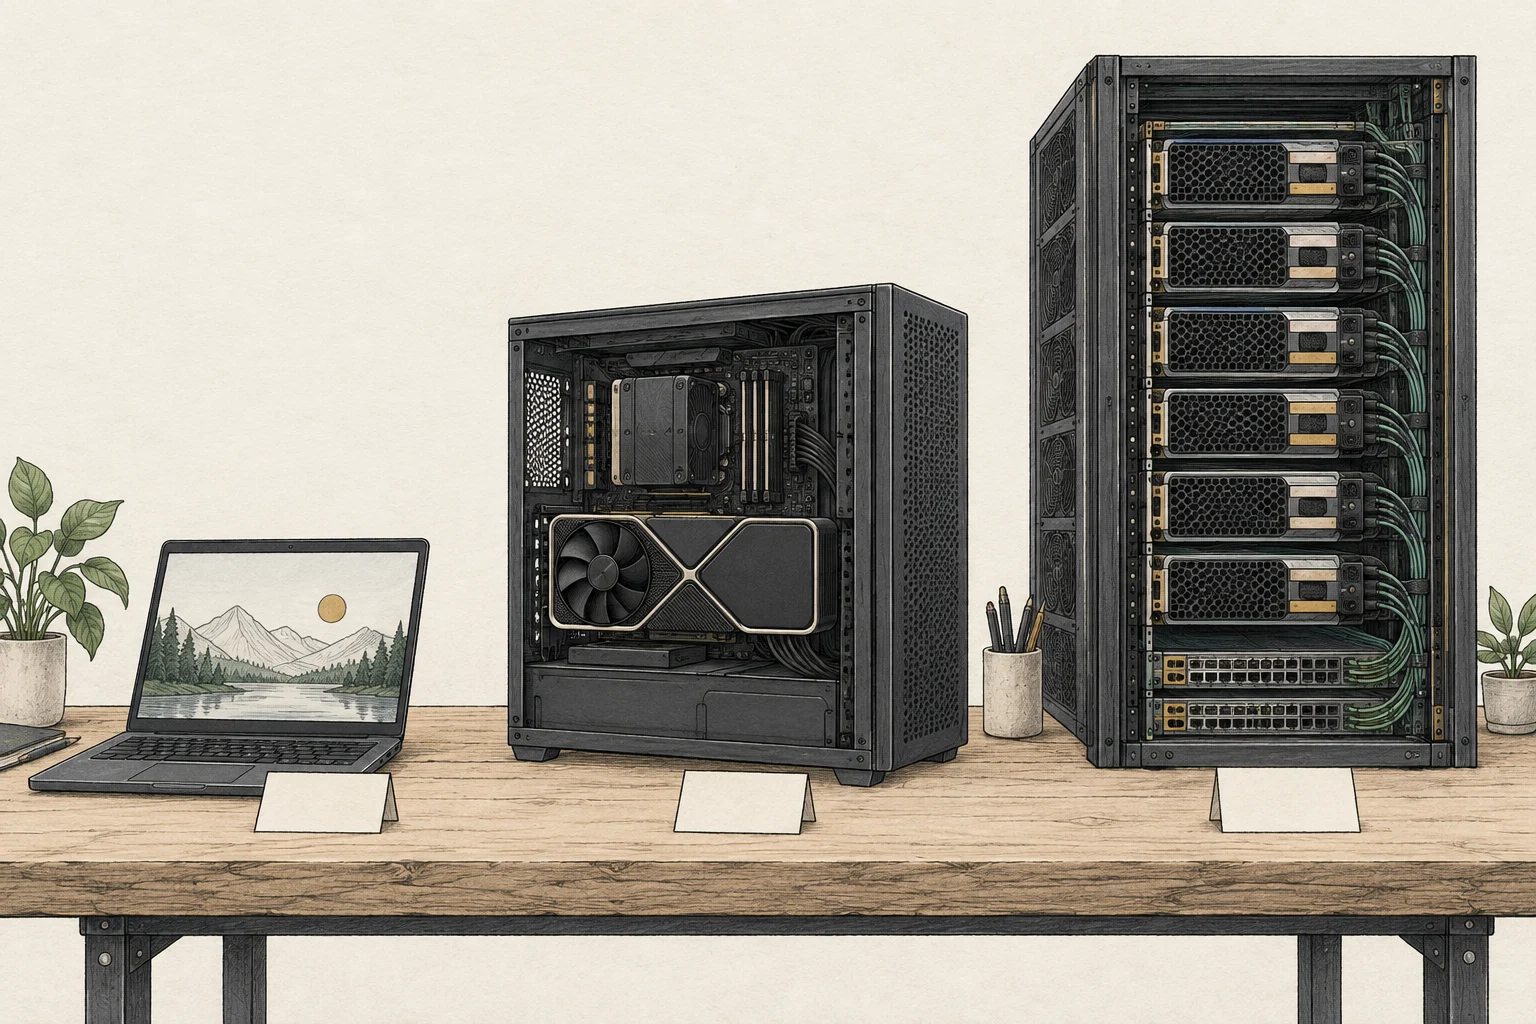
같은 선택지와 문서로 각 저장소를 확인해요
세 프로젝트에 같은 티켓과 action 후보를 적용해요. 요청 JSON은 프로젝트별 공식 인터페이스에 맞게 변환한 뒤, 응답의 키와 각 확률이 어떤 선택지에 대응하는지 기록하세요.
CPU 실험에는 로드 시간과 질문당 지연, 4B 개인 GPU 실행에는 VRAM12·batch 제한, 서버 실행에는 요청 동시성·GPU 사용량을 각각 기록합니다. 측정 조건이 다른 숫자를 한 순위표에 합치지 않아요.
학습형 프로젝트는 사용 자료와 오류 비용으로 골라요
kev는 Qwen2.5-0.5B에 LoRA13와 작은 판독 헤드를 더해 문서와 여러 질문을 한 시퀀스에서 다뤄요. qwen-rlcd는 Qwen3.5-0.8B를 Choice·Score·Noul 판단에 맞춰 학습해요. 이들은 점수를 그대로 읽는 기준선보다 판단 구조에 맞추지만, 학습·평가 자료 범위에 성능이 제한될 수 있어요.
‘두 번 청구’와 ‘중복 결제된 듯함’처럼 표현이 달라도 결과가 유지되는지, 확률이 검토에 쓸 만한지 시험해요. 기준선·작은 CPU API·B200 서버는 모델과 작업이 다르므로 같은 순위로 세우지 말고, 정확도·확률 보정·지연을 같은 업무 자료로 측정해요.
오픈 소스 구현을 업무 흐름으로 검증해요
샘플 티켓에서 정확도가 괜찮아도 실제 입력에는 긴 문맥, 중복 선택지, 누락 필드가 섞여요. 그런 입력을 포함한 고정 테스트와 모델 revision, 의존성 버전을 기록하세요.
학습용 프로젝트는 데이터 출처·라이선스·오류 수정 방법까지 살펴봐요. 오분류가 큰 비용을 만들면 자동화 범위를 줄이고 사람 검토를 기본 경로로 둡니다.
llama.cpp 판단 모델로 문의를 담당 부서에 나눠요
llama.cpp 0.6.0의 /v1/systemone으로 Qwen3.5-4B 기반 Kev-4B를 실행할 수 있어요. 문의 본문과 담당 부서 후보를 보내면 answers.route.choice에 선택한 부서가 돌아와요. 아래는 Q4_K_M 파일을 사용하는 예시예요. Kev-4B 모델 카드
0.6.0 이상 llama-server를 준비해 첫 명령을 실행하고, 서버 준비 로그가 나오면 다른 터미널에서 두 번째 명령을 보내세요. 후보 이름 옆에 맡는 업무를 적으면 짧은 라벨만 있을 때보다 분류 기준을 전달하기 쉬워요.
응답에서는 선택값과 후보별 probabilities를 확인해요. 연결에 실패하면 /health부터 열어보고, 501 오류가 나면 판단 모델을 올렸는지 확인하세요. 400 오류는 state와 questions의 입력 형식을 점검하면 돼요. 실제 문의를 자동으로 분류하기 전에는 사람이 정답을 붙인 문의로 오분류를 확인하고, 검토가 필요한 문의를 담당자에게 넘길 기준을 정해요. 공식 API 문서
llama-server -hf ggml-org/Kev-4B-GGUF:Q4_K_M --host 127.0.0.1 --port 8080 --ctx-size 4096curl -sS http://127.0.0.1:8080/health
curl -sS http://127.0.0.1:8080/v1/systemone -H 'Content-Type: application/json' -d '{"state":"I was charged twice for my subscription.","questions":{"route":{"type":"choice","instructions":"Which team should handle this inquiry?","criteria":{"billing":"payments, charges and refunds","access":"login and account access","security":"suspicious activity and account protection"}}}}'용어 각주
CPU — 운영체제와 일반 프로그램 명령을 실행하고, AI에서는 전처리·데이터 이동 등 범용 연산을 맡는 중앙 처리 장치입니다.
본문으로 돌아가기API — 프로그램의 기능을 다른 코드에서 호출하기 위한 약속된 인터페이스입니다.
본문으로 돌아가기처리량 — 일정 시간 동안 처리하거나 생성한 작업량입니다. 토큰/초, 요청/초처럼 단위를 함께 확인해야 비교할 수 있습니다.
본문으로 돌아가기토큰 — 모델이 입력이나 출력을 나누어 처리하는 단위입니다.
본문으로 돌아가기프리필 — LLM이 입력 프롬프트를 읽고 각 토큰의 내부 표현을 계산하는 단계입니다. 입력이 길수록 처리할 토큰이 많아집니다.
본문으로 돌아가기CUDA — NVIDIA GPU에서 범용 계산을 실행하기 위한 소프트웨어 플랫폼입니다.
본문으로 돌아가기MLX — Apple이 개발하는 머신러닝 프레임워크로, Apple Silicon의 CPU와 GPU가 공유하는 메모리를 활용해 모델을 실행합니다.
본문으로 돌아가기PyTorch — AI 모델을 만들고 실행하는 소프트웨어 프레임워크입니다. 모델과 함께 호환되는 PyTorch 버전 및 하드웨어 지원도 확인해야 합니다.
본문으로 돌아가기GPU — 많은 계산을 병렬로 처리하는 프로세서입니다. AI 모델 실행에서는 모델 계산을 맡습니다.
본문으로 돌아가기NVFP4 — NVIDIA가 정의한 4비트 부동소수점 데이터 형식입니다. 지원 여부는 GPU 세대, 모델과 소프트웨어 구현에 따라 다릅니다.
본문으로 돌아가기체크포인트 — 학습된 모델의 가중치 등을 저장한 파일입니다. 같은 모델 계열도 버전이나 용도에 따라 다른 체크포인트를 쓸 수 있습니다.
본문으로 돌아가기VRAM — 그래픽카드의 GPU가 사용하는 메모리입니다. 모델 가중치와 계산 중간값을 저장합니다.
본문으로 돌아가기LoRA — 기본 모델의 동작을 조정하는 작은 추가 가중치를 학습·적용하는 방식입니다. 기본 모델에 어댑터를 함께 적용하며, 스타일 조정이나 적은 단계의 생성 등에 쓰입니다.
본문으로 돌아가기
자주 묻는 질문
- 이 글에서 가장 먼저 확인할 것은 무엇인가요?
- Qwen을 사용하는 Jev형 프로젝트는 문서와 선택지를 입력받아 분류값과 후보 점수를 반환해요. SemIf는 4B 개인 장비 실험, Simple Jev는 0.8B CPU API 시연, openjev-sglang은 35B 서버 병렬 처리에 초점을 둬요. 사용할 장비와 판단 업무에 맞춰 시작점을 골라요.
- 필요한 메모리는 어느 정도인가요?
- CPU 실험에는 로드 시간과 질문당 지연, 4B 개인 GPU 실행에는 VRAM·batch 제한, 서버 실행에는 요청 동시성·GPU 사용량을 각각 기록합니다. 측정 조건이 다른 숫자를 한 순위표에 합치지 않아요.
- 조건과 출처는 어디서 확인하나요?
- llama.cpp 0.6.0의 `/v1/systemone`으로 Qwen3.5-4B 기반 Kev-4B를 실행할 수 있어요. 문의 본문과 담당 부서 후보를 보내면 `answers.route.choice`에 선택한 부서가 돌아와요. 아래는 Q4_K_M 파일을 사용하는 예시예요. [Kev-4B 모델 카드](https://huggingface.co/ggml-org/Kev-4B-GGUF)