
実行プログラムと拡張機能
最終更新
QwenでJev型のローカル判断:SemIf・Simple Jev・openjev-sglang
QwenベースのJev型実装はlogit参照・API実験・サーバー処理で目的が異なる
QwenベースのJev型プロジェクトは文書と選択肢から分類値や候補スコアを返します。SemIfは4Bの個人機器実験、Simple Jevは0.8B CPU1 API2のデモ、openjev-sglangは35Bのサーバー並列処理が中心です。機器と判断業務に合わせて選びます。
Jev型判断のローカルプロジェクトは、スコア参照・APIデモ・専用学習・サーバー処理量など出発点が異なります。まずモデルと実行経路を把握し、目的に合う同じデータで選択精度と遅延を分けて確認します。
候補トークンのスコアから選択値を作る
billing・access・securityなど担当部署の候補を定めて問い合わせを入力し、次位置のlogitを読みsoftmaxを適用すれば候補内の相対確率を得られます。文章や長いJSONは生成せずサーバーコードが構造を作ります。ただし各ラベルのtoken3分割・意味の区別・信頼度と実際の正解率の対応は別途検証が必要です。
説明例としてlogitが2・1・0ならsoftmax値は約66.5%・24.5%・9.0%です。3候補内で正規化した値であり、最初の候補がその確率で正解する保証ではありません。
SemIfは個人機器での4B比較を想定したプロジェクト
SemIfは名称変更前のOpenJevリポジトリを引き継ぎ、Qwen3.5-4Bの候補logitを直接読みます。複数質問で共通文書prefill4を再利用し、質問ごとの分岐を並列評価できます。RTX 3090のCUDA5実験記録とApple silicon MLX6バックエンドも公開されています。個人機器で再現可能な基準を探す場合、サーバー構成より近い出発点です。
高速なshared経路の選択は基本スコアリングと異なる場合があるため、遅延とともに選択の一致度も記録します。同じ問い合わせとモデル版を固定し、同じ評価データでfresh経路とshared経路を比較します。経路間の一致だけでは正解といえず、人手ラベルの基準回答と照合して誤分類を数えます。
Simple JevはCPUでAPI形式を学ぶ例
規模より実装経路でprojectを選びます
Simple JevはCPUでdecision APIを学ぶ小さな入口、SemIfはQwen 4B級を個人機器で試す経路です。openjev-sglangはB200 serverの並列実行向けで、desktop実習と同じ条件ではありません。
候補scoreを読むlibraryと/v1/systemone server requestは異なる実行方式です。比較するticketとaction名は固定しつつ、入力fieldと選択肢順は各projectのexampleに合わせます。
openjev-sglangはB200サーバーの並列処理基準
openjev-sglangはQwen3.6-35B-A3B NVFP49チェックポイント10をSGLangで提供し、radix cacheと並列要求を利用します。公開基準環境はB200 1基であり、個人GPU向け導入例として読まないでください。複数質問で共通prefixを維持してprefillを再利用するサーバー設計が参考点です。
64件の質問に関する公開処理量はアクセラレーター・入力長・同時実行条件によります。処理量と単一要求の遅延は異なります。仮に64件が4秒で完了すれば毎秒16件ですが、各要求が1/16秒で終わった意味ではありません。この計算は概念説明の仮定で、B200測定値の言い換えではありません。
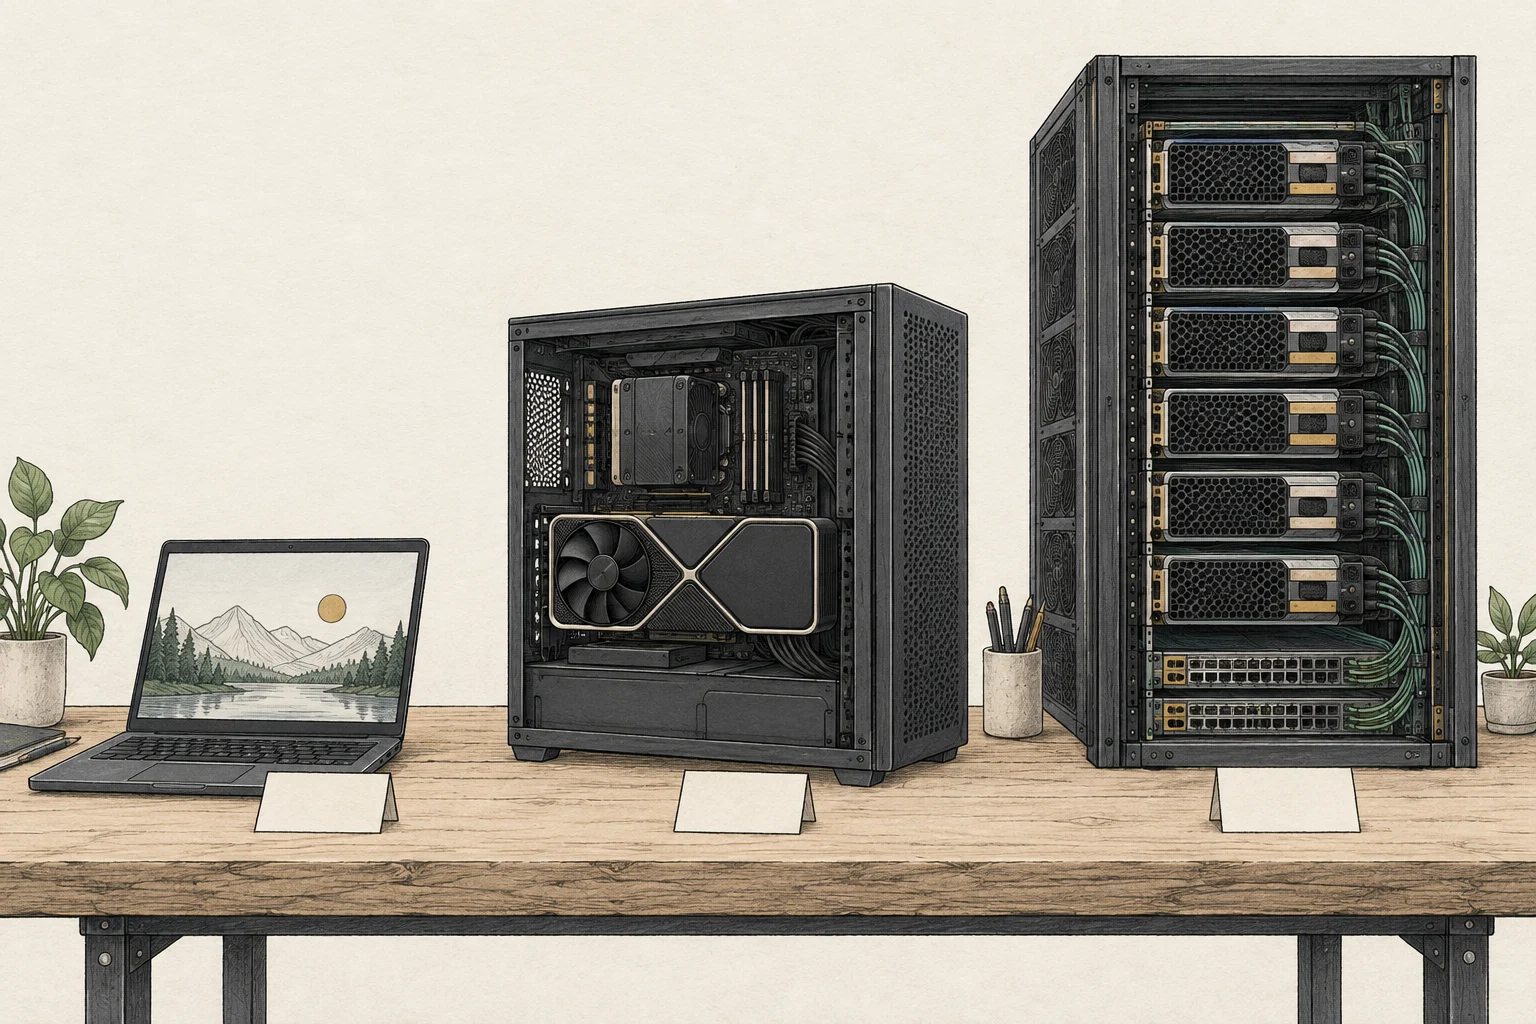
同じ選択肢と入力で各repoを確認します
3 projectに同じticketとaction候補を適用します。request JSONは各projectの公式interfaceに変換し、response keyと各確率が対応する選択肢を記録します。
CPUではロード時間・質問ごとの遅延、個人4B GPUではVRAM11・batch制限、serverでは同時実行・accelerator使用量を記録します。条件の異なる数値を順位表に混ぜません。
学習型プロジェクトはデータ範囲と誤りのコストで選ぶ
kevはQwen2.5-0.5BにLoRA12と小さな読み出しヘッドを加え、文書と複数質問を一つのシーケンスで扱います。qwen-rlcdはQwen3.5-0.8BをChoice・Score・Noul判断向けに学習します。直接スコア参照の基準構成より判断構造に適合しますが、学習・評価データの範囲が性能を制限する場合があります。
「二重請求」と「重複決済のようだ」のように表現が異なっても結果が保たれるか、信頼度が確認に役立つか試します。基準構成・小型CPU API・B200サーバーはモデルと作業が異なるため直接順位付けせず、同じ業務データで正確性・確率較正・遅延を測定します。
open実装を実務flowで検証します
sample ticketで良い精度でも、実入力には長文脈・重複選択肢・欠落fieldが混ざります。そうした入力を含む固定testとmodel revision・依存versionを記録します。
学習projectではdata出典・license・誤り修正手順も確認します。誤分類の損失が大きい場合は自動化範囲を狭め、人手確認を基本経路にします。
llama.cppの判断モデルで問い合わせを振り分ける
llama.cpp 0.6.0の/v1/systemoneで、Qwen3.5-4Bを基盤とするKev-4Bを実行できます。問い合わせ本文と担当候補を送ると、answers.route.choiceに選択した担当が返ります。以下はQ4_K_Mファイルを使う例です。Kev-4Bモデルカード
0.6.0以降のllama-serverを用意して最初のコマンドを実行します。サーバー準備完了のログが出たら、別のターミナルで二つ目を送ってください。候補名に担当業務の説明を添えると、短いラベルだけより分類基準を伝えやすくなります。
応答の選択結果と候補ごとのprobabilitiesを確認します。接続できなければまず/healthを開き、501エラーなら判断モデルを読み込んだか確認してください。400エラーではstateとquestionsの入力形式を点検します。実際の問い合わせを自動分類する前に、人が正解を付けた問い合わせで誤分類を調べ、確認が必要なものを担当者に回す基準を決めてください。公式API文書
llama-server -hf ggml-org/Kev-4B-GGUF:Q4_K_M --host 127.0.0.1 --port 8080 --ctx-size 4096curl -sS http://127.0.0.1:8080/health
curl -sS http://127.0.0.1:8080/v1/systemone -H 'Content-Type: application/json' -d '{"state":"I was charged twice for my subscription.","questions":{"route":{"type":"choice","instructions":"Which team should handle this inquiry?","criteria":{"billing":"payments, charges and refunds","access":"login and account access","security":"suspicious activity and account protection"}}}}'用語の注釈
CPU — OSや一般的なプログラム命令を実行する中央処理装置です。AIでは前処理やデータ転送などの汎用処理も担います。
本文に戻るAPI — 別のコードからプログラムの機能を呼び出すための決められたインターフェースです。
本文に戻るトークン — モデルが入力や出力を分けて処理する単位です。
本文に戻るプリフィル — LLMが入力プロンプトを読み、各トークンの内部表現を計算する段階です。プロンプトが長いほど処理するトークンが増えます。
本文に戻るCUDA — NVIDIA GPUで汎用計算を行うソフトウェア基盤です。
本文に戻るMLX — Appleが開発する機械学習フレームワークで、Apple SiliconのCPUとGPUが共有するメモリを使ってモデルを実行します。
本文に戻るPyTorch — AIモデルを作成・実行するソフトウェアフレームワークです。モデルと合わせて、対応するPyTorchの版やハードウェアも確認します。
本文に戻るGPU — 多くの計算を並列に処理するプロセッサーです。AIモデルの実行ではモデル計算を担います。
本文に戻るNVFP4 — NVIDIAが定義した4ビット浮動小数点データ形式です。対応状況はGPU世代、モデル、ソフトウェア実装によって異なります。
本文に戻るチェックポイント — 学習済みモデルの重みなどを保存したファイルです。同じモデル系列でも、版や用途によって異なるチェックポイントを使うことがあります。
本文に戻るVRAM — グラフィックカードのGPUが使うメモリです。モデルの重みや計算途中の値を保存します。
本文に戻るLoRA — 基本モデルの動作を調整する小さな追加の重みを学習・適用する方法です。基本モデルとアダプターを組み合わせ、画風の調整や少ないステップでの生成などに使います。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- QwenベースのJev型プロジェクトは文書と選択肢から分類値や候補スコアを返します。SemIfは4Bの個人機器実験、Simple Jevは0.8B CPU APIのデモ、openjev-sglangは35Bのサーバー並列処理が中心です。機器と判断業務に合わせて選びます。
- 必要なメモリはどのくらいですか?
- CPUではロード時間・質問ごとの遅延、個人4B GPUではVRAM・batch制限、serverでは同時実行・accelerator使用量を記録します。条件の異なる数値を順位表に混ぜません。
- 条件と出典はどこで確認できますか?
- llama.cpp 0.6.0の`/v1/systemone`で、Qwen3.5-4Bを基盤とするKev-4Bを実行できます。問い合わせ本文と担当候補を送ると、`answers.route.choice`に選択した担当が返ります。以下はQ4_K_Mファイルを使う例です。[Kev-4Bモデルカード](https://huggingface.co/ggml-org/Kev-4B-GGUF)