実行プログラムと拡張機能
Mac・RTX 3090・サーバーでJev型ローカルAIを動かす
モデル名を見て先にGPUを買うと、チャットLLMと同じ失敗を繰り返します。Jev型は長い文章をほとんど生成しないため、デコード速度より共通文脈のプリフィルと質問分岐が重要です。ノートPCで仕組みを試す場合、24GB GPUで反復実験する場合、多人数に提供する場合では必要な構成が違います。手元の機器から始めます。
初日はCPUで一件を完了する
Qwen3.5-0.8Bを使うSimple Jevなら専用GPUなしで要求と応答の形を確認できます。一段落、二問、二、三個の選択肢でJSONを見ます。目的は最高速度や業務精度ではなく、state、question、candidateがどこで組み立てられるかを理解することです。正解が分かる例で確率と選択を確認し、表現を少し変えて揺れを記録します。それが大きなモデルや機材で解決したい問題になります。
Macでは4B Q4とMLXから始める
SemIfのMLXバックエンドはApple SiliconでQwen3.5-4Bを直接スコアできます。ブラウザ用Q4は約3GBですが、実行領域、キャッシュ、macOS、ほかのアプリの容量も必要です。16GB Macでも小さな実験は可能ですが、毎回ほかのアプリを閉じるなら反復作業には向きません。24GB以上では余裕を残して質問数を増やし、freshとsharedで遅延と結果一致を記録します。
24GB GPUは反復検証に向きます
4BのBF16重みは単純計算で約8GBで、24GB GPUならモデル、キャッシュ、質問バッチに余裕があります。SemIfのRTX 3090実験は、direct、prefix reuse、parallel suffixを比べる台として便利だと示します。ただしGPU名だけで同じ数値にはなりません。ドライバ、PyTorch、モデル版、入力トークン、質問数を固定し、初回を除いた反復値を残します。処理量が問題でなければ小さい機器で精度を先に確かめます。
35BとSGLangはサービス運用の領域です
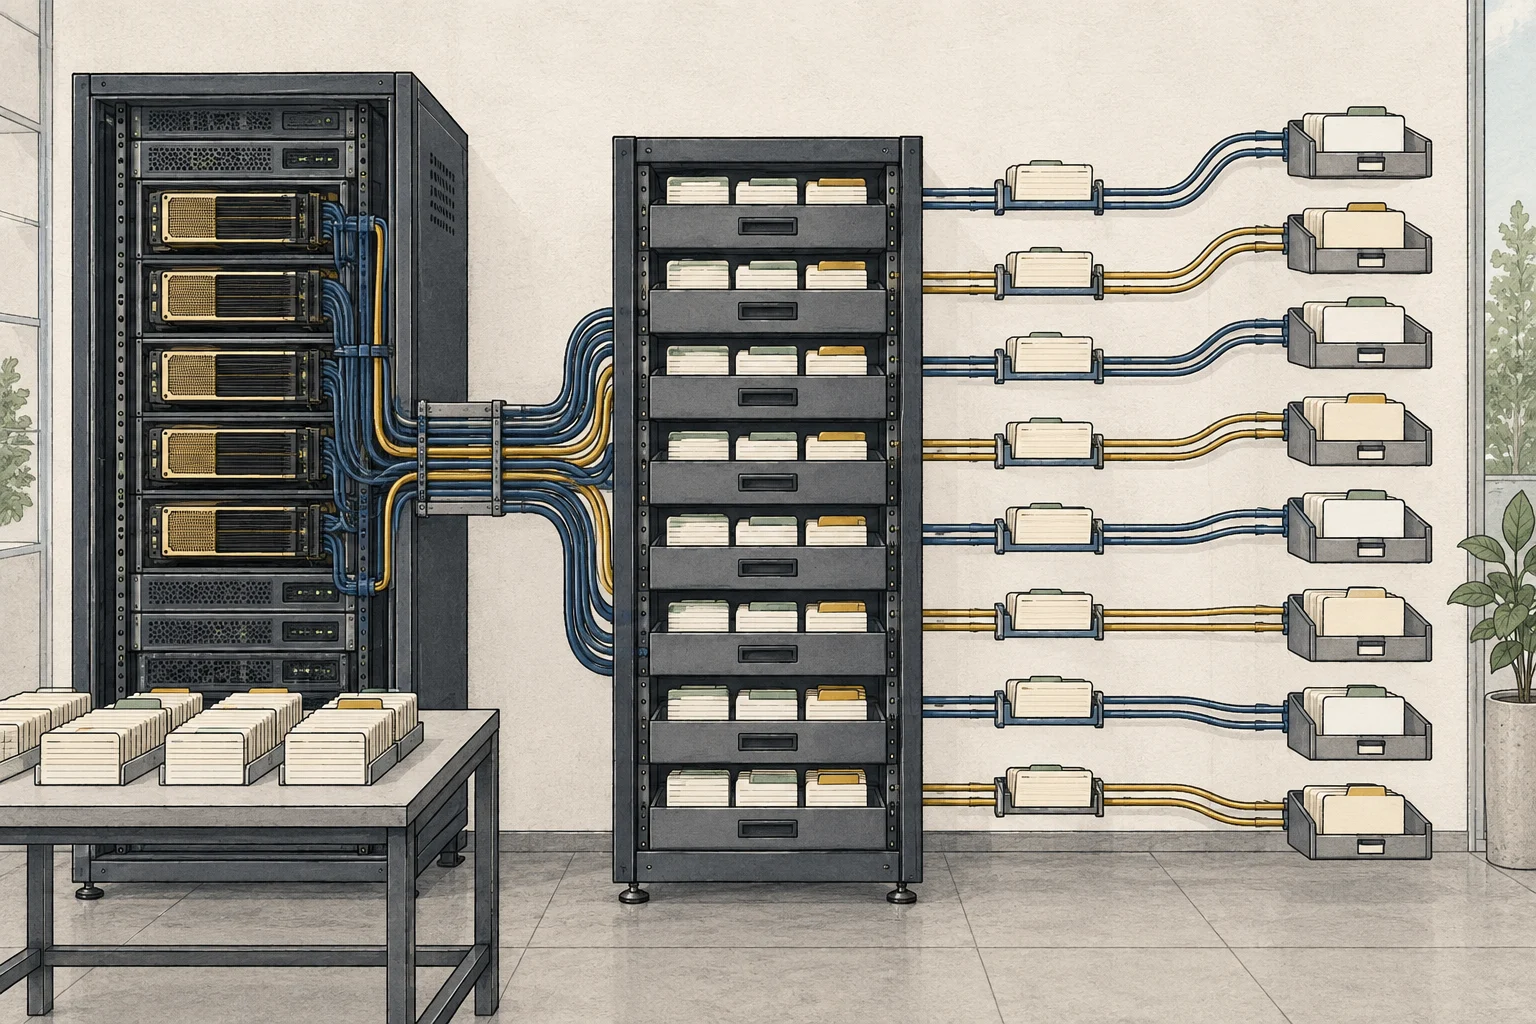
Qwen3.6-35B-A3Bは一トークンで使うパラメータが小さくても、全重みを保持します。openjev-sglangのNVFP4は約23GBと説明されますが、公開基準はB200であり、24GBの一般GPUで同じカーネルと余裕を保証しません。この規模では一件の速さよりradix cacheの再利用、同時分岐、過負荷の拒否を設計します。個人用の判断器なら4B実験を安定させる方が実用的です。
購入前に精度と遅延を同時に残す
実際の業務から代表的なstateを30件と質問群を作り、人が正解を付けます。directとsharedの選択、確率、遅延を同じ表に残してください。小さいモデルで精度と速度が足りれば機材を変える理由はありません。精度は足りるが大量時だけ遅いならGPUや接頭辞再利用が候補です。大きいモデルでも規則を誤るなら、機材より選択肢の説明、データ、人の確認経路を直します。tok/s順位より失敗時の戻り先が重要です。