
실행 프로그램과 확장
최종 업데이트
Jev형 로컬 판단 모델을 Mac·RTX 3090·서버에서 실행해요
문장 생성 대신 상태와 선택지를 점수화하는 판단 모델을 장비별로 시험해요
Jev형 로컬 판단 모델은 문의나 문서 같은 상태를 읽고, 미리 정한 질문에 대한 선택지 확률이나 점수를 반환해요. Qwen 기반 소형 모델은 CPU1와 개인 Mac·RTX에서 API2 흐름을 시험하기 좋고, OpenJev·Clef 계열 27B는 메모리와 서버 요구량이 커요. 먼저 소량의 실제 업무 사례로 결과를 확인한 뒤 요청 수와 지연에 맞는 장비를 골라요.
GPU3부터 고르기 전에 한 문서를 몇 번 읽고 질문을 몇 개 동시에 처리할지 정해요. 같은 공통 입력을 재사용하는 방식과 질문 수가 장비의 메모리·지연에 영향을 주므로, 지금 가진 장비에서 시작해 실제 병목이 보일 때 확장해요.
Jev형 판단은 어떤 입력을 받아 무엇을 돌려주나요?
일반 챗 모델은 문의를 읽고 답변 문장을 생성해요. Jev형 판단 모델은 문의나 사건 기록을 state로 받고, 미리 정한 질문과 선택지를 평가해요. choice는 선택지별 확률과 가장 높은 선택, score는 단계별 확률에서 계산한 점수, noul은 예/아니요 판단의 참 확률을 반환해요. 결과는 보통 JSON이므로 고객 문의 분류, 안전 점검, 다음 작업 선택처럼 답변 문장을 만들지 않아도 되는 단계에 연결할 수 있어요.
예를 들어 주문 문의를 state로 보내면 billing, shipping, technical 중 선택한 값과 각 후보의 확률을 받아요. 이 확률은 업무별 정답률과 다르므로, 사람이 표시한 정답과 대조해 임계값을 정하고 낮은 확률이나 경계 사례는 검토 대상으로 보내요.
oMLX 0.7.1.dev1과 llama.cpp v0.6.0은 TypeSafe 호환 POST /v1/systemone 엔드포인트를 지원해요. 일반 /v1/chat/completions는 토큰4을 생성해 문장을 보내지만, /v1/systemone은 지정한 choice, score, noul 질문의 구조화된 결과를 반환해요. 선택한 모델이 실제 decision model인지 확인한 뒤 이 주소를 호출해요.
CPU에서는 Simple Jev 서버로 문의 한 건을 분류해요
Simple Jev는 일반 Qwen 모델의 로짓을 읽어 선택 결과를 JSON으로 조립하는 서버예요. 이 절에서는 Qwen3.5-0.8B를 CPU에서 실행해 이중 청구 문의의 담당 팀을 골라요. 뒤의 oMLX 절은 별도로 학습된 OpenJev·Clef 체크포인트5를 사용하는 경로예요.
Git과 Python 3.12 이상을 준비해요. 아래 설치 명령은 Python 3.13이 있는 macOS·Linux 터미널 기준이에요. 저장소를 복제하고 그 폴더에서 가상환경6을 만든 뒤 서버 패키지를 설치해요.
git clone https://github.com/featherless-ai/simple-jev.git
cd simple-jev
python3.13 -m venv .venv
source .venv/bin/activate
python -m pip install -e './hf-server'
같은 가상환경에서 CPU 서버를 시작해요. 첫 실행은 Hugging Face에서 모델을 받으므로 다운로드와 적재가 끝날 때까지 기다려요. 포트는 뒤의 oMLX 서버와 겹치지 않도록 8001을 사용해요.
python hf-server/hf_server.py --model Qwen/Qwen3.5-0.8B --device cpu --dtype float32 --classifier-prompt-policy baseline --max-model-len 4096 --max-batch-size 4 --max-batch-tokens 4096 --port 8001서버 터미널은 열어 둔 채 새 터미널에서 상태와 모델 목록을 조회해요. 정상 상태와 Qwen3.5-0.8B 모델 ID가 나오면 짧은 분류 요청을 보낼 준비가 된 거예요.
curl http://127.0.0.1:8001/health
curl http://127.0.0.1:8001/v1/models
아래 요청은 이중 청구 문의를 state로 보내고 billing, shipping, technical 가운데 처리 팀을 물어요. 민감정보가 없는 예시부터 보내고, 실제 업무를 시험할 때도 개인 정보는 먼저 제거해요.
curl http://127.0.0.1:8001/v1/classifier \
  -H 'Content-Type: application/json' \
  -d '{"model":"Qwen/Qwen3.5-0.8B","state":"Customer message: I was charged twice for my order last week.","questions":{"route":{"type":"choice","instructions":"Which team should handle this?","criteria":{"billing":"Payments, invoices, and refunds","shipping":"Delivery or tracking issues","technical":"Product or account errors"}}}}'
응답의 answers.route에서 선택한 팀과 후보별 probabilities를 읽어요. 사람이 정한 담당 팀과 대조하고, 문구를 바꾸거나 정보가 빠진 문의도 추가해요. 이렇게 모은 오류 사례로 선택지 설명과 사람 검토 기준을 조정할 수 있어요.
접속이 안 되면 서버 터미널의 다운로드·모델 적재 상태와 포트 8001을 확인해요. HTTP 422가 나오면 응답의 오류 설명을 읽고 state, questions, criteria를 요청 예제와 대조해요. 패키지 설치가 실패하면 Python 버전과 가상환경부터 확인해요. 시험을 마치면 서버 터미널에서 Ctrl+C로 종료해요.
Apple Silicon에서는 Qwen 4B 실험의 메모리를 살펴요
Mac에서는 뒤의 oMLX API 절차로 OpenJev·Clef를 실행할 수 있어요. 이 절의 SemIf MLX7 실험은 장비 용량과 공통 입력 재사용을 비교할 때 참고해요. SemIf-OpenJev의 MLX 경로는 Apple Silicon에서 Qwen3.5-4B 모델을 직접 점수화하는 실험을 지원해요. 공개 브라우저 데모의 Q4 가중치 파일은 약 3GB예요. macOS와 실행기, 질문별 작업 공간, 캐시도 메모리를 사용하므로 활성 상태 보기에서 메모리 압력을 살피고, 모델 적재 후 반복 요청에 쓸 여유까지 확인해요.
16GB 통합 메모리8 맥에서 작은 요청이 실행되더라도 브라우저와 개발 도구를 함께 켜면 여유가 줄 수 있어요. 평소 쓰는 앱을 켠 상태에서 한 건을 처리하고 메모리 압력과 완료 시간을 확인해요. 여러 질문이 같은 긴 상태를 공유하는 작업이라면 공통 상태를 한 번 읽는 shared 경로와 질문마다 새로 읽는 fresh 경로를 따로 비교해요.
24GB 이상 통합 메모리는 질문 수와 입력 크기를 늘려 시험할 여유를 줄 수 있어요. 같은 업무 표본을 한 건씩 처리한 결과와 여러 건을 동시에 처리한 결과로 나누고, 선택 결과·확률·처리 시간·메모리를 함께 기록해요.
하드웨어 선택은 요청 형태부터 정해요
35B 실행 메모리는 BF169·NVFP410 등 체크포인트와 서빙 런타임11에 따라 달라져요. 예를 들어 JEV-35B NVFP4 카드는 가중치 25.6GB(23.3GiB)를 안내하고 B200에서 시험했다고 기록합니다. 장치 선택은 카드의 런타임 요구와 내 입력 조건을 함께 확인해요.
공개 비교표의 RTX PRO 6000 단일 질문 중앙값은 Julia-1 3ms, Laya 5ms, Kev-4B 12ms, lev 36ms, OpenJev 43ms예요. 이 다섯 항목과 각 모델 규모·언어를 표에 함께 적고, 다른 동시성이나 입력 길이의 운영 지연과 분리합니다.
RTX 3090에서는 VRAM과 재사용 경로를 함께 봐요
Qwen3.5-4B의 BF16 가중치 원시 크기는 40억 파라미터 × 16비트 ÷ 8비트/바이트로 약 8GB예요. RTX 3090의 24GB VRAM12에서 단순 차감하면 약 16GB가 남지만, 그 공간은 전부 질문 캐시에 쓸 수 없어요. 실행기와 CUDA13 드라이버, 임시 버퍼, KV 캐시14도 VRAM을 사용해요. Q4 파일은 다운로드와 가중치 메모리를 줄이는 대신 BF16과 수치 표현이 달라져요.
SemIf 저장소는 RTX 3090에서 direct, prefix reuse, parallel suffix 실행을 비교하는 자료를 제공해요. 공통 상태를 한 번 처리하고 여러 질문으로 갈라지는 작업에서는 재사용 경로가 프리필15을 줄일 수 있어요. SemIf의 설치·실행은 연결한 저장소 README를 따라요. 실행 환경이 준비되면 같은 체크포인트와 질문 세트로 direct 실행을 세 번 기록한 뒤 prefix 재사용과 병렬 suffix를 하나씩 비교해요.
각 경로에서 모델 리비전, 양자화16, 입력 토큰 수, 질문 개수, GPU 사용량과 결과를 저장해요. 첫 실행은 모델 로딩이 들어갈 수 있으니 반복 실행과 따로 적어요. 선택 결과가 달라지면 원래 상태와 후보별 확률을 검토하고, 사람이 표시한 정답 표본으로 두 경로를 비교해요.
| 장비 | 시작 모델·경로 | 함께 기록할 내용 |
|---|---|---|
| CPU | Qwen3.5-0.8B급 로컬 기준선 | 요청 형식·결과 JSON·단건 시간 |
| Apple Silicon Mac | Qwen3.5-4B Q4 · SemIf MLX | 통합 메모리 압력·fresh/shared 결과 |
| RTX 3090 24GB | Qwen3.5-4B · SemIf CUDA | VRAM·질문 지연·direct/reuse 결과 |
OpenJev 27B는 서버 입력과 메모리 부하를 따로 계획해요
OpenJev 27B는 Qwen3.8-27B 기반의 결정 모델로 이미지 입력도 지원해요. llama.cpp와 oMLX 지원 여부는 체크포인트와 프로젝트 버전에 따라 달라요. 모델 목록에 decision 유형으로 표시되고 /v1/systemone 요청이 작동하는지 먼저 확인해요. 공개 언어 목록은 영어, 독일어, 프랑스어, 힌디어, 중국어, 일본어예요. 한국어 업무를 시작하기 전에는 한국어 문의 표본으로 선택 결과와 오류를 평가해요.
oMLX 0.7.1.dev1은 Clef, Clef-Flash와 OpenJev 결정을 지원해요. Clef 계열은 텍스트와 이미지 입력을, OpenJev 27B는 텍스트와 한 장 이미지 입력을 지원한다고 릴리스가 설명해요. 이 모델은 텍스트 응답을 생성하는 대신 선택지 확률을 반환하므로, 이를 일반 채팅 API에 보내면 원하는 결과 형식이 나오지 않을 수 있어요.
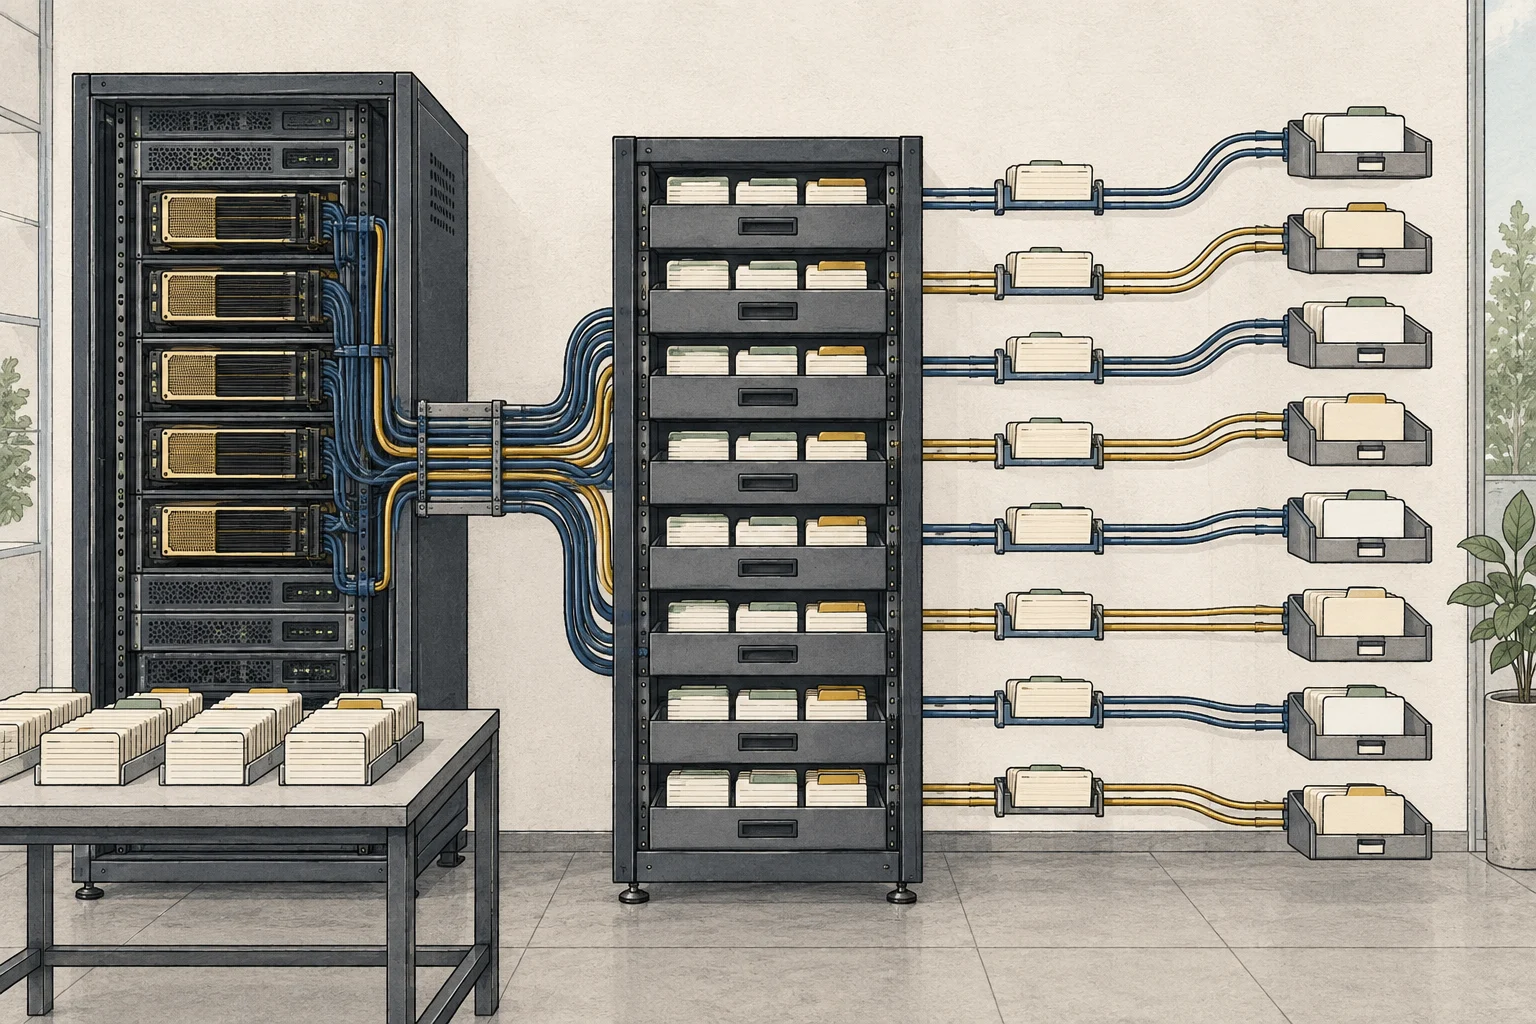
27B 서버를 여러 사용자가 공유한다면 평균 한 건의 시간뿐 아니라 동시 요청 수, 긴 입력, 이미지 포함 여부, 모델 상주 메모리를 함께 계획해요. RTX 3090에서 Q4 4B 작업으로 요청과 결과를 먼저 확인하고, 정답 표본과 예상 운영량을 바탕으로 27B 서버의 필요 용량을 계산해요.
VRAM·메모리와 오류 비용을 같이 봐요
Apple 통합 메모리 환경에서는 운영체제와 앱이 공유하는 메모리 여유를 남기고, GPU에서는 모델 가중치 외에 KV cache, activation, 서버 동시성 공간도 계획해야 합니다. 가중치 크기만으로 모델이 안정적으로 실행된다고 단정하지 마세요.
티켓 자동 분류가 상담원을 건너뛰거나 환불을 잘못 승인하면 오류 비용이 큽니다. 낮은 confidence는 사람 검토로 넘기고, 처리 시간과 재검토 비율이 목표에 맞는 장비만 후보로 남겨요.
정답 표본으로 사람 검토 기준과 구매 필요를 판단해요
실제 업무에서 반복되는 문의를 모아 사람이 정답을 표시해요. 30건은 초기 점검에 쓸 수 있는 작은 표본이에요. 운영 전체의 정확도나 효과를 판단하려면 명확한 사례와 경계 사례를 더 모으고, 각 모델의 선택·확률·처리 시간·오류를 같은 기준으로 기록해요. 새 오류 유형이 나오면 해당 사례를 표본에 추가해요.
확률 임계값은 업무가 감당할 수 있는 오류 비용에 맞춰요. 확률이 낮거나 후보 간 차이가 작은 요청은 사람에게 넘기는 규칙을 먼저 정해요. OpenJev 확률은 모델 파일의 온도 설정으로 계산돼요. 업무에 적용할 임계값은 별도 검증 표본에서 점검하고, 확인된 범위부터 자동 처리해요.
한 건을 즉시 처리하는 업무라면 개별 지연을, 문의를 모아 처리한다면 시간당 처리량17과 마감 시각을 측정해요. 답변이 맞지만 요청이 밀리면 GPU 여유나 병렬 질문 수를 고려하고, 답이 자주 틀리면 먼저 입력 상태·선택지·지원 언어를 고쳐요. 반복 업무와 입력 크기에서 필요한 장비 여유가 확인될 때 업그레이드를 비교해요.
자기 질문 분포로 p50·p95를 재요
동일한 질문 묶음과 모델 revision으로 장치별로 여러 번 반복하고 p50·p95, 최대 메모리, 오류 응답을 기록합니다. 모델 로드·첫 요청·워밍된 요청 시간은 따로 분리해야 첫 실행 지연이 반복 사용 지연에 섞이지 않아요.
작은 batch에서 맞춘 설정을 서비스 부하로 확대하기 전 동시 요청을 단계적으로 늘리세요. 품질, 지연, 메모리 한도를 동시에 만족할 때 해당 구성을 운영 후보로 삼습니다.
API를 처음 호출해 결정 결과를 확인해요
oMLX 앱이나 지원 서버에서 OpenJev 또는 Clef decision 체크포인트를 내려받고 서버를 실행해요. 아래 두 요청의 YOUR_OMLX_API_KEY를 서버에 설정한 키로 바꿔요. 인증을 사용하지 않는 서버에서는 두 요청 모두 Authorization 헤더를 빼요. 먼저 모델 목록을 조회해요.
curl http://127.0.0.1:8000/v1/models -H 'Authorization: Bearer YOUR_OMLX_API_KEY'응답의 data[].id에서 사용할 decision 모델 ID를 복사해 YOUR_DECISION_MODEL_ID에 넣어요. 이어서 결제 중복 사례와 처리 팀을 묻는 선택형 요청을 보내요.
curl http://127.0.0.1:8000/v1/systemone \
  -H 'Content-Type: application/json' \
  -H 'Authorization: Bearer YOUR_OMLX_API_KEY' \
-d '{"model":"YOUR_DECISION_MODEL_ID","state":"Customer message: I was charged twice for my order last week.","questions":{"route":{"type":"choice","instructions":"Which team should handle this?","criteria":{"billing":"The customer reports a duplicate charge or refund issue","shipping":"The customer reports a delivery or tracking issue","technical":"The customer reports a product or account technical issue"}}}}'answers에 route 질문과 선택 결과, 확률이 표시되면 요청이 처리된 거예요. 실제 업무에서 사람이 표시한 정답 표본과 대조해 결과를 평가해요. HTTP 501은 모델 유형이나 입력 형식이 지원되지 않을 때, HTTP 400은 요청 JSON이 유효하지 않을 때 반환될 수 있어요. 적재 오류가 나면 서버 로그의 첫 오류와 메모리 여유를 확인해요.
용어 각주
CPU — 운영체제와 일반 프로그램 명령을 실행하고, AI에서는 전처리·데이터 이동 등 범용 연산을 맡는 중앙 처리 장치입니다.
본문으로 돌아가기API — 프로그램의 기능을 다른 코드에서 호출하기 위한 약속된 인터페이스입니다.
본문으로 돌아가기GPU — 많은 계산을 병렬로 처리하는 프로세서입니다. AI 모델 실행에서는 모델 계산을 맡습니다.
본문으로 돌아가기토큰 — 모델이 입력이나 출력을 나누어 처리하는 단위입니다.
본문으로 돌아가기체크포인트 — 학습된 모델의 가중치 등을 저장한 파일입니다. 같은 모델 계열도 버전이나 용도에 따라 다른 체크포인트를 쓸 수 있습니다.
본문으로 돌아가기Python 가상환경 — 프로젝트별로 Python 패키지를 분리해 설치하는 공간입니다. 패키지 버전 충돌을 줄이는 데 쓰입니다.
본문으로 돌아가기MLX — Apple이 개발하는 머신러닝 프레임워크로, Apple Silicon의 CPU와 GPU가 공유하는 메모리를 활용해 모델을 실행합니다.
본문으로 돌아가기통합 메모리 — CPU와 GPU가 같은 물리 메모리 풀을 공유하는 구조입니다.
본문으로 돌아가기BF16 — 모델 수치를 저장하고 계산하는 16비트 부동소수점 형식입니다. FP32와 같은 폭의 지수부를 써 넓은 값 범위를 표현합니다.
본문으로 돌아가기NVFP4 — NVIDIA가 정의한 4비트 부동소수점 데이터 형식입니다. 지원 여부는 GPU 세대, 모델과 소프트웨어 구현에 따라 다릅니다.
본문으로 돌아가기런타임 — 프로그램이 실행될 때 필요한 기능을 제공하는 소프트웨어 환경입니다. 로컬 AI에서는 모델을 실행하는 엔진을 가리키기도 합니다.
본문으로 돌아가기VRAM — 그래픽카드의 GPU가 사용하는 메모리입니다. 모델 가중치와 계산 중간값을 저장합니다.
본문으로 돌아가기CUDA — NVIDIA GPU에서 범용 계산을 실행하기 위한 소프트웨어 플랫폼입니다.
본문으로 돌아가기KV 캐시 — 어텐션에서 이전 토큰의 키·값을 저장해 다음 토큰 생성 때 재사용하는 메모리입니다. 문맥 길이와 배치 크기에 따라 용량이 달라집니다.
본문으로 돌아가기프리필 — LLM이 입력 프롬프트를 읽고 각 토큰의 내부 표현을 계산하는 단계입니다. 입력이 길수록 처리할 토큰이 많아집니다.
본문으로 돌아가기양자화 — 모델의 가중치나 계산값을 더 적은 비트로 표현해 저장 공간과 메모리 사용량을 줄이는 방법입니다. 표현 단계가 거칠어져 정확도에도 영향을 줄 수 있습니다.
본문으로 돌아가기처리량 — 일정 시간 동안 처리하거나 생성한 작업량입니다. 토큰/초, 요청/초처럼 단위를 함께 확인해야 비교할 수 있습니다.
본문으로 돌아가기
자주 묻는 질문
- 이 글에서 가장 먼저 확인할 것은 무엇인가요?
- Jev형 로컬 판단 모델은 문의나 문서 같은 상태를 읽고, 미리 정한 질문에 대한 선택지 확률이나 점수를 반환해요. Qwen 기반 소형 모델은 CPU와 개인 Mac·RTX에서 API 흐름을 시험하기 좋고, OpenJev·Clef 계열 27B는 메모리와 서버 요구량이 커요. 먼저 소량의 실제 업무 사례로 결과를 확인한 뒤 요청 수와 지연에 맞는 장비를 골라요.
- 필요한 메모리는 어느 정도인가요?
- Mac에서는 뒤의 oMLX API 절차로 OpenJev·Clef를 실행할 수 있어요. 이 절의 SemIf MLX 실험은 장비 용량과 공통 입력 재사용을 비교할 때 참고해요. SemIf-OpenJev의 MLX 경로는 Apple Silicon에서 Qwen3.5-4B 모델을 직접 점수화하는 실험을 지원해요. 공개 브라우저 데모의 Q4 가중치 파일은 약 3GB예요. macOS와 실행기, 질문별 작업 공간, 캐시도 메모리를 사용하므로 활성 상태 보기에서 메모리 압력을 살피고, 모델 적재 후 반복 요청에 쓸 여유까지 확인해요.
- 선택하지 않는 편이 좋은 경우는 언제인가요?
- Apple 통합 메모리 환경에서는 운영체제와 앱이 공유하는 메모리 여유를 남기고, GPU에서는 모델 가중치 외에 KV cache, activation, 서버 동시성 공간도 계획해야 합니다. 가중치 크기만으로 모델이 안정적으로 실행된다고 단정하지 마세요.