
実行プログラムと拡張機能
最終更新
Jevとは何か:文章を書かずに判断するSystem Oneモデル
Jevは文章の代わりに選択値と信頼度を返す
Jevは文書や問い合わせから、事前に決めた選択肢と信頼度を返す判断モデルです。担当部署やリスク区分など、次のプログラムがそのまま使う値を作ります。繰り返す分類を自動化し、説明は通常のLLM1や人に任せられます。
Jev型モデルを自分のPCやMacでローカルに動かせるか知りたい場合は、まずこのモデルが何を返すのかから確認してください。たとえば問い合わせをbilling・access・securityのいずれかに振り分けるなら、説明文よりも担当部署の値一つが次の工程に役立つことがあります。Jev型のリクエストは判定項目と選択肢を先に決めてから問い合わせを入力します。出力形式が短いことが速度の要点であり、単に回答を短く書くことではありません。
問い合わせを次のプログラムが使える値に変える
「今月の料金が二重に請求されたようです」という問い合わせを例にします。担当部署にbilling・access・securityを指定して本文を入力します。billingなら請求担当の作業箱へ送り、信頼度が低い場合は人の確認に回せます。
分類だけが必要な段階と、返金手順を説明したり追加質問で曖昧さを解いたりする段階は異なります。次のプログラムに担当部署だけ渡せばよいなら文章を再解釈する必要はありませんが、相談を完了するには説明と対話が必要です。
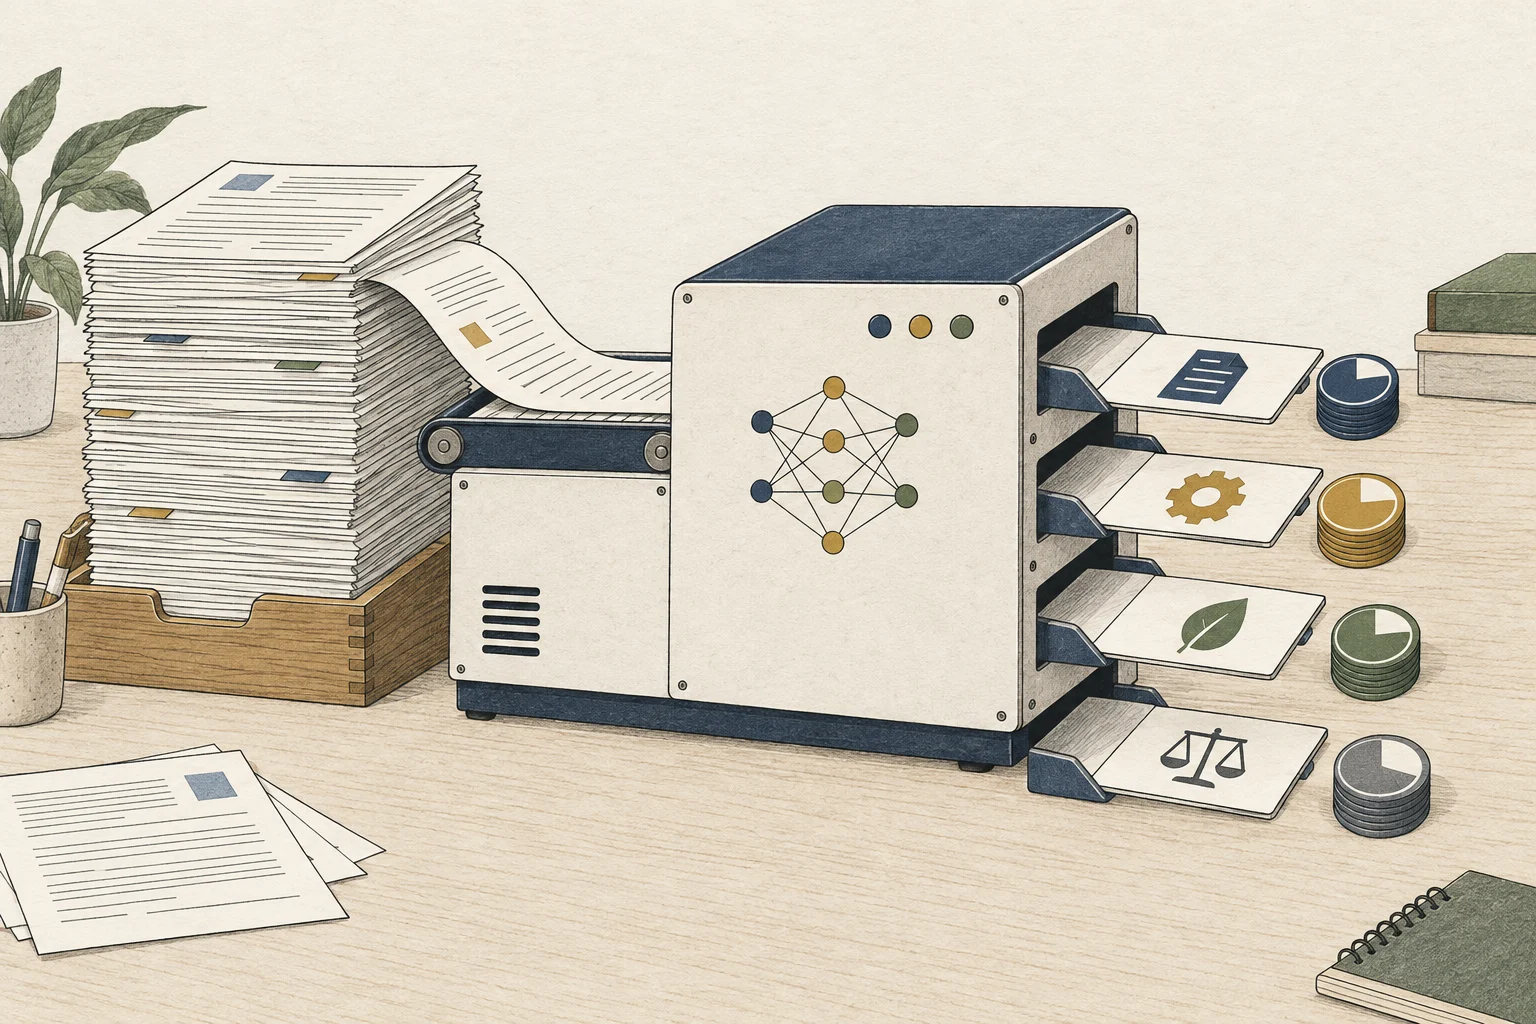
決めた判断項目をまとめて計算する
一般LLMはJSONモードでも括弧・キー・値をトークン2単位で生成します。Jevは出力構造と候補を事前に定め、複数の判断を並列計算できるため、生成対象が異なります。TypeSafeは自社サービスのend-to-end遅延を70~500msと説明していますが、これは同サービスの公開範囲であり、地域・入力長・質問数を問わず保証される時間ではありません。
比較では同じ問い合わせと選択肢数を使い、両方でネットワーク待ちを同じように含めます。一般LLMのJSON生成時間とJevのend-to-end時間では測定範囲が異なります。本稿は公開値を解釈するもので、新たな遅延測定や全条件での優位性を主張しません。
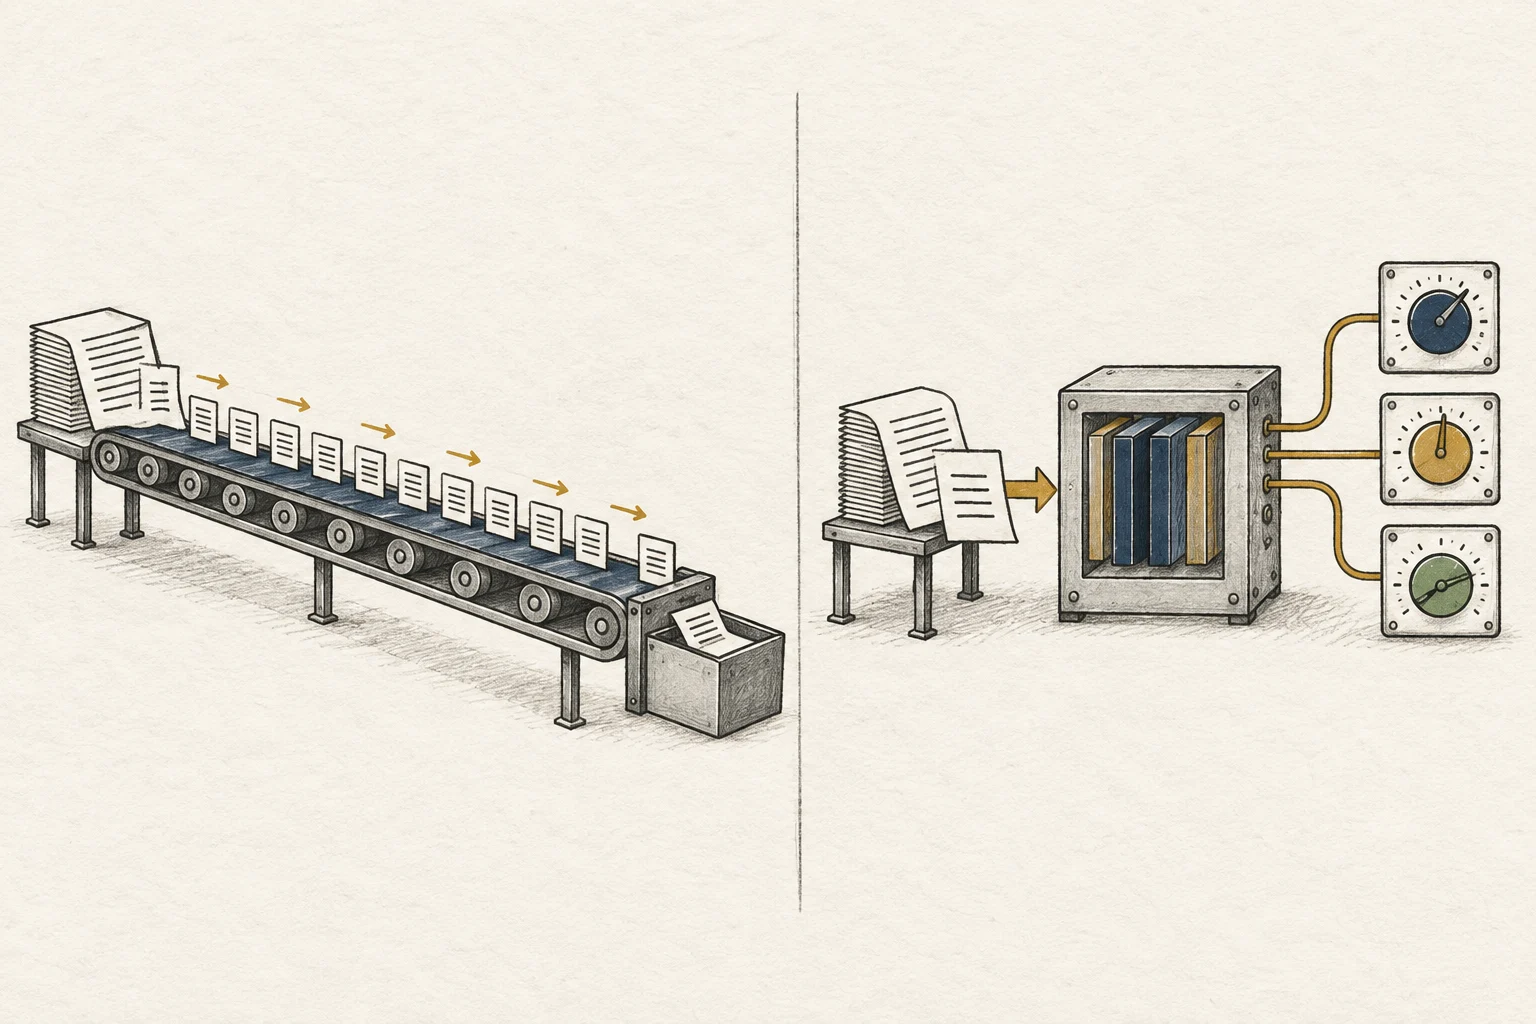
JEVは回答文の代わりに選択肢を採点します
JEV型decision modelは状況・質問・選択肢を受け取り、各選択肢のscoreやprobabilityを返します。反復するticket振り分けや状態判定に向き、自由な説明文は別の生成modelに任せます。
公開されたRTX PRO 6000の単一質問中央値はJulia-1 3ms、Laya 5ms、Kev-4B 12ms、lev 36ms、OpenJev 43msです。各model名・規模・言語を対応させ、異なる入力長や同時実行のservice遅延とは分けます。
業務の正解と確認基準を決める
選択肢を固定すると、billing・access・security以外の値やJSON構造の崩れを減らせます。しかし二つの決済が完了したのか、一方が保留か、アカウントアクセスに異常があるかが不明ならbilling分類も誤り得ます。形式の有効性と業務上の正確さは別です。
高い信頼度でも正解は保証されません。信頼度基準未満または候補差が小さい結果は人に回し、権限や決済など影響の大きい判断は自動承認しません。テスト例は人が先にラベル付けし、基準回答との比較で誤分類と人手確認への移行を分けて追跡します。
反復分類・振り分けはJev型、説明はLLMに任せる
担当部署振り分け・リスクスコア・候補順位・ポリシー適格性のように出力範囲が決まった作業では、構造化値を次段階へ渡しやすくなります。二重請求の原因説明・返金手順・不足情報の質問には自由文が必要です。Jevと一般LLMを分類・説明の別段階に使えますが、接続だけで正確性や速度は保証されません。
分類値が次の処理へ与える影響を図にします。受付キューを選ぶ値と返金を自動承認する値では許容誤りと確認要件が異なります。同じモデルでも後段の権限に応じて自動化範囲を定めます。
decision headと候補token採点を区別します
一部のQwen実装は候補token logitsを直接読み、Jev-OmniはGemma 4 12B IT表現上の別学習classification headを使います。長文生成を避けても内部経路とartifactは異なります。
API3公開前に選択肢・同点処理・不確実時の人手確認を決めます。選択文言の変更で正解labelとの対応が切れるためschema versionを記録します。
Qwenベースのローカル実装も比較できる
TypeSafeはJevの重みと訓練方法を非公開で運用しています。ローカルでは公開Qwenの候補ロジットを読む、共通文書のプリフィル4後に複数の質問へ分岐するプロジェクトを使えます。Jev型の選択値を別の方法で実装します。
実装ごとにモデル・プロンプト5・入力処理・並列化が異なる場合があります。同じデータと条件でローカル構成の正確性・確率較正・遅延を確認します。「Jevと同じ」ではなく「Jev型の判断方式を再現する実装」と表現します。
自分で試すなら、Qwenを使ったローカルJev実装の比較から始めてください。CPU6で試す方法とMac・NVIDIA GPU7向けのプロジェクトを分けて紹介しています。
JEV-27B-VLは画像の選択確率を返します
AutoTrustは、テキスト問い合わせで担当を選ぶJev型の判断を画像や画面にも適用するautotrust/JEV-27B-VLを公開しました。System 1は画像とテキストを受け取り、yes/no、2~256候補からの選択、0~5評価の確率を1回のforward passで返します。
同じmodelのSystem 2はQwen3.8-27Bを基盤とする通常の画像入力テキスト・推論を担当します。Apache-2.0で、28BのBF168重みを含みます。公式モデルカードと2026-09-30発表
商品写真をelectronics・clothing・homeのいずれかに分類する作業を考えます。stateに画像と販売者タイトルを入れ、questionに分類基準を書くと候補ごとの確率が返ります。選択項目だけ必要な場合はchoice、安全性など真である確率を読む場合はnoulを使います。確率が高いだけで決済や権限を自動処理せず、人がラベル付けした画像セットで誤分類と保留基準を先に評価します。
commandが完了すると、候補一覧とprobabilities配列を含むJSON responseが返ります。hf: command not foundではHugging Face CLI9のinstallを確認します。画像requestが拒否された場合は、state配列の{"image": URL}形式と画像URLへのアクセスを先に確認します。/v1/decideのroute errorでは、server logでserve_decide.pyが必要なvLLM開発環境で起動したか確認します。公式decision APIと画像入力形式
| 経路 | 適した入力 | 公式実行条件 |
|---|---|---|
Ollama /v1/systemone | Nimble・Tevによるテキスト選択・yes/no・score | Ollama 0.35.0以降と対応model |
JEV-27B-VL /v1/decide | テキスト・画像から選択確率 | vLLM開発build、80GB以上GPU推奨 |
python -m pip install -U huggingface_hub
hf download autotrust/JEV-27B-VL --local-dir JEV-27B-VL
python3 JEV-27B-VL/serve_decide.py --model JEV-27B-VL --served-model-name autotrust/JEV-27B-VL --host 127.0.0.1 --port 8000 --enable-lora --max-lora-rank 32 --lora-modules jev-decision=JEV-27B-VL/adapter_vllm --logprobs-mode processed_logprobs --max-model-len 32768 --enable-prefix-caching --mamba-cache-mode align --limit-mm-per-prompt '{"image": 8}' --max-num-seqs 8 --trust-request-chat-templatecurl http://127.0.0.1:8000/v1/decide -H 'Content-Type: application/json' -d '{"kind":"choice","state":["Photo: ", {"image":"https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/p-blog/candy.JPG"}],"question":"Which category fits this image?","options":["food","electronics","clothing","home"]}'同じ業務標本で精度と遅延を測ります
チケット100件に正解actionと「判断できない」の選択肢を含め、モデルごとに完全一致率・エラーの種類・空の応答を集計します。同じデバイスで入力長ごとの遅延を繰り返し測定し、p50とp95も記録します。
confidenceが低く影響の大きい判断は人へ回します。速度だけで導入せず、誤った自動処理の損失と確認コストを比較します。
computer-use scoreは入力要素と課題規模も読みます
AutoTrustは2026-10-03のカード更新で、headless Chromiumのランダムな多段階課題60件の95%を完了し、clickあたり約0.26秒だったと報告しています。課題はshopping・設定・mail画面で3~7回clickする構成です。modelには番号枠だけでなく画面要素のテキストも渡しています。番号枠だけの別条件では完了率10%だったため、95%をスクリーンショットだけでの一般GUI成功率として読んではいけません。公式カードのcomputer-use条件
ロボットアームの結果も実機ではなくMuJoCo simulationです。ランダムなscene 20件の75%を完了し、判断1回あたり約240msでした。制御loopと環境がbrowser clickとは異なるため、二つの遅延値は直接比較できません。vLLMのメモリ説明にはBF16重み52GBと、256K prompt時のKV cache10約17GBが記載され、183GB B200での測定です。80GB GPUでは--max-model-len 131072から始めるようカードが推奨しています。
| 試験 | 公開結果 | 条件と限界 |
|---|---|---|
| browser computer use | 60件中95%、約0.26秒/click | headless Chromium、3~7 click、番号枠+要素text |
| MuJoCoロボットアーム | 20 scene中75%、約240ms/decision | simulation、実機測定ではない |
| 256K text prompt | 約8,700 prompt tok/s | B200 1枚、逐次1 request、prompt 250K |
用語の注釈
大規模言語モデル — 大量のテキストデータから言語パターンを学び、文脈に沿ったテキストを処理・生成するモデルです。
本文に戻るトークン — モデルが入力や出力を分けて処理する単位です。
本文に戻るAPI — 別のコードからプログラムの機能を呼び出すための決められたインターフェースです。
本文に戻るプリフィル — LLMが入力プロンプトを読み、各トークンの内部表現を計算する段階です。プロンプトが長いほど処理するトークンが増えます。
本文に戻るプロンプト — モデルに送る入力文です。生成モデルでは作りたい結果を説明する文になり、出力の構成や内容を大きく左右します。
本文に戻るCPU — OSや一般的なプログラム命令を実行する中央処理装置です。AIでは前処理やデータ転送などの汎用処理も担います。
本文に戻るGPU — 多くの計算を並列に処理するプロセッサーです。AIモデルの実行ではモデル計算を担います。
本文に戻るBF16 — モデルの数値に使う16ビット浮動小数点形式です。指数部はFP32と同じ幅で、同程度に広い値の範囲を表せます。
本文に戻るCLI — Command-Line Interfaceの略です。ターミナルにコマンドを入力してプログラムを操作する方式です。
本文に戻るKVキャッシュ — 過去トークンのAttention用キー・バリューを保存し、後続トークン生成で再利用するメモリです。容量はコンテキスト長やバッチサイズで変わります。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- Jevは文書や問い合わせから、事前に決めた選択肢と信頼度を返す判断モデルです。担当部署やリスク区分など、次のプログラムがそのまま使う値を作ります。繰り返す分類を自動化し、説明は通常のLLMや人に任せられます。
- 必要なメモリはどのくらいですか?
- ロボットアームの結果も実機ではなくMuJoCo simulationです。ランダムなscene 20件の75%を完了し、判断1回あたり約240msでした。制御loopと環境がbrowser clickとは異なるため、二つの遅延値は直接比較できません。vLLMのメモリ説明にはBF16重み52GBと、256K prompt時のKV cache約17GBが記載され、183GB B200での測定です。80GB GPUでは`--max-model-len 131072`から始めるようカードが推奨しています。
- 条件と出典はどこで確認できますか?
- 同じmodelのSystem 2はQwen3.8-27Bを基盤とする通常の画像入力テキスト・推論を担当します。Apache-2.0で、28BのBF16重みを含みます。[公式モデルカード](https://huggingface.co/autotrust/JEV-27B-VL)と[2026-09-30発表](https://huggingface.co/blog/autotrust/autotrustjev-27b-vl-a-decision-model-that-learned)