
応答速度と加速
最終更新
MTPとは:複数トークン予測の仕組みと適用条件
MTPは次のtoken候補を作り、メインモデルが一致する範囲を検証します
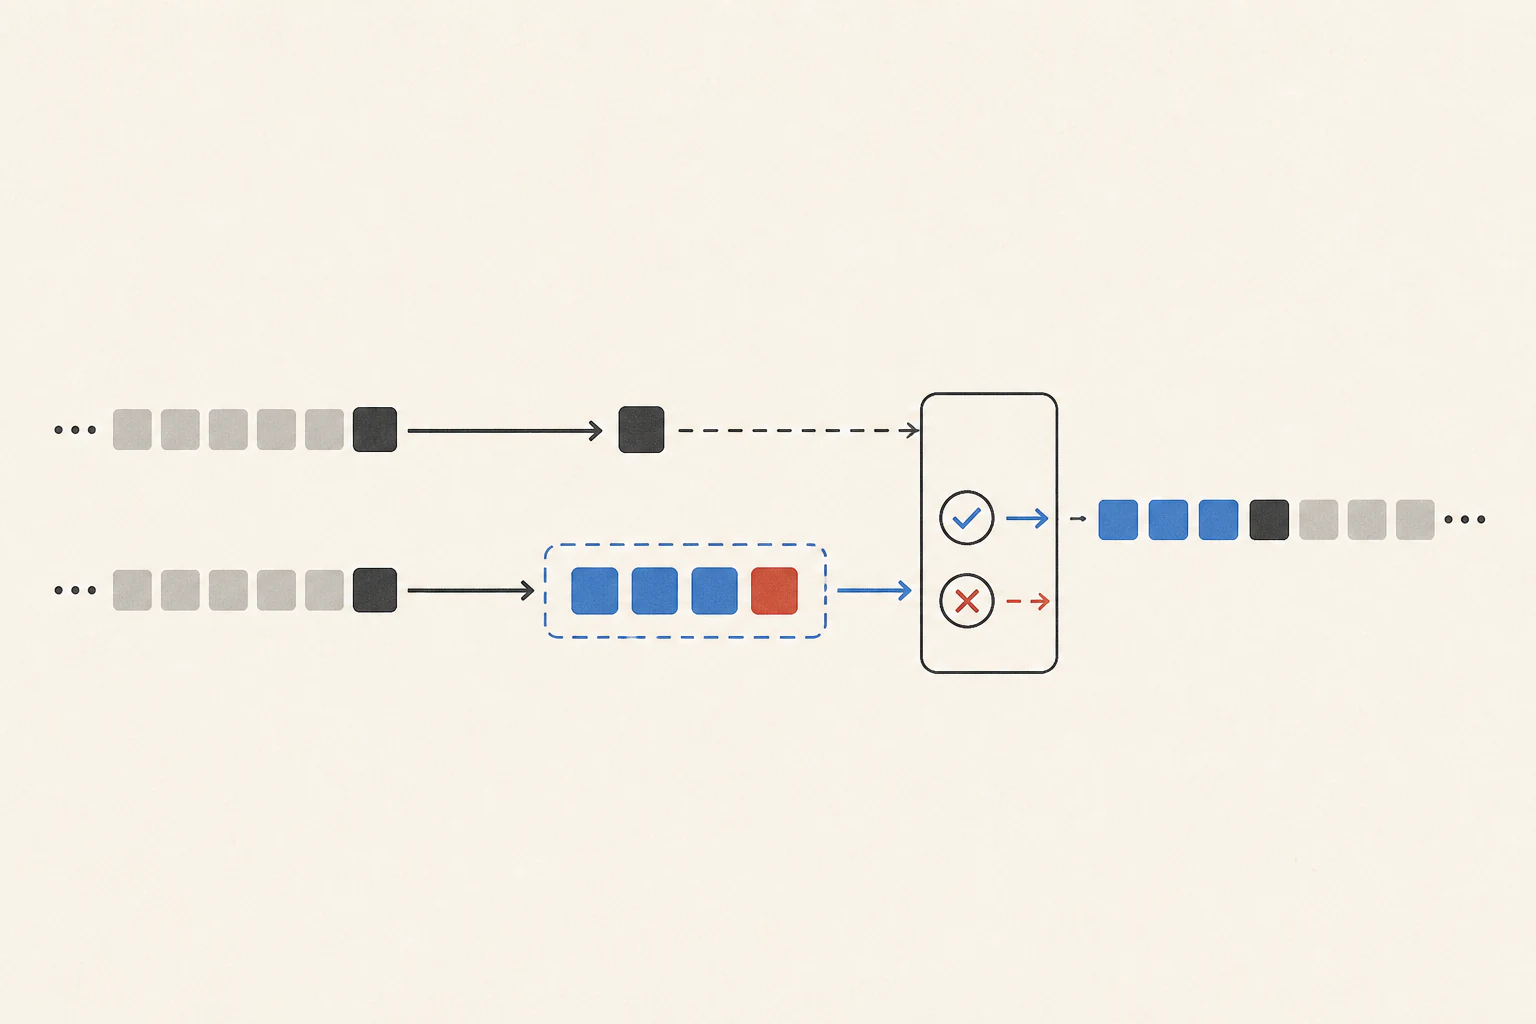
MTP1は回答の次のトークン2候補を先に作り、複数トークンをまとめて検証する生成方式です。追加の予測ヘッドが候補を用意し、本モデルが承認した連続区間を回答に反映します。候補の一致度によって実際の生成速度が変わるため、同じコード修正の依頼で通常生成と比較します。
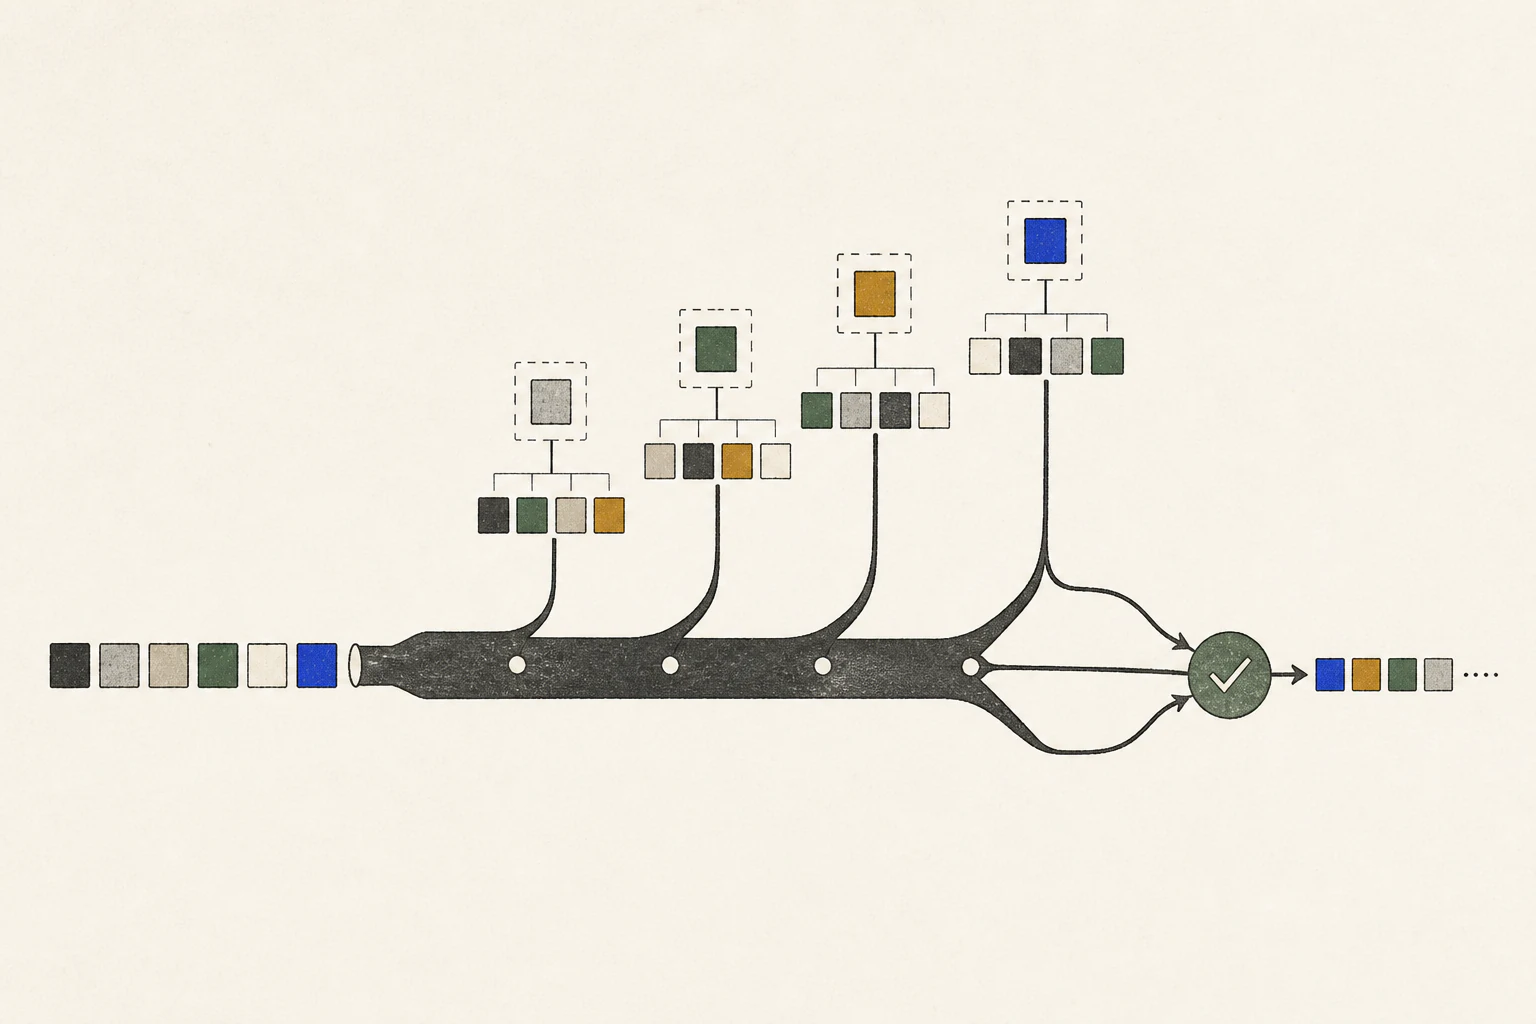
関数名の変更と空入力エラー処理を含むcode修正を依頼したとします。通常生成は次のtokenを決め、その結果を含めてさらに次を計算します。MTP予測headは後続候補を先に準備し、メインモデルが複数位置をまとめて検証できるようにします。3候補を作っても全て回答に残るわけではありません。
メインモデルは一致する連続候補を承認します
たとえば3候補のうち最初のtokenだけ一致すればそれを残し、後の2つは破棄します。モデルは不一致地点から続けるため却下候補は出力しませんが、候補作成と検証には計算がかかっています。3tokenが連続して一致すればメインモデルは一部の逐次計算を減らせます。
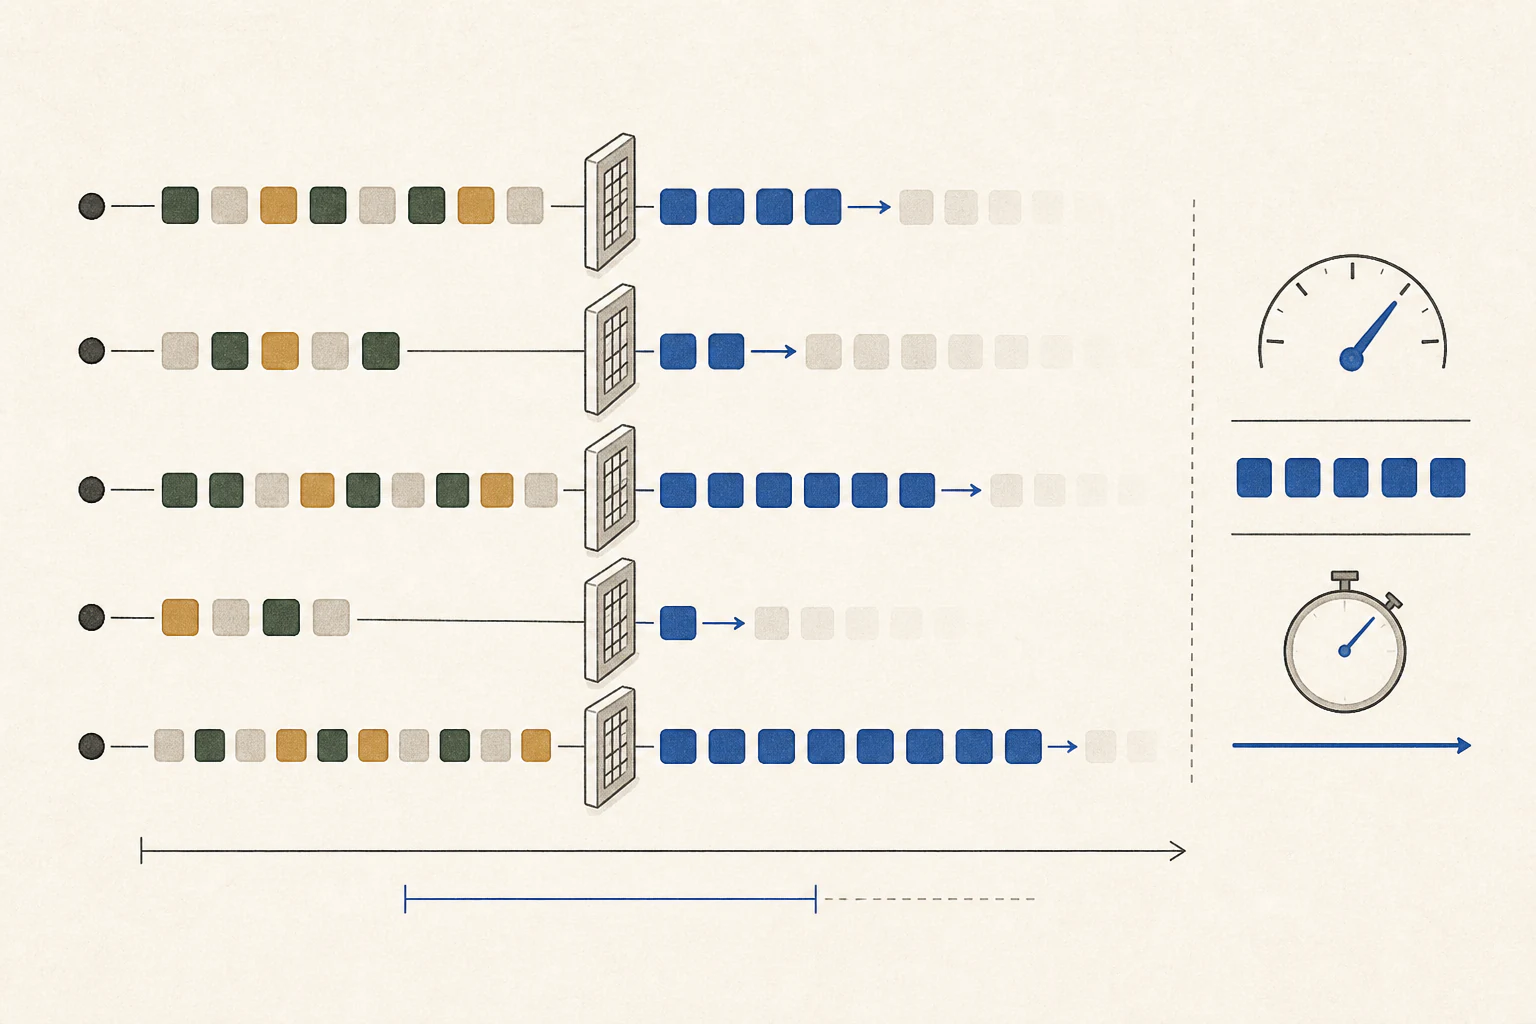
そのため予測深度が高いほど常に速いわけではありません。不一致が多ければ破棄作業が増え、連続候補がよく承認されれば逐次計算を減らす余地が増えます。予測token数ではなく実際の依頼の完了時間を比較します。
設定を有効にする前にモデルfileとruntime対応を確認します
同じcode修正でMTP前後を比較します
まずMTPを無効にし、同じfile、質問、依頼長で基準回答を作ります。同じmodel fileでMTP設定だけを変えて実行します。準備後、各状態を3回測り中央値を比較し、モデル再読み込み時間は別記録します。会話cache状態と他の起動アプリも両条件で揃えます。
入力処理と回答生成のどちらが遅いか先に確認します。MTPが主に対象とするのは後者の生成区間です。PDF検索や長い入力の後に初回答が遅い場合はprefill6と文書受け渡しも別に測定します。
最初のtokenまでのTTFT7、その後のdecode8、全体完了時間を分けます。decode tok/sは最初のtoken以降の生成数をdecode時間で割り、読み込みとTTFTは含めません。両回答の修正範囲と生成token数が近いかも確認します。
出力codeで関数名と呼び出し箇所、空入力error、通常入力処理を確認します。token候補の検証は利用者要件の検査ではないため、時間が短くても修正範囲が欠ければ同じ作業を速く終えたとはいえません。
速度上の利点がない場合は失敗段階に合わせて調整します
経路が有効でもdecode時間が変わらなければ、この依頼で利点は観察されませんでした。長いPDF後に初回答が遅ければprefillと検索を、メモリerrorなら入力長とcacheを先に確認します。
反復測定でMTPが実際の完了時間を短縮し、codeが要件を満たすなら現在の機器を使い続けられる場合があります。MTP非対応または結果に差がなければ、広告の最大加速を購入根拠にせず、作業を止めている別の段階を先に解決します。
用語の注釈
MTP — 複数の将来トークンを一度に予測する学習目標、またはそれを行うモデル構成です。投機的デコーディングでは、その予測を候補トークンとして提案できます。
本文に戻るトークン — モデルが入力や出力を分けて処理する単位です。
本文に戻るチェックポイント — 学習済みモデルの重みなどを保存したファイルです。同じモデル系列でも、版や用途によって異なるチェックポイントを使うことがあります。
本文に戻るランタイム — プログラムの実行時に必要な機能を提供するソフトウェア環境です。ローカルAIではモデル実行エンジンを指すこともあります。
本文に戻る量子化 — モデルの重みや計算値を少ないビット数で表し、保存容量やメモリ使用量を減らす方法です。表現が粗くなるため、精度にも影響することがあります。
本文に戻るプリフィル — LLMが入力プロンプトを読み、各トークンの内部表現を計算する段階です。プロンプトが長いほど処理するトークンが増えます。
本文に戻る最初のトークンまでの時間 — リクエスト送信から最初の出力トークンが届くまでの時間です。
本文に戻るトークンのデコード — 入力とそれまでの回答をもとに、次の出力トークンを順に生成する段階です。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- MTPは回答の次のトークン候補を先に作り、複数トークンをまとめて検証する生成方式です。追加の予測ヘッドが候補を用意し、本モデルが承認した連続区間を回答に反映します。候補の一致度によって実際の生成速度が変わるため、同じコード修正の依頼で通常生成と比較します。