
실행 프로그램과 확장
최종 업데이트
FlashAttention과 PagedAttention 차이
FlashAttention은 계산 이동을, PagedAttention은 KV 캐시 배치를 다뤄요
FlashAttention1은 어텐션2 계산을 작은 타일로 나눠 중간 데이터를 메모리에 반복해서 쓰고 읽는 일을 줄여요. PagedAttention은 여러 요청의 KV 캐시3를 고정 블록으로 나눠 필요한 만큼 배정하고 회수해요. 하나는 계산 커널, 다른 하나는 요청별 메모리 관리여서 역할이 다르고 함께 지원될 수도 있어요.
긴 코드 저장소를 읽는 요청은 입력 토큰4의 관계를 계산하는 프리필5을 거치고, 답변 생성 중에는 다음에 이어갈 상태를 KV 캐시에 보관해요. FlashAttention은 앞쪽 어텐션 계산의 메모리 이동을, PagedAttention은 여러 요청이 함께 쓰는 캐시 배치를 다뤄요.
FlashAttention은 긴 입력의 어텐션 계산을 나눠 처리해요
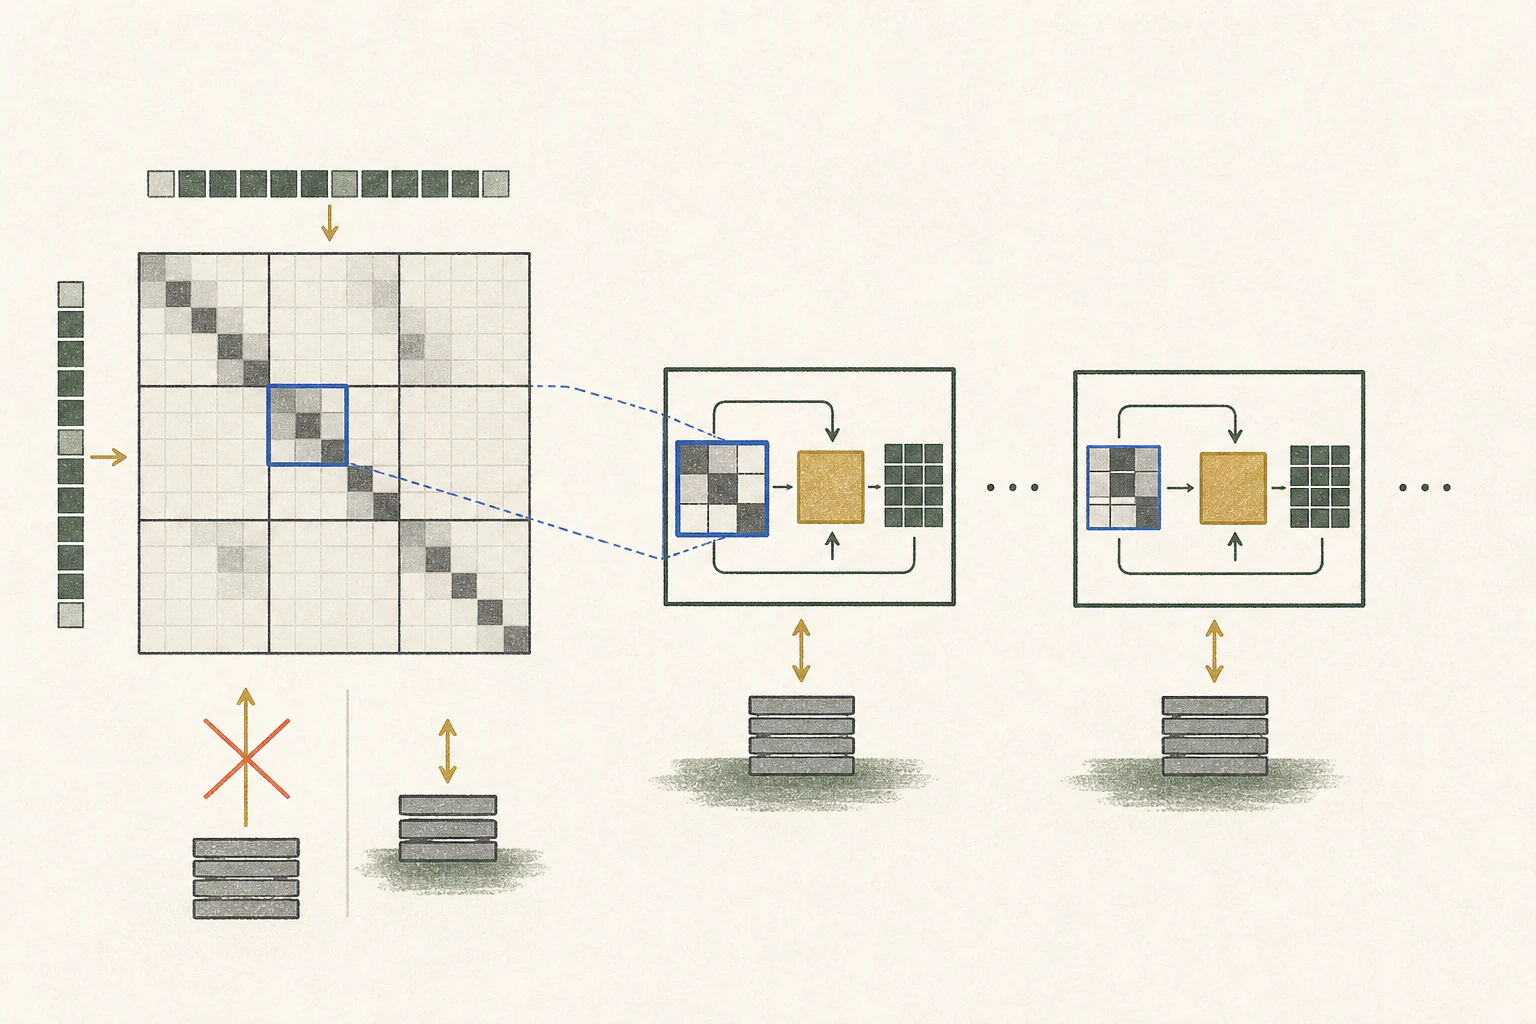
모델은 입력 토큰이 서로 참고할 정보를 어텐션으로 계산해요. 입력이 길수록 중간 결과를 GPU6 메모리에 쓰고 다시 읽는 이동이 많아져요. FlashAttention은 입력을 작은 타일로 계산하고 중간 결과를 큰 배열에 반복 기록하지 않아 데이터 이동을 줄여요.
입력 전체를 어텐션 계산에 사용하면서 중간 결과의 저장과 이동을 줄이는 방식이에요. 긴 입력에서 첫 토큰까지 오래 걸린다면 모델 로딩 시간과 프리필 시간을 나누어 기록하고, 실행 로그에서 FlashAttention 커널이 선택됐는지 확인해요.
PagedAttention은 요청별 KV 캐시 공간을 관리해요
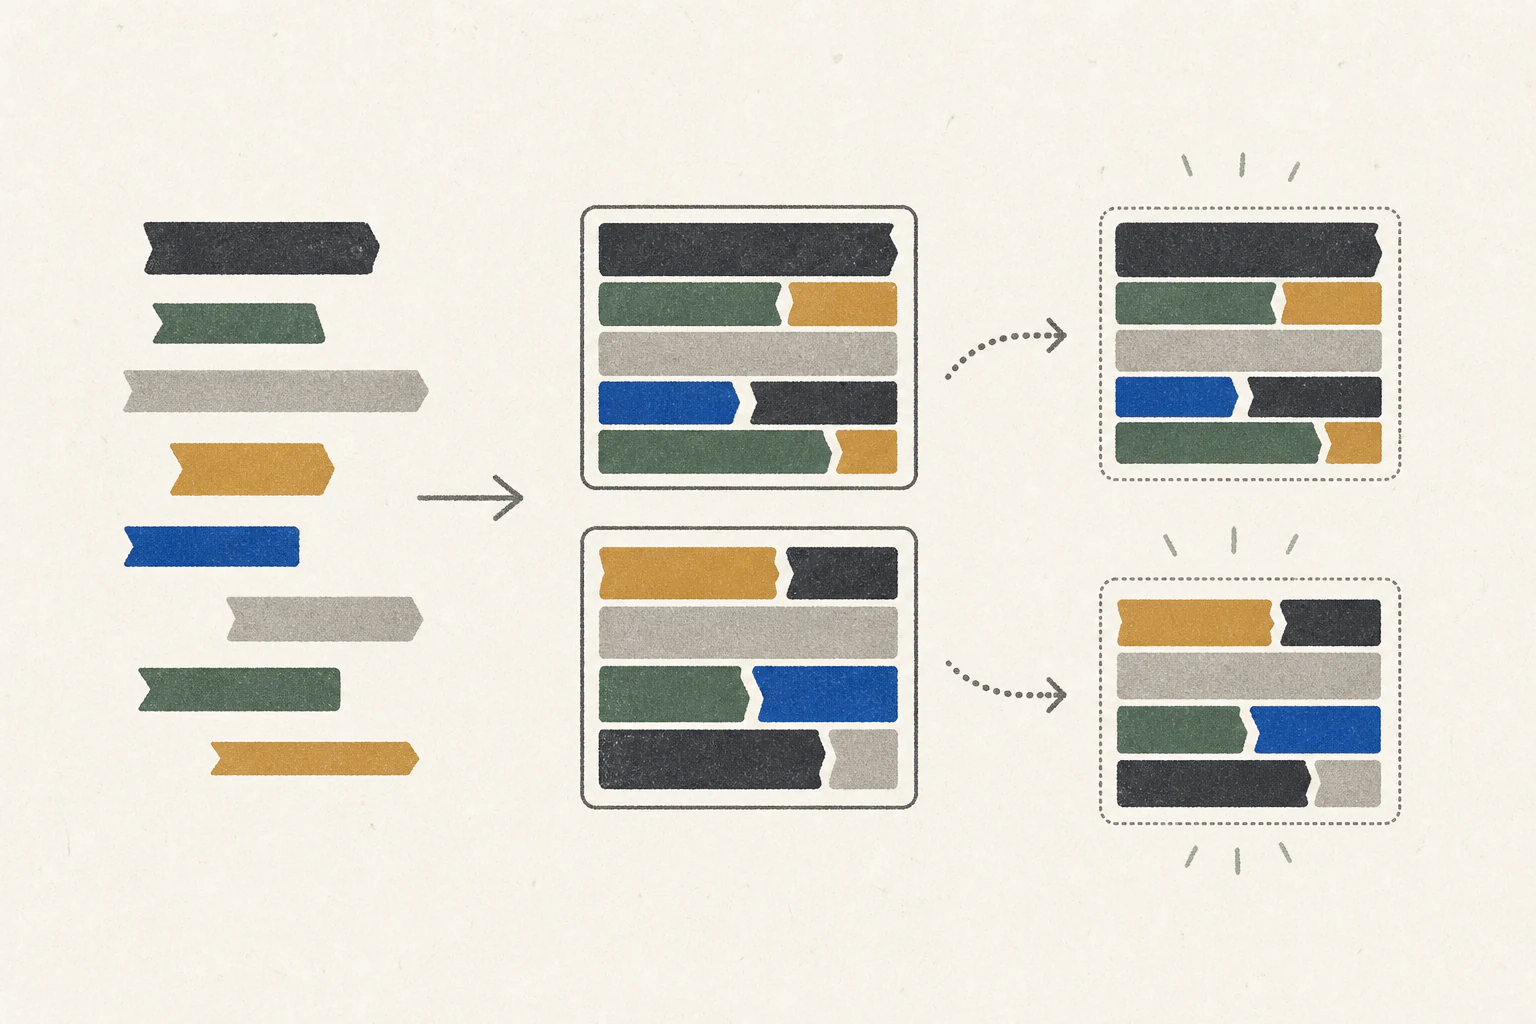
서버에 길이가 다른 요청이 들어오면 각 대화는 입력과 지금까지 생성한 토큰의 상태를 KV 캐시에 보관해요. PagedAttention은 이 캐시를 같은 크기의 블록으로 관리하고 요청마다 필요한 만큼 배정한 뒤 완료되면 회수해요. 큰 연속 메모리를 요청별로 미리 잡아둘 때 생길 수 있는 빈 공간을 줄이는 목적이에요.
요청 A가 이어지는 동안 짧은 B가 끝나면 B의 블록을 회수해 C에 배정할 수 있어요. A의 대화에 필요한 상태는 A가 끝날 때까지 유지해요. 같은 GPU 메모리 안에서 요청별 공간을 효율적으로 나눠 쓰는 거예요.
동시 요청이나 문서 길이가 늘면 활성 캐시도 필요해요. 입력 프리필이 실행 중인 디코드7와 GPU 자원을 나누면 토큰 간격이 길어질 수 있고, 긴 프리필을 나누어 스케줄링하는 지원 여부는 런타임8마다 달라요. 캐시를 더 효율적으로 배치해도 실제 상태를 담을 물리 메모리는 필요해요.
서로 다른 역할이라 함께 쓸 수 있어요
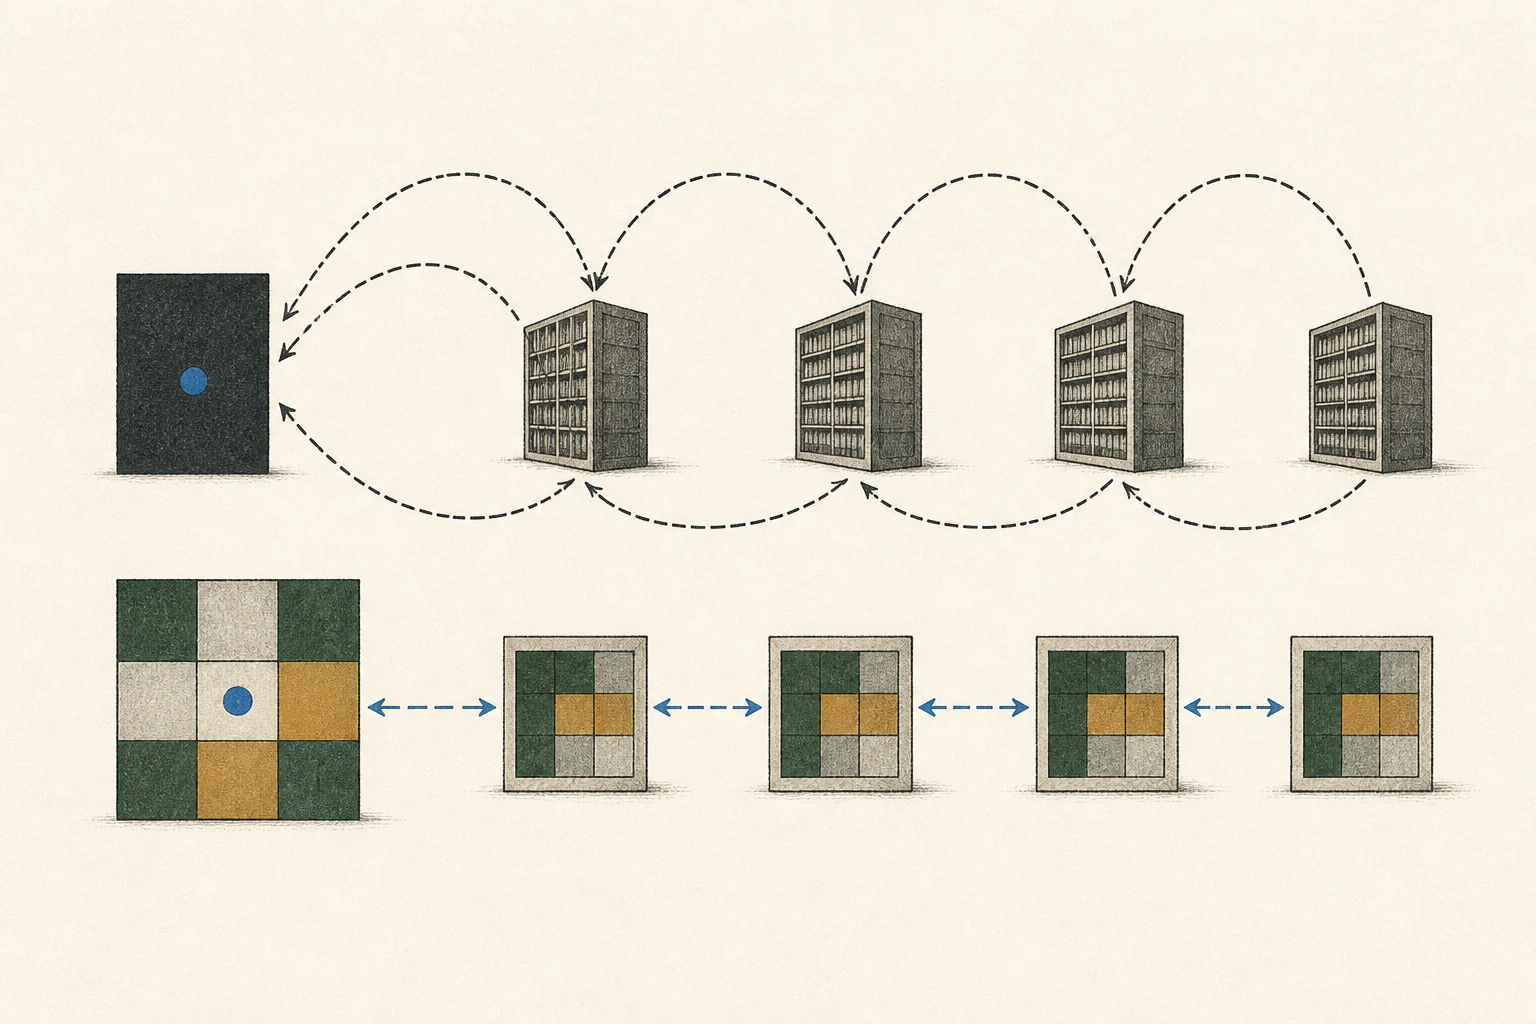
FlashAttention은 어텐션 계산 중 데이터가 메모리를 오가는 방식을 바꾸고, PagedAttention은 각 요청의 KV 캐시를 블록에 배정하는 방식이에요. 같은 런타임이 모두 지원하면 프리필 계산과 요청 메모리 관리를 함께 최적화할 수 있어요. 긴 코드 입력에서 프리필이 느린 문제와 팀 요청이 겹칠 때 캐시 공간이 부족한 문제는 각각 다른 조건을 확인해요.
지원 여부는 GPU·모델 구조·양자화9·앱 버전에 따라 달라지고, 런타임이 자동으로 경로를 고를 수도 있어요. 메뉴에 옵션 이름이 보이는지만으로 적용됐다고 보지 말고 로그에서 실제 커널과 캐시 경로를 확인해요. 강제 설정을 시험하기 전 정상 실행되는 기본값을 기록해 둬요.
요청 한 건과 팀 서버를 각각 측정해요
개인용으로 짧은 함수 하나를 물으면 동시 캐시 상태가 적어 PagedAttention의 서버 메모리 배치 이점이 작을 수 있어요. FlashAttention도 프리필과 한 토큰씩 만드는 디코드에서 효과가 같다고 볼 수 없어요. 첫 토큰 대기와 생성 중 토큰 간격을 분리해 기록해요.
팀 서버는 한 요청의 기준 결과를 만든 뒤 긴 코드 분석 중 짧은 질문과 다른 분석을 겹쳐 보내요. 첫 토큰, 생성 구간, 피크 메모리, 요청별 지연, 전체 처리량10을 기록하면 커널 계산과 캐시 관리 중 어떤 변화가 사용자에게 도움이 됐는지 볼 수 있어요.
런타임이 허용하는 옵션을 한 번에 하나씩 시험하고 로그에서 실제 적용을 확인해요. 사용자 조정 옵션이 없으면 임의로 넣지 말고 자동 선택 여부를 로그에서 살펴요. 입력 계산이 병목일 때 FlashAttention 경로를, 겹치는 요청의 캐시 배치가 문제일 때 PagedAttention 지원을 확인해요.
용어 각주
FlashAttention — 어텐션 계산을 작은 타일로 나눠 중간 결과를 빠른 온칩 메모리에 유지하고, GPU 메모리 왕복과 전체 어텐션 행렬 저장을 줄이는 알고리즘입니다.
본문으로 돌아가기어텐션 — 입력 토큰 사이의 관련도를 계산해 각 위치의 정보를 현재 표현에 반영하는 신경망 연산입니다.
본문으로 돌아가기KV 캐시 — 어텐션에서 이전 토큰의 키·값을 저장해 다음 토큰 생성 때 재사용하는 메모리입니다. 문맥 길이와 배치 크기에 따라 용량이 달라집니다.
본문으로 돌아가기토큰 — 모델이 입력이나 출력을 나누어 처리하는 단위입니다.
본문으로 돌아가기프리필 — LLM이 입력 프롬프트를 읽고 각 토큰의 내부 표현을 계산하는 단계입니다. 입력이 길수록 처리할 토큰이 많아집니다.
본문으로 돌아가기GPU — 많은 계산을 병렬로 처리하는 프로세서입니다. AI 모델 실행에서는 모델 계산을 맡습니다.
본문으로 돌아가기토큰 디코드 — 입력과 앞서 만든 답변을 바탕으로 다음 출력 토큰을 차례로 생성하는 단계입니다.
본문으로 돌아가기런타임 — 프로그램이 실행될 때 필요한 기능을 제공하는 소프트웨어 환경입니다. 로컬 AI에서는 모델을 실행하는 엔진을 가리키기도 합니다.
본문으로 돌아가기양자화 — 모델의 가중치나 계산값을 더 적은 비트로 표현해 저장 공간과 메모리 사용량을 줄이는 방법입니다. 표현 단계가 거칠어져 정확도에도 영향을 줄 수 있습니다.
본문으로 돌아가기처리량 — 일정 시간 동안 처리하거나 생성한 작업량입니다. 토큰/초, 요청/초처럼 단위를 함께 확인해야 비교할 수 있습니다.
본문으로 돌아가기
자주 묻는 질문
- 이 글에서 가장 먼저 확인할 것은 무엇인가요?
- FlashAttention은 어텐션 계산을 작은 타일로 나눠 중간 데이터를 메모리에 반복해서 쓰고 읽는 일을 줄여요. PagedAttention은 여러 요청의 KV 캐시를 고정 블록으로 나눠 필요한 만큼 배정하고 회수해요. 하나는 계산 커널, 다른 하나는 요청별 메모리 관리여서 역할이 다르고 함께 지원될 수도 있어요.
- 필요한 메모리는 어느 정도인가요?
- 서버에 길이가 다른 요청이 들어오면 각 대화는 입력과 지금까지 생성한 토큰의 상태를 KV 캐시에 보관해요. PagedAttention은 이 캐시를 같은 크기의 블록으로 관리하고 요청마다 필요한 만큼 배정한 뒤 완료되면 회수해요. 큰 연속 메모리를 요청별로 미리 잡아둘 때 생길 수 있는 빈 공간을 줄이는 목적이에요.