
먼저 읽기
최종 업데이트
로컬 LLM 장비 고르는 법: 메모리·속도·전력 기준
로컬 LLM 장비는 필요한 메모리와 기다림으로 골라요
로컬 LLM1은 내 컴퓨터에서 질문·문서·코드를 처리해 답변을 만드는 모델이에요. 장비를 고를 때는 모델이 들어갈 메모리와 답을 받기까지의 시간이 중요해요. 먼저 평소 사용하는 PDF와 코드 질문을 현재 컴퓨터에서 실행하고, 부족한 지점을 찾아 두 후보를 비교해요.
기기에서 모델이 아예 적재되지 않으면 용량 문제예요. 모델이 적재되고 답은 정확하지만 첫 글자까지 오래 걸리면 입력 처리 대기를, 답이 시작된 뒤 문장이 천천히 이어지면 생성 속도를 살펴요. 반대로 빨리 답해도 PDF 날짜를 틀리거나 코드를 망가뜨리면 먼저 질문이나 모델을 점검해야 해요. GPU2를 추가해도 답의 품질은 그대로예요.
구매 전에 지금 컴퓨터에서 두 작업을 해봐요
20쪽 업무 PDF에서 갱신 날짜와 근거 문단을 찾고, 가끔 함수 오류를 고치는 것이 목표라면 장비는 이 두 작업을 끝까지 처리할 수 있는지로 평가해요. 공개 모델을 모두 실행하는 최고 사양을 기준으로 시작할 필요는 없어요. 같은 PDF 질문과 같은 코드 요청을 현재 컴퓨터에서 실행해요. PDF에서는 날짜와 근거가 맞는지, 코드에서는 수정안이 기존 테스트를 통과하는지 확인하고 모델 이름·양자화3·입력 길이를 함께 적어요.
작업별로 중요한 판단 기준은 달라요.
| 작업 | 먼저 확인할 결과 | 막히면 볼 지표 |
|---|---|---|
| PDF 요약·근거 검색 | 날짜와 근거 문단이 원문과 맞는지 | 긴 입력의 첫 답 대기와 메모리 여유 |
| 함수 오류 수정 | 요청한 수정이 테스트를 통과하는지 | 답변 생성 시간과 반복 수정량 |
파일 적재와 전체 작업에 필요한 메모리는 달라요
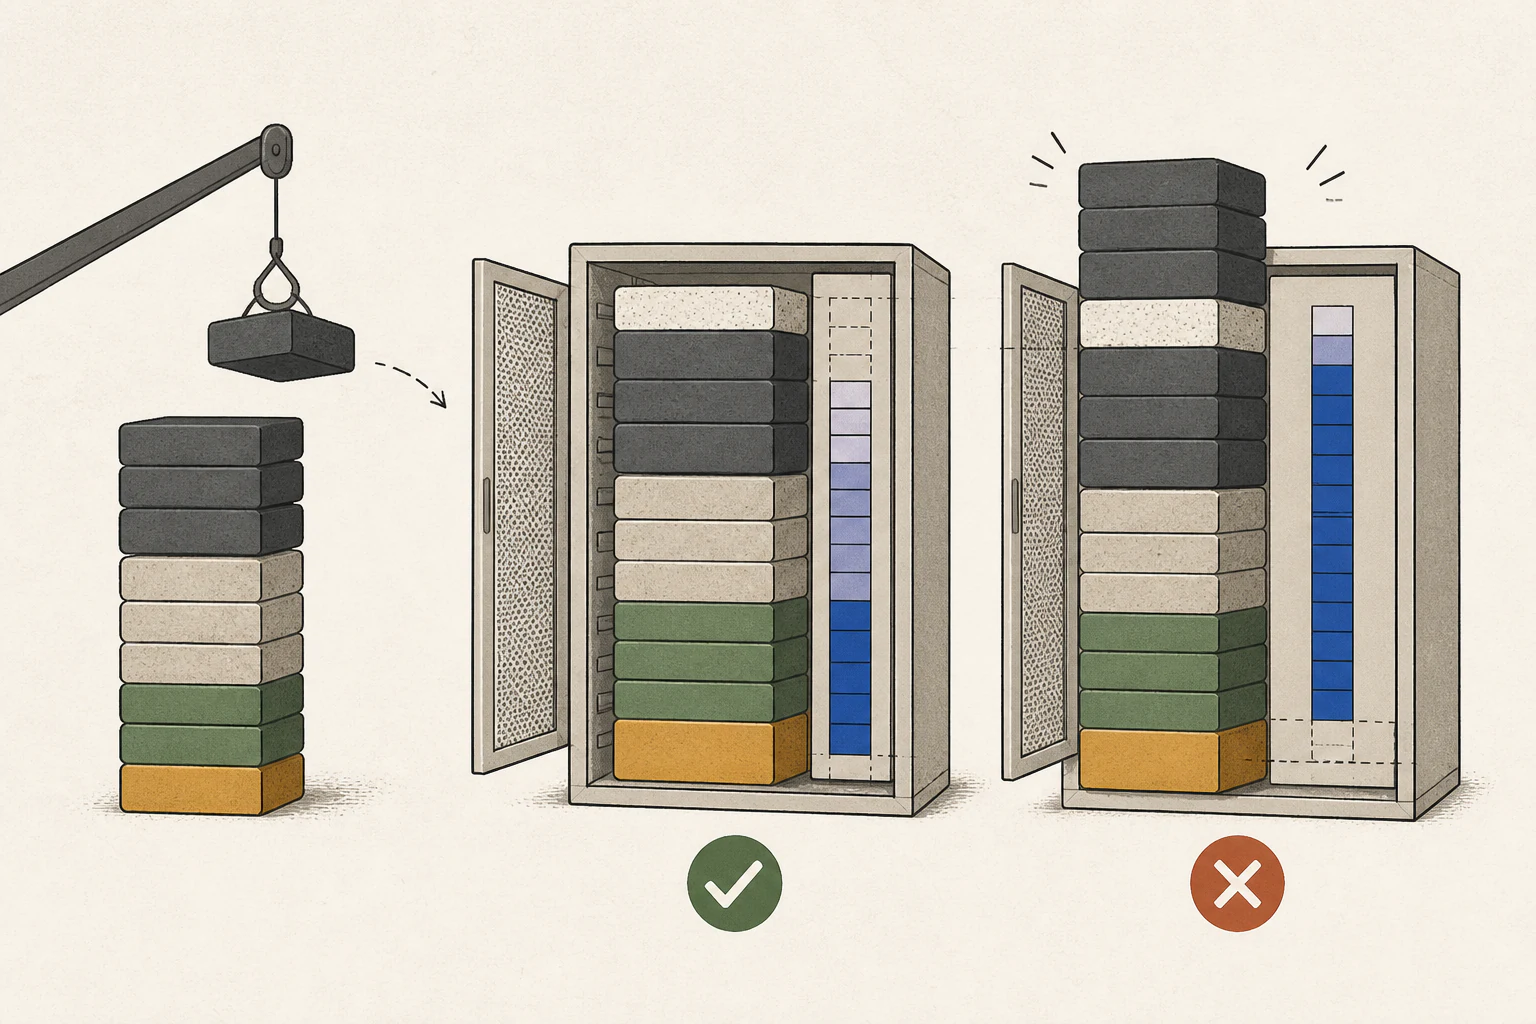
가중치 파일이 메모리에 올라가도 실행 프로그램4의 작업 공간과 입력·답변을 위한 KV 캐시5가 남아야 해요. 긴 문서는 짧은 인사말보다 더 많은 문맥을 유지하고, 답변 생성에도 공간이 필요해요. 그래서 짧은 질문 하나가 성공했다고 20쪽 PDF도 같은 상태로 처리할 수 있다고 판단하지 않아요. 모델 적재, 문서 입력, 답변 완료까지 실제 흐름으로 확인해요.
Mac의 통합 메모리6는 운영체제와 앱이 함께 쓰고, 외장 GPU의 VRAM7은 시스템 RAM8과 별도예요. 두 환경의 32GB 표기가 모델 전용 공간도 같다는 뜻은 아니에요. 브라우저와 문서 프로그램을 평소처럼 켠 상태로 작업할 예정이라면 그 앱들이 차지할 여유도 남겨요. 표시된 메모리를 전부 모델에 줄 수 있다고 계산하지 말고 작업으로 확인해야 해요.
첫 답 대기와 답변 생성 속도를 따로 봐요
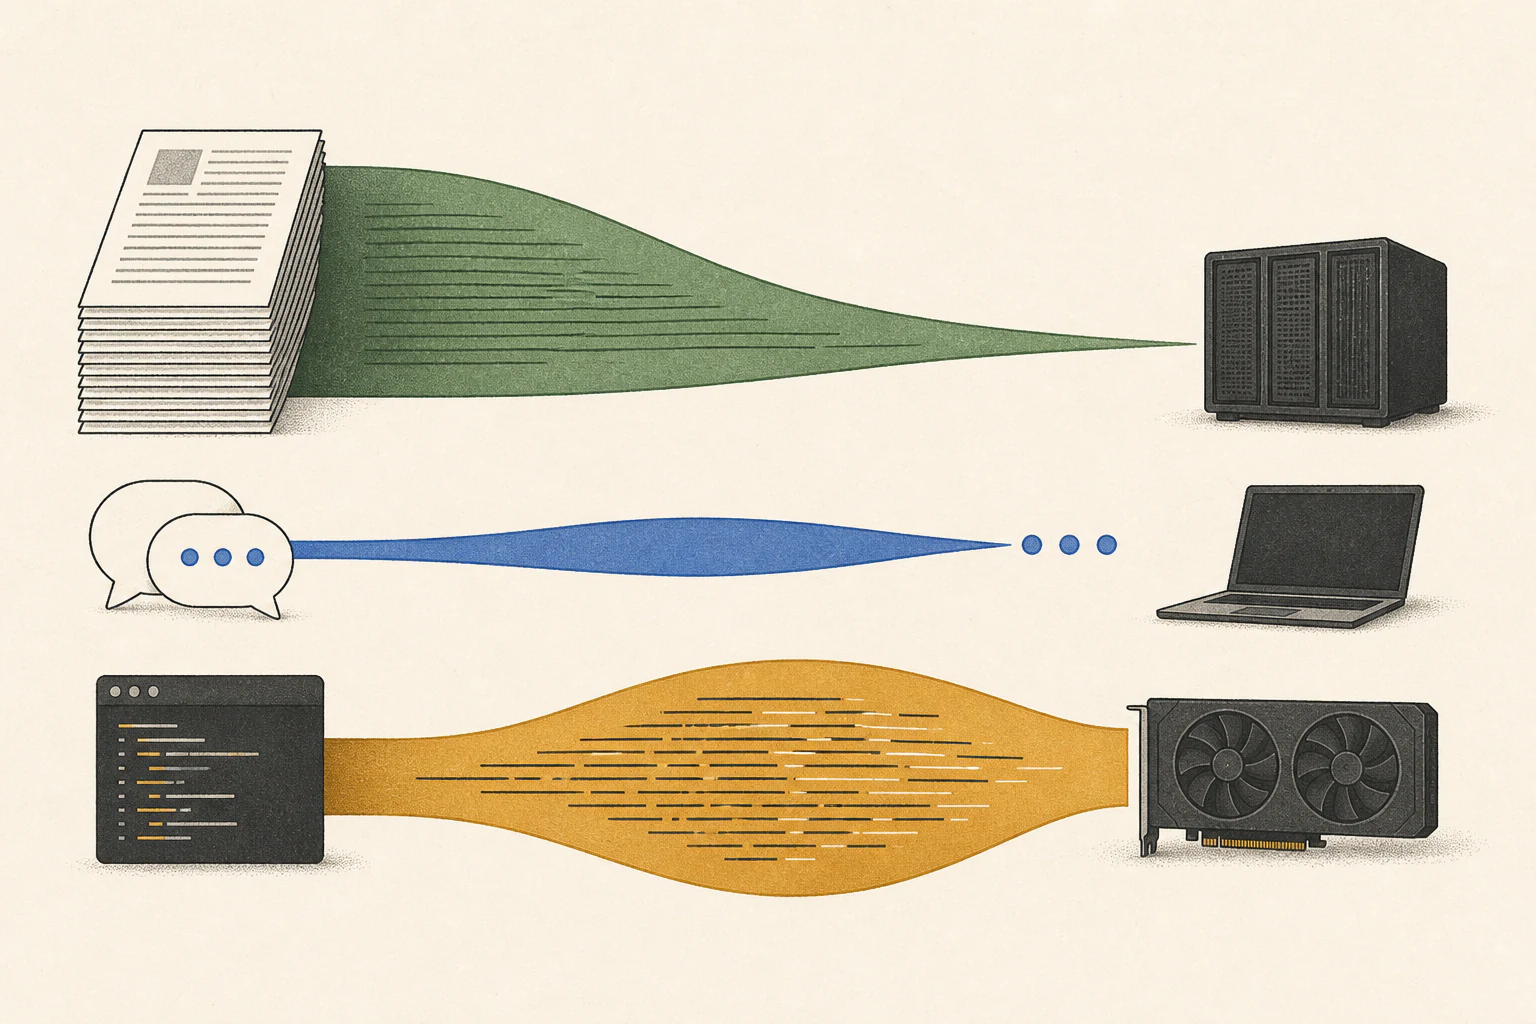
모델이 메모리에 들어가도 기다림이 길면 자주 쓰지 않게 될 수 있어요. 문서 입력 뒤 첫 답이 나올 때까지의 시간은 입력을 처리하는 프리필9의 영향을 받고, 답이 시작된 뒤 완료될 때까지는 디코드10가 영향을 줘요. 두 시간을 따로 재면 긴 문서 입력을 줄일지, 답변 생성이 더 빠른 구성을 찾을지 알 수 있어요.
사이트의 속도 체감으로 후보를 좁힌 다음 직접 쓸 모델과 비슷한 조건의 실행 기록을 확인해요. 모델 이름만 같아도 양자화, 입력 길이, 실행 모드가 다르면 장비 비교가 같은 조건이 아니에요. 예상 체감은 가능성을 살피는 출발점으로 쓰고, 내 문서에서 직접 측정한 기록과 섞지 않아요.
200만~300만원 예산은 기존 PC에서 쓸 부품부터 따져요
먼저 현재 PC에 어떤 GPU와 VRAM이 있는지 보고, 필요한 모델과 입력이 그 안에 들어가는지 확인해요. 새 그래픽카드만 살 수 있는지도 살펴요. 파워 용량과 전원 단자, 케이스의 카드 길이·두께와 슬롯 공간, 메인보드가 지원하는 RAM 규격과 빈 슬롯, 모델 파일을 둘 SSD11 여유를 함께 확인해요.
견적은 기존 PC를 활용하는 경우와 새 시스템을 사는 경우로 나누고 같은 항목을 비교해요. 기존 PC 쪽에는 GPU와 실제로 바꿔야 할 파워·케이스·RAM·저장장치·냉각 비용을 더해요. 새 PC나 Mac 쪽에는 본체와 메모리·SSD 옵션까지 포함해요. 중고 GPU는 보증과 반품 조건도 가격 옆에 적어요. 시세 화면의 금액은 확정 견적이 아니며 TCO 계산에 누락된 본체 부품 비용은 별도로 더해야 해요.
예산이 200만~300만원이라면 두 견적이 예산 안에 들어오는지 확인하고, 같은 모델·양자화·입력 길이로 예상 대기를 비교해요. 예시 비교 주소는 RTX 3090 24GB와 Mac mini M4 32GB, Qwen 3.8 27B, 문맥 4096 조건을 사용해요. VRAM과 통합 메모리를 숫자만으로 같게 보지 말고, 앱이 CUDA12나 macOS를 지원하는지도 확인해요. 양쪽 다 예산을 넘으면 모델이나 입력 길이를 낮춰 먼저 시험하고, 실제로 부족했던 지점을 확인한 뒤 다시 견적을 내요.
확장하기 어려운 장비는 반복 작업으로 여유를 정해요
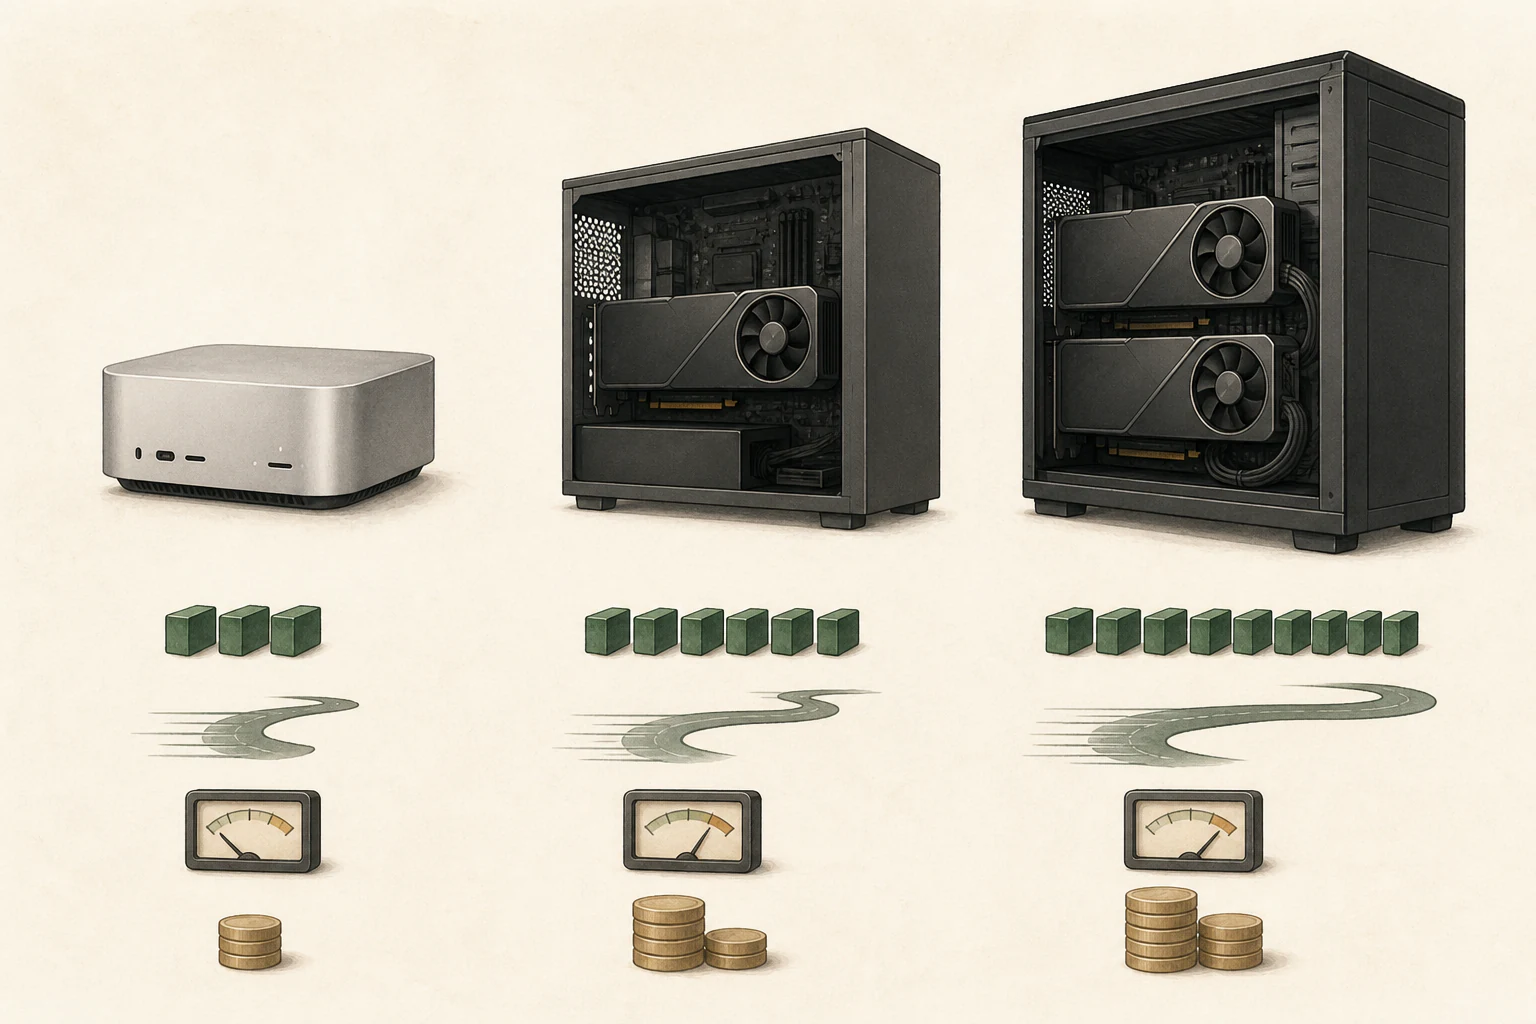
구매 뒤 메모리를 바꾸기 어려운 장비라면 지금 할 일과 다음으로 꼭 해볼 일을 각각 적고, 두 작업이 요구하는 용량을 확인해요. 큰 모델을 한 달에 한 번만 시험하고 나머지 날은 작은 문서 모델을 쓴다면, 드문 시도를 위해 매일 쓰는 장비를 크게 맞출지 따져볼 수 있어요. ‘언젠가 쓸지도 모름’과 매주 반복해서 막히는 작업은 같은 구매 이유가 아니에요.
반대로 문서가 늘 때마다 같은 한계에 부딪히고 입력을 줄이면 필요한 근거가 사라진다면 더 큰 메모리가 작업을 끝내기 위한 조건일 수 있어요. 자료 종류와 줄여야 했던 내용을 기록해 두면 다음 용량을 정할 때 반복 문제를 해결하면서도 필요 이상으로 큰 옵션을 고르지 않을 수 있어요.
두 후보를 같은 작업으로 마지막 확인해요
후보를 두 개로 좁히면 처음 시험한 PDF와 코드 질문, 모델 파일, 양자화, 입력 길이를 같은 조건으로 맞춰요. 메모리 용량만 큰 장비가 두 작업을 빨리 끝낸다고 가정하지 말고 첫 답 대기와 답변 생성 속도, 작업 결과를 함께 봐요. RAM·VRAM 또는 통합 메모리, SSD가 견적서에서 비교한 제품과 같은지도 구매 전에 확인해요.
현재 컴퓨터에서 두 작업이 정확히 끝난다면 그대로 써도 돼요. PDF를 넣을 때만 메모리가 부족하면 모델과 문맥이 들어가는 구성을 찾고, 답은 맞지만 대기가 길다면 같은 모델에서 실제로 빨라지는 구성을 비교해요. 어느 단계도 막히지 않는다면 남은 예산을 쓰지 않아도 돼요.
용어 각주
대규모 언어 모델 — 대규모 텍스트 데이터에서 언어 패턴을 학습해 문맥에 맞는 텍스트를 처리하고 생성하는 모델입니다.
본문으로 돌아가기GPU — 많은 계산을 병렬로 처리하는 프로세서입니다. AI 모델 실행에서는 모델 계산을 맡습니다.
본문으로 돌아가기양자화 — 모델의 가중치나 계산값을 더 적은 비트로 표현해 저장 공간과 메모리 사용량을 줄이는 방법입니다. 표현 단계가 거칠어져 정확도에도 영향을 줄 수 있습니다.
본문으로 돌아가기런타임 — 프로그램이 실행될 때 필요한 기능을 제공하는 소프트웨어 환경입니다. 로컬 AI에서는 모델을 실행하는 엔진을 가리키기도 합니다.
본문으로 돌아가기KV 캐시 — 어텐션에서 이전 토큰의 키·값을 저장해 다음 토큰 생성 때 재사용하는 메모리입니다. 문맥 길이와 배치 크기에 따라 용량이 달라집니다.
본문으로 돌아가기통합 메모리 — CPU와 GPU가 같은 물리 메모리 풀을 공유하는 구조입니다.
본문으로 돌아가기VRAM — 그래픽카드의 GPU가 사용하는 메모리입니다. 모델 가중치와 계산 중간값을 저장합니다.
본문으로 돌아가기시스템 RAM — 프로그램이 실행되는 동안 데이터를 임시로 보관하는 시스템 메모리입니다.
본문으로 돌아가기프리필 — LLM이 입력 프롬프트를 읽고 각 토큰의 내부 표현을 계산하는 단계입니다. 입력이 길수록 처리할 토큰이 많아집니다.
본문으로 돌아가기토큰 디코드 — 입력과 앞서 만든 답변을 바탕으로 다음 출력 토큰을 차례로 생성하는 단계입니다.
본문으로 돌아가기SSD — 플래시 메모리를 사용하는 데이터 저장 장치입니다. 전원이 꺼져도 데이터가 보존됩니다.
본문으로 돌아가기CUDA — NVIDIA GPU에서 범용 계산을 실행하기 위한 소프트웨어 플랫폼입니다.
본문으로 돌아가기
자주 묻는 질문
- 이 글에서 가장 먼저 확인할 것은 무엇인가요?
- 로컬 LLM은 내 컴퓨터에서 질문·문서·코드를 처리해 답변을 만드는 모델이에요. 장비를 고를 때는 모델이 들어갈 메모리와 답을 받기까지의 시간이 중요해요. 먼저 평소 사용하는 PDF와 코드 질문을 현재 컴퓨터에서 실행하고, 부족한 지점을 찾아 두 후보를 비교해요.
- 필요한 메모리는 어느 정도인가요?
- 가중치 파일이 메모리에 올라가도 실행 프로그램의 작업 공간과 입력·답변을 위한 KV 캐시가 남아야 해요. 긴 문서는 짧은 인사말보다 더 많은 문맥을 유지하고, 답변 생성에도 공간이 필요해요. 그래서 짧은 질문 하나가 성공했다고 20쪽 PDF도 같은 상태로 처리할 수 있다고 판단하지 않아요. 모델 적재, 문서 입력, 답변 완료까지 실제 흐름으로 확인해요.