
新規モデル · 2026.09.04
最終更新
GLM-5.3・DeepSeek-V4は個人のPCでも使えるか
大規模オープンウェイトモデルでチーム専用サーバーを作るには
GLM-5.3-FlashとDeepSeek-V4-Flashは重みをダウンロードし、自社サーバーで質問やコードに対するテキスト回答を生成できる大規模オープンウェイトモデルです。チームで運用するには全重みを保持するメモリ、並列実行に対応した装置と実行環境、リクエストを受けるサーバー設定を準備します。
コードを外部サービスへ送らないチームサーバーが必要なら、重みが公開されていることと手元の機器で実用的に動かせることを分けて考えます。モデルファイル、分散実行に必要なacceleratorとruntime1、複数ユーザーのリクエストを運用できるかを順に確認してください。
自社サーバーではチームがデータと接続権限を管理する
組織が管理するサーバーでモデルを動かし、外部の推論サービスと接続しなければ、コードや文書を内部で処理する構成を作れます。ここでのローカルには個人PCだけでなくチーム管理のサーバーも含みます。全重みを読み込み計算できるようにメモリと実行環境を合わせます。
サーバーを自分たちで管理する場合、アクセス範囲、ログ、権限設定もチームの責任です。各モデルのlicenseが予定する使い方を許可するか確認し、更新、ファイル保管、障害対応の担当を決めてください。個人が時々使う1台と複数人が常時利用するサーバーでは、必要なモデル規模と運用責任が異なります。
active parameterと全重みは別の数値です
GLM-5.3-Flashは全体約320B・active 18B、DeepSeek-V4-Flash-0731は全体約304B・active 13Bと案内されています。MoE2モデルはtoken3ごとに一部の専門家を選ぶためactive数は全体より小さくなります。後続tokenや別のリクエストで他の専門家が選ばれることがあるため、runtimeは全重みにアクセスできる必要があります。
全重みが生の4bit値だと単純に仮定して10進単位で計算すると、GLMの320Bは160GB、DeepSeekの304Bは152GBです。実ファイルや実行メモリの測定値ではありません。block付加情報、混合精度、KV cache4、runtime領域を除いた計算なので、実際の圧縮版容量と使用量はファイルと実行条件で確認してください。
公式checkpointの並列実行要件を確認します
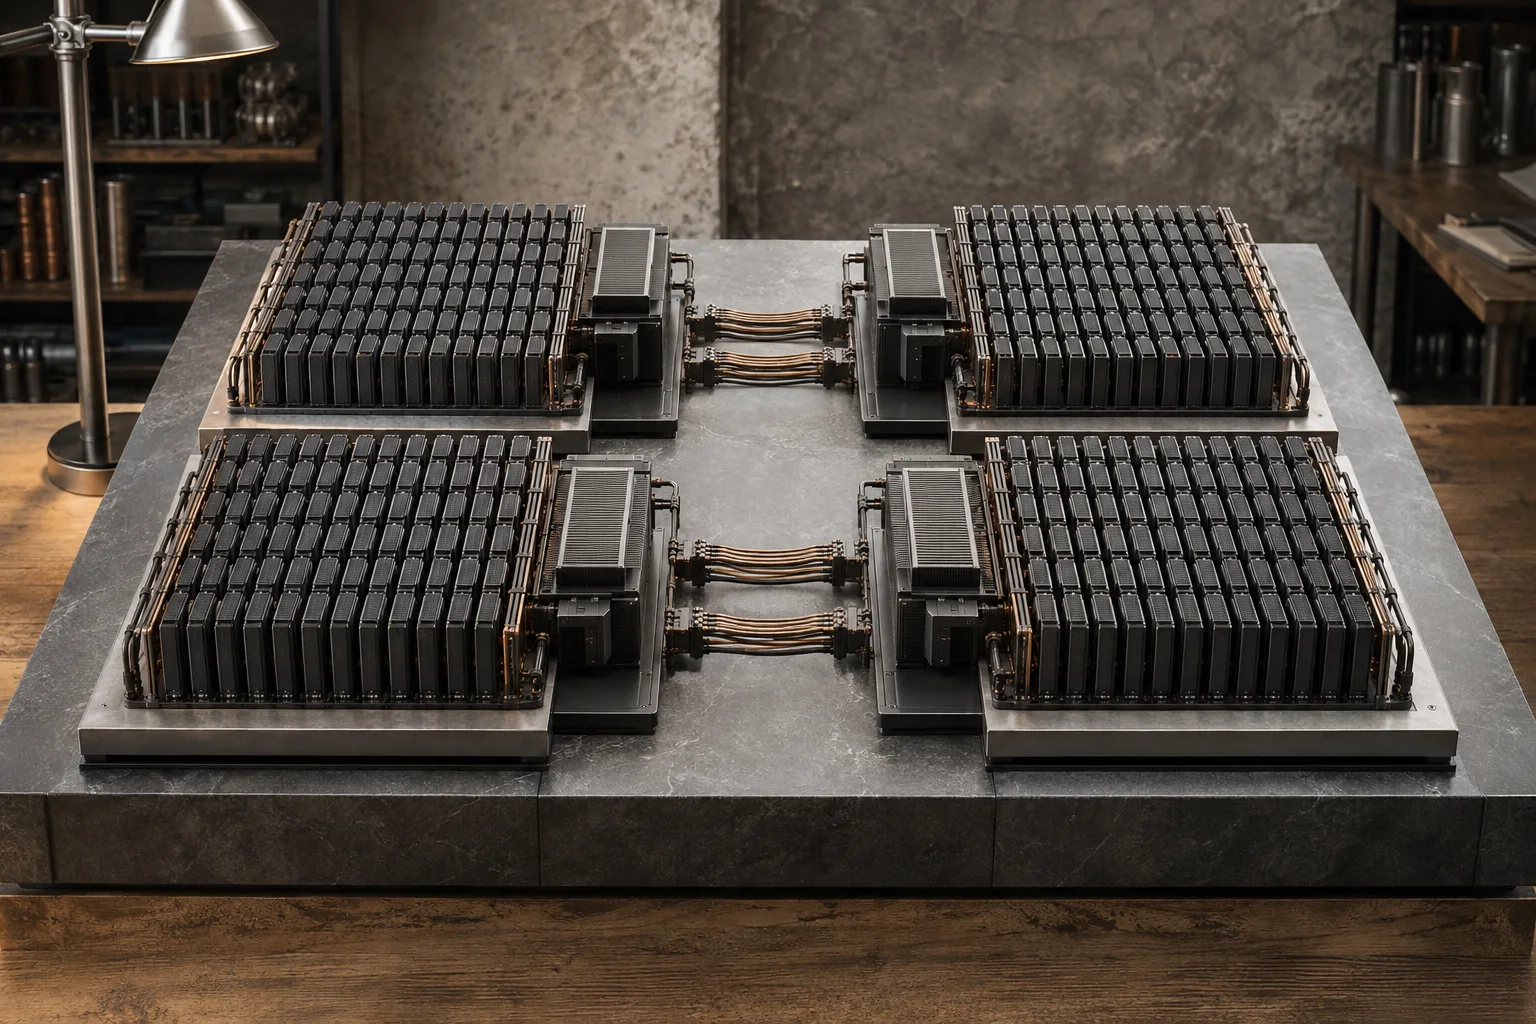
公式checkpoint5は複数のacceleratorに重みを分け、計算中にノード間で結果をやりとりする実行経路を前提とする場合があります。DeepSeek-V4-Flash-0731の公式例は4×GB300ノードを使います。消費者向けGPU1枚への導入手順ではないため、まずmodel cardでサーバー構成と並列実行要件を確認してください。
acceleratorの台数を合わせるだけでは同じ実行になりません。重みの分割方法、各カードのメモリ、ノード間接続、runtimeが対応する並列経路もそろえる必要があります。起動コマンドを使う前に、機器が構成を支え、必要なソフトウェア経路が利用できるか確認してください。
256GB unified memoryでの実験は別の圧縮モデル経路です
256GB unified memory6は互換圧縮変換版を試せる可能性を広げますが、公式checkpointのサーバー経路とは異なります。OS、アプリ、会話中のcacheもunified memoryを使います。ファイルを保存できることだけでは、選んだruntimeがその変換版を実行できるとは判断できません。
まず実験ファイルの形式と容量、同じモデルをそのアプリ・runtime版で動かした記録を確認します。短いリクエストで読み込みと基本応答を試し、次にチームが実際に使うコードや文書の長さへ増やしてください。最大contextが非常に長くても初期値にする必要はありません。入力を段階的に増やすと、読み込み、context、cacheのどこに問題があるか特定しやすくなります。
チームの運用目的に必要な規模を選びます
複数ユーザーの社内リクエストを常時処理し、データ管理や処理量が重要なら、acceleratorサーバーと保守計画を合わせて検討します。障害対応、更新、モデルファイル保管、同時リクエスト管理も導入コストに含まれます。一人が時々文書やコードを尋ねるだけなら、小型モデルでlocal環境の有用性を先に試せます。
同じリポジトリの質問を現在のモデルと候補モデルへ送り、コードレビューでの有用性、1件の完了時間、同時に処理した件数を比べます。データ管理、品質、運用コストは別の基準なので、一つの速度値で代用できません。必要な重みの規模とチームが担える保守に合うサーバーとモデルを選んでください。
用語の注釈
ランタイム — プログラムの実行時に必要な機能を提供するソフトウェア環境です。ローカルAIではモデル実行エンジンを指すこともあります。
本文に戻るMoE — 複数の専門家サブネットワークから入力に応じて一部を選ぶモデル構造です。総パラメータ数と1トークン処理時に有効な数は異なることがあります。
本文に戻るトークン — モデルが入力や出力を分けて処理する単位です。
本文に戻るKVキャッシュ — 過去トークンのAttention用キー・バリューを保存し、後続トークン生成で再利用するメモリです。容量はコンテキスト長やバッチサイズで変わります。
本文に戻るチェックポイント — 学習済みモデルの重みなどを保存したファイルです。同じモデル系列でも、版や用途によって異なるチェックポイントを使うことがあります。
本文に戻るユニファイドメモリ — CPUとGPUが同じ物理メモリ領域を共有する構造です。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- GLM-5.3-FlashとDeepSeek-V4-Flashは重みをダウンロードし、自社サーバーで質問やコードに対するテキスト回答を生成できる大規模オープンウェイトモデルです。チームで運用するには全重みを保持するメモリ、並列実行に対応した装置と実行環境、リクエストを受けるサーバー設定を準備します。
- 必要なメモリはどのくらいですか?
- 全重みが生の4bit値だと単純に仮定して10進単位で計算すると、GLMの320Bは160GB、DeepSeekの304Bは152GBです。実ファイルや実行メモリの測定値ではありません。block付加情報、混合精度、KV cache、runtime領域を除いた計算なので、実際の圧縮版容量と使用量はファイルと実行条件で確認してください。
- 条件と出典はどこで確認できますか?
- 公式checkpointは複数のacceleratorに重みを分け、計算中にノード間で結果をやりとりする実行経路を前提とする場合があります。DeepSeek-V4-Flash-0731の公式例は4×GB300ノードを使います。消費者向けGPU1枚への導入手順ではないため、まずmodel cardでサーバー構成と並列実行要件を確認してください。