
まず読み込み
最終更新
PDF要約用のローカルAI:メモリを買う前に文書を確認する
メモリを増やす前にPDFから抽出された内容を確認します
PDF向けのローカルAIは、文書からテキストを抽出したり検索したりして回答を作ります。要約が間違っていたら、まず抽出した1ページで見出し・文の順序・表の数値が原文どおりか確認します。入力が壊れている場合、大型モデルやメモリを増やしても直せません。文書が正しく読み込まれてから検索方法と機器を比べます。
80ページのサービス契約を確認する場面を想像してください。本文と表があるページを1枚コピーし、見出し・文の順序・金額が元の項目と対応しているか確認します。数字だけを見るのではなく、「年間利用料」の横の値がその項目に結びついているかを確かめます。読み順や表の構造が崩れていれば、モデルも並び替わった内容をもとに回答します。
コピー結果が空だったりページ画像だけだったりする場合は、まずOCR1や画像入力の処理を確認します。たとえば、スキャンしたページの数字8が3と読み取られていないか原本と照合します。機密契約書ではなく、構成の似た公開文書で試すこともできます。1ページの見出し・文・表が正しくコピーできることを合格条件にすれば、後の段階の問題と文書抽出の問題を分けやすくなります。
文書全体の要約と個別の質問を分けます
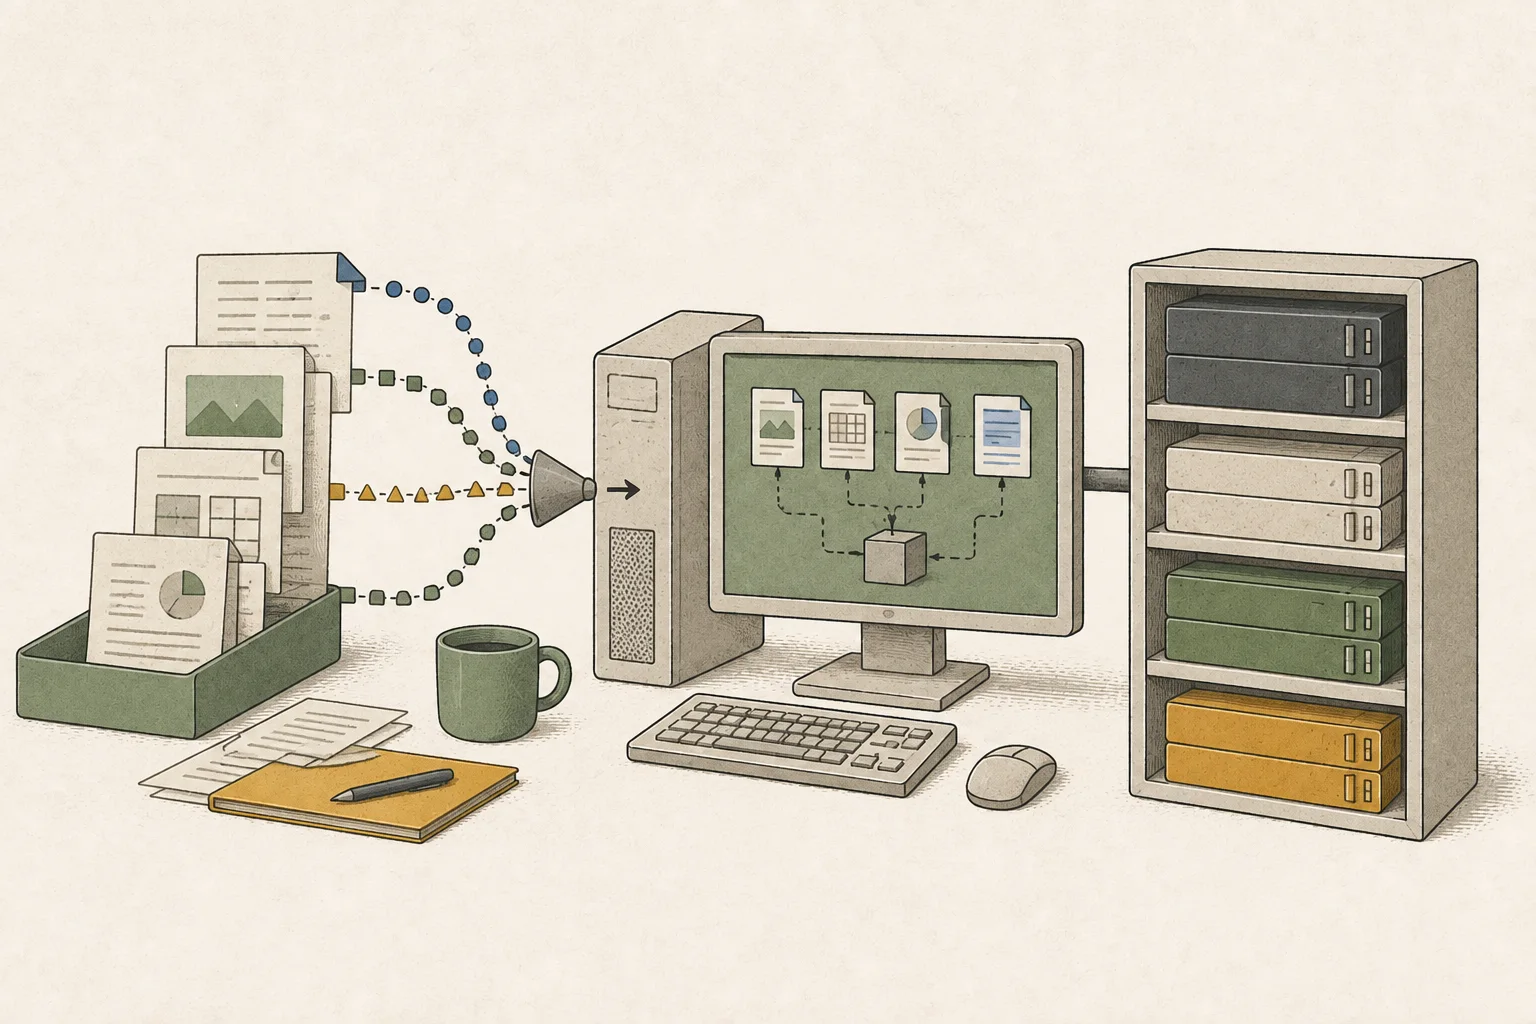
「契約上の義務をすべて要約して」は、文書全体の流れや章の関係を尋ねる依頼です。「自動更新を取り消すにはいつ通知すべきか」は、該当条項と条件を変える例外を探して根拠を確認する依頼です。毎回全ページを入力する代わりに、関連箇所を検索して回答に渡す仕組みがRAG2です。検索が解約条項だけを見つけ、別の章の例外を逃すと、流暢でも結論は誤ります。
検索された条項が質問に答えているかだけでなく、別の箇所にある例外や関連条件も含まれるか確認します。通知期限と通知方法が別の章にあれば、抜粋1つでは回答が不十分な場合があります。一方、文書全体を一度に入力しても完全な要約になるとは限りません。章ごとの要約を統合する際に定義と例外が分離することがあります。概要が必要か、根拠付きの個別回答が必要かを決めてから入力範囲と検索方法を選びます。
待ち時間を段階ごとに分けて原因を探します
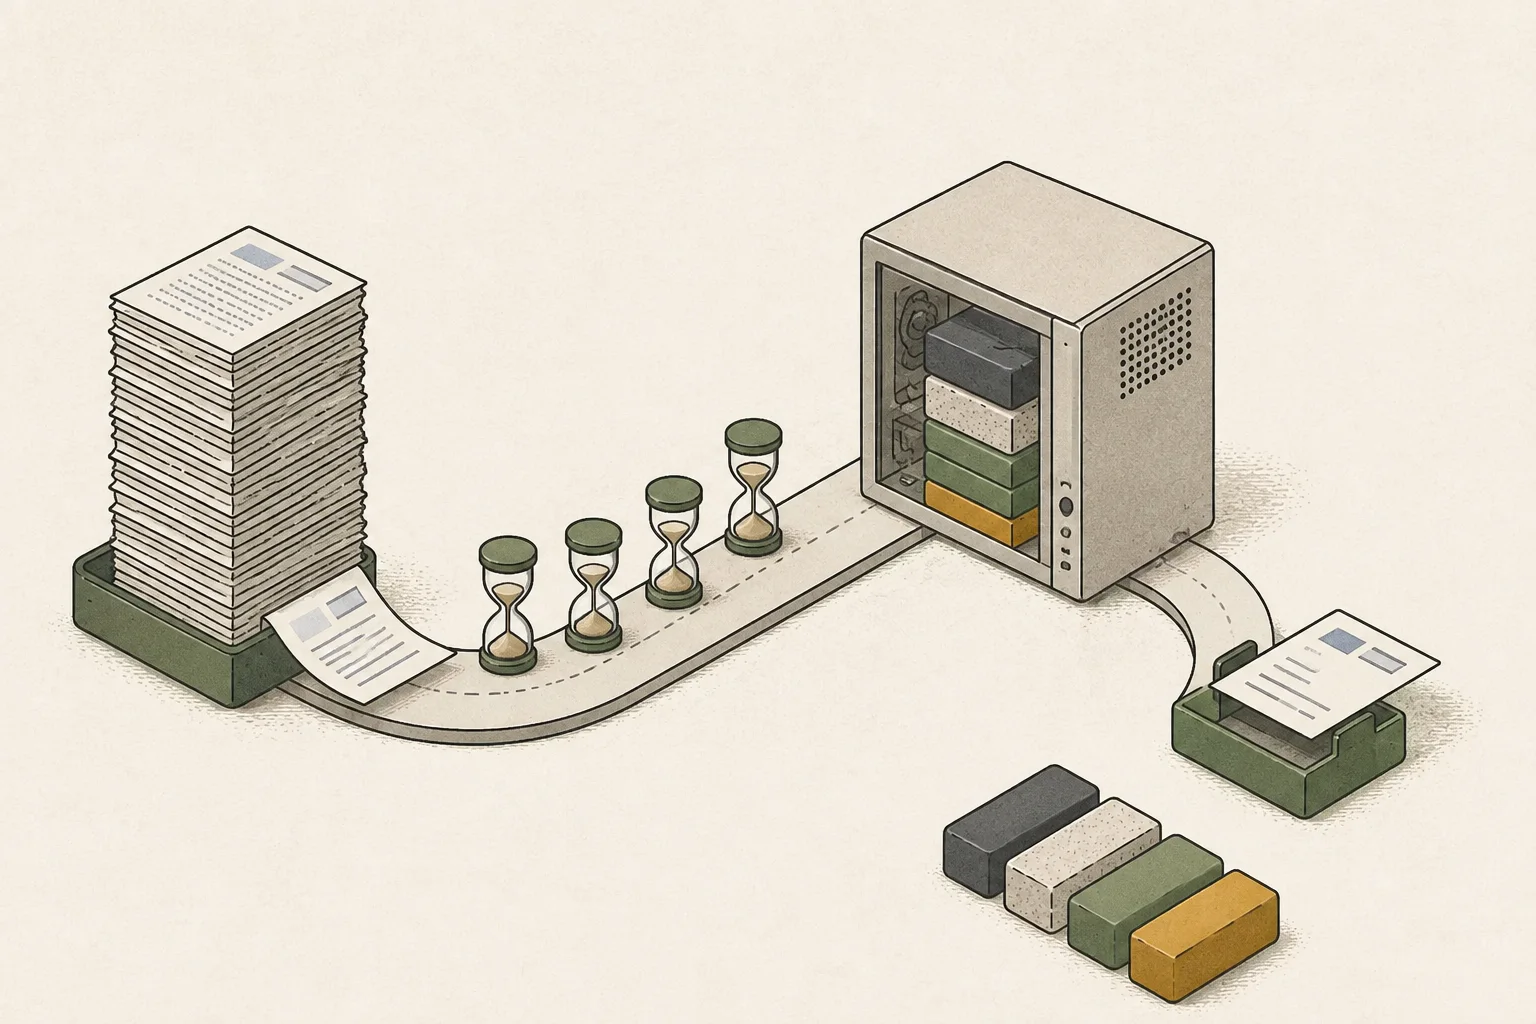
PDFを送ってから最初の文字が出るまでには、ファイル読み込み、テキスト抽出、モデルが入力を処理するprefill3が含まれる場合があります。その後の回答生成がdecode4です。抽出済みテキストの貼り付けは速いのにPDFのアップロードだけ遅いなら、まずファイル処理や抽出経路を調べます。テキストを準備しても入力が長いほど初回回答が遅くなるなら、prefillの影響を確認します。
サイトのprefill比較ツールはモデルの入力処理に関する体感を比較するもので、PDF読み込みやOCRを再現しません。実際のアプリではPDF選択から回答完了までと、抽出テキストを直接入力した場合の時間を分けて記録します。最初の文字までと回答完了までの時間も分けると、ファイル処理・入力処理・生成のどこを見直すべきか分かります。
答えを知っている質問と原文の根拠を記録します
契約書から繰り返し使う質問を3つ選びます。更新通知の日付、料金表の特定の数値と単位、契約に記載されていないサポート時間です。答えは事前に原文から探します。最後の質問では、モデルが時間を作り出さず、文書に記載がないと説明するか確認します。同じ質問と答えを使えば、モデルや検索範囲を変えた結果を比較できます。
回答にページ番号や条項番号があっても、その箇所を開いて確認します。検索型の構成では、その条項が実際にモデル入力へ届いたかも見ます。日付は正しいのに料金が違う場合は、表の抽出と数値と項目の対応を調べます。記載のない質問にモデルが答えを作った場合、モデルサイズを変える前に指示、検索漏れ、根拠の受け渡しを確認します。回答が原文と一致するか、根拠が入力に含まれたか、不明点を認めたかを記録すれば、次に変える設定が明確になります。
文書作業で繰り返すボトルネックを確認してから機器を選びます
まず現在の構成で文書1件を抽出し、必要な質問に答え、根拠を確認するまでの時間を記録します。毎回文書全体を入力する必要があるなら、入力処理と実行時メモリが重要になる場合があります。一部の条項だけを探す作業なら、例外まで検索できるか、文書にない質問を適切に扱えるかが優先です。ファイル保存用のSSD5容量とモデル実行時のメモリは別の要件です。
抽出テキストと質問を同じに保ち、設定を一つだけ変えます。文脈長6か検索範囲のどちらかを調整し、回答と待ち時間の段階を比較します。短い依頼で正常動作を確認してから、代表ページ、関連条項、契約全体へと入力範囲を広げると、どこでメモリや時間が負担になるか分かります。スキャンした数値が誤って抽出されているなら、モデルを大きくしても原因は残ります。原文と検索根拠が正確なのに入力やメモリで繰り返し詰まる場合に、機器の増強を検討できます。
プライバシーのためにローカル実行を選ぶなら、OCR・embedding・検索・ファイルアップロードもどの環境で処理されるか確認します。文書1件を最初から最後まで実行し、アプリの準備、PDF入力、追加質問の各段階でメモリとエラーを記録します。契約全体を毎日扱い、入力処理やメモリが常にボトルネックなら増強を検討できます。必要な条項だけを時々確認するなら、現在の検索手順で十分かもしれません。判断基準は最大文脈長ではなく、繰り返す文書作業です。
用語の注釈
OCR — 画像やスキャン文書の文字を認識してテキストにする処理です。表の配置や読み順は、元の画像を合わせて確認する必要があります。
本文に戻る検索拡張生成 — 質問に関連する資料を検索してモデル入力に加え、その文脈をもとに回答を生成する方式です。
本文に戻るプリフィル — LLMが入力プロンプトを読み、各トークンの内部表現を計算する段階です。プロンプトが長いほど処理するトークンが増えます。
本文に戻るトークンのデコード — 入力とそれまでの回答をもとに、次の出力トークンを順に生成する段階です。
本文に戻るSSD — フラッシュメモリを使うデータ保存装置です。電源を切ってもデータが保持されます。
本文に戻るコンテキスト長 — 1回のリクエストでモデルが扱える入力と生成内容のトークン範囲です。上限や実際のメモリ使用量はモデルと実行設定によります。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- PDF向けのローカルAIは、文書からテキストを抽出したり検索したりして回答を作ります。要約が間違っていたら、まず抽出した1ページで見出し・文の順序・表の数値が原文どおりか確認します。入力が壊れている場合、大型モデルやメモリを増やしても直せません。文書が正しく読み込まれてから検索方法と機器を比べます。
- 必要なメモリはどのくらいですか?
- まず現在の構成で文書1件を抽出し、必要な質問に答え、根拠を確認するまでの時間を記録します。毎回文書全体を入力する必要があるなら、入力処理と実行時メモリが重要になる場合があります。一部の条項だけを探す作業なら、例外まで検索できるか、文書にない質問を適切に扱えるかが優先です。ファイル保存用のSSD容量とモデル実行時のメモリは別の要件です。