실행 프로그램과 확장
OpenClaw에 Ollama 또는 관리형 llama.cpp 로컬 모델 연결하기
모델을 골랐다는 표시보다, 도구 호출을 끝까지 통과하는지 확인하세요.
Gateway1와 모델 서버를 따로 준비하고, 이미 Ollama를 쓴다면 기존 모델을 연결하세요. 엔진 선택을 OpenClaw에 맡기려면 관리형 llama.cpp 경로가 대안입니다. 어느 경로든 기본 모델로 지정하기 전에 짧은 채팅, Gateway 경유 응답, 읽기 전용 도구 호출2을 차례로 통과시키세요.
먼저 Gateway와 모델 서버를 따로 준비합니다
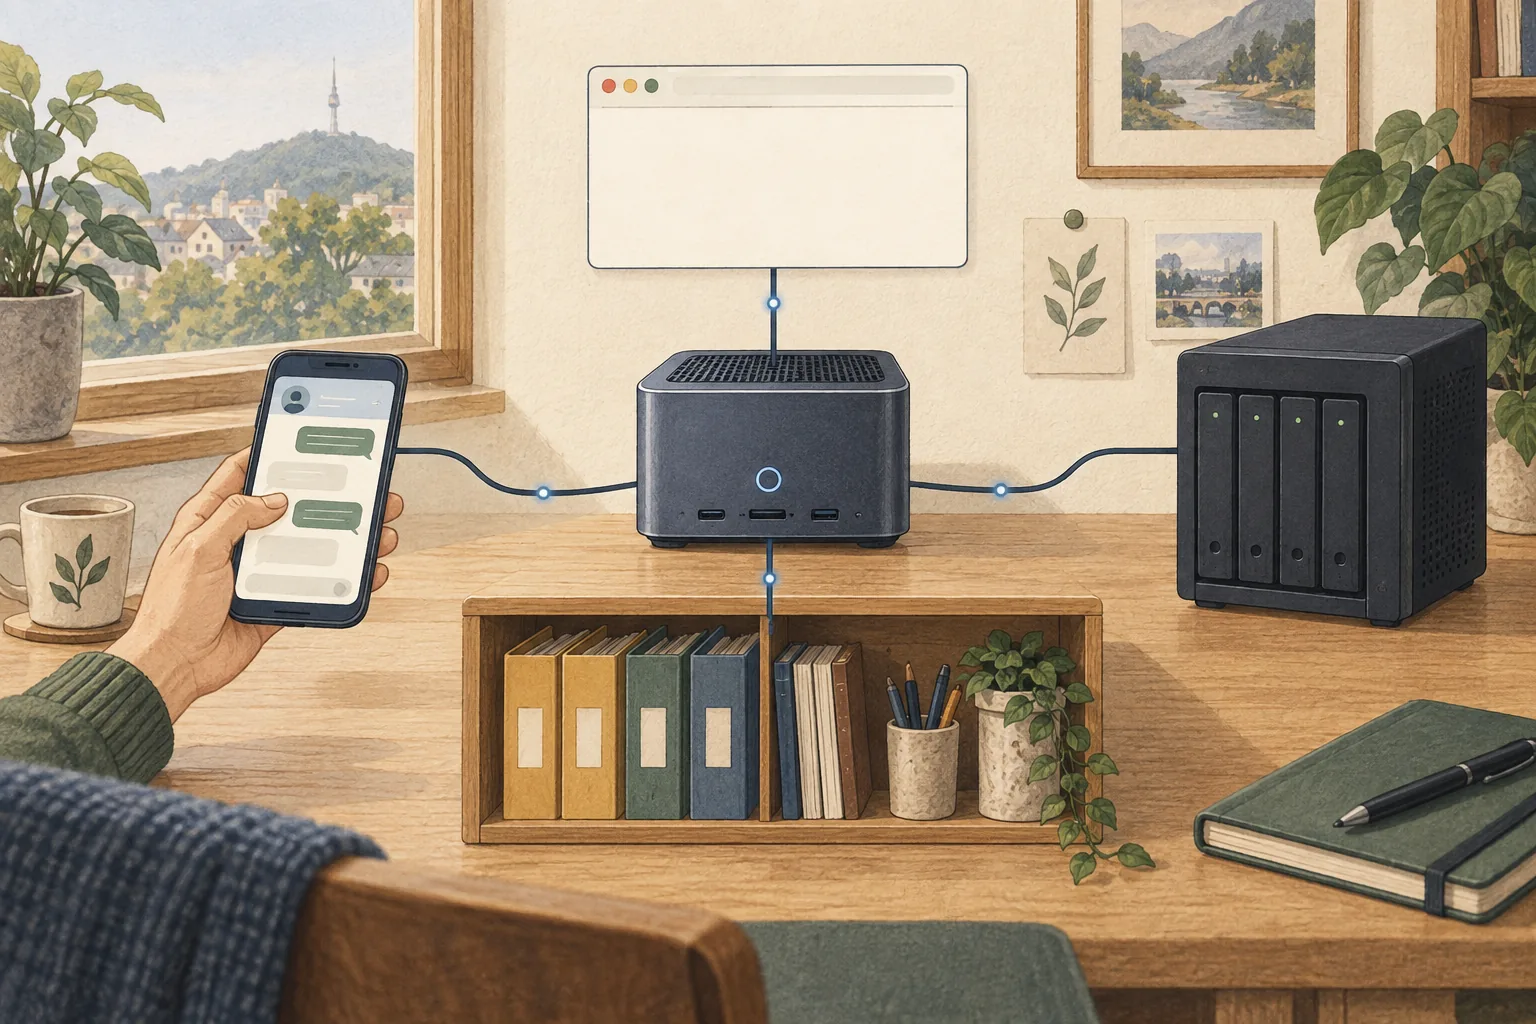
OpenClaw는 채널과 에이전트 작업을 조정하는 Gateway입니다. Ollama나 llama.cpp는 모델을 실제로 불러 추론하는 서버 역할을 합니다. 둘을 한 컴퓨터에 함께 설치할 수 있지만, 모델 연결에 실패했을 때 어느 쪽을 확인해야 하는지 알려면 두 역할을 구분해 두어야 합니다.
OpenClaw를 설치한 뒤 로컬 모델을 붙이려면 Gateway와 모델 서버를 각각 준비합니다. 아래 명령은 macOS·Linux·WSL2용이며, Windows에서는 공식 Windows Hub 또는 PowerShell 설치 안내를 사용하세요. 모델 서버 연결은 OpenClaw 설치와 별도 단계입니다.
지원 Node 버전과 설치 경로를 확인합니다
공식 설치 문서는 Node.js 24.16 이상 또는 26.1 이상을 지원하고 Node 26을 권장합니다. 기존 Node가 있어도 요구 버전과 SQLite 런타임3 조건을 만족하는지 살펴봅니다. 설치를 시작하기 전에 현재 지원 버전은 OpenClaw 공식 설치 안내에서 확인하세요.
macOS·Linux·WSL2의 공식 기본 설치기 예시는 curl -fsSL https://openclaw.ai/install.sh | bash입니다. Windows PowerShell에는 별도 설치기가 있습니다. 이 명령은 네트워크에서 받아 온 스크립트를 셸에서 실행하므로, 그대로 붙여 넣기 전에 주소가 공식 문서의 도메인인지 보고 installer 세부 안내도 읽으세요. 회사 장비나 민감한 환경에서는 스크립트 내용을 검토하거나 지원되는 다른 설치 경로를 고를 수 있습니다.
Ollama는 이미 설치한 모델 서버를 연결합니다
Ollama 경로는 서버와 모델을 따로 관리하고 싶을 때 적합합니다. Ollama를 공식 다운로드 경로에서 설치하고 실행한 다음 모델을 받습니다. OpenClaw의 Ollama 안내에는 ollama pull gemma4 예제가 있지만, 특정 모델을 계속 추천한다는 뜻은 아닙니다. 내려받을 모델의 정확한 이름과 태그, 도구 호출 지원 여부를 Ollama 공식 카탈로그에서 확인하세요.
OpenClaw 설정 과정에서 ollama 인증 선택을 고르고, 로컬 또는 LAN 주소와 모델 ID를 제공합니다. 로컬 endpoint는 실제 비밀키가 필요하지 않아 ollama-local 표시를 사용할 수 있지만, 공용 원격 호스트나 Ollama Cloud에는 유효한 인증 정보가 필요합니다. 집 밖에서 접근하려고 모델 서버를 인터넷 전체에 공개하지 말고, OpenClaw 문서의 네트워크·인증 안내를 따르세요.
openclaw models list --provider ollama관리형 llama.cpp는 모델 선택과 서버 준비를 안내합니다
어떤 로컬 모델을 골라야 할지 모르거나, 각 모델별 실행 옵션을 직접 맞추고 싶지 않다면 OpenClaw의 관리형 llama.cpp 경로를 살펴볼 수 있습니다. 공식 로컬 모델 문서는 llama.cpp 플러그인을 설치하고 openclaw onboard를 실행한 다음 Managed local server를 선택하라고 안내합니다. 설정 화면은 Gateway 호스트, 모델, 다운로드 크기, 실행 backend를 보여 준 뒤 다운로드를 진행하고, 기본 모델을 바꾸기 전 실제 tool call을 검증합니다.
이 경로가 모든 컴퓨터에서 같은 모델과 속도를 보장한다는 뜻은 아닙니다. 공식 문서는 모델 가중치, context 크기, runtime, 호스트의 다른 작업에 따라 메모리 요구가 달라진다고 설명합니다. 관리형 카탈로그의 64K context recipe 중 가장 낮은 호스트 메모리 바닥값 8 GiB도 특정 recipe의 조건이지 OpenClaw 전체 최소 사양이나 실행·성능 보장이 아닙니다. 다운로드 화면의 현재 하드웨어 검사를 읽고, 다른 앱이 사용하는 메모리까지 고려합니다.
짧은 채팅, Gateway, 도구 호출을 순서대로 확인합니다
모델이 목록에 보여도 확인할 단계가 남아 있습니다. 아래 두 명령으로 모델의 직접 응답과 Gateway 경유 응답을 따로 확인한 뒤, 테스트 폴더를 읽는 실제 도구 호출을 실행하세요. 세 단계가 각각 모델, 연결 경로, 도구 실행 여부를 알려 줍니다.
먼저 모델에 짧은 입력을 직접 보내고, 다음에는 같은 입력을 Gateway를 거쳐 보냅니다. <provider/model>은 openclaw models list에 표시된 로컬 모델 ID로 바꾸세요. 두 명령 모두 JSON 출력에서 pong 응답을 확인합니다. 이것은 추론과 Gateway 연결 확인이며, 에이전트 도구 실행까지 증명하지는 않습니다. 마지막으로 읽기 전용 테스트 폴더의 파일을 읽게 하고 실행 기록에 실제 도구와 결과가 남는지 확인합니다.
openclaw infer model run --local --model <provider/model> --prompt "Reply with exactly: pong" --jsonopenclaw infer model run --gateway --model <provider/model> --prompt "Reply with exactly: pong" --json작업이 멈추면 실패한 단계를 분리합니다
모델이 로드되지 않으면 모델 ID, 서버 상태, 메모리 여유, 다운로드 완료 여부를 확인합니다. 일반 채팅은 되는데 도구 호출이 안 되면 모델의 tool-calling 형식, chat template, OpenAI 호환 endpoint, OpenClaw가 보낸 전체 prompt 크기를 봅니다. 짧은 프롬프트가 통과해도 대화 이력과 도구 설명이 더해진 agent 요청은 메모리를 더 쓰거나 모델 context 한도를 넘을 수 있습니다.
모델을 확인하기 전에는 기본값으로 바꾸지 마세요. 로컬 모델은 호스팅 제공자의 안전 필터를 포함하지 않을 수 있습니다. 외부 문서를 처리할 때는 읽기 권한부터 시작하고, 로컬 추론을 쓰더라도 메신저나 검색 요청은 외부 서비스로 전송될 수 있음을 기억하세요.
두 경로 중 하나를 고르고 작은 작업부터 맡깁니다
이미 실행 중인 Ollama 모델의 태그와 서버를 직접 관리하고 싶다면 Ollama를 선택하세요. 모델 설치와 하드웨어별 선택을 OpenClaw가 안내하길 원한다면 openclaw onboard에서 llama.cpp 플러그인과 Managed local server 경로를 검토합니다.
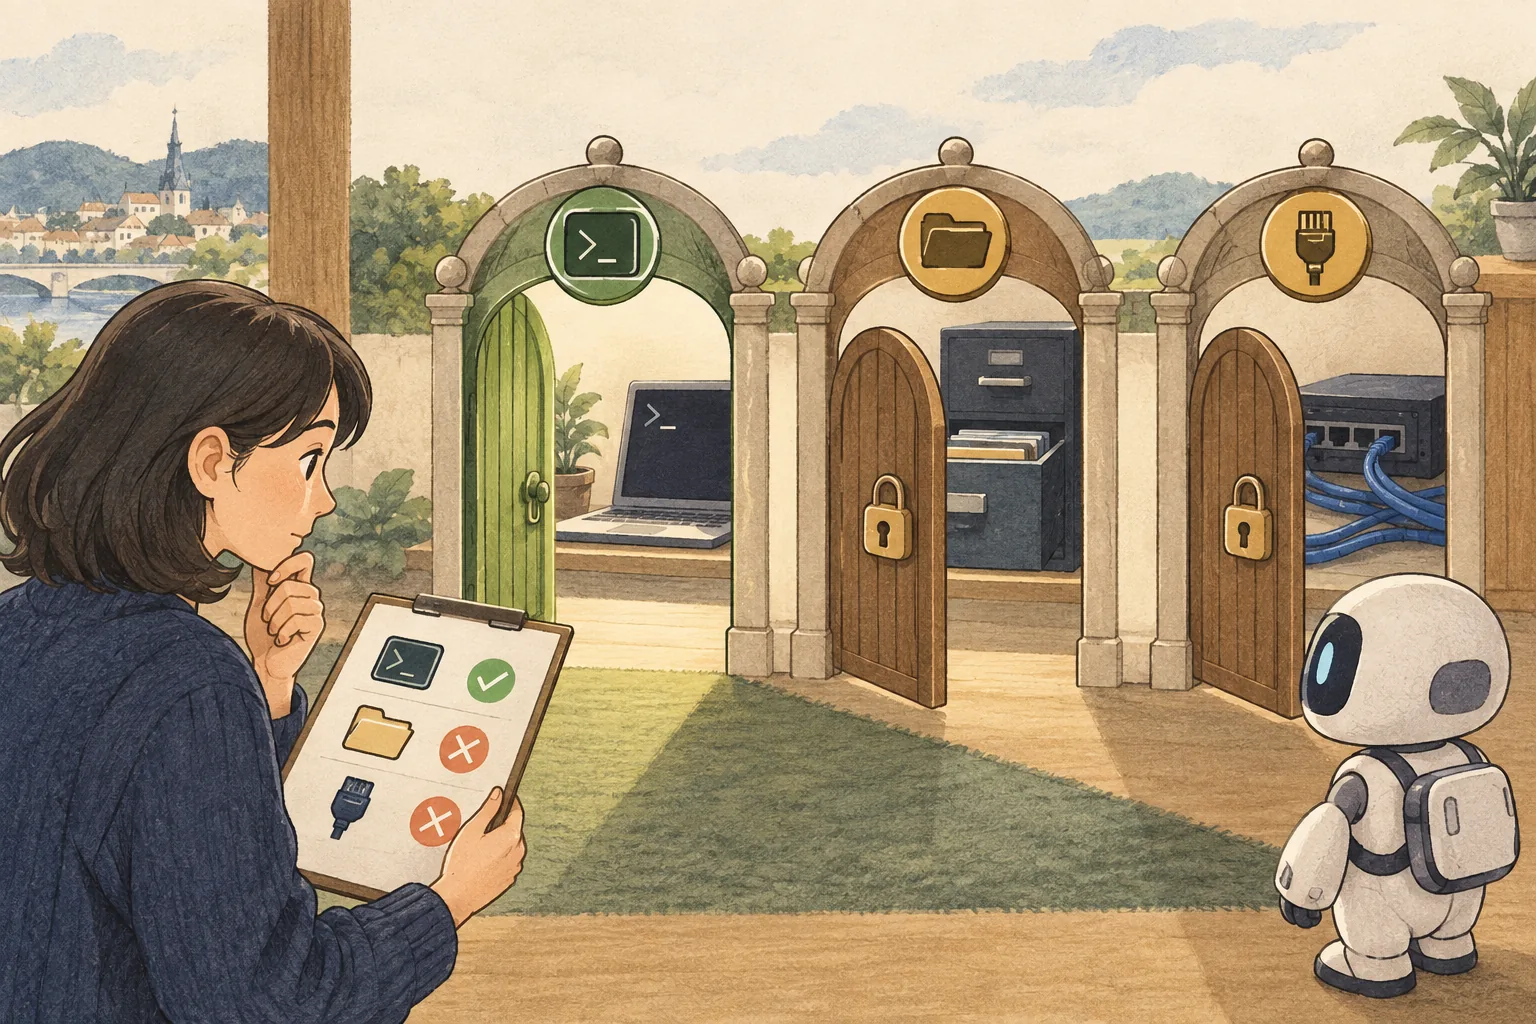
어느 경로를 고르든 테스트 폴더의 메모 하나를 읽고 요약 초안을 만드는 작업부터 시작하세요. 실행 기록에서 호출한 도구와 인수를 살펴보고 답변을 원문과 대조합니다. 파일을 읽은 기록이 없다면 모델이 내용을 추측했을 수 있습니다.
기록이 기대와 다르면 재설치보다 실패한 단계를 먼저 찾으세요. 모델, 서버, 전체 프롬프트, 도구 형식 중 어디에서 문제가 났는지 확인한 뒤 기본 모델로 지정합니다. 메신저·자동화·파일 쓰기 권한은 이 읽기 작업이 통과한 뒤 필요한 것만 추가하세요.
용어 각주
게이트웨이 — 여러 클라이언트·채널·모델·도구 사이의 요청을 받고 적절한 경로로 연결하는 관문 역할의 프로그램입니다. 항상 모델을 직접 실행하는 서버를 뜻하지는 않습니다.
본문으로 돌아가기도구 호출 — 모델이 파일 읽기·검색·명령 실행 같은 외부 기능의 이름과 인자를 요청하는 형식입니다. 요청을 실제로 실행할지는 에이전트 런타임과 권한 설정이 결정합니다.
본문으로 돌아가기런타임 — 프로그램이 실행될 때 필요한 기능을 제공하는 소프트웨어 환경입니다. 로컬 AI에서는 모델을 실행하는 엔진을 가리키기도 하며, GPU 런타임 라이브러리와 완성된 서빙 앱은 서로 다른 구성요소입니다.
본문으로 돌아가기