
실행 프로그램과 확장
최종 업데이트
Slotstream: 125B 모델을 16GB 맥에서 돌리는 방법
모델 전체가 메모리에 들어가지 않아도 실행은 됩니다
Slotstream은 105GB짜리 125B 모델을 16GB에서 64GB 맥까지 실행하는 맥 전용 프로그램이에요. 공유 가중치는 메모리에 두고, 토큰1마다 쓰이는 전문가만 SSD2에서 읽어 와요. 48GB M5 Pro에서 초당 20.91~23.69토큰을 기록했고, 16GB 맥에서는 1~6토큰으로 떨어져요.
모델 전체를 메모리에 올리지 않는 실행 방식이에요
Slotstream은 애플 실리콘 맥에서 1,250억 파라미터 모델을 돌리는 실행 프로그램3이에요. 모델 파일은 약 105GB인데, 16GB 맥에서도 실행되는 것이 이 도구의 목적이에요. 모델 전체를 메모리에 올리지 않고, 지금 계산에 필요한 부분만 SSD에서 읽어 와요.
모델 파일 105GB를 16GB 메모리에 맞추는 방법은 하나예요. 계산에 쓰이지 않는 부분을 디스크에 두고, 쓰이는 순간에만 읽는 거예요. 디스크 읽기 속도가 생성 속도를 크게 좌우해요.
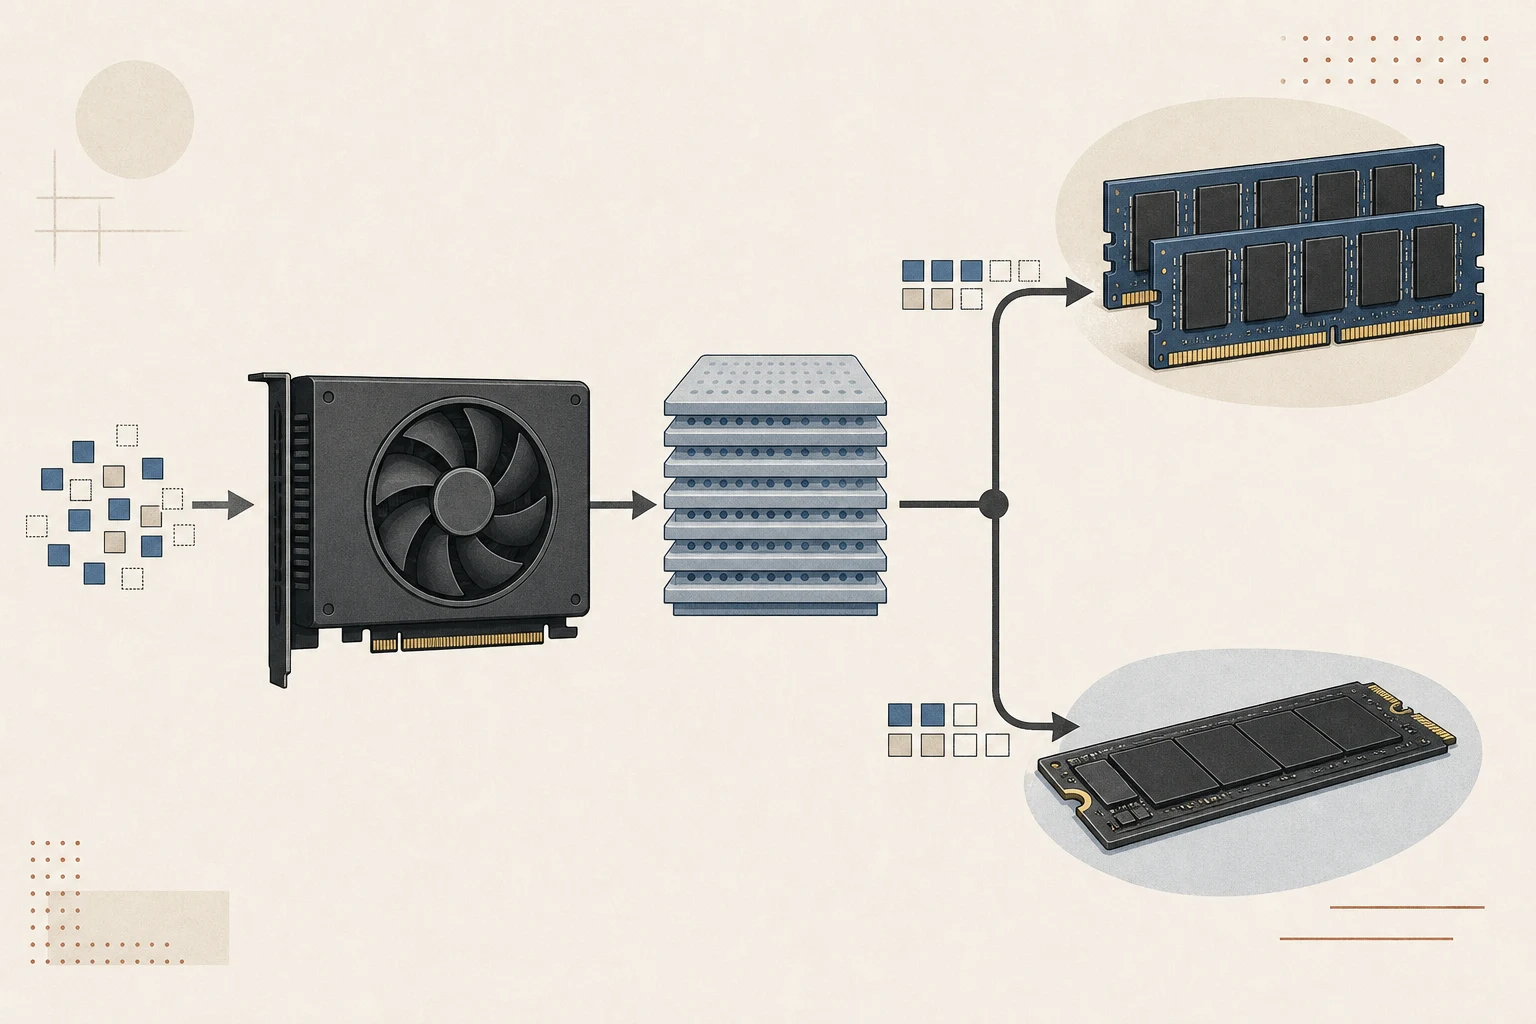
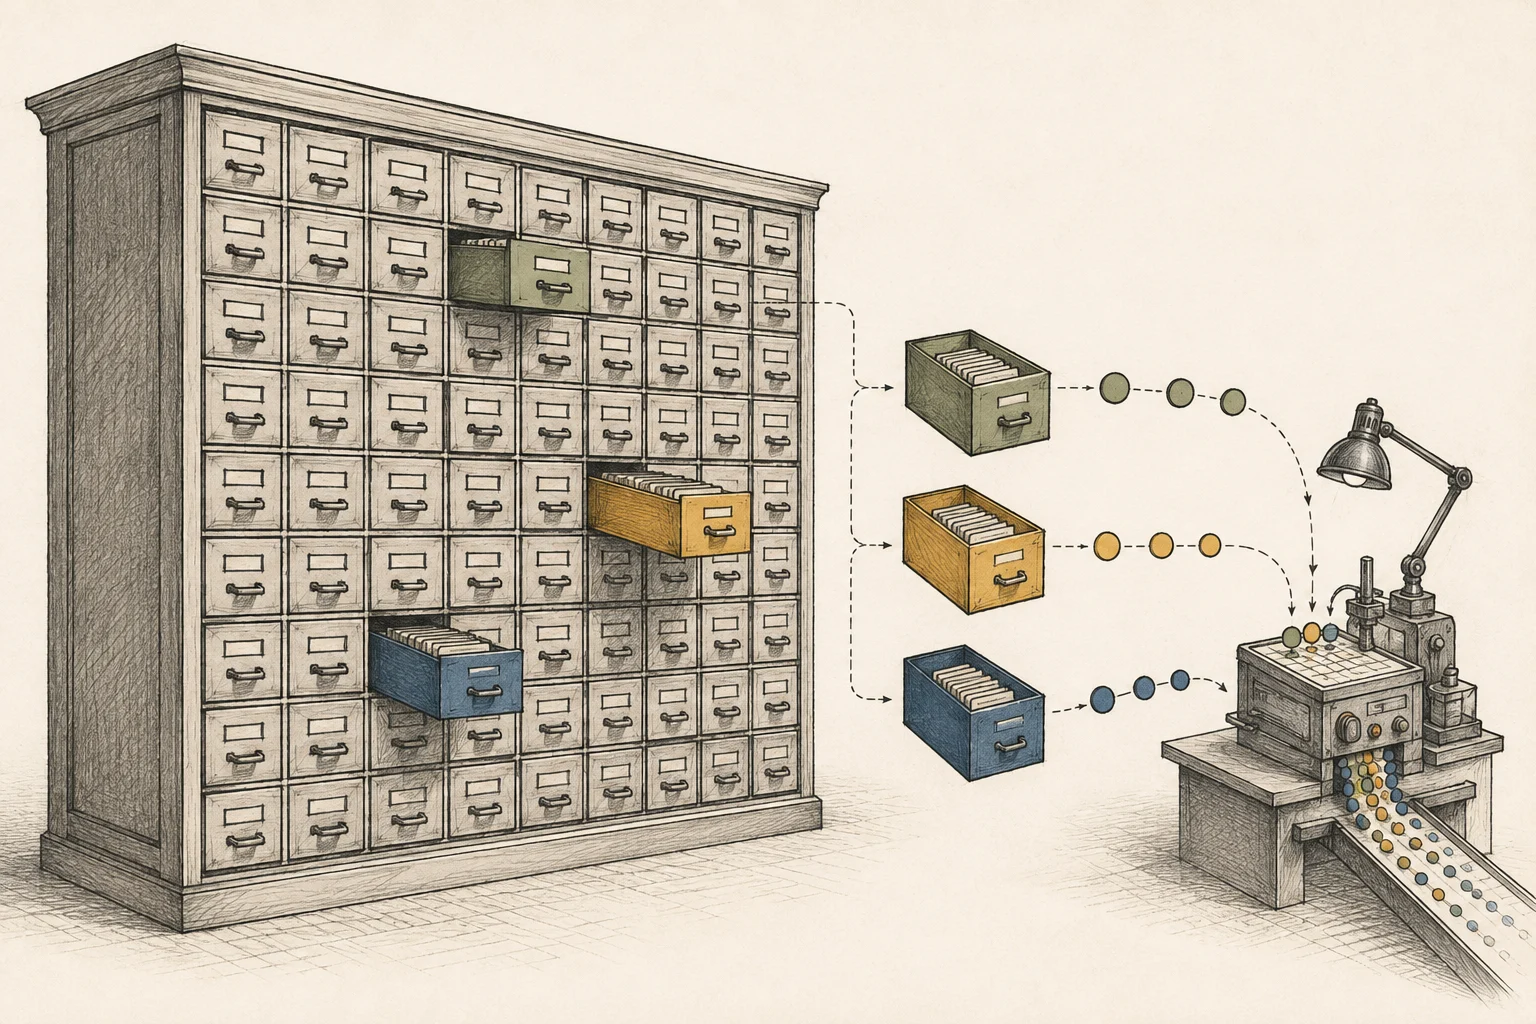
Qwen3.8-Flash-Next는 전문가 네트워크를 여러 개 두고 토큰마다 일부만 쓰는 MoE4 모델이에요. 공유 가중치는 메모리에 두고, 선택된 전문가만 SSD에서 캐시로 불러와요. 자주 쓰는 전문가는 메모리에 남겨 다음 읽기를 줄여요.
그래서 메모리가 작은 맥에서는 디스크 읽기가 속도를 정하고, 메모리가 큰 맥에서는 전문가를 더 많이 들고 있어 속도가 올라가요. 어느 쪽이든 계산 결과는 같아요.
설치 전에 맥과 디스크를 확인해요
설치하고 첫 답을 받아요
터미널에서 설치 스크립트를 실행해요. 같은 명령을 다시 실행하면 업데이트가 돼요.
curl -LsSf https://raw.githubusercontent.com/carloslfu/slotstream/main/install.sh | sh설치 뒤에는 doctor로 맥 상태를 확인하고 run으로 첫 답을 받아요. 처음 실행할 때 모델을 내려받고, 중단해도 이어받기가 돼요.
slotstream doctor
slotstream run --prompt "하늘이 파란 이유가 뭐야?"
내려받는 파일은 100GB를 넘기 때문에 회선에 따라 몇 시간이 걸릴 수 있어요. 한 번 받아 두면 이후에는 오프라인에서도 실행돼요.
메모리 구간마다 기대 속도가 달라져요
설치된 메모리에 따라 기대 속도와 자동 문맥 길이가 달라져요. 아래 값은 개발팀이 공개한 추정치이고, 실제 속도는 다른 앱의 메모리 사용에 따라 낮아져요.
| 설치 메모리 | 예상 속도 | 자동 문맥 길이 |
|---|---|---|
| 16GB 이상 24GB 미만 | 초당 1~6토큰 | 32,768토큰 |
| 24GB 이상 48GB 미만 | 초당 5~16토큰 | 32GB까지 32,768토큰 |
| 48GB 이상 96GB 미만 | 초당 15~27토큰 | 64GB에서 131,072토큰 |
| 96GB 이상 | 초당 20~32토큰 | 262,144토큰 |
96GB 이상은 모델이 메모리에 다 들어가는 구간이라, 전체를 올리는 엔진이 더 빠르다고 개발팀이 밝혀요.
공개된 측정값의 조건을 읽어요
개발팀이 공개한 측정은 2026년 10월 5일, 48GB M5 Pro에서 33GB 메모리 예산으로 진행했어요. 원본 4비트 모델을 썼고, 세 가지 작업을 각각 세 번씩 돌렸어요.
| 작업 | 중앙값 |
|---|---|
| 짧은 프롬프트 | 초당 20.91토큰 |
| 긴 문맥 | 초당 23.69토큰 |
| 코드 답변 완성 | 초당 21.59토큰 |
이 값은 답을 만드는 구간만 잰 것이에요. 모델을 올리는 시간과 프롬프트7를 읽는 시간은 따로 들어가서, 대화를 처음 시작할 때는 표보다 느리게 느껴져요.
이전 릴리스와 비교하면 예산 차이가 보여요
이전 0.2.19 릴리스는 22GB 예산에서 초당 15.86토큰을 기록했어요. 예산이 커지면 전문가를 더 많이 메모리에 두게 되어 디스크 읽기가 줄어요.
개발팀은 이 숫자가 같은 설정에서의 속도 향상을 뜻하지는 않는다고 밝혀요. 예산과 작업 묶음, 측정 방식이 서로 달라서 릴리스 간 비교로 읽으면 안 돼요.
읽을 전문가를 미리 정하는 방식이에요
다음 층에서 어떤 전문가가 필요할지 미리 예측해, 필요해지기 전에 SSD에서 읽어 와요. 이 예측은 속도만 바꾸고 출력은 바꾸지 않아요.
전문가 캐시는 다른 앱이 메모리를 요구하면 줄어들어요. 캐시가 줄면 속도는 떨어지지만, 모델에서 전문가가 빠지는 것은 아니에요.
메모리 목표를 지정하지 않으면 33GB를 기준으로 잡고, 맥의 실제 여유에 맞춰 조정해요. 시작할 때 예산과 캐시 크기, 여유분을 나눠서 보여줘요.
메모리 목표를 직접 지정할 때는 값이 최대 예산일 뿐, 그만큼 항상 쓰는 것은 아니에요. 짧은 요청은 목표보다 훨씬 적게 쓰고 끝나요.
코딩 에이전트에 연결해요
Ollama, OpenAI, Anthropic 형식 API8를 함께 열어요. Claude Code, Codex, opencode, Hermes를 연결해 쓸 수 있고, launch 뒤에 도구 이름을 붙여 실행해요.
slotstream launch claude동시에 여러 요청을 처리하지는 않아요. 연결된 앱이 같은 모델 하나를 나눠 쓰기 때문에, 여러 에이전트를 동시에 돌리는 용도라면 다른 도구가 맞아요.
| 무엇을 확인하나 | Slotstream |
|---|---|
| 지원 API 형식 | Ollama·OpenAI·Anthropic |
| 동시 생성 | 한 번에 하나 |
| 다른 모델 | 지원하지 않음 |
이 방식이 맞지 않는 경우도 있어요
이 도구는 16GB부터 64GB까지의 맥을 기준으로 만들어졌어요. 그보다 큰 메모리를 가진 맥에는 이 방식이 필요하지 않아요.
PLE9 오프로드처럼 모델 구조를 활용해 메모리를 나누는 방식과는 다르게, 이 도구는 전문가 단위로 디스크와 메모리를 오가요. 같은 모델을 다뤄도 무엇을 디스크에 두는지가 달라요.
이미지 정확도 벤치마크와 다른 모델과의 비교는 아직 없어요. 생성은 모델 파일을 다시 쓰지 않지만, 자동 설정을 크게 넘기면 스왑이 늘어 SSD 쓰기가 발생해요.
용어 각주
토큰 — 모델이 입력이나 출력을 나누어 처리하는 단위입니다.
본문으로 돌아가기SSD — 플래시 메모리를 사용하는 데이터 저장 장치입니다. 전원이 꺼져도 데이터가 보존됩니다.
본문으로 돌아가기런타임 — 프로그램이 실행될 때 필요한 기능을 제공하는 소프트웨어 환경입니다. 로컬 AI에서는 모델을 실행하는 엔진을 가리키기도 합니다.
본문으로 돌아가기MoE — 여러 전문가 하위망 중 일부를 입력에 따라 선택해 사용하는 모델 구조입니다. 총 파라미터 수와 한 토큰 처리에 활성화되는 파라미터 수는 다를 수 있습니다.
본문으로 돌아가기MLX — Apple이 개발하는 머신러닝 프레임워크로, Apple Silicon의 CPU와 GPU가 공유하는 메모리를 활용해 모델을 실행합니다.
본문으로 돌아가기Metal — Apple 기기에서 그래픽과 GPU 병렬 계산을 실행하는 저수준 기술입니다.
본문으로 돌아가기프롬프트 — 모델에 보내는 입력문입니다. 생성 모델에서는 만들 결과를 설명하는 문장이 되어 출력의 구성과 내용을 크게 좌우합니다.
본문으로 돌아가기API — 프로그램의 기능을 다른 코드에서 호출하기 위한 약속된 인터페이스입니다.
본문으로 돌아가기PLE 임베딩 테이블 — Per-Layer Embedding의 약자로, 모델의 특정 층에 임베딩 정보를 더하는 구조입니다. Qwen Flash-Next 계열은 n-그램 테이블을 사용하며, 지원되는 실행 경로에서는 이 테이블을 RAM이나 SSD로 오프로딩할 수 있습니다.
본문으로 돌아가기
자주 묻는 질문
- 이 글에서 가장 먼저 확인할 것은 무엇인가요?
- Slotstream은 105GB짜리 125B 모델을 16GB에서 64GB 맥까지 실행하는 맥 전용 프로그램이에요. 공유 가중치는 메모리에 두고, 토큰마다 쓰이는 전문가만 SSD에서 읽어 와요. 48GB M5 Pro에서 초당 20.91~23.69토큰을 기록했고, 16GB 맥에서는 1~6토큰으로 떨어져요.
- 필요한 메모리는 어느 정도인가요?
- Slotstream은 애플 실리콘 맥에서 1,250억 파라미터 모델을 돌리는 실행 프로그램이에요. 모델 파일은 약 105GB인데, 16GB 맥에서도 실행되는 것이 이 도구의 목적이에요. 모델 전체를 메모리에 올리지 않고, 지금 계산에 필요한 부분만 SSD에서 읽어 와요.