
実行プログラムと拡張機能
最終更新
Slotstream:125Bモデルを16GBのMacで動かす方法
モデル全体がメモリに収まらなくても実行はできます
Slotstreamは105GBの125Bモデルを16GBから64GBのMacで実行するMac専用プログラムです。共有の重みはメモリに置き、トークン1ごとに使うエキスパートだけをSSD2から読みます。48GBのM5 Proで毎秒20.91〜23.69トークン、16GBのMacでは毎秒1〜6トークンまで下がります。
モデル全体をメモリに載せない実行方式です
SlotstreamはApple SiliconのMacで1,250億パラメータのモデルを動かす実行プログラムです。モデルファイルは約105GBありますが、16GBのMacでも動くことがこのツールの目的です。モデル全体をメモリに載せず、いまの計算に必要な部分だけをSSDから読みます。
105GBのモデルファイルを16GBのメモリに収める方法は一つです。計算に使わない部分をディスクに置き、使う瞬間だけ読みます。ディスクの読み込み速度が生成速度を大きく左右します。
Qwen3.8-Flash-Nextはエキスパートネットワークを複数持ち、トークンごとに一部だけを使うMoE3モデルです。共有の重みはメモリに置き、選ばれたエキスパートだけをSSDからキャッシュに読み込みます。よく使うエキスパートはメモリに残して次の読み込みを減らします。
そのためメモリの小さいMacではディスクの読み込みが速度を決め、メモリの大きいMacではより多くのエキスパートを保持できるぶん速くなります。どちらでも計算結果は同じです。
インストール前にMacとディスクを確認します
インストールして最初の返答を受け取ります
ターミナルでインストールスクリプトを実行します。同じコマンドをもう一度実行すると更新されます。
curl -LsSf https://raw.githubusercontent.com/carloslfu/slotstream/main/install.sh | shインストール後はdoctorでMacの状態を確認し、runで最初の返信を受け取ります。初回はモデルをダウンロードし、中断しても再開できます。
slotstream doctor
slotstream run --prompt "하늘이 파란 이유가 뭐야?"
ダウンロードするファイルは100GBを超えるため、回線によっては数時間かかります。一度取得すれば以後はオフラインでも実行できます。
メモリの区分ごとに期待できる速度が変わります
搭載メモリによって期待できる速度と自動のコンテキスト長が変わります。以下の値は開発チームが公開した推定値で、実際の速度は他のアプリのメモリ使用に応じて下がります。
| 搭載メモリ | 推定速度 | 自動コンテキスト長 |
|---|---|---|
| 16GB以上24GB未満 | 毎秒1〜6トークン | 32,768トークン |
| 24GB以上48GB未満 | 毎秒5〜16トークン | 32GBまで32,768トークン |
| 48GB以上96GB未満 | 毎秒15〜27トークン | 64GBで131,072トークン |
| 96GB以上 | 毎秒20〜32トークン | 262,144トークン |
96GB以上はモデルがメモリに収まる区分なので、全体を載せるエンジンの方が速いと開発チームは述べています。
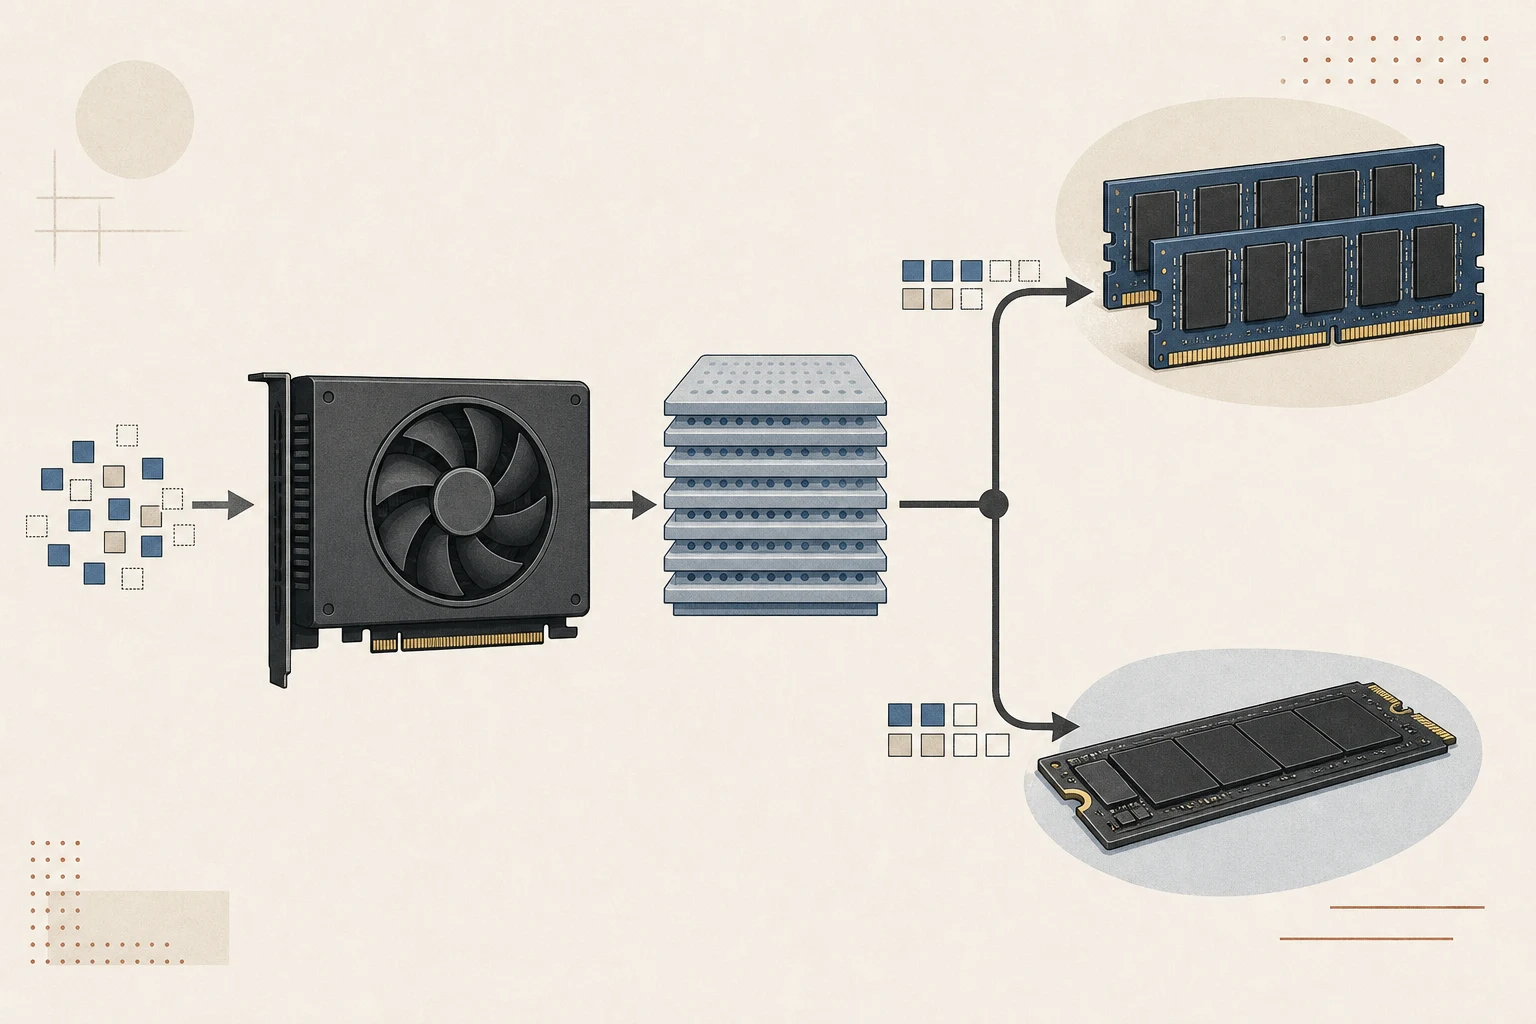
公開された測定値の条件を読みます
開発チームが公開した測定は2026年10月5日、48GBのM5 Proで33GBのメモリ予算のもとに行われました。元の4ビットモデルを使い、3種類の作業をそれぞれ3回ずつ実行しています。
| 作業 | 中央値 |
|---|---|
| 短いプロンプト | 毎秒20.91トークン |
| 長いコンテキスト | 毎秒23.69トークン |
| コーディング回答の完走 | 毎秒21.59トークン |
この値は回答を生成する区間だけを測ったものです。モデルを読み込む時間とプロンプト6を読む時間は別にかかるため、会話の最初のターンは表より遅く感じます。
以前のリリースと比べると予算の違いが見えます
以前の0.2.19リリースは22GBの予算で毎秒15.86トークンを記録しました。予算が大きくなればより多くのエキスパートをメモリに置けるため、ディスクの読み込みが減ります。
開発チームはこの数字が同一設定での速度向上を意味するわけではないと述べています。予算も作業の組み合わせも測定方法も異なるため、リリース間の比較として読むべきではありません。
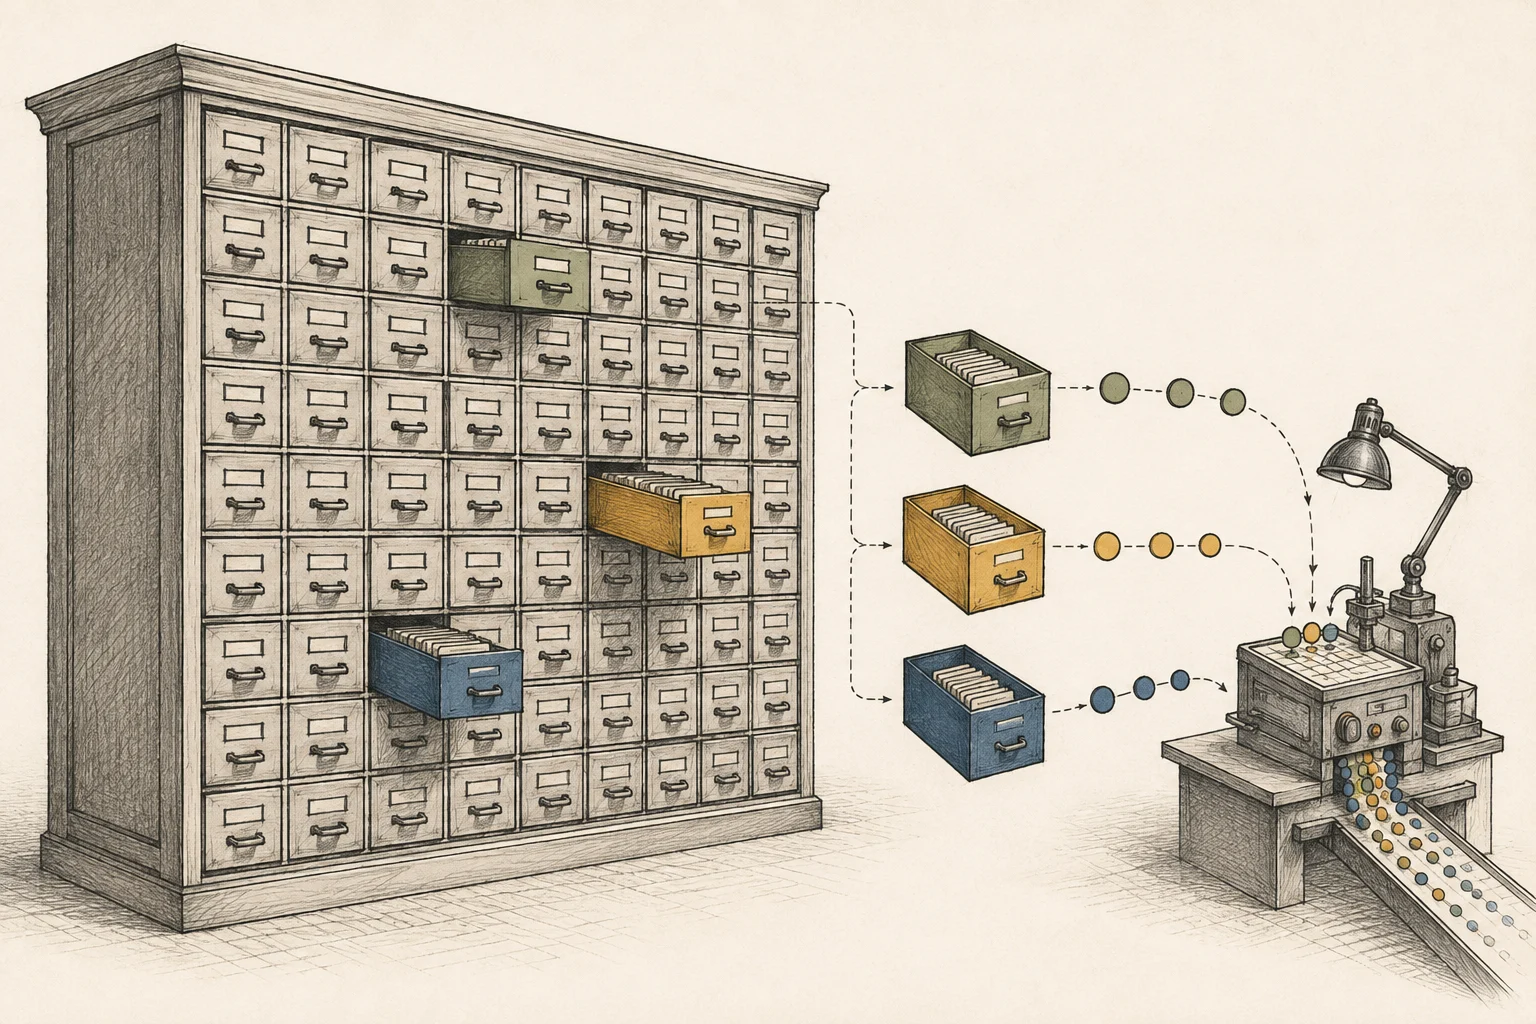
読むエキスパートをあらかじめ決める方式です
次の層でどのエキスパートが必要になるかを予測し、要求される前にSSDから読み込みます。この予測は速度だけを変え、出力は変えません。
エキスパートのキャッシュは他のアプリがメモリを要求すると縮みます。キャッシュが縮むと速度は落ちますが、モデルからエキスパートが消えるわけではありません。
メモリ目標を指定しない場合は33GBを基準にし、実際の空きに合わせて調整します。起動時には予算とキャッシュの大きさ、余裕分を分けて表示します。
メモリ目標を自分で指定する場合、その値は最大予算であり、常にそれだけ使うわけではありません。短いリクエストは目標よりずっと少ない使用量で終わります。
コーディングエージェントにつなぎます
Ollama、OpenAI、Anthropic形式のAPI7を同時に開きます。Claude Code、Codex、opencode、Hermesをつなげて使え、launchの後ろにツール名を付けて実行します。
slotstream launch claude複数のリクエストを同時に処理はしません。接続したアプリが1つのモデルを共有するため、複数のエージェントを同時に動かす用途なら別のツールが合います。
| 何を確認するか | Slotstream |
|---|---|
| 対応API形式 | Ollama·OpenAI·Anthropic |
| 同時生成 | 一度に1つ |
| 他のモデル | 非対応 |
この方式が合わない場合もあります
用語の注釈
トークン — モデルが入力や出力を分けて処理する単位です。
本文に戻るSSD — フラッシュメモリを使うデータ保存装置です。電源を切ってもデータが保持されます。
本文に戻るMoE — 複数の専門家サブネットワークから入力に応じて一部を選ぶモデル構造です。総パラメータ数と1トークン処理時に有効な数は異なることがあります。
本文に戻るMLX — Appleが開発する機械学習フレームワークで、Apple SiliconのCPUとGPUが共有するメモリを使ってモデルを実行します。
本文に戻るMetal — Apple機器でグラフィックスやGPUの並列計算を実行する低水準の技術です。
本文に戻るプロンプト — モデルに送る入力文です。生成モデルでは作りたい結果を説明する文になり、出力の構成や内容を大きく左右します。
本文に戻るAPI — 別のコードからプログラムの機能を呼び出すための決められたインターフェースです。
本文に戻るPLE埋め込みテーブル — Per-Layer Embeddingの略で、モデルの特定の層に埋め込み情報を加える構造です。Qwen Flash-Next系はn-gramテーブルを使い、対応する実行環境ではRAMやSSDへオフロードできます。
本文に戻るオフロード — 容量が足りないとき、モデルデータの一部をGPUメモリからシステムRAMやストレージへ移して処理する方法です。データ転送が追加されます。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- Slotstreamは105GBの125Bモデルを16GBから64GBのMacで実行するMac専用プログラムです。共有の重みはメモリに置き、トークンごとに使うエキスパートだけをSSDから読みます。48GBのM5 Proで毎秒20.91〜23.69トークン、16GBのMacでは毎秒1〜6トークンまで下がります。
- 必要なメモリはどのくらいですか?
- SlotstreamはApple SiliconのMacで1,250億パラメータのモデルを動かす実行プログラムです。モデルファイルは約105GBありますが、16GBのMacでも動くことがこのツールの目的です。モデル全体をメモリに載せず、いまの計算に必要な部分だけをSSDから読みます。