실행 프로그램과 확장
vLLM Metal 0.30: Mac 한 대를 여러 사람이 쓰는 로컬 AI 서버로 만드는 법
vLLM Metal의 강점은 한 답변의 최고 속도보다, 겹친 요청을 덜 낭비하며 처리하는 데 있습니다.
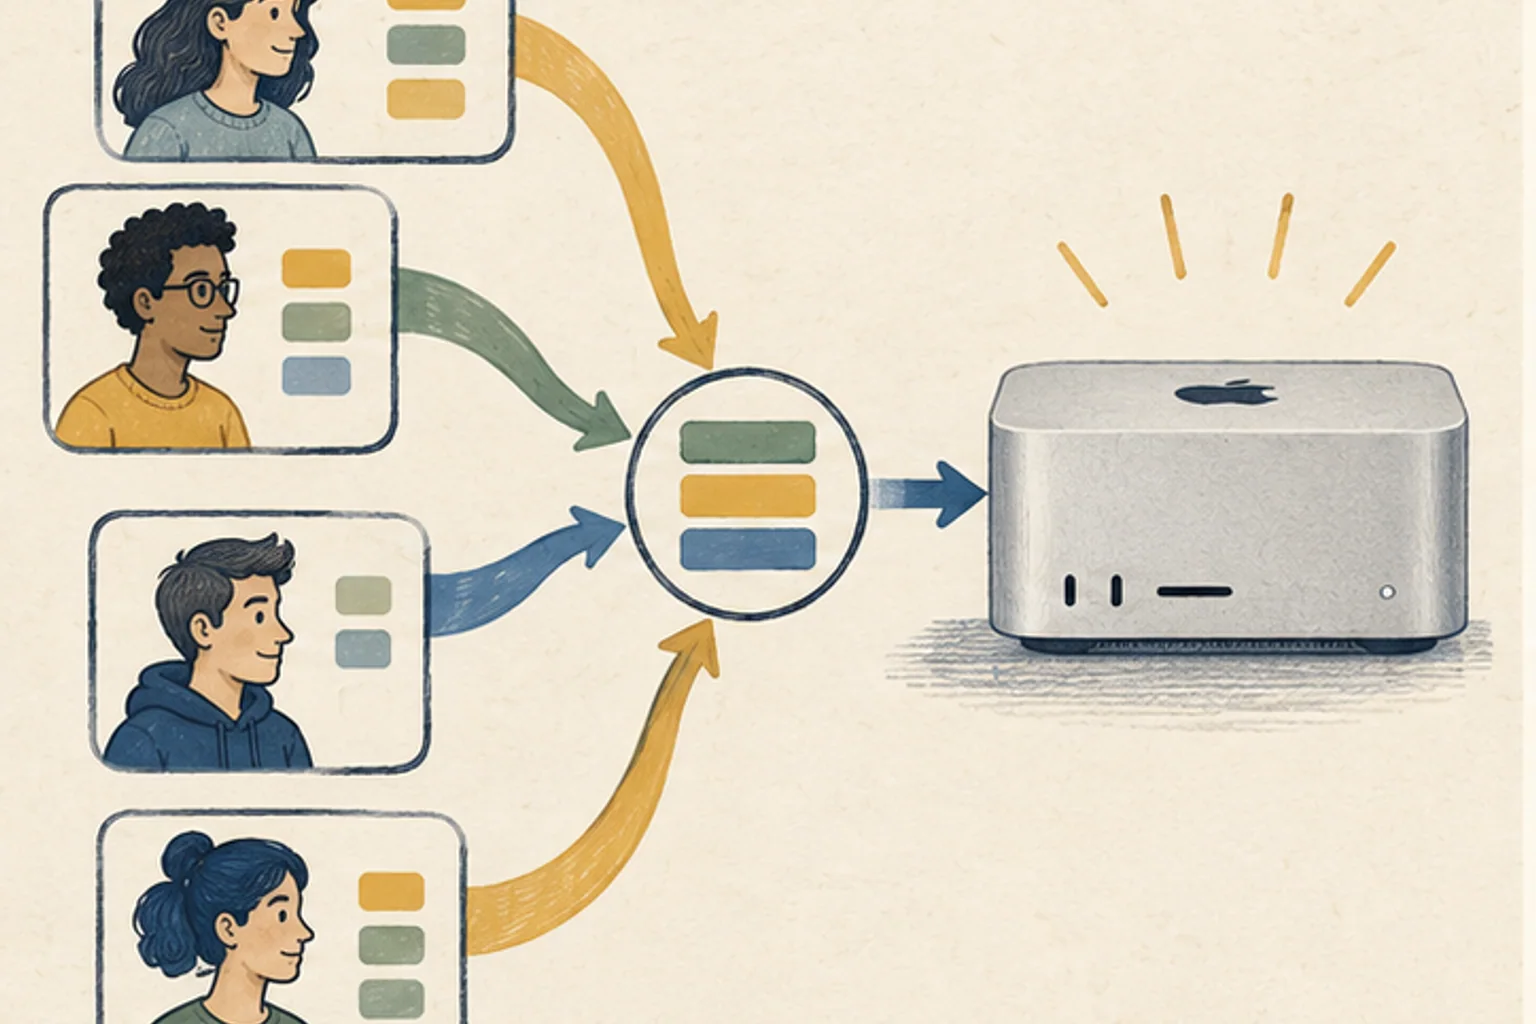
혼자 쓰던 Mac Studio에 코딩 에이전트와 문서 검색 도구, 가족의 질의가 동시에 들어오면 한 요청의 tok/s만으로는 서버 상태를 설명할 수 없습니다. vLLM Metal1 0.30은 vLLM 스케줄러와 Metal 실행을 연결해 KV 캐시2를 페이지 단위로 관리하고 여러 요청을 묶어 처리합니다. 설치 후 바로 동시 사용자가 빨라지는 것은 아니며 메모리 예산과 큐 지연을 함께 맞춰야 합니다.
한 요청과 여러 요청의 빠름은 다릅니다
혼자 한 문장을 생성할 때는 메모리 대역폭3과 커널 효율이 속도를 좌우합니다. 여러 요청이 겹치면 스케줄러가 빈 계산 구간을 얼마나 잘 채우고 KV 캐시 공간을 얼마나 덜 낭비하는지가 중요해집니다. vLLM Metal은 후자의 문제를 Mac에서 다루려는 서버 엔진입니다.
사이트가 보유한 공개 측정에서 M5 Pro 64GB와 Qwen3-0.6B BF164 조건의 vLLM Metal 출력 처리량5은 동시성 1·8·16에서 각각 136.3·445.7·497.2 tok/s였습니다. 이 수치는 작은 모델의 서버 처리량이며 다른 모델의 개인 디코드6 속도로 옮기지 않습니다. 핵심은 동시 요청이 생겼을 때 총 처리량 곡선을 따로 봐야 한다는 점입니다.
0.30에서 바뀐 메모리 규칙을 먼저 맞춥니다
vLLM Metal 0.30은 KV 저장소를 vLLM 스케줄러가 통합 관리하고 Metal 쪽에서는 MLX7 view로 같은 메모리를 봅니다. 하이브리드 모델도 서로 다른 캐시 풀이 메모리를 이중으로 잡지 않고 전체 예산을 함께 사용합니다. PagedAttention은 항상 켜지므로 과거 환경 변수로 끄는 설정은 더 이상 기준이 아닙니다.
이전의 VLLM_METAL_MEMORY_FRACTION 환경 변수는 제거됐고 --gpu8-memory-utilization으로 예산을 정합니다. 너무 높이면 운영체제와 다른 앱이 메모리 압박을 받고, 너무 낮으면 KV 블록이 부족해 동시 요청이 대기합니다. 0.70처럼 보수적으로 시작해 실제 동시성에서 스왑과 메모리 압력을 보며 올립니다.
설치는 안정 버전과 네이티브 arm64를 확인합니다
공식 요구 조건은 Apple Silicon, macOS 15 이상, 네이티브 arm64 Python 3.12입니다. Rosetta로 실행되는 x86 Python이 섞이면 설치가 되더라도 Metal 경로가 예상과 달라질 수 있습니다. 터미널에서 아키텍처와 Python 버전을 확인한 뒤 공식 설치 스크립트나 Homebrew 중 하나를 선택합니다.
0.30에서는 fp89·int8·nvfp410 KV 캐시 dtype을 받지 않으며 auto 또는 TurboQuant 경로를 사용해야 합니다. 다른 vLLM 서버에서 쓰던 옵션을 그대로 복사하면 시작 단계에서 거부될 수 있습니다. 릴리스 노트의 제거·변경 항목을 먼저 보고 현재 명령을 짧게 만듭니다.
curl -fsSL https://raw.githubusercontent.com/vllm-project/vllm-metal/main/install.sh | bash -s -- --stablebrew tap vllm-project/vllm-metal https://github.com/vllm-project/vllm-metal
brew install vllm-project/vllm-metal/vllm-metal동시성 시험은 개인 지연과 총 처리량을 같이 봅니다
단일 요청으로 정상 답변과 메모리 사용량을 확인한 뒤 동시성 2·4·8 순서로 올립니다. 각 단계에서 전체 tok/s뿐 아니라 요청별 첫 토큰11 시간과 토큰 사이 지연을 기록합니다. 총 처리량이 올라가도 개인 요청이 지나치게 늦어진다면 배치 한도나 최대 시퀀스 수를 낮춰야 합니다.
코딩 에이전트는 짧은 호출을 여러 번 보내고 문서 요약은 긴 입력을 한 번 보냅니다. 두 작업을 같은 비율로 섞은 시험을 만들어야 실제 큐와 프리필12 경쟁을 볼 수 있습니다. 한 종류의 짧은 프롬프트만으로 얻은 최고 처리량을 팀 서버 용량으로 쓰지 않습니다.
여러 Mac은 먼저 독립 복제로 나눕니다
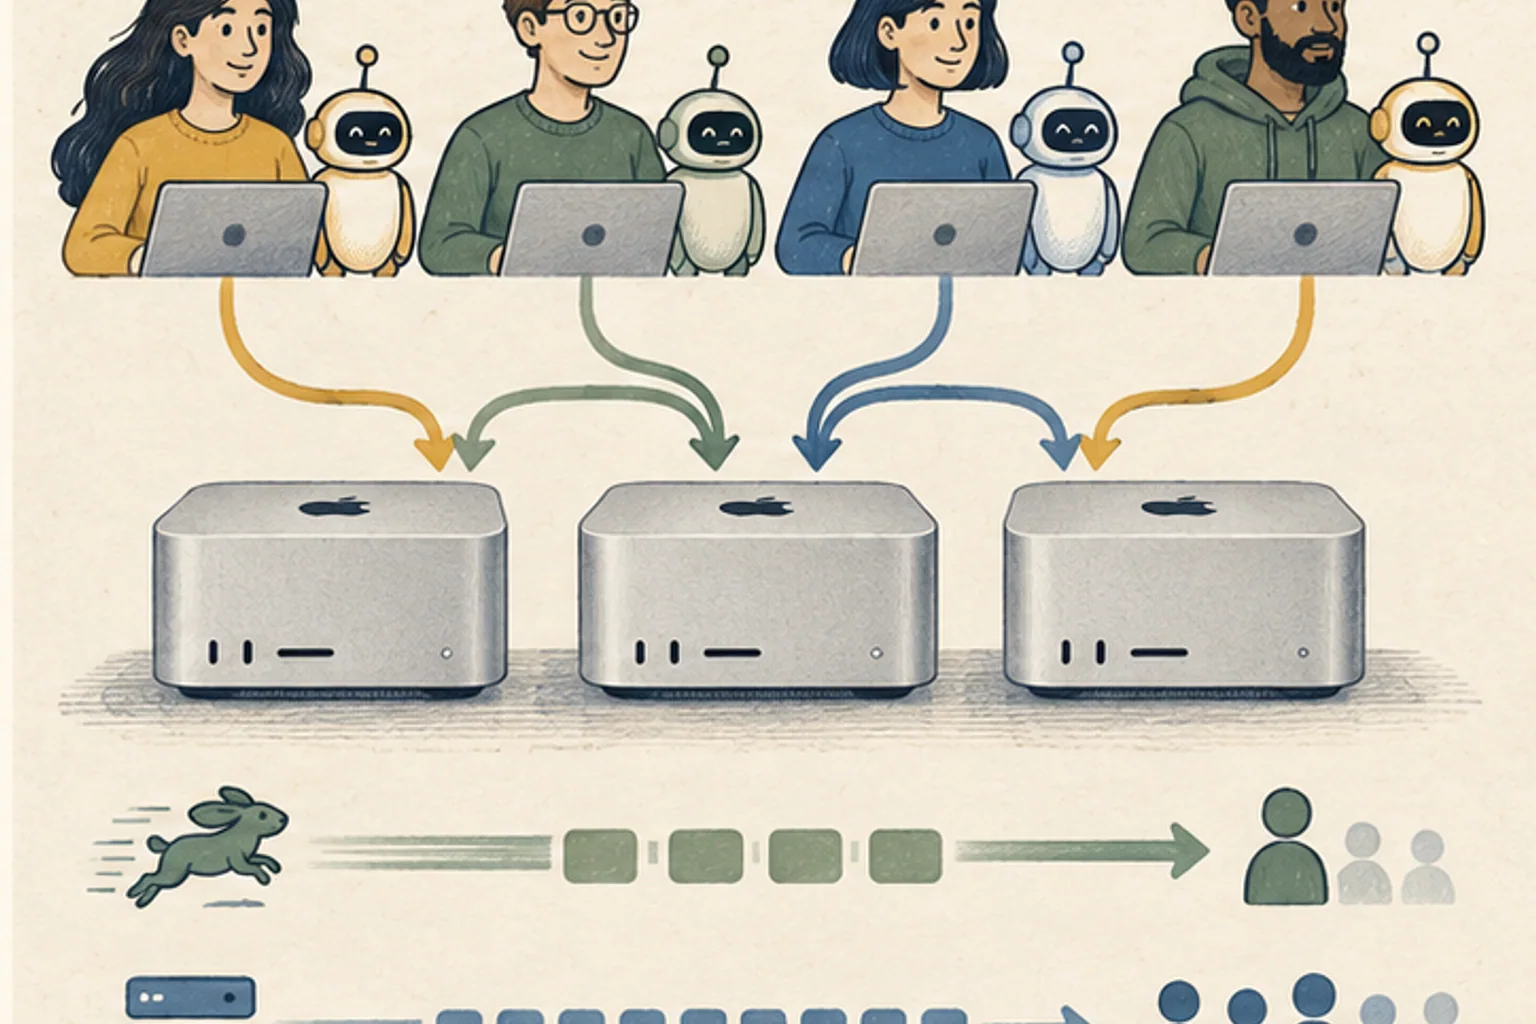
vLLM Metal은 Ray 실행기와 파이프라인 병렬13, Mac별 데이터 병렬 복제를 지원하는 방향으로 발전했습니다. 하지만 모델 하나를 여러 Mac에 나누면 네트워크 동기화가 토큰마다 개입할 수 있습니다. 모델이 한 Mac에 들어간다면 각 Mac에 같은 서버를 띄우고 요청을 나누는 구성이 문제를 찾고 복구하기 쉽습니다.
한 대가 멈춰도 나머지 서버가 요청을 받을 수 있고, 모델 업데이트도 한 대씩 검증할 수 있습니다. 반대로 모델이 한 대에 들어가지 않을 때만 파이프라인14 분할을 검토합니다. 구매 결정은 단일 요청 최고치가 아니라 목표 동시 사용자에서 유지되는 첫 토큰 시간과 장애 복구 방식으로 내립니다.
용어 각주
Metal — Apple 기기에서 그래픽과 GPU 병렬 계산을 실행하는 저수준 기술입니다. 모델을 골라 대화하는 앱 자체와는 다릅니다.
본문으로 돌아가기KV 캐시 — 어텐션에서 이전 토큰의 키·값을 저장해 다음 토큰 생성 때 재사용하는 메모리입니다. 문맥 길이와 배치 크기에 따라 용량이 달라집니다.
본문으로 돌아가기메모리 대역폭 — 메모리와 프로세서 사이에서 단위 시간에 전송할 수 있는 데이터 양입니다. 실제 처리량은 접근 패턴과 다른 병목에도 영향을 받습니다.
본문으로 돌아가기BF16 — 모델의 수를 저장하고 계산하는 16비트 부동소수점 형식입니다. 사용 가능 여부는 하드웨어와 실행 프로그램에 달려 있습니다.
본문으로 돌아가기처리량 — 일정 시간 동안 처리하거나 생성한 작업량입니다. 토큰/초, 요청/초처럼 단위를 함께 확인해야 비교할 수 있습니다.
본문으로 돌아가기디코드 — LLM에서는 입력 처리 뒤 출력 토큰을 생성하는 단계를 뜻합니다. VAE나 오디오 코덱에서는 압축 표현이나 인코딩 데이터를 원래 형식으로 복원하는 처리를 가리킬 수 있습니다.
본문으로 돌아가기MLX — Apple이 개발하는 머신러닝 프레임워크입니다. Apple silicon에서는 통합 메모리와 Metal을 활용하며, 별도로 Linux 실행 경로도 제공합니다. 지원 모델과 기능은 MLX 기반 도구마다 다릅니다.
본문으로 돌아가기GPU — 많은 계산을 병렬로 처리하는 프로세서입니다. AI 모델 실행에서는 모델 계산을 맡습니다.
본문으로 돌아가기FP8 — 8비트 부동소수점 수치 형식 계열입니다. 세부 형식과 지원 범위는 하드웨어 및 소프트웨어에 따라 다릅니다.
본문으로 돌아가기NVFP4 — NVIDIA가 정의한 4비트 부동소수점 데이터 형식입니다. 지원 여부는 GPU 세대, 모델과 소프트웨어 구현에 따라 다릅니다.
본문으로 돌아가기토큰 — 모델이 입력이나 출력을 나누어 처리하는 단위입니다. 토큰 하나가 글자 하나나 일정한 시간 길이에 해당하지는 않습니다.
본문으로 돌아가기프리필 — LLM이 입력 프롬프트를 읽고 각 토큰의 내부 표현을 계산하는 단계입니다. 입력이 길수록 처리할 토큰이 많아집니다.
본문으로 돌아가기파이프라인 병렬 — 모델의 층들을 여러 장치의 단계로 나누어 실행하는 방식입니다. 한 요청의 다음 단계가 앞 단계 결과를 기다릴 수 있어, 장치를 늘려도 한 응답이 같은 비율로 빨라지지는 않습니다.
본문으로 돌아가기파이프라인 — 입력부터 결과까지 이어지는 처리 단계의 묶음입니다. 각 단계에서 서로 다른 모델이나 도구를 사용할 수 있습니다.
본문으로 돌아가기