実行プログラムと拡張機能
vLLM Metal 0.30:1台のMacを複数人向けローカルAIサーバーにする
vLLM Metalの強みは、1つの回答の最高速度よりも、重複した要求を無駄にして処理することです。
自分で書いたMac Studioにコーディングエージェントとドキュメント検索ツール、家族の問い合わせが同時に入ってくると、1つのリクエストのtok/sだけではサーバーの状態を説明できません。 vLLM Metal1 0.30 は vLLM スケジューラと Metal の実行を接続し、KV キャッシュをページ単位で管理し、複数の要求をまとめて処理します。インストール後すぐに同時ユーザーが高速化されるわけではなく、メモリー予算とキュー遅延を一緒にする必要があります。
1つの要求と複数の要求の速さは異なります
単独で文を生成するときは、メモリ帯域幅2とカーネル効率が速度に左右されます。複数の要求が重複する場合、スケジューラが空の計算区間をどれだけ充分に満たし、KVキャッシュ空間をどれだけ無駄にするかが重要になる。 vLLM Metalは、後者の問題をMacで扱おうとするサーバーエンジンです。
サイトが保有する公開測定で、M5 Pro 64GBとQwen3-0.6B BF163条件のvLLM Metal出力スループット4は、同時性1・8・16でそれぞれ136.3・445.7・497.2tok/sでした。この数値は、小さなモデルのサーバースループットであり、他のモデルのプライベートデコード5速度には移動しません。重要なのは、同時要求が発生したときに総スループット曲線を別々に見る必要があることです。
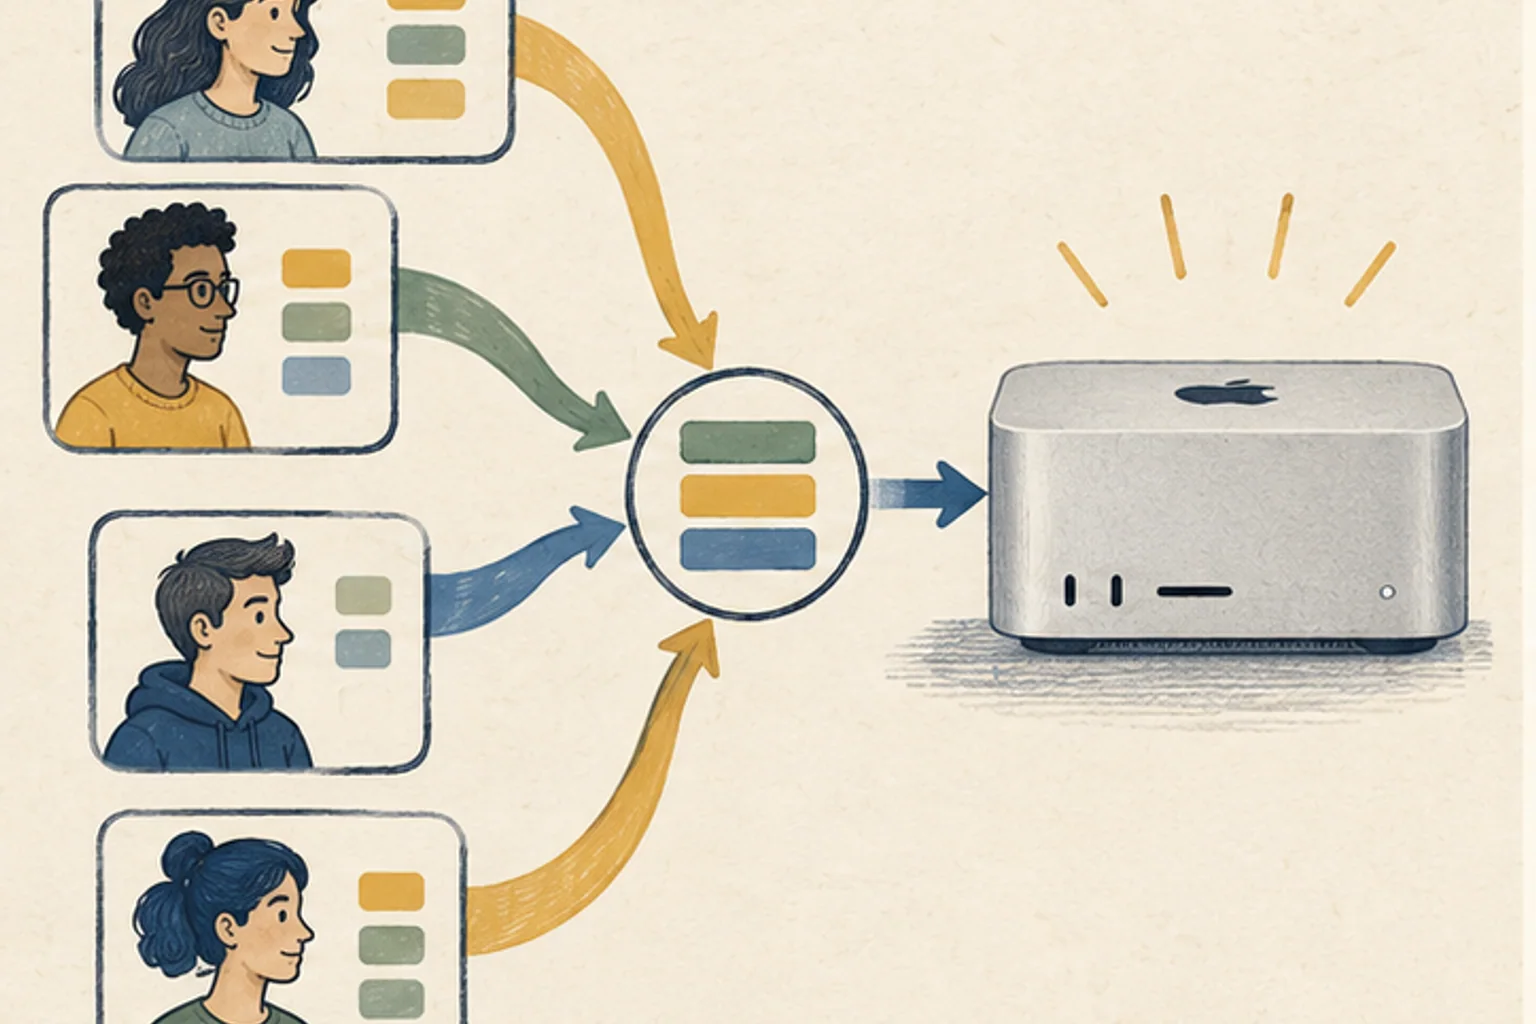
0.30から変更されたメモリルールを最初に合わせます
vLLM Metal 0.30 は KV ストレージを vLLM スケジューラによって統合管理し、Metal 側では MLX6 view で同じメモリを表示します。ハイブリッドモデルも、異なるキャッシュプールがメモリを二重にすることなく、予算全体を一緒に使用します。 PagedAttentionは常にオンになるため、過去の環境変数でオフにした設定はもはや基準ではありません。
以前のVLLM_METAL_MEMORY_FRACTION環境変数は削除され、--gpu7-memory-utilizationで予算を設定します。高すぎるとオペレーティングシステムや他のアプリがメモリの圧迫を受け、低すぎるとKVブロックが不足して同時要求が待機します。 0.70のように保守的に起動し、実際の並行性でスワップとメモリ圧力を見て上げます。
インストールは安定版とネイティブarm64をチェックします
公式要件はApple Silicon、macOS 15以降、ネイティブarm64 Python 3.12です。 Rosettaで実行されているx86 Pythonが混在している場合、インストールされていてもMetalのパスが予想と異なる場合があります。ターミナルでアーキテクチャとPythonのバージョンを確認し、公式のインストールスクリプトまたはHomebrewのいずれかを選択します。
0.30では、fp88・int8・nvfp49 KVキャッシュ10dtypeを受け取らず、autoまたはTurboQuantパスを使用する必要があります。他のvLLMサーバーによって書き込まれたオプションをそのままコピーすると、開始段階で拒否される可能性があります。リリースノートの削除・変更項目を先に見て、現在のコマンドを短くします。
curl -fsSL https://raw.githubusercontent.com/vllm-project/vllm-metal/main/install.sh | bash -s -- --stablebrew tap vllm-project/vllm-metal https://github.com/vllm-project/vllm-metal
brew install vllm-project/vllm-metal/vllm-metal並行性テストでは、個人の遅延と総スループットを一緒に見る
単一の要求で正常な回答とメモリ使用量を確認した後、並行性2・4・8順に上げます。各ステップで、トークン11全体と同様に、要求ごとの最初のトークン時間とトークン間の遅延を記録します。総スループットが上がっても個人の要求が遅すぎる場合は、配置制限または最大シーケンス数を減らす必要があります。
コーディングエージェントは短い呼び出しを複数回送信し、文書の要約は長い入力を一度送信します。両方のタスクを同じ割合で混合したテストを作成する必要があり、実際のキューとプレフィルの競争を見ることができます。 1 種類の短いプロンプトで得られた最高スループットをチーム サーバーの容量として書きません。
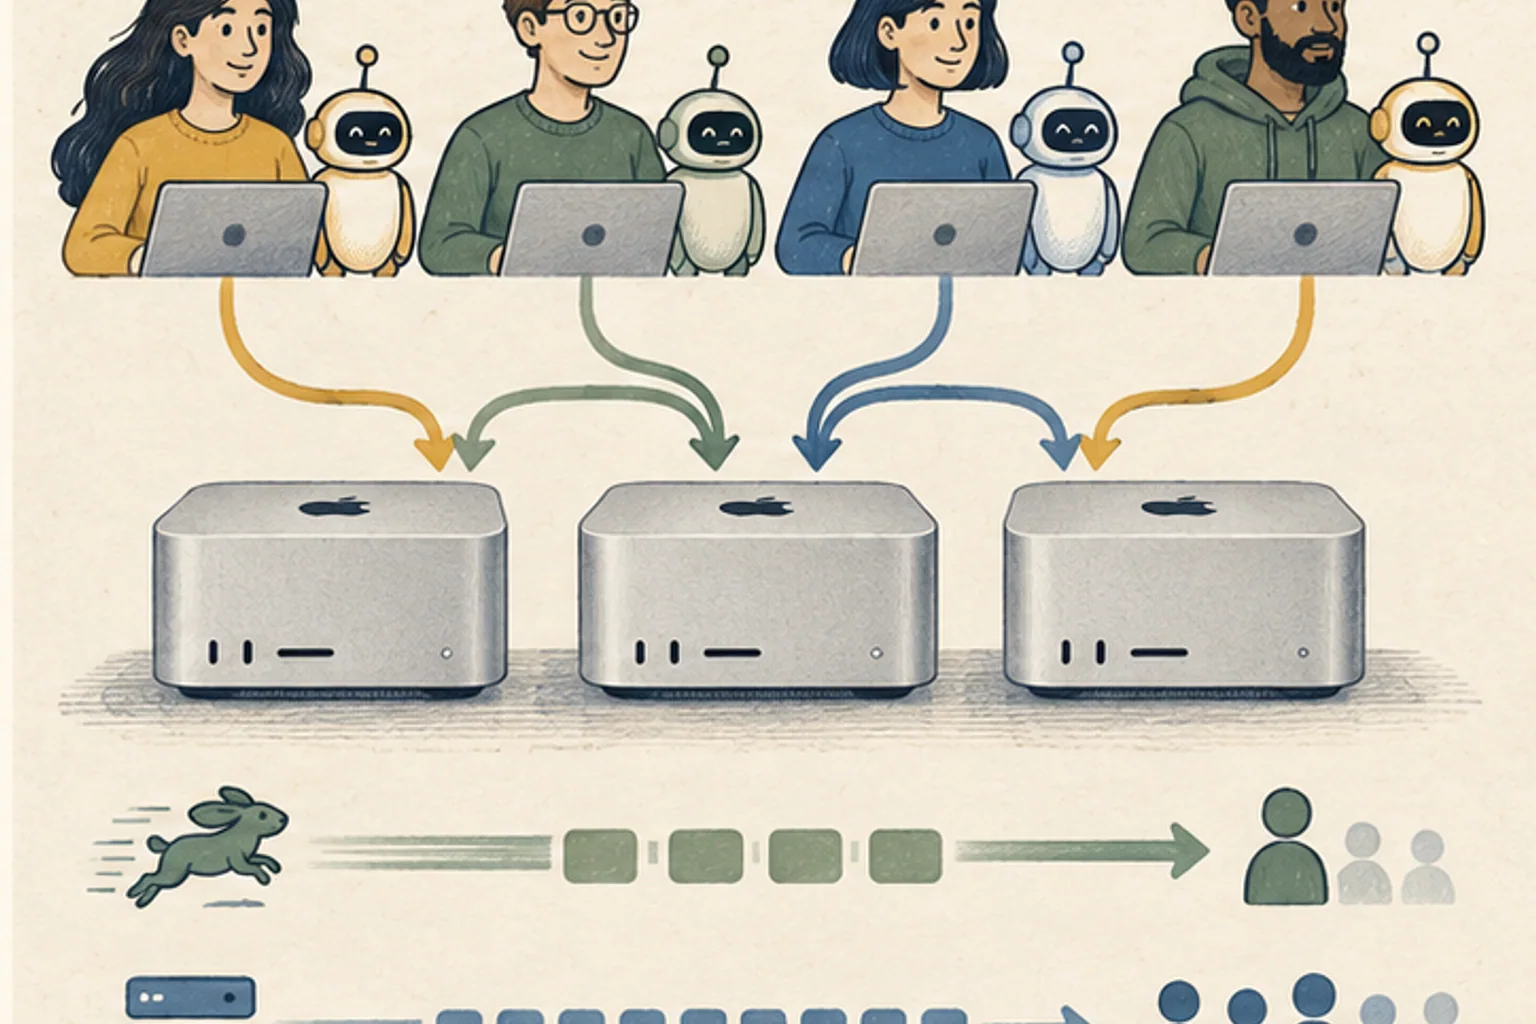
複数のMacは最初に独立した複製に分割されます
vLLM Metalは、Rayランチャーとパイプライン並列12、Mac固有のデータ並列複製をサポートする方向に発展しました。ただし、1つのモデルを複数のMacに分割すると、ネットワーク同期はトークンごとに介入できます。モデルが1つのMacに入ると、各Macに同じサーバーを起動し、要求を分割する構成が問題を見つけて修復するのは簡単です。
1台が停止しても、残りのサーバーが要求を受け取ることができ、モデル更新も1台ずつ検証できます。逆に、モデルが1台に入らない場合にのみパイプライン13分割を確認してください。購入の決定は、単一の要求最高値ではなく、ターゲット同時ユーザーで維持される最初のトークン時間とフェイルバック方式で行われます。
用語の注釈
Metal — Apple機器でグラフィックスやGPUの並列計算を実行する低水準の技術です。モデルを選んで会話するアプリそのものではありません。
本文に戻るメモリ帯域幅 — メモリとプロセッサー間で単位時間に転送できるデータ量です。実効処理量はアクセスパターンや他のボトルネックにも左右されます。
本文に戻るBF16 — モデルの数値を保存・計算する16ビット浮動小数点形式です。利用可否はハードウェアと実行環境によります。
本文に戻るスループット — 一定時間に処理・生成した作業量です。トークン/秒やリクエスト/秒など、単位を合わせて比較します。
本文に戻るデコード — LLMでは入力処理後に出力トークンを生成する段階です。VAEやオーディオコーデックでは、圧縮表現や符号化データから元の形式を復元する処理を指すことがあります。
本文に戻るMLX — Appleが開発する機械学習フレームワークです。Apple siliconでは統合メモリとMetalを活用し、別途Linux向けの実行経路も提供します。対応モデルや機能はMLXを使うツールごとに異なります。
本文に戻るGPU — 多くの計算を並列に処理するプロセッサーです。AIモデルの実行ではモデル計算を担います。
本文に戻るFP8 — 8ビット浮動小数点形式の総称です。具体的な形式や対応範囲はハードウェアとソフトウェアによって異なります。
本文に戻るNVFP4 — NVIDIAが定義した4ビット浮動小数点データ形式です。対応状況はGPU世代、モデル、ソフトウェア実装によって異なります。
本文に戻るKVキャッシュ — 過去トークンのAttention用キー・バリューを保存し、後続トークン生成で再利用するメモリです。容量はコンテキスト長やバッチサイズで変わります。
本文に戻るトークン — モデルが入力や出力を分けて処理する単位です。1トークンが1文字や一定の時間に相当するわけではありません。
本文に戻るパイプライン並列 — モデルの層を複数の装置上の段階に分けて実行する方式です。後の段階が前の結果を待つことがあり、装置を増やしても個々の応答が同比率で速くなるとは限りません。
本文に戻るパイプライン — 入力から出力まで続く処理段階のまとまりです。段階ごとに異なるモデルやツールを使うことがあります。
本文に戻る