実行プログラムと拡張機能
ローカルRAG回答が間違っている場合:検索・チャンク・モデル診断手順
モデルから変更すると原因を見逃しやすい
回答が誤っていたら、まず検索機能が渡した断片を確認してください。PDFの文字が欠けていないか、チャンクが条件を分断していないか、必要な文が検索されたのにモデルが見落としたのかを順に調べます。
休暇規程への回答が誤っていたら、まず検索結果を開きます
「入社6か月の社員も夏季休暇を取れますか」という質問を例にします。回答画面だけでは原因が分からないため、まず検索機能がモデルに渡した断片を画面またはログで確認します。上位の検索結果に「勤続1年以上」という条件がなければ、生成モデルを変えないでください。回答モデルは、検索されなかった規程を復元できません。
検索結果が空、または別の休暇制度を指している場合は、まずPDFの抽出結果を原文ページと照合します。見出しと表の行が混ざっていないか、「6か月以上」のような条件がテキストに残っているかを確認してください。抽出結果には条件があるのに検索されない場合は、チャンク境界、埋め込み、文書フィルターを一つずつ調べます。検索された断片に条件が明記されているのに回答が誤っている場合は、モデルに渡したプロンプトと回答を比較します。
まずPDFの原文と抽出テキストを照合します
休暇規程が表形式、または二段組みのPDFなら、1ページ選び、目で見える文章と抽出テキストを並べてください。「入社後6か月以上」が抜けている、または表の資格要件と例外が混ざっている場合、検索機能は誤った原文を正確に見つけている可能性があります。PDF抽出ツールまたはOCR設定を変え、そのページを再抽出して欠けていた文が戻ったか確認します。
文書全体を再インデックスする前に、問題のページのテキストが修正されたことを確認してください。修正後も古い結果が出る場合は、以前の抽出データやインデックスを参照していないか調べます。原文と抽出テキストが同じ意味を持つことを確認してから、チャンクや検索設定に進みます。
根拠が検索されない場合は設定を一つずつ変えます
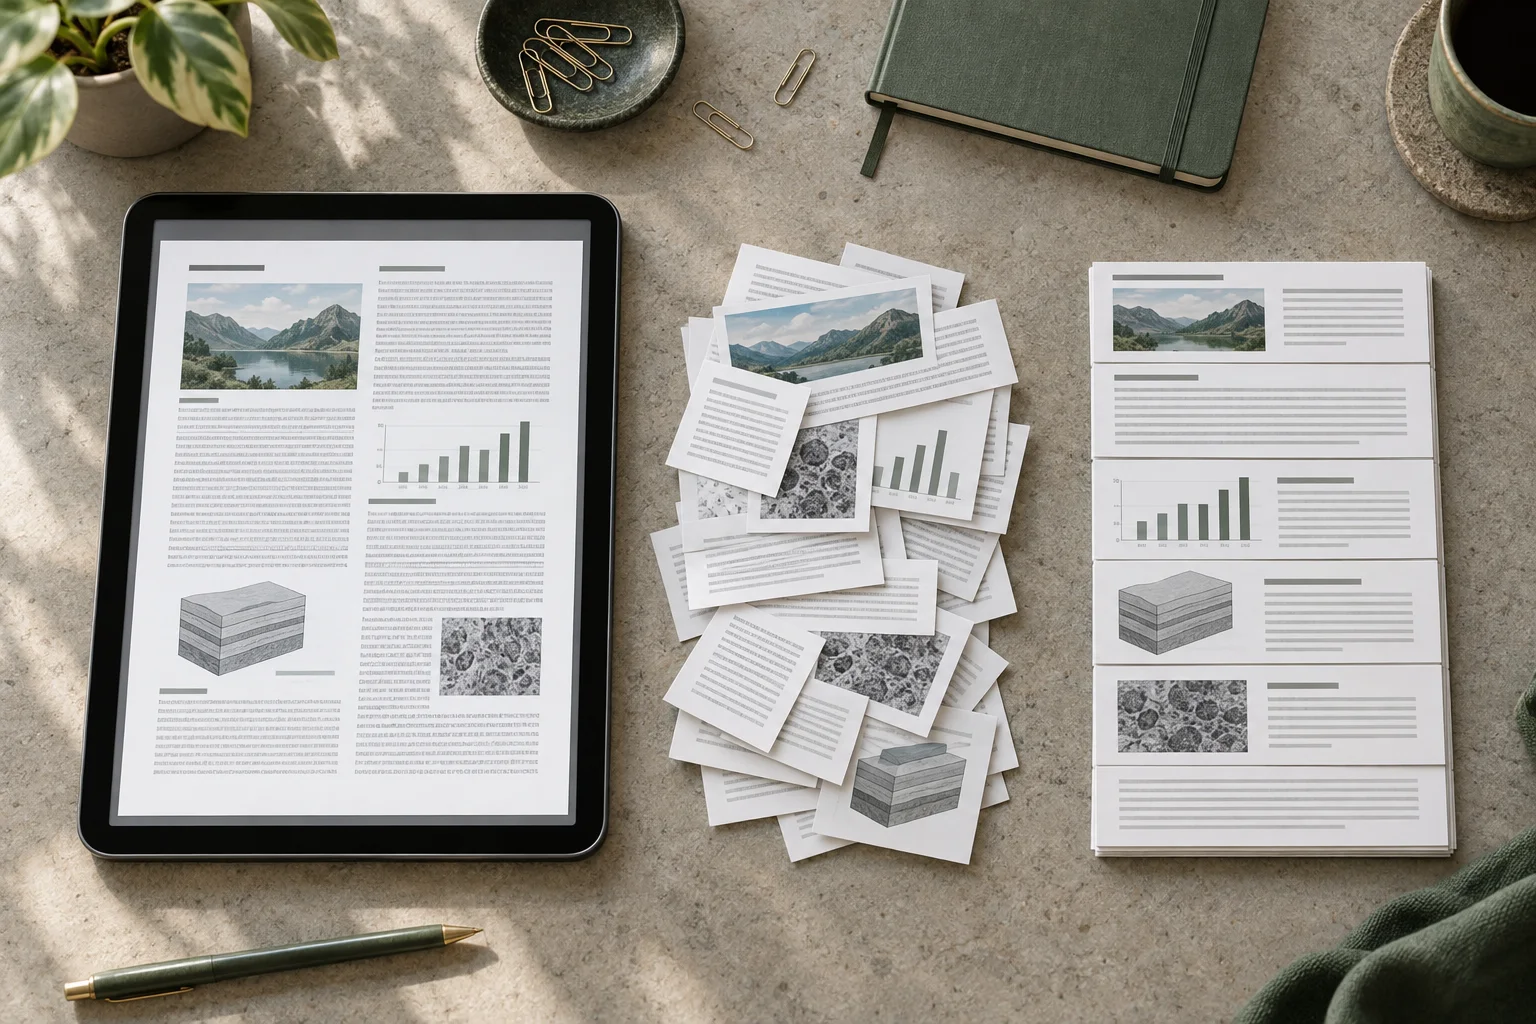
チャンクが短すぎると、「勤続6か月以上」という条件と休暇の可否が別々の断片に分かれることがあります。長すぎると複数の休暇規程が一つの断片に混ざり、質問と無関係な文までモデルに渡される場合があります。まず正解の根拠となるべき文に印を付け、同じ質問を実行して、その文が上位の検索結果に含まれるか記録してください。
根拠が見つからない場合は、チャンクサイズだけを調整して同じ質問を再実行します。それでも見つからなければ、重なり、埋め込み、メタデータフィルター、再ランキングの順に一つずつ変更してください。一度に複数の設定を変えると、検索結果が変わってもどの設定が改善につながったのか分かりません。検索順位の改善と最終回答の正確さの改善も分けて記録します。
文書を更新したら、新しいインデックスを確認してから切り替えます
規程PDFを修正したのに古い回答が続く場合は、ファイル名だけでなく、ファイルハッシュ、インデックス作成時刻、インデックスのバージョン、キャッシュキーを確認してください。名前を変えずに本文だけが変更された可能性があります。質問を使って、修正内容が抽出テキストに含まれていること、新しいインデックスの検索結果に修正後の条項が出ることを確認します。
稼働中のインデックスを先に削除して作り直すと、検証が終わるまで検索を提供できない場合があります。新しいバージョンを別に作り、代表的な質問で確認してから切り替えれば、新バージョンに問題が見つかったときに以前のインデックスへ戻せます。文書ハッシュ、インデックスのバージョン、代表的な質問に対する検索結果と回答を確認してください。
検索が正しいのに回答が誤っている場合は生成段階を確認します
検索された断片には「勤続6か月以上で夏季休暇を申請できる」とあるのに、モデルが「1年以上の勤続が必要です」と回答したとします。まず、その断片が実際のプロンプトにそのまま含まれているか確認します。含まれている場合は、根拠の文だけに基づいて回答し、条件が書かれていなければ分からないと答えるようモデルに指示します。同じ根拠を使っても誤答するなら、別のモデルや量子化1を比較します。
回答が遅い場合も区間に分けます。質問を送ってから検索結果が出るまで、検索完了から最初のトークン2が出るまで、最初のトークンから回答が終わるまでの時間をそれぞれ記録してください。最初の区間が長ければインデックスやフィルター、2番目が長ければ根拠の長さやプリフィル3、最後が長ければトークン生成速度を確認します。利用者が増えたときだけ遅くなるなら、一人と四人が同じ質問をした場合の待ち行列とメモリ使用量を比較してください。