まず読み込み
ローカルRAG構築ガイド:私の文書に答えるAIを作成する手順
文書を入れたとすぐに良い答えは出ません。
まずPDFから抽出されたテキストを確認します。次にチャンクに分け、質問に近い根拠を検索し、その箇所を読んだモデルの回答を確認します。文書量と同時利用者数を見積もり、実際の根拠の長さで待ち時間も測定してください。
一つの質問で文書取り込み・検索・回答を切り分けます
社内の休暇規程PDFを使って、「入社6か月の社員も夏季休暇を取れますか」と答えたいとします。RAG1はPDFから文字を取り出して検索用の断片に分け、質問に近い断片を選んでLLM2に渡します。LLMは渡された根拠を読んで回答を書きます。質問のたびにPDF全体を読み直す仕組みではありません。
最初の実装では、回答と一緒に検索された断片も画面に表示してください。たとえば回答が「可能です」なのに、検索結果に入社6か月という条件がなければ、モデルが推測したのか、検索機能が別の段落を取得したのかをすぐ確認できます。検索結果が空、または無関係なら、回答モデルを変える前に文書抽出と検索を修正します。必要な条件がすべて含まれているのに回答だけが誤っている場合は、プロンプトか生成モデルを確認します。
実際に試すには、LlamaIndexの公式ローカルモデル例に沿って、回答モデルにOllama、検索用にHugging Faceの埋め込みモデルを接続します。まず休暇規程PDFをdata/vacation-policy.pdfとして保存してください。以下のコードはdata/内のテキストPDFを読み込み、700トークン3のチャンクと100トークンの重なりでインデックスを作成し、同じ休暇規程の質問を送ります。インストールとモデルのダウンロードにはネットワークが必要ですが、この構成はOllamaのローカルサーバーとダウンロード済みの埋め込みモデルを使い、ホスト型の回答・埋め込みAPI4は呼び出しません。標準のllama3.1モデルファイルは約4.9GBで、推論時には重みとコンテキスト用のメモリも必要です。ディスク容量だけでなく、利用可能なメモリも確認してください。機密文書を扱う場合はモデルを事前に用意し、ネットワークを切断した後も実行できることを確認してください。
実行すると、まずPDFから抽出したテキストの一部が表示され、次に回答と「Retrieved evidence」の下にモデルが参照した文章が表示されます。表現はモデルによって異なっても構いませんが、結論は実際のPDFにある勤続条件と一致している必要があります。抽出プレビューが空、または文の順序が崩れている場合は、インデックスを作る前にOCRまたはPDF抽出を修正してください。プレビューは正しいのに根拠が検索されない場合はチャンクと検索設定を調整し、根拠は正しいのに回答が異なる場合は回答モデルと指示を確認します。
python -m venv .venv
source .venv/bin/activate
pip install llama-index llama-index-llms-ollama llama-index-embeddings-huggingface llama-index-readers-file
ollama pull llama3.1
mkdir -p datafrom llama_index.core import Settings, SimpleDirectoryReader, VectorStoreIndex
from llama_index.core.node_parser import SentenceSplitter
from llama_index.embeddings.huggingface import HuggingFaceEmbedding
from llama_index.llms.ollama import Ollama
Settings.llm = Ollama(model="llama3.1", request_timeout=360.0)
Settings.embed_model = HuggingFaceEmbedding(model_name="BAAI/bge-m3")
Settings.text_splitter = SentenceSplitter(chunk_size=700, chunk_overlap=100)
documents = SimpleDirectoryReader(
input_dir="data", required_exts=[".pdf"]
).load_data()
if not documents:
raise RuntimeError("No PDF was loaded from data/")
# Check this text against the source PDF before indexing it.
print("Extracted text preview:\n", documents[0].text[:1000])
index = VectorStoreIndex.from_documents(documents)
index.storage_context.persist(persist_dir="storage")
question = "입사 6개월 차 직원도 여름휴가를 쓸 수 있나요?"
response = index.as_query_engine(similarity_top_k=3).query(question)
print("\nAnswer:\n", response)
print("\nRetrieved evidence:")
for source in response.source_nodes:
print("-", source.node.get_content()[:600])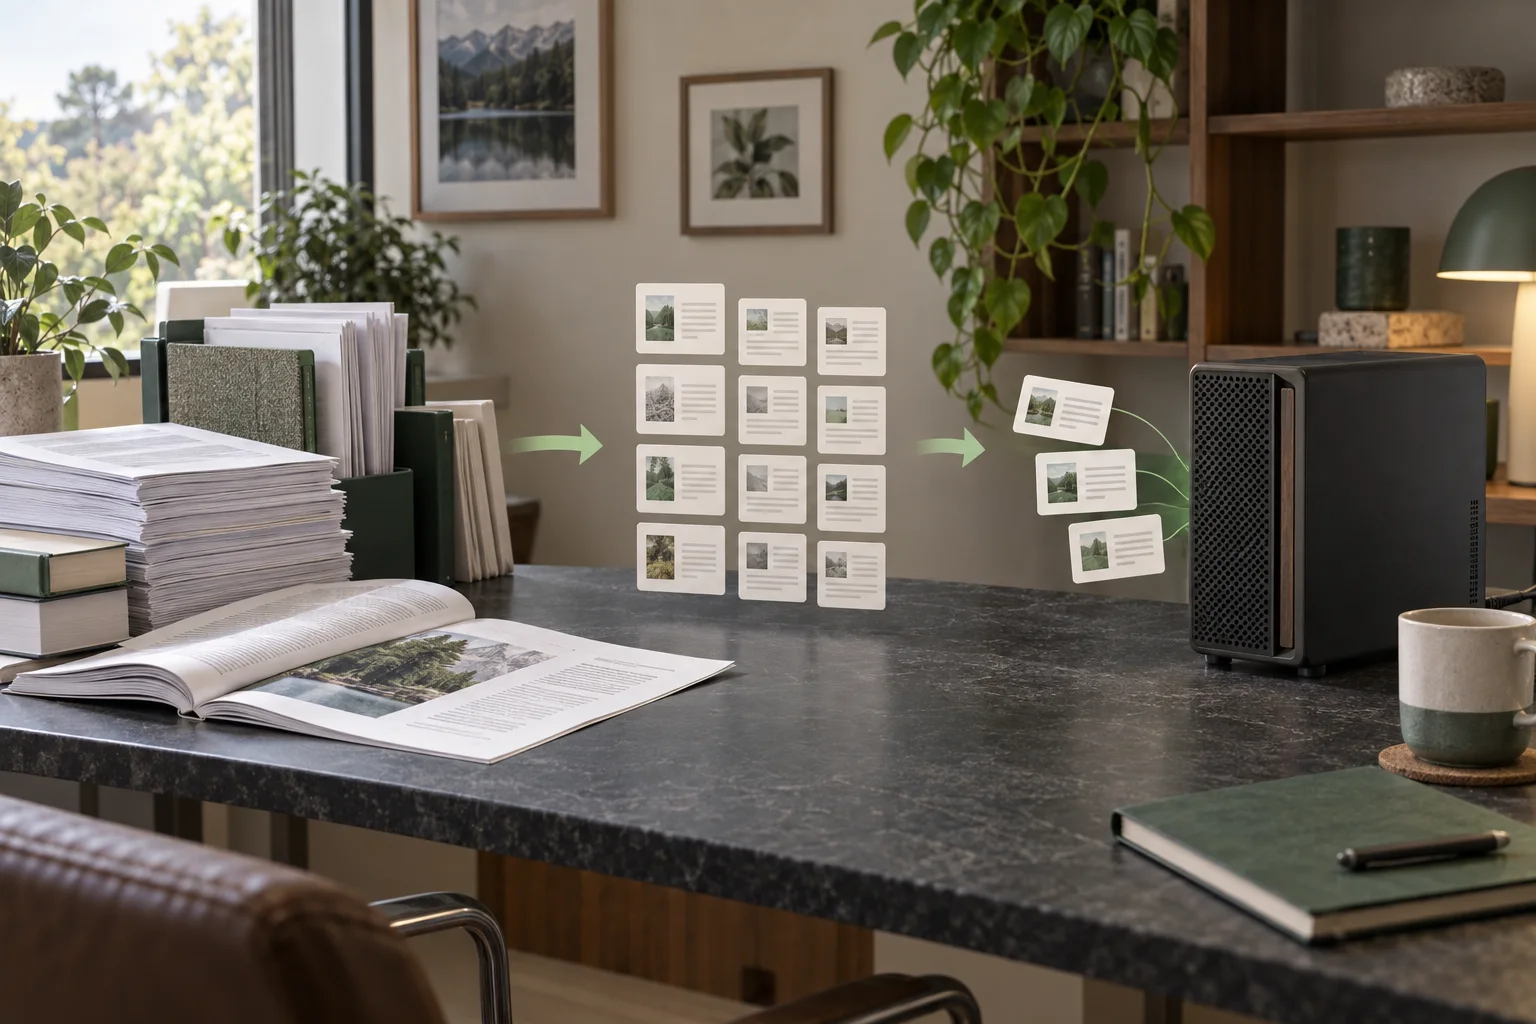
PDFの文章が欠落していないか確認してからチャンクを決めます
休暇規程に表がある、またはPDFが二段組みなら、まず1ページを抽出して原文と照合してください。「6か月以上」のような条件が欠けていたり、表の項目順が入れ替わっていたりすると、チャンク設定を変えても検索対象の原文が誤ったままです。見出しや表の項目が正しい順序で抽出されていることを確認してから次へ進みます。
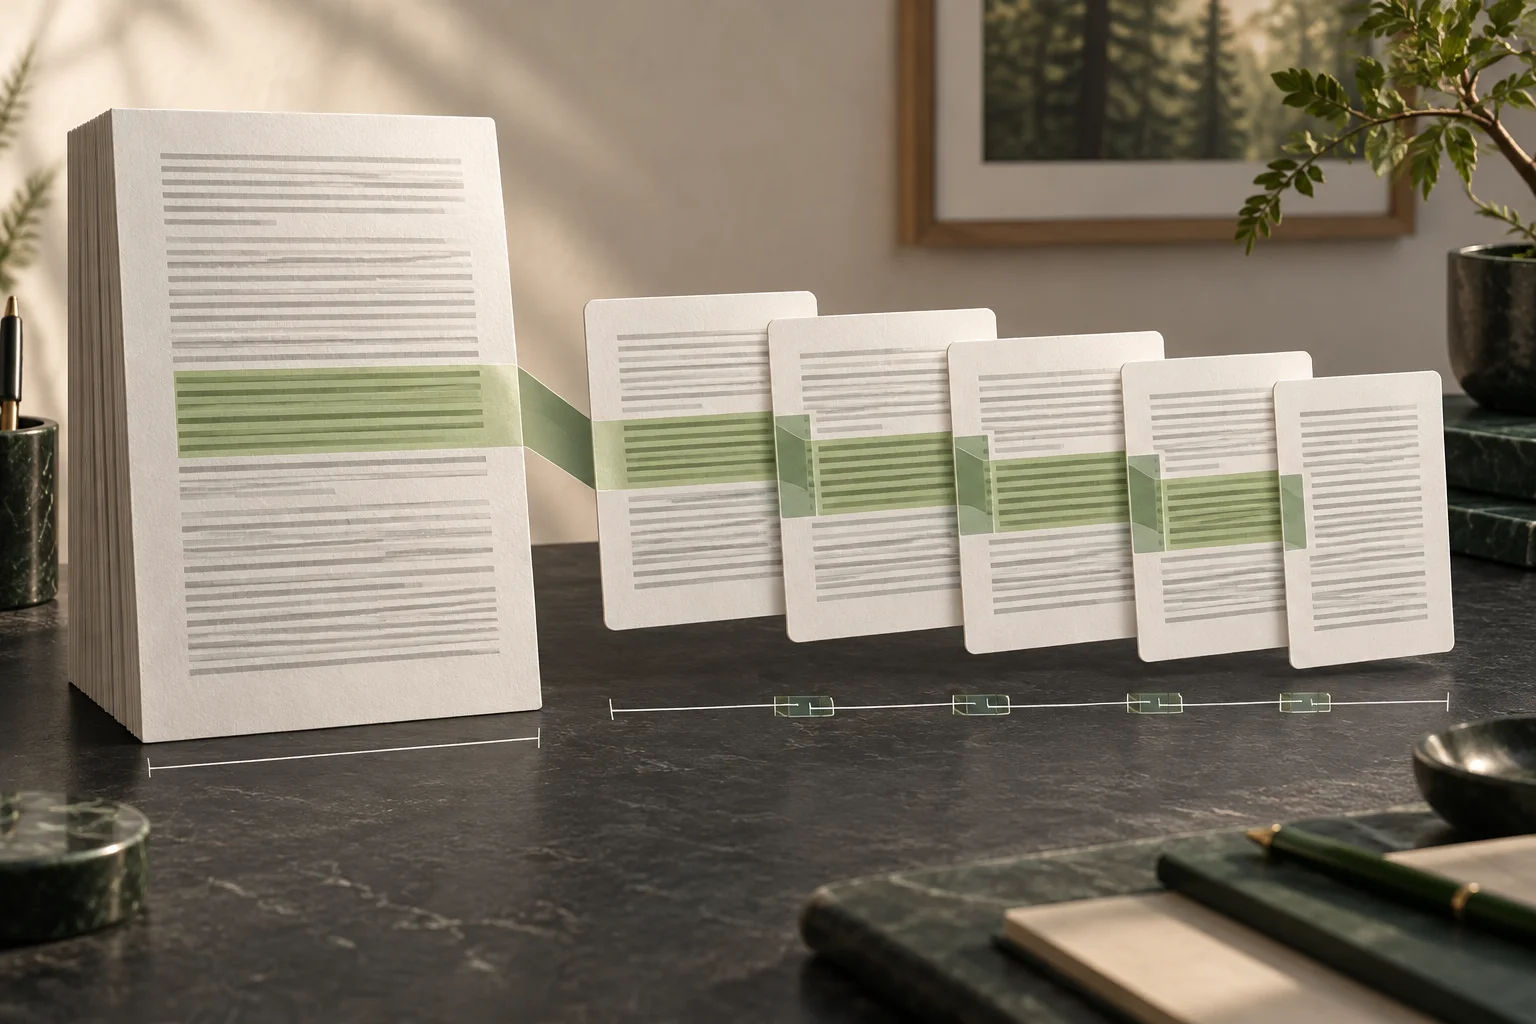
上の例では、休暇規程PDFを700トークンずつに分け、100トークン重ねます。そのため各チャンクは、前のチャンクの開始位置から600トークン後に始まります。重なりを設けると、ページや段落の境界で「勤続6か月以上」のような条件と結論が別々のチャンクに分かれるのを防ぎやすくなります。ただし、重なりが大きいほど同じ文が複数のチャンクに繰り返し含まれます。まずこの設定で検索された根拠を確認し、必要な場合だけ調整してください。PDFの実際のトークン数とチャンク数は文書によって異なるため、ここでは仮の文書量やベクトル保存容量を計算しません。
回答に必要な断片だけを渡し、待ち時間を区間ごとに測ります
休暇に関する質問に答えるために、規程全体をモデルへ渡す必要はありません。上位の検索結果に「夏季休暇」や「勤続期間」などの条件が含まれているか確認し、回答に必要な断片だけを渡します。検索結果は正しいのに最初のトークンが遅い場合、モデルが根拠を読むプリフィル5に時間がかかっている可能性があります。最初のトークンの後も回答の生成が遅ければ、生成速度を別に確認します。検索結果が出るまでに時間がかかる場合は、インデックス、フィルター、ストレージを確認します。
一人で使う場合は、まず回答モデルがメモリに収まるかを確認し、実際に渡す根拠の長さで最初のトークンが出るまでの時間を測ります。複数人が同時に質問すると、リクエストごとにKVキャッシュ6の使用量と待ち行列が増えます。その場合、モデルがメモリに収まるだけでは不十分で、サービングエンジンが同時リクエストをどう処理するかも確認します。文書数と同時利用者数を計算ツールに入力すると、チャンク数、予想保存量、ハードウェアのボトルネックを見積もれます。
20個の質問で検索結果と回答を一緒に確認します
休暇規程から、答えがそのまま書かれている質問、表の例外規定を探す必要がある質問、文書に答えがない質問を混ぜて20個作ります。各質問の横に期待する回答と、必ず検索されるべき文、または「根拠なし」と記録します。実行ごとに、質問、抽出テキスト、上位の検索結果、最終回答、最初のトークンまでの時間、全体の応答時間を同じ行に保存します。これで誤答が原文の欠落、検索失敗、モデルの判断のどこから来たのか追跡できます。
最初の結果が悪ければ、まず原文の抽出を確認します。その後、チャンクサイズまたは重なり、埋め込み、回答モデルの順に、一度に一つだけ設定を変えてください。同じ20問を再実行し、どの段階が変わったかを比較します。質問セットを通過した後で文書数と利用者数を増やすと、現在のハードウェアのどこが実際の制約になるかが分かります。一人で数百〜数千件の文書を検索するなら、ベクトルストアを拡張する前に回答モデルのメモリ使用量と根拠を読む時間を測ってください。
用語の注釈
検索拡張生成 — 質問に関連する資料を検索してモデル入力に加え、回答を生成する方式です。検索範囲や資料の品質は実装によって異なります。
本文に戻る大規模言語モデル — 大量のテキストデータで学習し、テキストを処理・生成する言語モデルです。機能や対応入力はモデルごとに異なります。
本文に戻るトークン — モデルが入力や出力を分けて処理する単位です。1トークンが1文字や一定の時間に相当するわけではありません。
本文に戻るAPI — 別のコードからプログラムの機能を呼び出すための決められたインターフェースです。APIという言葉だけで外部サーバーへの送信を意味するわけではありません。
本文に戻るプリフィル — LLMが入力プロンプトを読み、各トークンの内部表現を計算する段階です。プロンプトが長いほど処理するトークンが増えます。
本文に戻るKVキャッシュ — 過去トークンのAttention用キー・バリューを保存し、後続トークン生成で再利用するメモリです。容量はコンテキスト長やバッチサイズで変わります。
本文に戻る