먼저 읽기
로컬 RAG 구축 가이드: 내 문서에 답하는 AI를 만드는 순서
문서를 넣었다고 바로 좋은 답이 나오지는 않습니다
PDF 글자를 먼저 확인하고, 청크를 만들어 질문과 가까운 근거를 검색한 뒤, 해당 조각을 읽은 모델의 답을 검토합니다. 문서량과 동시 사용자 수를 계산하고 실제 근거 길이에서 대기시간도 재세요.
질문 하나로 문서 적재·검색·답변을 구분합니다
예를 들어 사내 휴가 규정 PDF에서 ‘입사 6개월 차 직원도 여름휴가를 쓸 수 있나요?’라는 질문에 답하고 싶다고 해 보겠습니다. RAG1는 PDF에서 글자를 꺼내고, 그 글을 검색할 조각으로 나누고, 질문과 가까운 조각을 골라 LLM2에 전달합니다. LLM은 전달받은 근거를 읽고 답을 씁니다. 문서를 넣는 순간 PDF 전체를 매번 읽는 방식은 아닙니다.
첫 구현에서는 검색된 조각을 답과 함께 화면에 표시하세요. 예를 들어 답은 ‘가능합니다’인데 검색 조각에 입사 6개월 조건이 없다면, 모델이 추측했는지 검색기가 다른 문단을 가져왔는지 바로 확인할 수 있습니다. 검색 조각 자체가 비어 있거나 엉뚱하면 답변 모델을 바꾸기 전에 문서 추출과 검색을 고쳐야 합니다. 조각에 필요한 조건이 모두 있는데 답만 틀리면 그때 프롬프트나 생성 모델을 살펴보면 됩니다.
직접 실행해 보려면 LlamaIndex의 공식 로컬 모델 예제를 따라 Ollama를 답변 모델로, Hugging Face 임베딩을 검색용으로 연결할 수 있습니다. 먼저 휴가 규정 PDF를 data/vacation-policy.pdf로 저장하세요. 아래 코드는 data/ 폴더의 텍스트 PDF를 읽고, 700토큰3 청크와 100토큰 겹침으로 색인을 만든 뒤 같은 휴가 질문을 보냅니다. 설치와 모델 다운로드에는 네트워크가 필요하지만, 이 구성은 Ollama의 로컬 서버와 내려받은 임베딩 모델을 사용하며 호스팅 답변·임베딩 API4를 호출하지 않습니다. llama3.1 기본 모델 파일은 약 4.9GB이며 실행할 때는 모델 가중치와 문맥을 위한 메모리도 필요하므로, 저장공간뿐 아니라 여유 메모리를 확인하세요. 민감한 문서라면 모델을 미리 준비한 다음 네트워크를 끄고 실행되는지 확인하세요.
실행하면 먼저 PDF에서 뽑은 텍스트 일부가 나오고, 그다음 답과 ‘Retrieved evidence’ 아래에 모델이 참고한 문장들이 표시됩니다. 답의 표현은 모델마다 달라도 괜찮지만, 결론은 실제 PDF에 적힌 근속 조건과 맞아야 합니다. 추출 미리보기가 비었거나 문장 순서가 무너지면 색인을 만들기 전에 OCR이나 PDF 추출을 고치세요. 미리보기는 맞는데 근거가 검색되지 않으면 청크와 검색 설정을 조정하고, 근거가 맞는데 답이 다르면 답변 모델과 지시문을 확인합니다.
python -m venv .venv
source .venv/bin/activate
pip install llama-index llama-index-llms-ollama llama-index-embeddings-huggingface llama-index-readers-file
ollama pull llama3.1
mkdir -p datafrom llama_index.core import Settings, SimpleDirectoryReader, VectorStoreIndex
from llama_index.core.node_parser import SentenceSplitter
from llama_index.embeddings.huggingface import HuggingFaceEmbedding
from llama_index.llms.ollama import Ollama
Settings.llm = Ollama(model="llama3.1", request_timeout=360.0)
Settings.embed_model = HuggingFaceEmbedding(model_name="BAAI/bge-m3")
Settings.text_splitter = SentenceSplitter(chunk_size=700, chunk_overlap=100)
documents = SimpleDirectoryReader(
input_dir="data", required_exts=[".pdf"]
).load_data()
if not documents:
raise RuntimeError("No PDF was loaded from data/")
# Check this text against the source PDF before indexing it.
print("Extracted text preview:\n", documents[0].text[:1000])
index = VectorStoreIndex.from_documents(documents)
index.storage_context.persist(persist_dir="storage")
question = "입사 6개월 차 직원도 여름휴가를 쓸 수 있나요?"
response = index.as_query_engine(similarity_top_k=3).query(question)
print("\nAnswer:\n", response)
print("\nRetrieved evidence:")
for source in response.source_nodes:
print("-", source.node.get_content()[:600])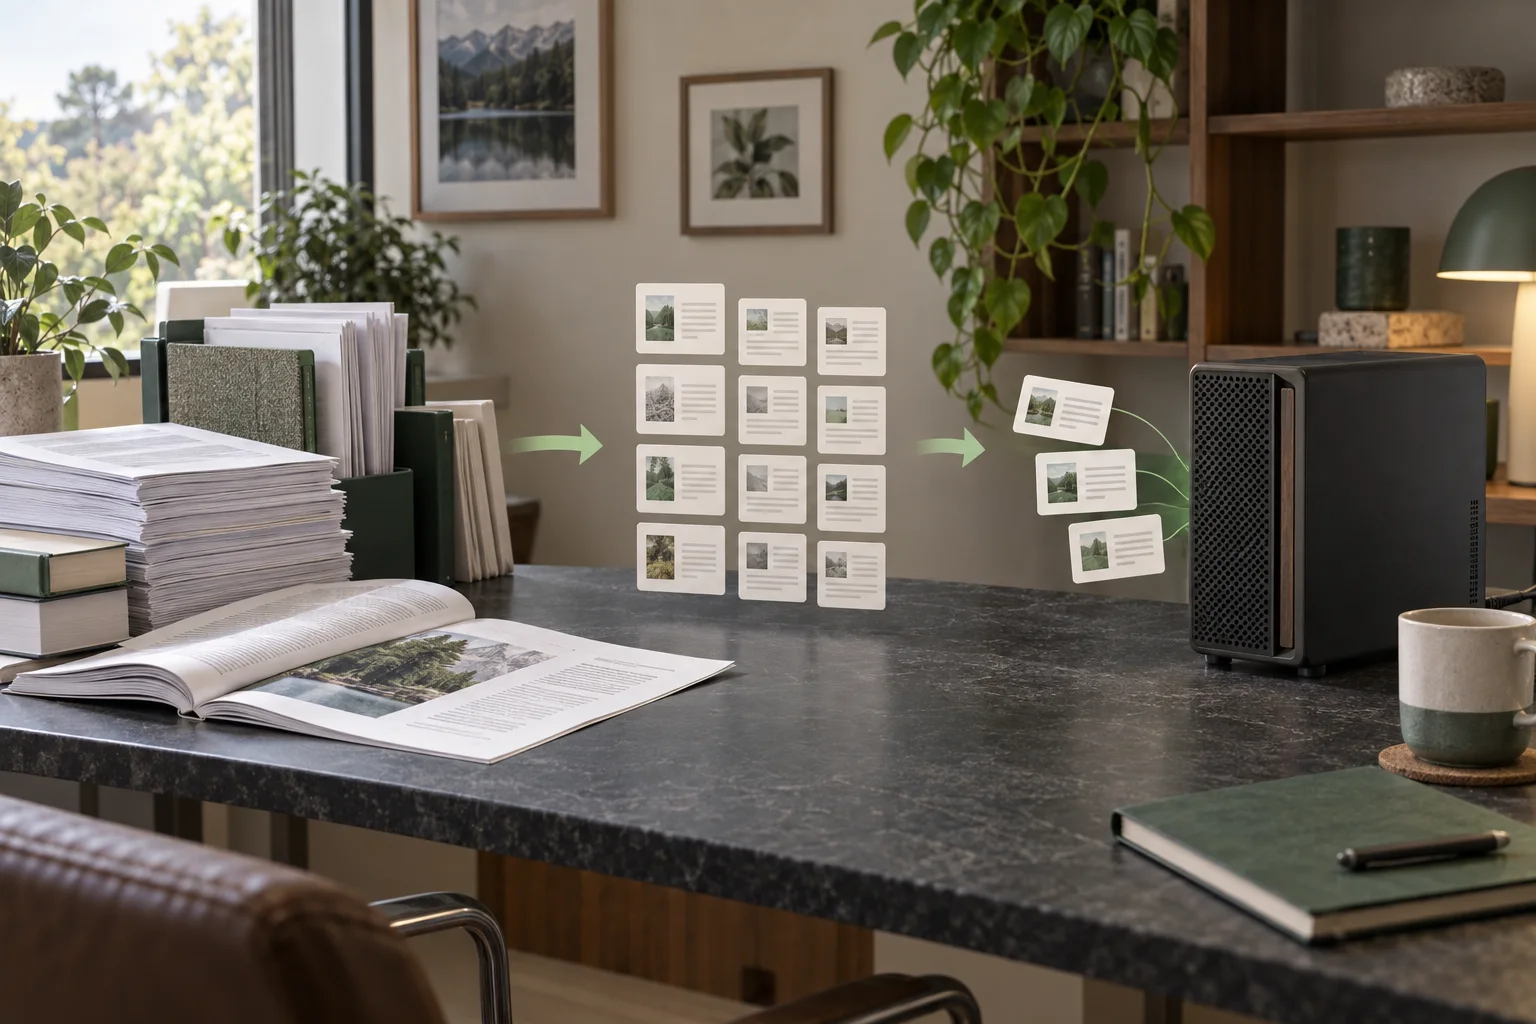
PDF에서 빠진 문장이 없는지 확인한 뒤 청크를 정합니다
휴가 규정이 표나 두 단 편집 PDF라면 먼저 한 페이지를 추출해 원문과 대조하세요. ‘6개월 이상’ 같은 조건이 누락되거나 표의 항목 순서가 뒤섞였으면, 청크 설정을 만져도 검색할 원문부터 잘못된 상태입니다. 추출한 텍스트에 제목과 표의 항목이 읽을 순서대로 남는지 확인한 뒤 다음 단계로 넘어갑니다.
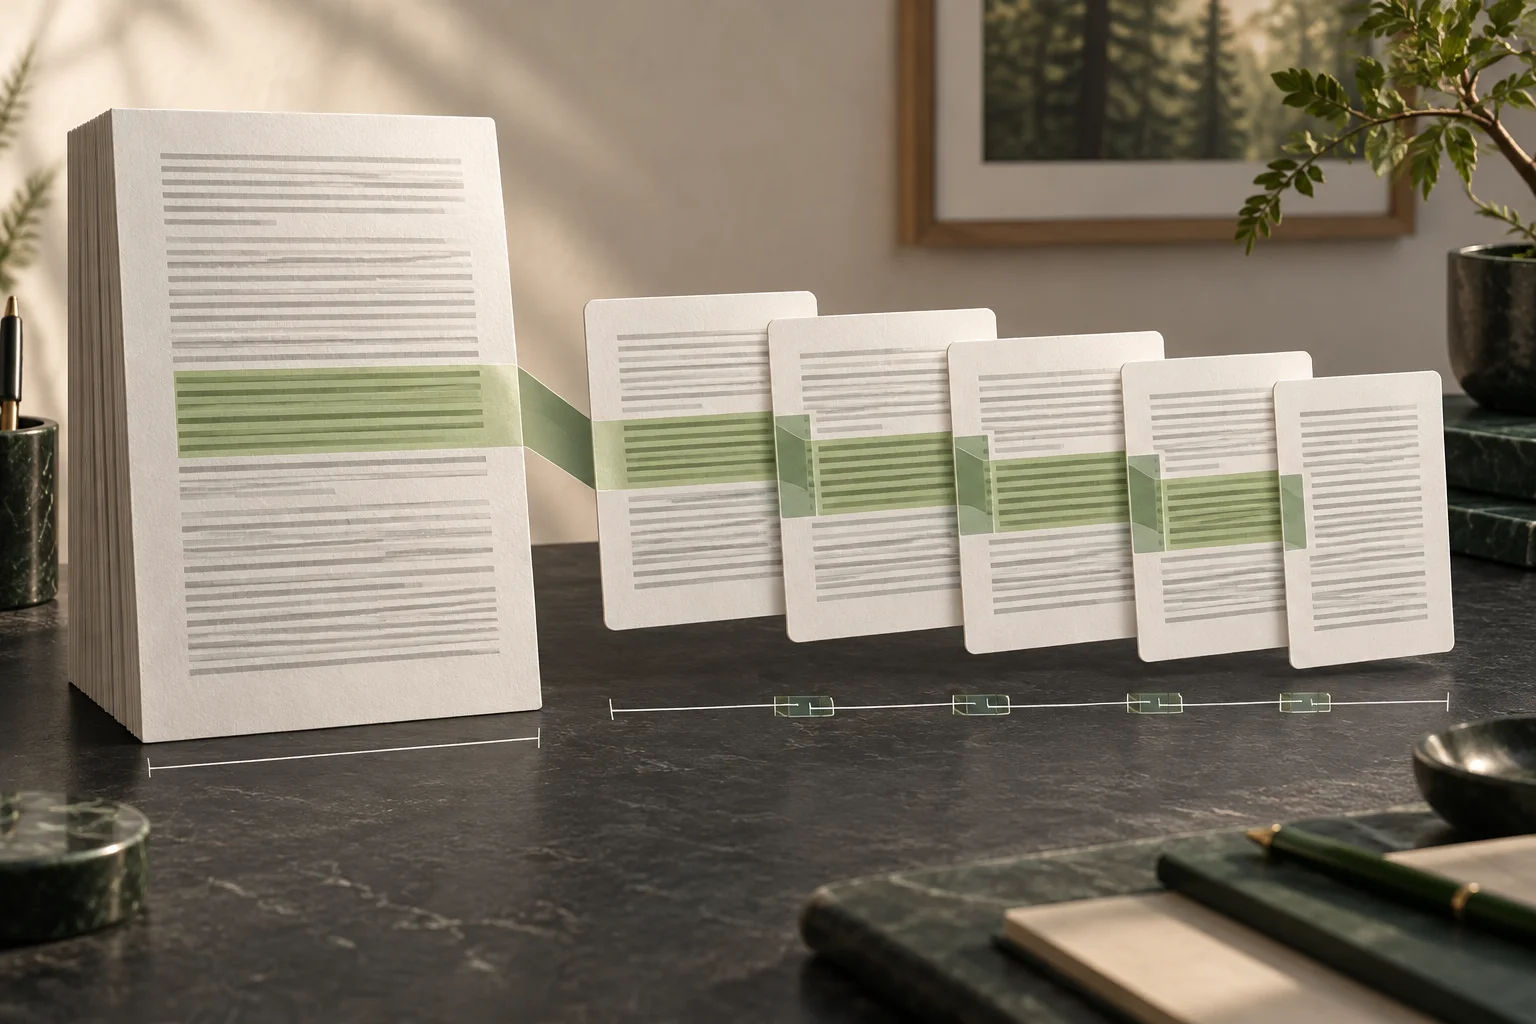
위 실행 예시는 휴가 규정 PDF를 700토큰씩 자르고 100토큰을 겹칩니다. 따라서 다음 조각은 앞 조각이 시작한 곳에서 600토큰 뒤에 시작합니다. 겹침은 페이지나 문단 경계에서 ‘입사 6개월 이상’ 같은 조건과 결론이 서로 다른 조각으로 갈리는 일을 줄여 줍니다. 다만 겹침이 커지면 같은 문장이 여러 조각에 반복되므로, 먼저 이 설정으로 검색된 근거를 확인하고 필요한 경우에만 조정하세요. PDF의 실제 토큰 수와 분할 결과는 문서에 따라 달라지므로, 여기서는 가상의 전체 문서량이나 벡터 저장량을 계산하지 않습니다.
답변에 필요한 조각만 보내고, 대기 구간을 나눠 봅니다
휴가 질문에 답할 때 규정집 전체를 모델에 넣을 필요는 없습니다. 검색된 상위 조각에 ‘여름휴가’, ‘근속 기간’ 같은 조건이 있는지 확인하고, 답에 필요한 조각만 보내세요. 검색은 맞는데 첫 글자가 늦게 나오면 모델이 근거를 읽는 프리필5이 긴 것일 수 있습니다. 첫 글자 뒤 답이 천천히 이어지면 생성 속도를 따로 봅니다. 검색 결과가 나오기까지 오래 걸린다면 색인·필터·저장장치 쪽을 확인합니다.
혼자 쓰는 경우에는 먼저 사용할 답변 모델이 메모리에 들어가는지 확인하고, 실제로 보낼 근거 길이에서 첫 토큰 대기시간을 잽니다. 여러 사람이 동시에 질문하면 각 요청의 KV 캐시6와 대기열이 더해집니다. 이때는 모델이 메모리에 들어간다는 사실만으로 충분하지 않고, 서버가 동시 요청을 어떻게 처리하는지도 살펴야 합니다. 문서 수와 동시 사용자 수를 계산기에 넣으면 청크 수와 예상 저장량, 장비 병목을 가늠할 수 있습니다.
질문 스무 개로 검색 결과와 답변을 함께 검증합니다
휴가 규정에서 답이 바로 나오는 질문, 표의 예외 조항을 찾아야 하는 질문, 문서에 답이 없는 질문을 섞어 20개를 만드세요. 각 질문 옆에 기대 답과 반드시 찾아야 하는 문장 또는 ‘근거 없음’을 적습니다. 실행할 때마다 질문, 추출된 텍스트, 검색 상위 조각, 최종 답, 첫 토큰 시간과 전체 응답 시간을 한 행에 저장합니다. 그래야 틀린 답이 원문 누락인지 검색 실패인지 모델 판단인지 거슬러 갈 수 있습니다.
처음 결과가 나쁘면 원문 추출부터 확인하고, 그다음 청크 크기나 겹침, 임베딩, 답변 모델 순으로 한 번에 하나만 바꾸세요. 같은 20개 질문으로 다시 실행해 어느 단계가 바뀌었는지 비교합니다. 질문 세트가 통과한 뒤 문서와 사용자를 늘리면 현재 장비에서 실제로 막히는 단계가 보입니다. 혼자 수백~수천 문서를 검색한다면 벡터 저장소를 먼저 키우기보다 답변 모델의 메모리와 근거를 읽는 시간을 측정하세요.
용어 각주
검색 증강 생성 — 질문과 관련된 자료를 검색해 모델 입력에 보태고 답변을 생성하는 방식입니다. 검색 범위와 자료 품질은 구현에 따라 다릅니다.
본문으로 돌아가기대규모 언어 모델 — 대량의 텍스트 데이터로 학습해 텍스트를 처리하고 생성하는 언어 모델입니다. 기능과 지원 입력은 모델마다 다릅니다.
본문으로 돌아가기토큰 — 모델이 입력이나 출력을 나누어 처리하는 단위입니다. 토큰 하나가 글자 하나나 일정한 시간 길이에 해당하지는 않습니다.
본문으로 돌아가기API — 프로그램의 기능을 다른 코드에서 호출하기 위한 약속된 인터페이스입니다. API라는 말만으로 외부 서버 전송을 뜻하지는 않습니다.
본문으로 돌아가기프리필 — LLM이 입력 프롬프트를 읽고 각 토큰의 내부 표현을 계산하는 단계입니다. 입력이 길수록 처리할 토큰이 많아집니다.
본문으로 돌아가기KV 캐시 — 어텐션에서 이전 토큰의 키·값을 저장해 다음 토큰 생성 때 재사용하는 메모리입니다. 문맥 길이와 배치 크기에 따라 용량이 달라집니다.
본문으로 돌아가기