
実行プログラムと拡張機能
最終更新
DGX Sparkを2台つなぐと、実際に何が変わるのか
DGX Spark 2台でメモリと同時処理の余裕が増えます
DGX Sparkを2台使うと、大きなモデルを分割して実行したり、それぞれが別のリクエストを処理したりできます。使いたいモデルが1台に収まるか、同時に何人が使うかによって適した構成が変わります。
1台のメモリが足りなければモデルの分割を、複数の利用者からのリクエストで待ち行列が長くなるならモデルの複製を検討します。2つの方法では、機器に任せる仕事が異なります。実行プログラムがどの構成に対応しているかを確認し、解決したい問題に合わせて性能を比較しましょう。
2台目が必要な理由を切り分ける
1台の空きメモリに重みと会話中に蓄積するKVキャッシュ1が収まらない場合、対応ランタイム2でモデルを2ノードに分割できます。最初の利点は、一つのノードには収まらないモデルを実行できることであり、回答生成の高速化とは限りません。
各Sparkの公称メモリは128GBで、2台では合計256GBです。ただしアプリから単一の256GBデバイスに見えるわけではありません。ランタイムが重みとキャッシュを分配し、ノード間で結果をやり取りする必要があります。特定の構成要素や作業領域が一方に偏れば、合計容量が残っていてもそのノードが先に上限に達します。実行中はノードごとの使用量と配置を確認してください。
モデルが 1 台に収まるなら、まず 2 台目で実現したいことを決めます。一つの回答生成を 2 ノードに分割するのか、モデルを複製して複数のリクエストを処理するのかで構成が変わります。
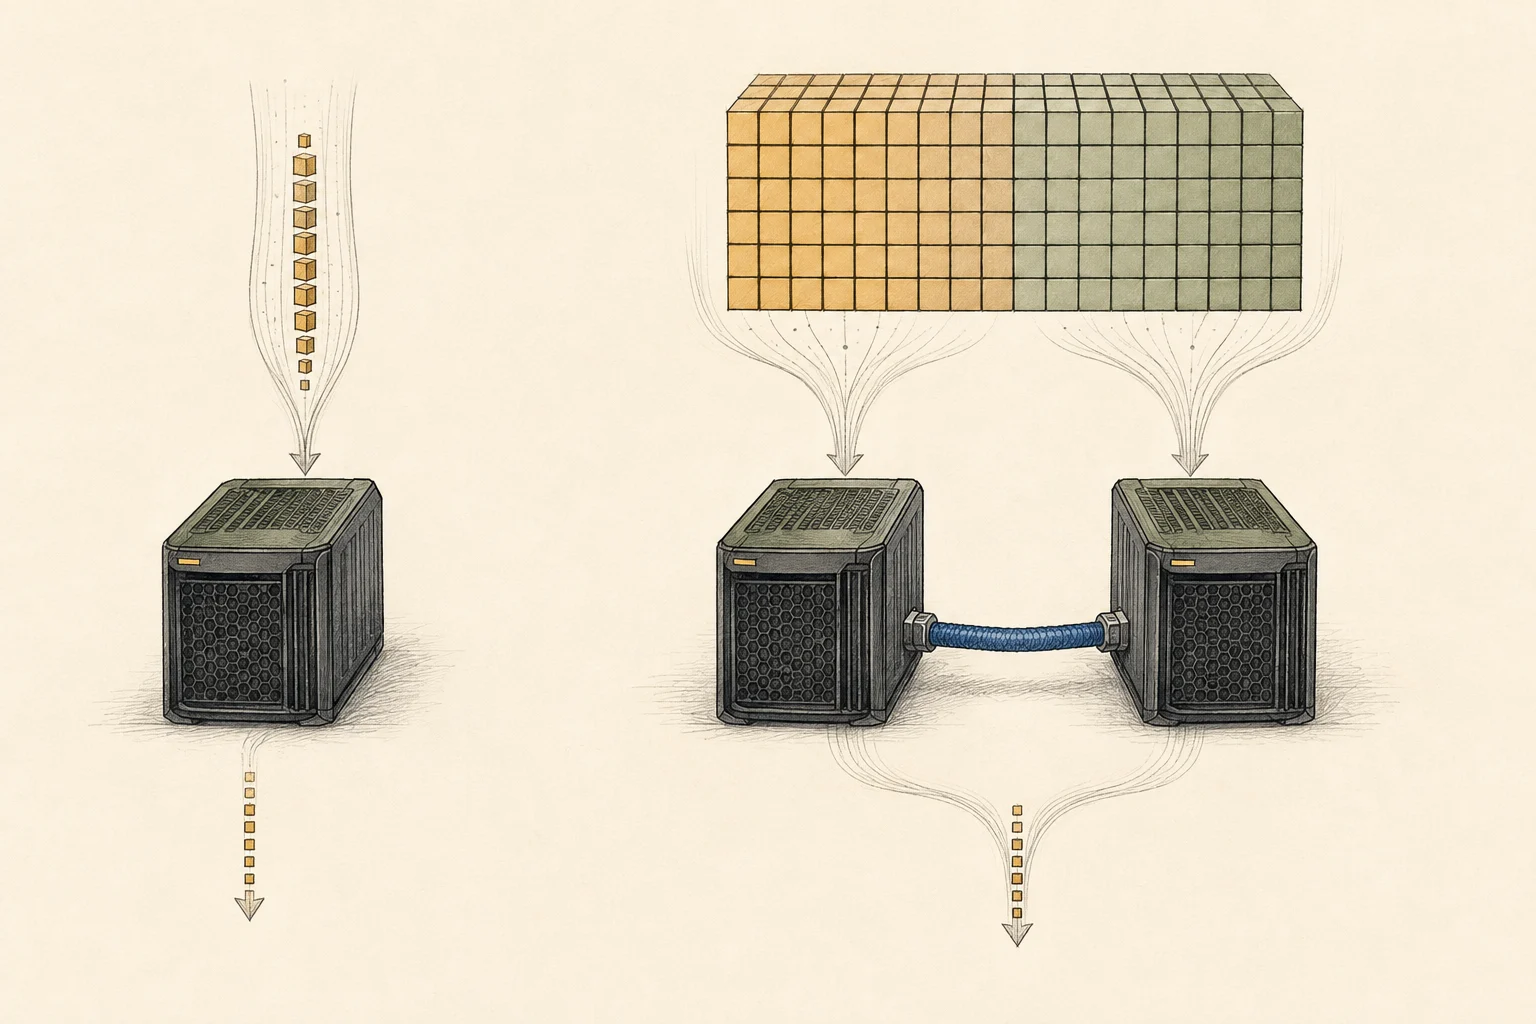
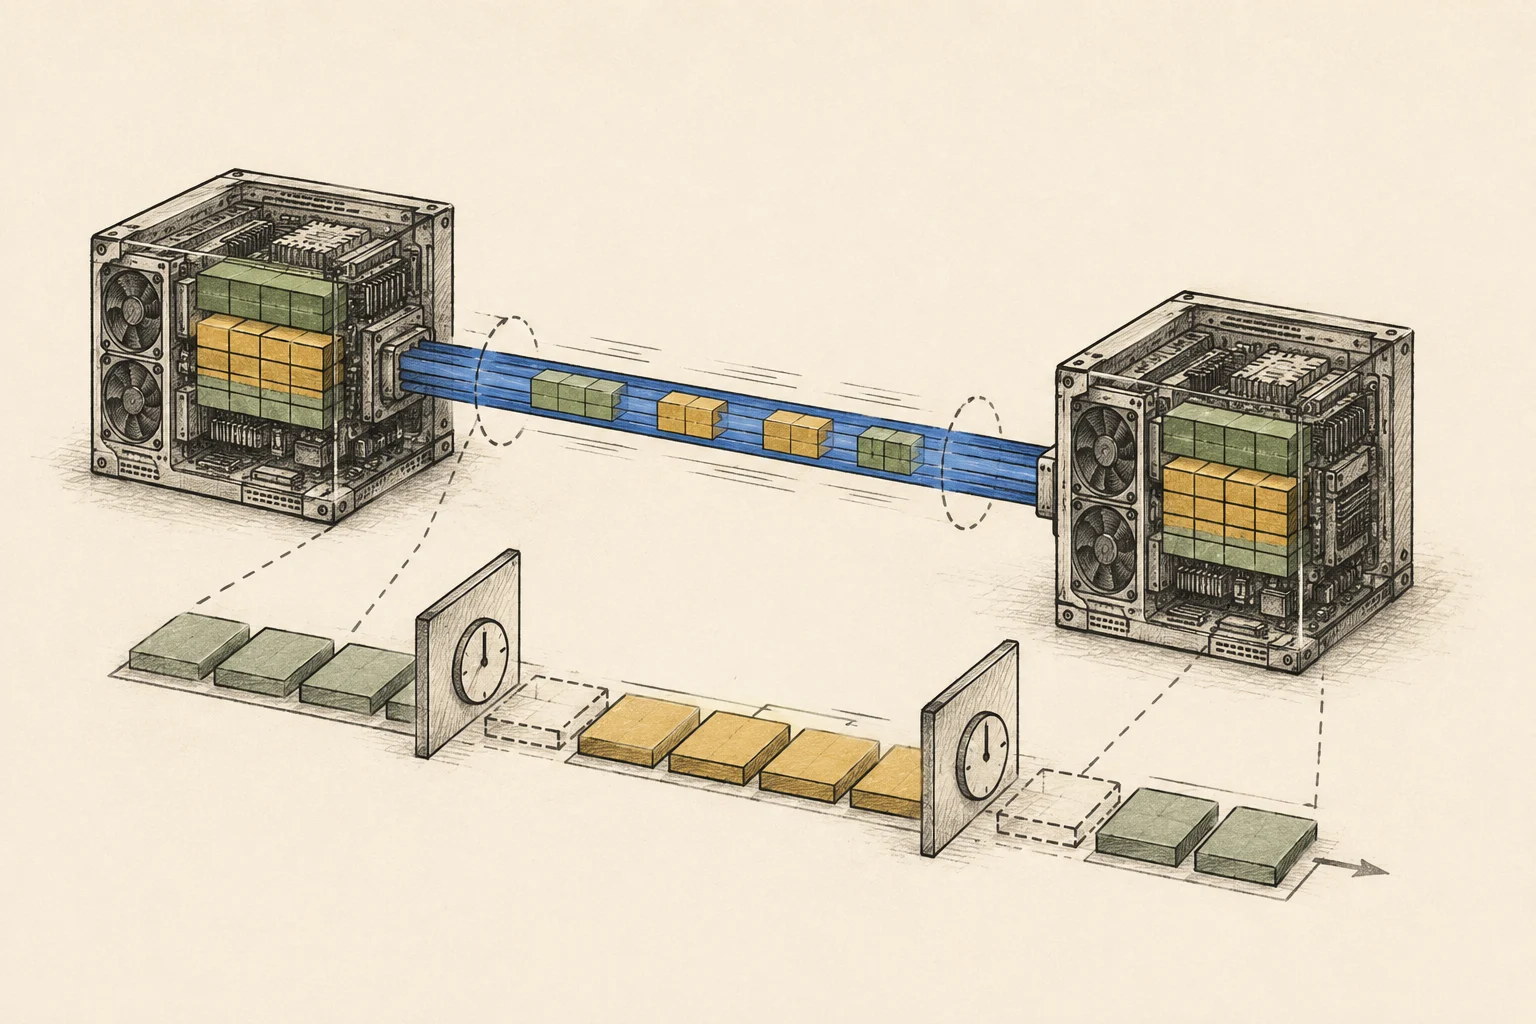
一つの回答の分割では計算とともに通信も増える
構成差を見るために比較条件を揃える
「2台のほうが速かった」という結果を見るときは、モデルファイル・量子化6・ランタイムのバージョン・MTP7設定・入力長・同時リクエスト数が同じか確認します。2台構成だけ量子化やMTPが異なる場合、実際の購入構成の比較には役立ちますが、1台追加した効果だけを分離した結果ではありません。
比較は2段階に分けます。まず共通設定でノード数とモデル分割の差を見てから、各システムで実用する最適設定を適用します。モデルファイルと形式、入出力条件、最初のトークンまでの時間、完了時刻を記録し、一方だけが使えるオプションは構成差として明記します。
SparkのARM64環境に合うパッケージ、対応するQSFPケーブル、ノード間通信設定、分割実行経路をプログラムが認識していることも確認します。これらが未確認だと、非対応の実行状態と2ノード通信そのもののコストを混同する可能性があります。
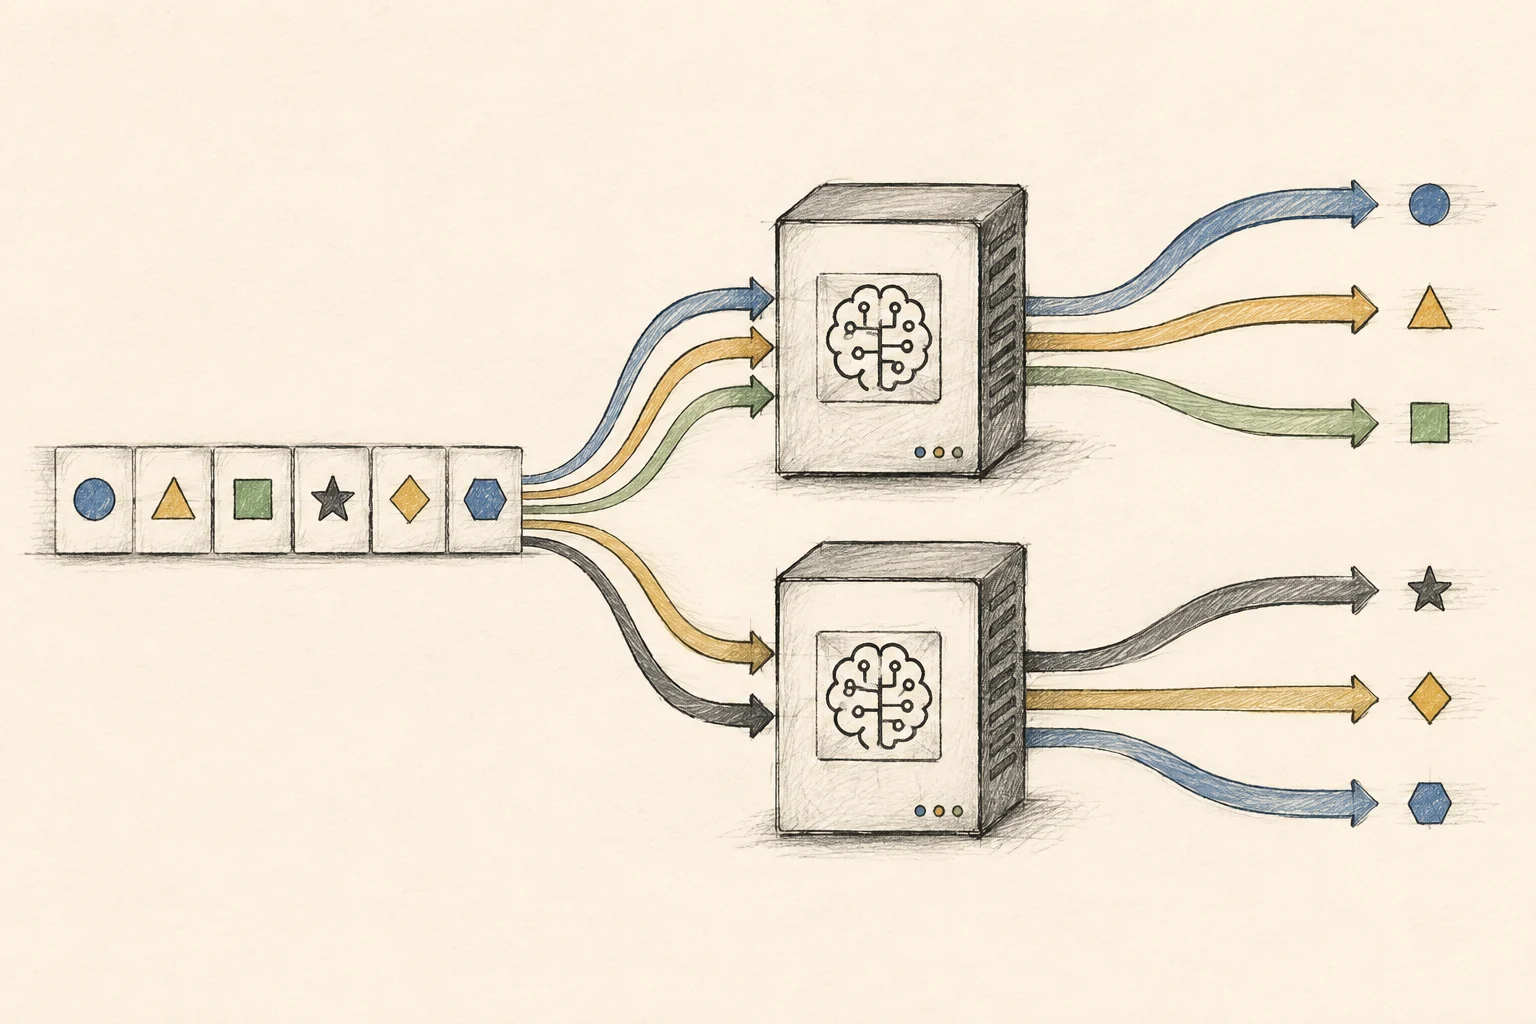
複数リクエストでは複製と分割の違いが重要
モデルが1台に収まるなら、各ノードに同じモデルの複製を配置できます。スケジューラーがリクエストAを一方、Bをもう一方に送れば、異なるユーザーを同時に処理できる可能性があります。この場合は一つの回答速度だけでなく、一定時間内に完了したリクエスト数や待ち行列も重要です。
一方、リクエストAを2ノードに分割する構成では、両方のノードがAを一緒に処理します。別のリクエストBが空いているノードに自動で独立割当されるとは限りません。1台に収まらないモデルを分割する方法と、モデルを複製してリクエストを分配する方法は、異なる課題を解決します。
最初のトークンまでの時間・生成速度・複数リクエストのスループット8は別の指標です。総処理量が増えても、個別リクエストや最も長く待つユーザーの応答は遅い場合があります。単一リクエストの比較は同時負荷テストの代わりにはなりません。
2台目に任せる仕事を先に決める
1台に必要なモデルとキャッシュが収まらないなら、2台目のSparkで実行範囲を広げられることがあります。必要なモデルが1台で問題なく動き、一人で使う待ち時間も許容できるなら、接続・管理の負担に見合う仕事があるか検討します。実際のリクエスト待ちや、より大きなモデルが必要な状況が具体的な根拠になります。
ボトルネックが起きる段階を診断します。読み込みに失敗するならメモリ配置と対応経路を確認します。モデル読み込み後に長い入力や同時リクエストで待ち時間が長いなら、分割・複製・リクエストスケジューリングのどの機能が使えるかを調べます。そのうえで目標モデルとランタイムを決めて直接比較します。
元の比較ツールはQwen3.8 27Bと4K入力でSpark 1台と2台の想定体感を示します。推奨形式やアクセラレーションは機器によって異なり、同時負荷テストではありません。prefillを含めるか切り替えて一人の待ち時間を見て、購入前に目標構成を実測します。
用語の注釈
KVキャッシュ — 過去トークンのAttention用キー・バリューを保存し、後続トークン生成で再利用するメモリです。容量はコンテキスト長やバッチサイズで変わります。
本文に戻るランタイム — プログラムの実行時に必要な機能を提供するソフトウェア環境です。ローカルAIではモデル実行エンジンを指すこともあります。
本文に戻るプリフィル — LLMが入力プロンプトを読み、各トークンの内部表現を計算する段階です。プロンプトが長いほど処理するトークンが増えます。
本文に戻るトークン — モデルが入力や出力を分けて処理する単位です。
本文に戻るトークンのデコード — 入力とそれまでの回答をもとに、次の出力トークンを順に生成する段階です。
本文に戻る量子化 — モデルの重みや計算値を少ないビット数で表し、保存容量やメモリ使用量を減らす方法です。表現が粗くなるため、精度にも影響することがあります。
本文に戻るMTP — 複数の将来トークンを一度に予測する学習目標、またはそれを行うモデル構成です。投機的デコーディングでは、その予測を候補トークンとして提案できます。
本文に戻るスループット — 一定時間に処理・生成した作業量です。トークン/秒やリクエスト/秒など、単位を合わせて比較します。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- DGX Sparkを2台使うと、大きなモデルを分割して実行したり、それぞれが別のリクエストを処理したりできます。使いたいモデルが1台に収まるか、同時に何人が使うかによって適した構成が変わります。
- 必要なメモリはどのくらいですか?
- 各Sparkの公称メモリは128GBで、2台では合計256GBです。ただしアプリから単一の256GBデバイスに見えるわけではありません。ランタイムが重みとキャッシュを分配し、ノード間で結果をやり取りする必要があります。特定の構成要素や作業領域が一方に偏れば、合計容量が残っていてもそのノードが先に上限に達します。実行中はノードごとの使用量と配置を確認してください。