
メモリとモデル
最終更新
35BのMoEが、小さな密モデルより速いことがある理由
35B MoEと27B Denseは、1トークンの計算量が異なります。
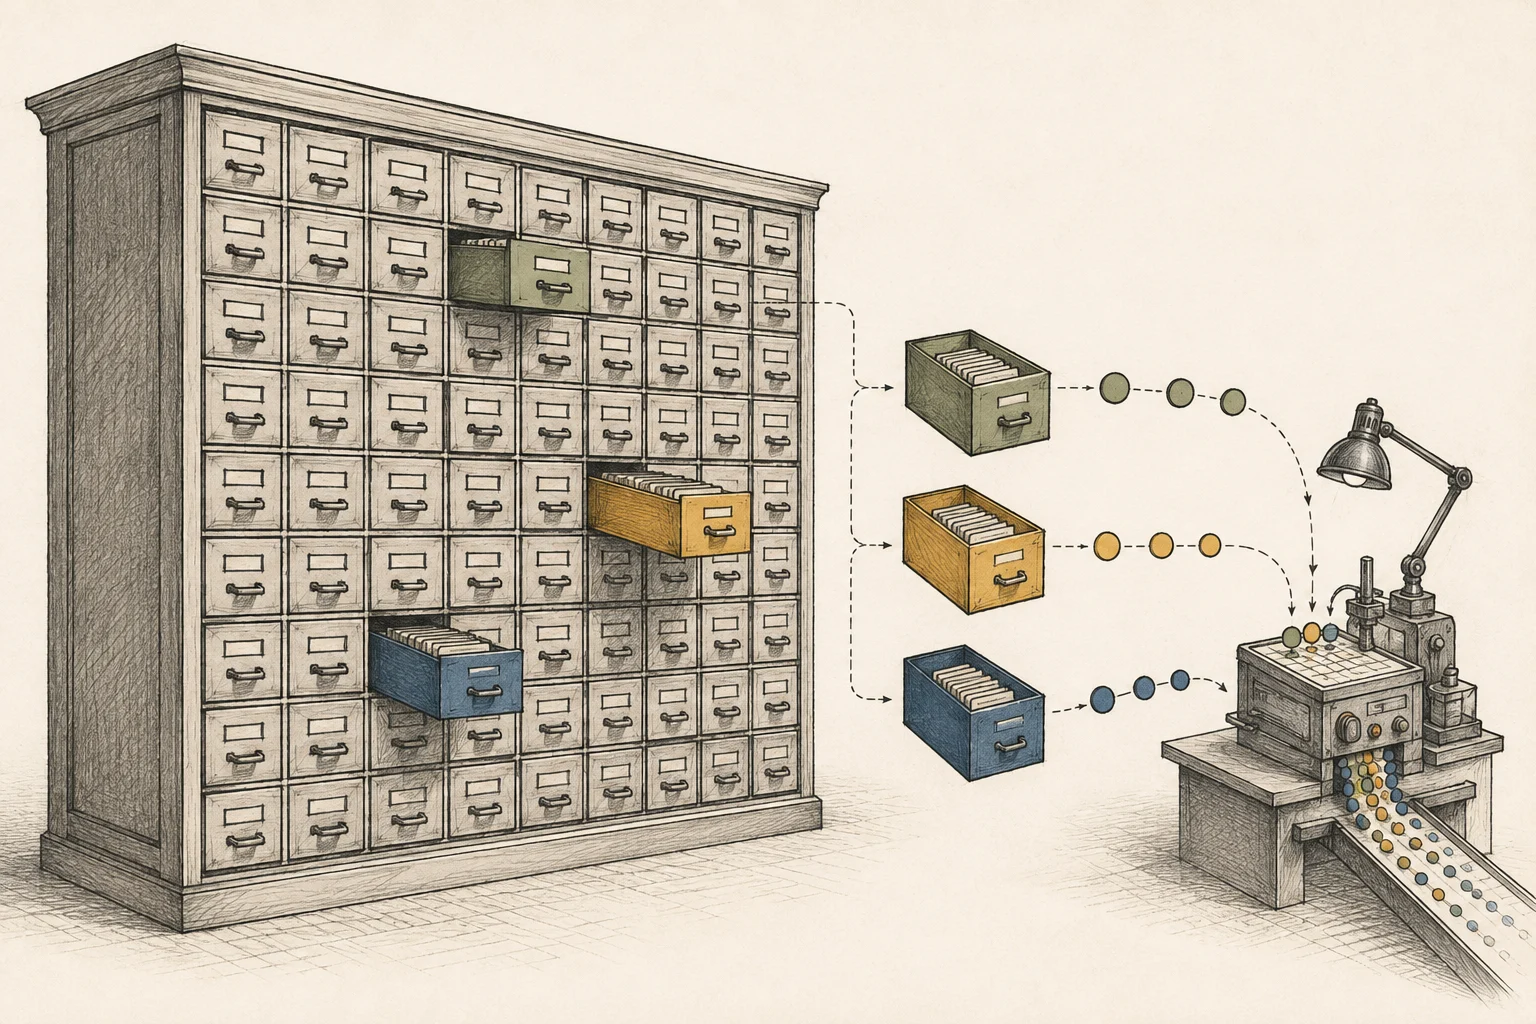
MoE1は複数のエキスパートから一部を選んで計算する構造です。全体35B・アクティブ約3Bのモデルは保存する重みが大きくても、トークン2ごとの計算量を減らせます。この経路を効率よく実行できる機器では、より小さな27B Denseより速く生成する組み合わせもあります。
空文字列でエラーになる関数を修正する場面で、2つのモデルを比べます。同じコードと依頼を送ると、最初の応答とコード生成速度を比較できます。テストを通すまでの時間も加えれば、自分の作業でどちらが有利か判断できます。
MoEは選んだエキスパートの経路だけを計算します。
Denseは新しいトークンを作る際、各層の重みの大部分を使います。MoEはルーターがトークンに合うエキスパートを選び、共有部分と一緒に計算します。全体35Bでもアクティブ約3Bなら、そのトークンには全体の一部が参加します。その結果、大きなモデルの方がトークンごとの計算量が少なくなる場合があります。
実行プログラムが選ばれた重みを素早く供給し、エキスパートの演算を効率よく処理できると、少ない計算量がデコード3速度につながります。ルーティングと不規則なデータアクセスにも時間がかかるため、同じ機器の実行結果を合わせて確認することが重要です。
全体の重みにアクセスできる構成を準備します。
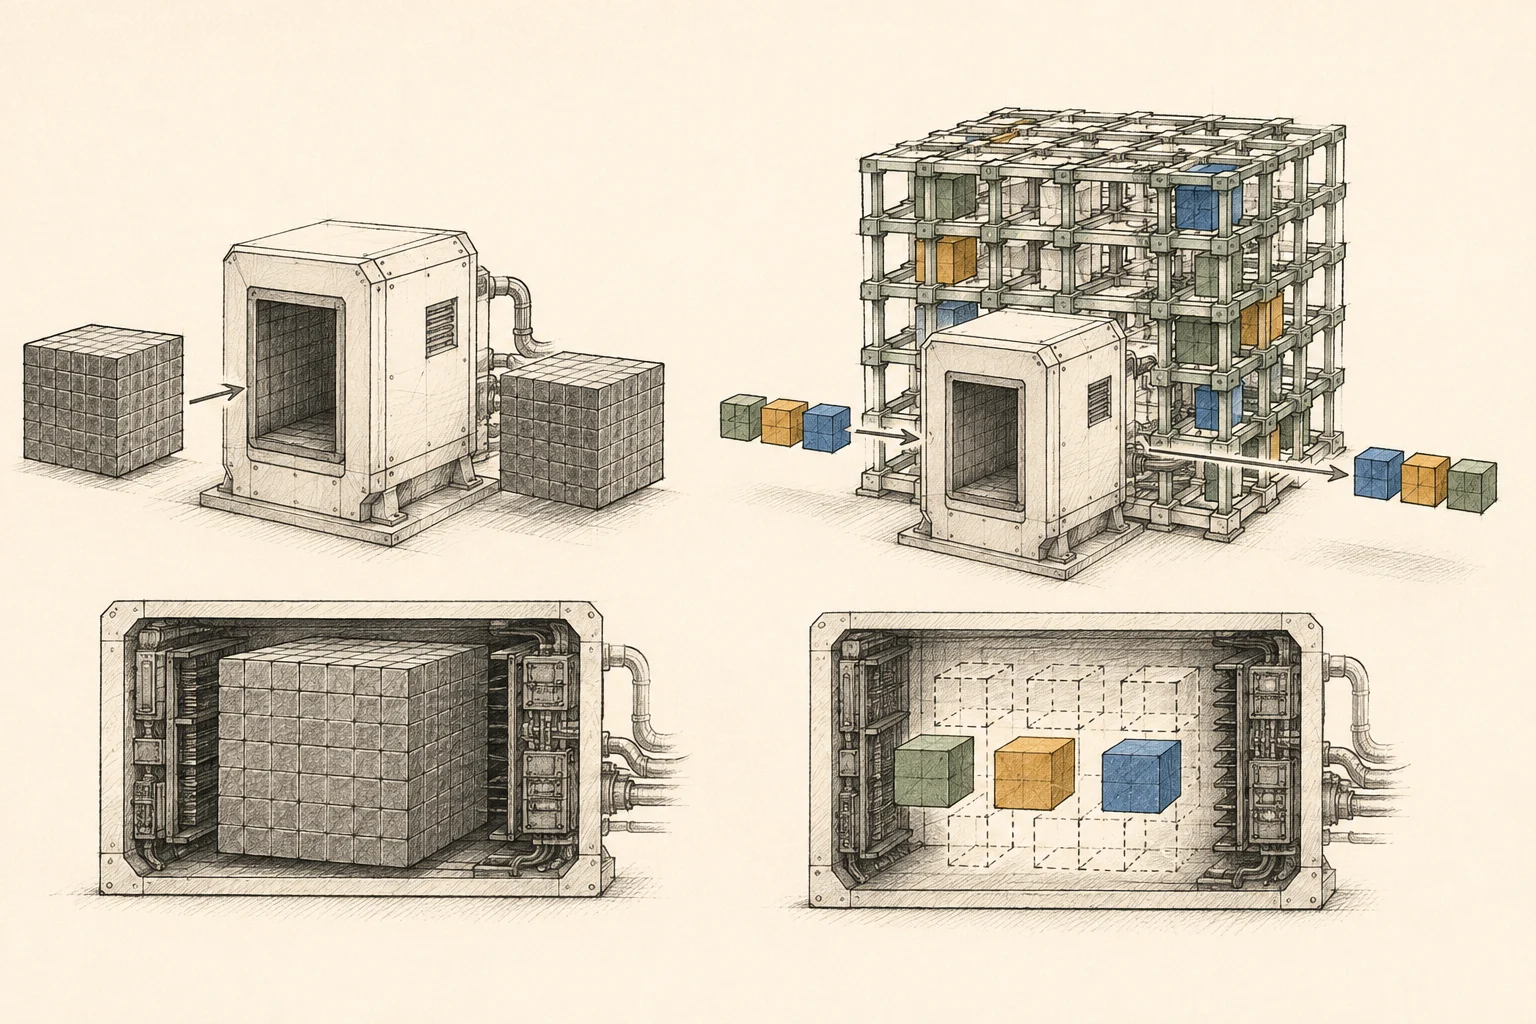
同じコードと入力条件で最初の応答を比較します。
問題の関数、関連する呼び出し元、エラーログを同じように送ります。「戻り値の形式を維持し、空の入力を安全に扱う」と範囲を決めると結果を比べやすくなります。最初のモデルが変更したファイルではなく、同じ基準コミットやコピーから別々に開始し、ログとdiffを分けて保管してください。
モデルファイル、量子化、実行プログラム、思考モード、入力、出力上限、同時リクエスト数を記録します。プリフィル9とデコードを分け、最初のトークン時間と全体の完了時間を記録してください。モデルでトークン分割が異なるため、tok/sと作業完了時間を合わせて比べると役立ちます。
個人のコーディング支援では、まず1件のリクエストで比較します。共同サーバーでは、別途同時リクエストを試します。入力によって別のエキスパートが選ばれ、メモリアクセスとスケジューリングも変わります。全体処理量に加えて各利用者の遅延も記録してください。
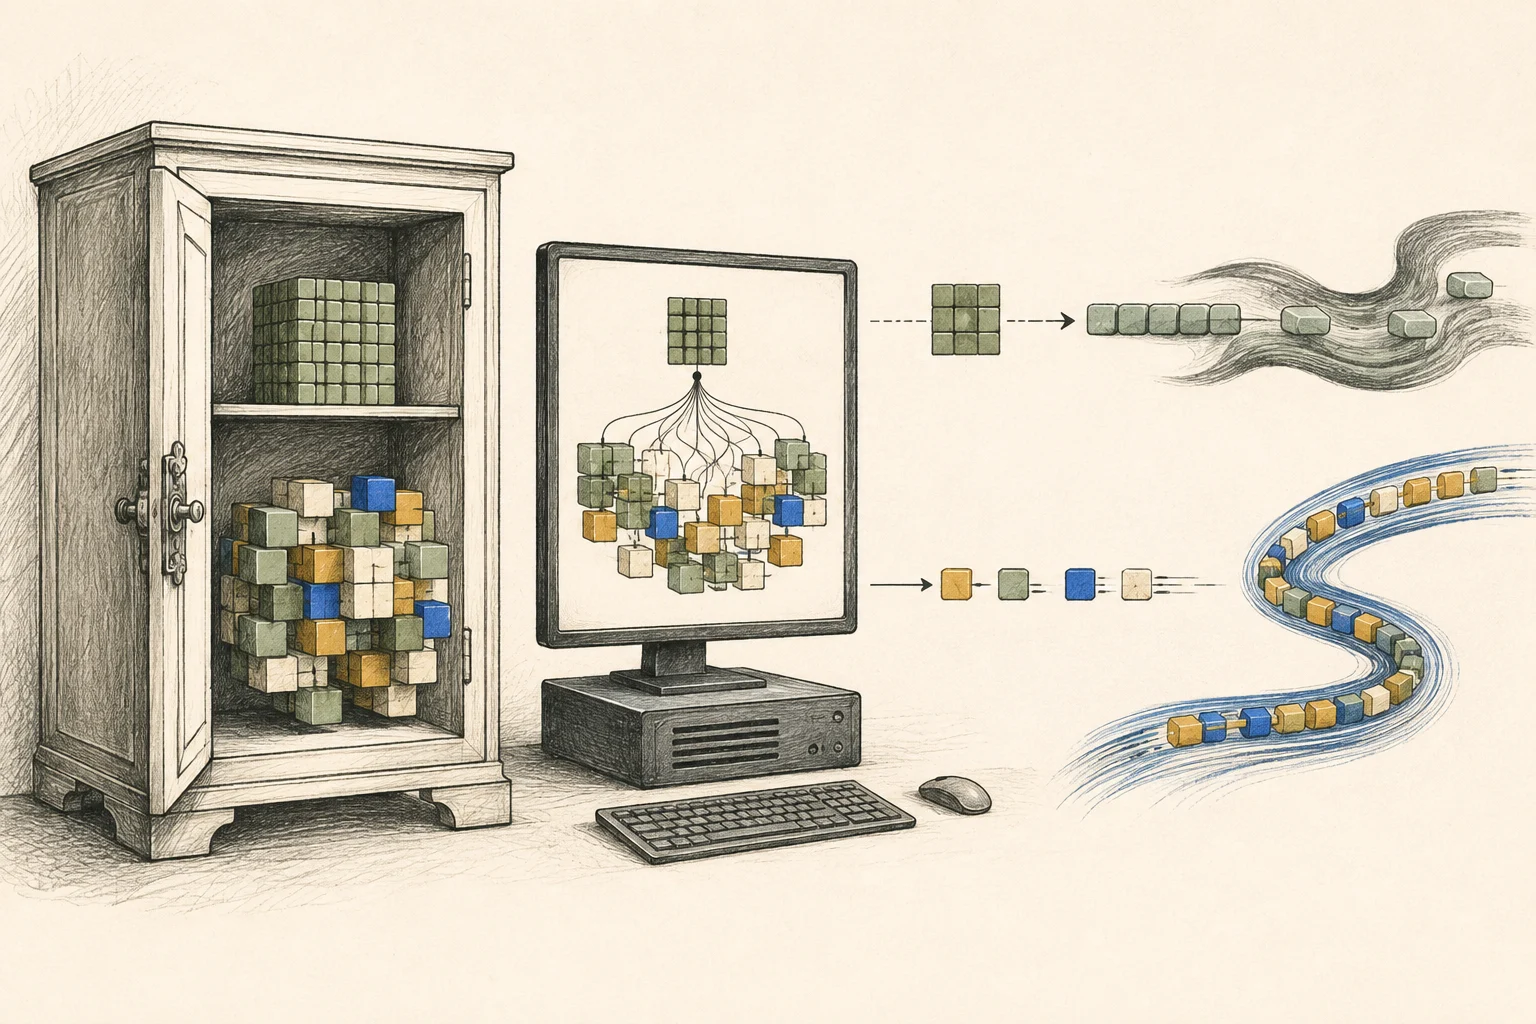
修正がテストを通すまでの時間を記録します。
空入力と通常入力、既存の呼び出し元をテストします。戻り値の形式が維持され、エラーが解決したか確認してください。失敗したら同じモデルにログを送り、修正したdiffを確認して再テストします。その時間まで含めると、実際に作業が速くなったか判断できます。
サイトの比較画面では、機器と入力長を保ちながら35B MoEと27B Denseを切り替えられます。モデルごとに推奨形式と高速化が異なるため、実際に使う構成を検討するために利用します。キャッシュの余裕を残して収まり、自分のコードで必要な修正ができる候補から選びましょう。
用語の注釈
MoE — 複数の専門家サブネットワークから入力に応じて一部を選ぶモデル構造です。総パラメータ数と1トークン処理時に有効な数は異なることがあります。
本文に戻るトークン — モデルが入力や出力を分けて処理する単位です。
本文に戻るトークンのデコード — 入力とそれまでの回答をもとに、次の出力トークンを順に生成する段階です。
本文に戻る量子化 — モデルの重みや計算値を少ないビット数で表し、保存容量やメモリ使用量を減らす方法です。表現が粗くなるため、精度にも影響することがあります。
本文に戻るKVキャッシュ — 過去トークンのAttention用キー・バリューを保存し、後続トークン生成で再利用するメモリです。容量はコンテキスト長やバッチサイズで変わります。
本文に戻るVRAM — グラフィックカードのGPUが使うメモリです。モデルの重みや計算途中の値を保存します。
本文に戻るシステムRAM — プログラムの実行中にデータを一時保存するシステムメモリです。
本文に戻るオフロード — 容量が足りないとき、モデルデータの一部をGPUメモリからシステムRAMやストレージへ移して処理する方法です。データ転送が追加されます。
本文に戻るプリフィル — LLMが入力プロンプトを読み、各トークンの内部表現を計算する段階です。プロンプトが長いほど処理するトークンが増えます。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- MoEは複数のエキスパートから一部を選んで計算する構造です。全体35B・アクティブ約3Bのモデルは保存する重みが大きくても、トークンごとの計算量を減らせます。この経路を効率よく実行できる機器では、より小さな27B Denseより速く生成する組み合わせもあります。
- 必要なメモリはどのくらいですか?
- 個人のコーディング支援では、まず1件のリクエストで比較します。共同サーバーでは、別途同時リクエストを試します。入力によって別のエキスパートが選ばれ、メモリアクセスとスケジューリングも変わります。全体処理量に加えて各利用者の遅延も記録してください。