
実行プログラムと拡張機能
最終更新
ローカルLLMの初回実行が遅いときに確認する五つのこと
最初の回答が遅いときは、取得から生成まで段階を分けて確認する
ローカルLLM1は、自分のコンピューターに保存したモデルで質問を読み、回答を作ります。アプリで新しいモデルを初めて選ぶと、まずファイルを取得してメモリに読み込みます。この準備が終わると、質問の処理と回答の生成を始められます。
最初の質問で長く待っても、次の質問はすぐに始まることがあります。取得済みのファイルを再度ダウンロードする必要がなく、モデルがメモリに残っていれば読み込み時間も省けるからです。モデルの準備、文書の読み取り、回答の生成のどこで待っているのかを順に調べましょう。
進捗表示でダウンロードとモデル読み込みを区別する
ダウンロード率や転送量が表示されているなら、まだモデルファイルを取得中です。転送量が増えていれば完了まで待ちます。止まった場合は接続とエラーメッセージを確認し、アプリの再試行機能を使ってください。この段階の問題は、コンテキスト長や出力設定を変えても解消できません。
取得後、アプリはディスクに保存したモデルをメモリに読み込みます。「モデル読み込み」が長く続く場合は、ファイル読み込みとメモリ使用量を調べてください。進捗表示はアプリによって異なります。詳細ログがなければ、画面に表示された段階とエラーを書き留めれば十分です。準備後に質問を送ってからの待ち時間は、次の節で分けて考えます。
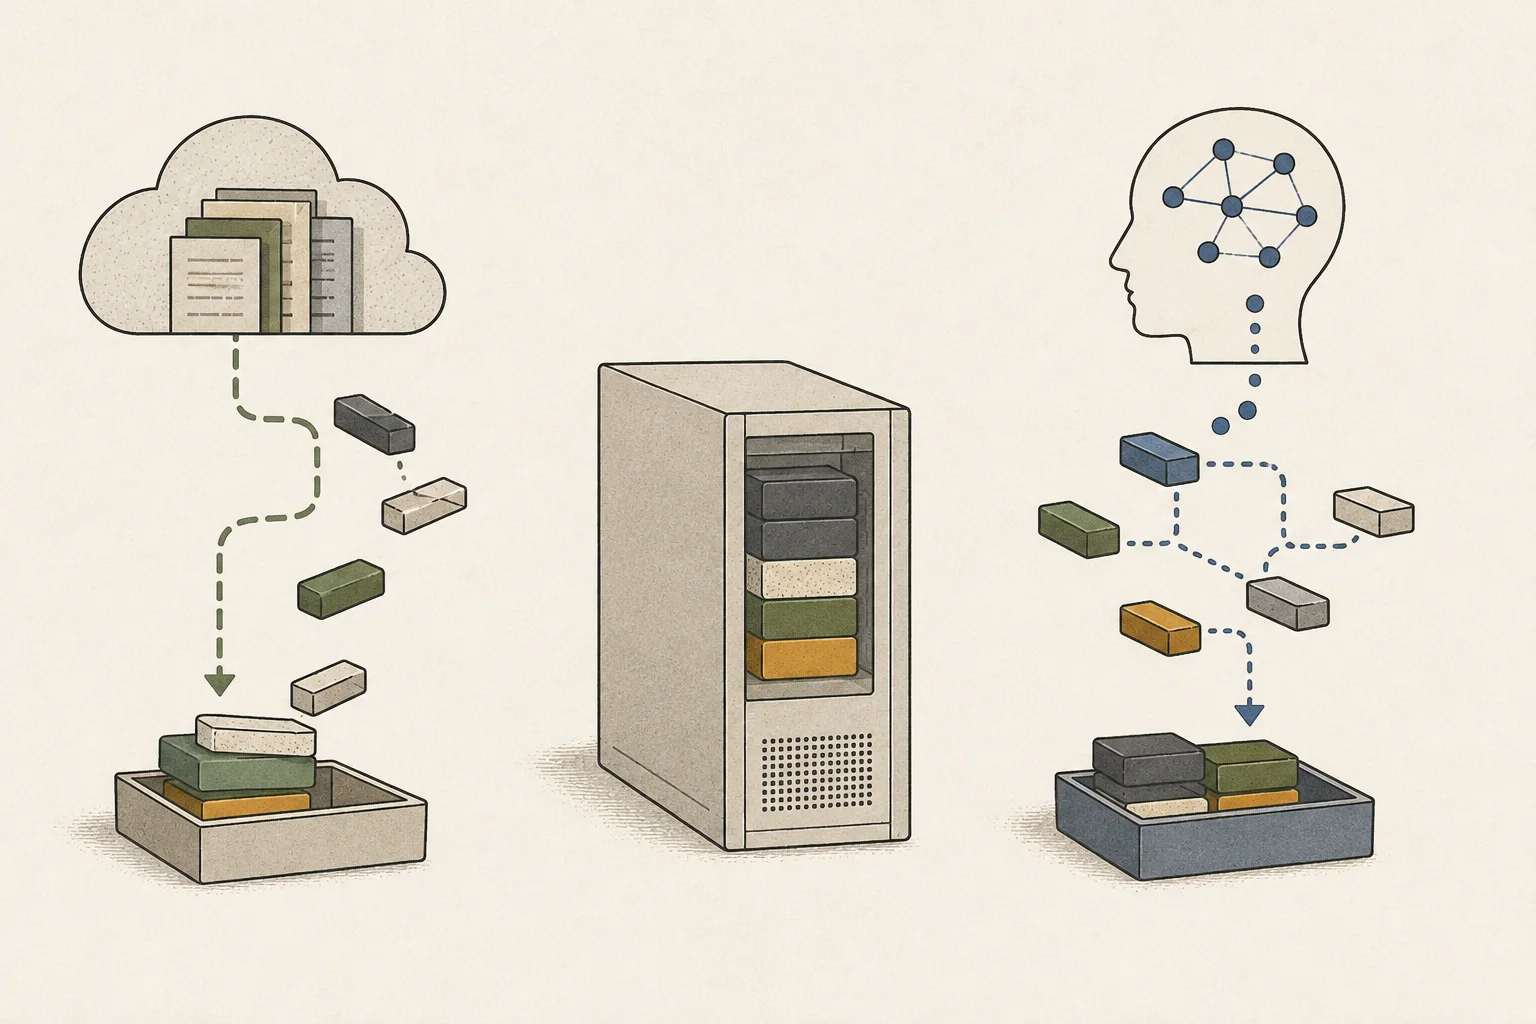
長い文書では最初の応答までの待ち時間が増えることがある
モデルは回答を書く前に、質問と一緒に送られた文書を処理します。この入力処理がプリフィル2です。同じ規程文書について「申請期限と例外を教えて」と質問してください。まず両方を含む抜粋を、次に全文を入力し、最初の回答が出るまでの時間を比べます。
モデルと設定を固定し、それぞれ新しい会話で試します。同じ会話に文書を追加し続けると、前の質問や回答も次の入力に含まれるからです。新しい会話で履歴を減らし、入力キャッシュの状態はアプリで別に確認してください。結果を比較できるよう、抜粋にも回答に必要な根拠をすべて残します。
最初の応答は同じくらいに始まるのに、長い回答だけ完了が遅い場合は、出力の長さを調べます。文書を読む負荷は最初の応答まで、回答を続ける負荷はそこから完了まで、と時間を分けて比較できます。
メモリの余裕とモデルの実行場所を確認する
ディスクリートGPU3を使うPCでは、実行プログラムのメモリ表示やログで、モデルがGPUにどれだけ配置されたか確認します。一部をCPU4で処理する構成では、GPUだけで動かす場合と速度が変わることがあります。Macではモデル、OS、ブラウザーが共有メモリを使うため、他のアプリが多いほどモデルに使える余裕が減ります。
まずモデルは変えずに他のアプリを閉じ、短い質問と文書付きの質問を試します。次に小さいモデルへ替え、同じ質問をしてください。条件を一つずつ変えると、メモリの空きとモデルサイズの影響を分けて調べられます。小型モデルでは計算量や実行方式も変わるため、速度だけでなく申請の例外まで正しく回答できたか確認しましょう。
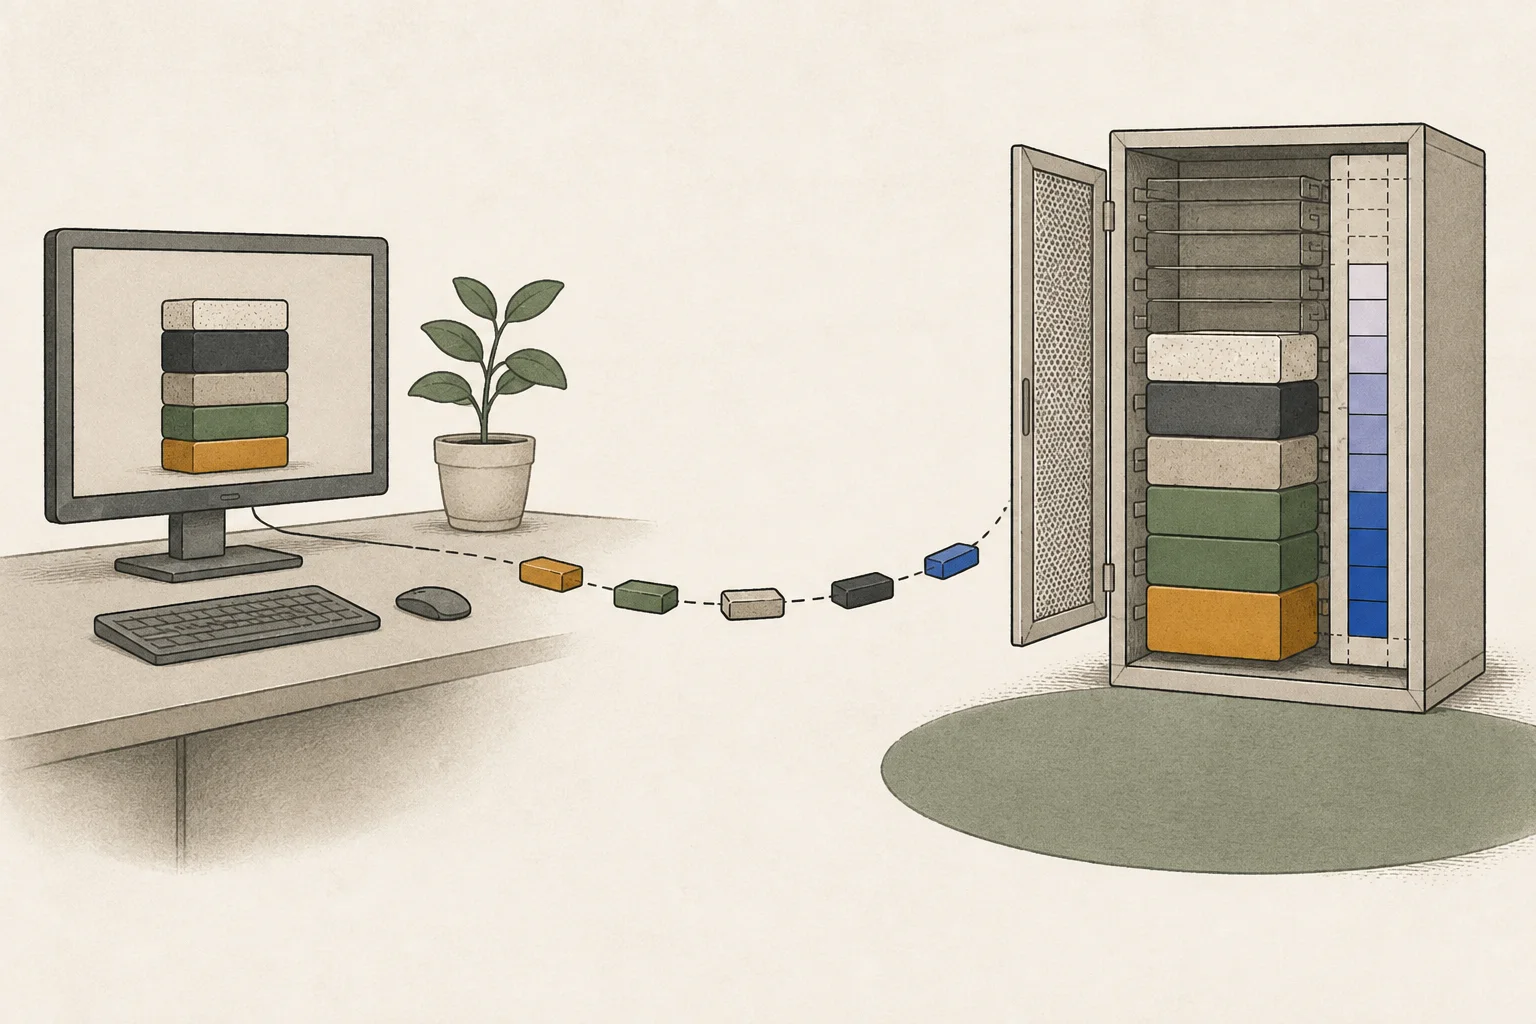
モデルを読み込んだまま使うと準備時間を減らせる
2回目の質問が速くなる理由は複数あります。ファイルがディスクに残っていれば再取得は不要です。アプリがモデルをメモリに保持していれば読み込みを省けます。同じ入力の先頭部分をキャッシュから再利用できる場合は、プリフィルの再計算も減ります。
普段アプリを開いたまま使うならモデルの読み込み後に、必要なときだけ起動するなら再起動後に比べてください。終了後もOSのファイルキャッシュが残る場合があり、入力キャッシュの消去方法もプログラムごとに異なります。開始条件を記録し、同じアプリ、モデル、バージョンで繰り返すと、普段の待ち時間が分かります。
画面上の待ち時間を比べるには、質問を送ってから回答が表示されるまでを測ってください。サーバーログには計算時間だけが記録される場合があるため、待機、読み込み、画面表示を含む利用者側の時間も残すとよいでしょう。
回答が途中で切れたら終了理由を確認する
回答が文の途中で終わった場合は、アプリやサーバーログの終了理由を確認します。出力上限に達していたら、同じ質問で上限だけを増やして再実行してください。出力上限は、1回のリクエストで生成できる回答の長さを決める設定です。増やすと長い回答を受け取れますが、完了時間や必要なメモリも変わることがあります。
最後に、申請期限と例外の両方が回答に含まれたか確認します。必要な内容を保った状態で、リクエスト、最初のトークン5、完了の時刻と終了理由を記録してください。準備後も最初の回答が遅いなら入力処理とメモリを、すぐ始まるのに完了が遅いなら回答長とデコード6速度を比べます。短縮すべき段階が分かれば、機器選びの基準も具体的になります。
用語の注釈
大規模言語モデル — 大量のテキストデータから言語パターンを学び、文脈に沿ったテキストを処理・生成するモデルです。
本文に戻るプリフィル — LLMが入力プロンプトを読み、各トークンの内部表現を計算する段階です。プロンプトが長いほど処理するトークンが増えます。
本文に戻るGPU — 多くの計算を並列に処理するプロセッサーです。AIモデルの実行ではモデル計算を担います。
本文に戻るCPU — OSや一般的なプログラム命令を実行する中央処理装置です。AIでは前処理やデータ転送などの汎用処理も担います。
本文に戻るトークン — モデルが入力や出力を分けて処理する単位です。
本文に戻るトークンのデコード — 入力とそれまでの回答をもとに、次の出力トークンを順に生成する段階です。
本文に戻る
よくある質問
- この記事で最初に確認すべきことは何ですか?
- ローカルLLMは、自分のコンピューターに保存したモデルで質問を読み、回答を作ります。アプリで新しいモデルを初めて選ぶと、まずファイルを取得してメモリに読み込みます。この準備が終わると、質問の処理と回答の生成を始められます。
- 必要なメモリはどのくらいですか?
- 取得後、アプリはディスクに保存したモデルをメモリに読み込みます。「モデル読み込み」が長く続く場合は、ファイル読み込みとメモリ使用量を調べてください。進捗表示はアプリによって異なります。詳細ログがなければ、画面に表示された段階とエラーを書き留めれば十分です。準備後に質問を送ってからの待ち時間は、次の節で分けて考えます。